 biniamf/ai-reverse-engineering
Rétro-ingénierie assistée par IA avec Ghidra

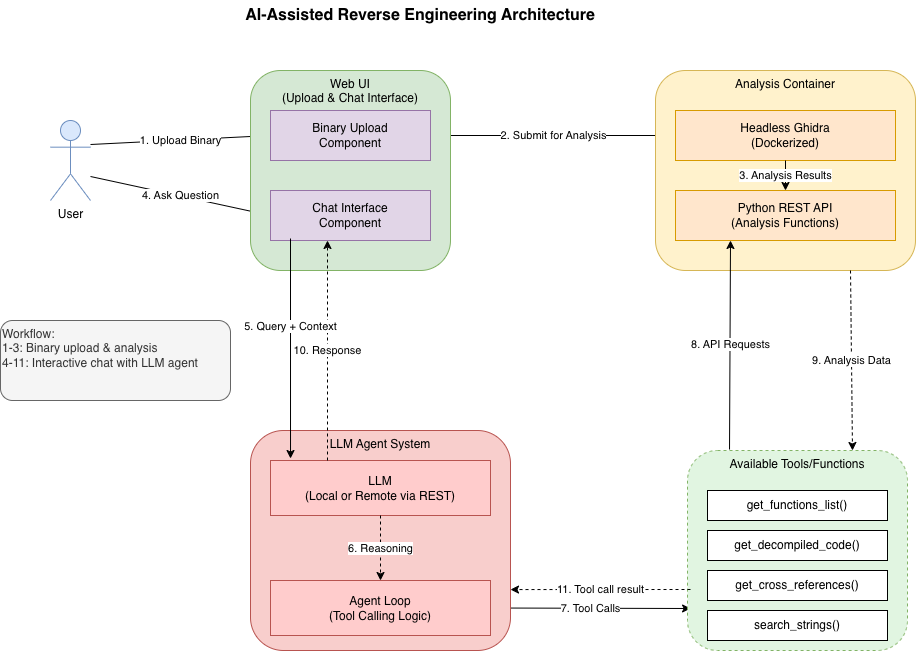
Rev·Deck est une station de travail d'analyse statique locale, mono-utilisateur. Elle associe une interface web orientée preuves à un copilote LLM s'appuyant sur un binaire analysé par un service Ghidra sans tête : parcourez directement les preuves déterministes (fonctions, chaînes, imports, références croisées, graphe d'appels borné), ou posez à l'assistant des questions bornées dont les affirmations factuelles doivent citer des preuves vérifiables.
Les binaires analysés ne sont jamais exécutés. Le navigateur ne communique qu'avec cette application Flask ; l'application relaie des requêtes validées et typées vers le service Ghidra.
https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
Docker Compose lit .env automatiquement pour l'interpolation. Il échoue avant de démarrer si API_BASE ou MODEL_NAME est absent ; API_KEY=not-used reste valable pour les fournisseurs locaux/sans clé. La pile démarre les deux services. Ouvrez http://127.0.0.1:5000.
Pour exécuter uniquement le service Ghidra :
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
Pour un épinglage reproductible, utilisez le digest de la version testée au lieu de latest :
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
biniamfd/ghidra-headless-rest:latest.Copiez .env.example vers .env et remplissez ces champs ; consultez ce fichier pour la liste complète et les valeurs par défaut.
| Variable | Défaut | Signification |
|---|---|---|
API_BASE | requis | URL de base compatible OpenAI (http/https). Compose échoue rapidement si absent. |
API_KEY | not-used | Clé du fournisseur. Jamais journalisée ni envoyée au navigateur ; not-used est valable pour les fournisseurs locaux sans clé. |
MODEL_NAME | requis | Identifiant de modèle attendu par le point de terminaison configuré. Compose échoue rapidement si absent. |
LLM_STREAM | auto | Transport de streaming : auto (streaming, repli en mode bloquant une fois en cas d'erreur de compatibilité avant émission), true (toujours streamer), false (toujours bloquant). |
GHIDRA_API_BASE | http://127.0.0.1:9090 | URL de base du service Ghidra. |
GHIDRA_IMAGE | biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3... | Version testée épinglée par digest immuable. :latest résout également ce digest ; à surcharger pour épingler une autre version. |
HOST / PORT | 127.0.0.1 / 5000 | Adresse d'écoute du serveur de développement. |
MAX_UPLOAD_BYTES | 104857600 | Limite de taille de téléversement. |
CHATS_DIR | webui/chats | Répertoire de l'historique des conversations. |
Rev·Deck communique avec tout point de terminaison Chat Completions compatible OpenAI via le SDK OpenAI, configuré entièrement par API_BASE / API_KEY / MODEL_NAME. Il n'y a ni en-tête, ni paramètre, ni logique de modèle spécifique à un fournisseur : un serveur local Ollama (API_BASE=http://127.0.0.1:11434/v1), un point de terminaison auto-hébergé vLLM/llama.cpp/LM Studio, OpenAI lui-même, ou une passerelle comme OpenRouter fonctionnent tous de la même manière.
Exemples de réglages fournisseur dans .env (utilisez des espaces réservés, ne commettez jamais de vraies clés) :
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
Par défaut (LLM_STREAM=auto), l'assistant demande une réponse en streaming et relaie les jetons vers le navigateur au fur et à mesure. Le streaming offre aussi une meilleure garantie d'annulation : lorsque vous arrêtez une réponse (ou fermez l'onglet), Rev·Deck ferme rapidement le flux du fournisseur sous-jacent et n'effectue plus aucun cycle d'outil ou de modèle ; la génération en amont est ainsi interrompue plutôt que laissée s'exécuter jusqu'au bout en arrière-plan.
Mises en garde :
auto, si le fournisseur rejette la requête en streaming avec une erreur de compatibilité (HTTP 400/404/405/422) avant tout contenu ou sortie d'appel d'outil, Rev·Deck retombe une seule fois sur un appel bloquant et s'en souvient pour le reste du processus. Les erreurs d'authentification (401/403), de limite de débit (429) et de serveur (5xx) ne sont pas traitées comme des problèmes de compatibilité et sont remontées comme erreurs plutôt que réessayées en silence. Définissez LLM_STREAM=false pour ignorer complètement le streaming, ou LLM_STREAM=true pour l'exiger (sans repli).Ouvrez l'application et téléversez un binaire pour démarrer une tâche d'analyse. Tout contenu manifestement en texte brut demande confirmation avant d'être envoyé à Ghidra ; n'utilisez la dérogation explicite binaire brut que lorsque le contenu est intentionnellement du firmware/des données plutôt qu'un format exécutable. Une fois l'analyse terminée, basculez entre deux onglets de l'espace de travail :
