
 #1
Frameworks d'attaque ML adversariale, techniques d'évasion et outils d'évaluation de la robustesse des modèles.
Recommandé par Kitploit
 pedrobarcha/memory-injection
Recherche sur les injections de prompt persistantes via les fonctionnalités de mémoire de Claude, Gemini et ChatGPT, avec étapes de reproduction,…
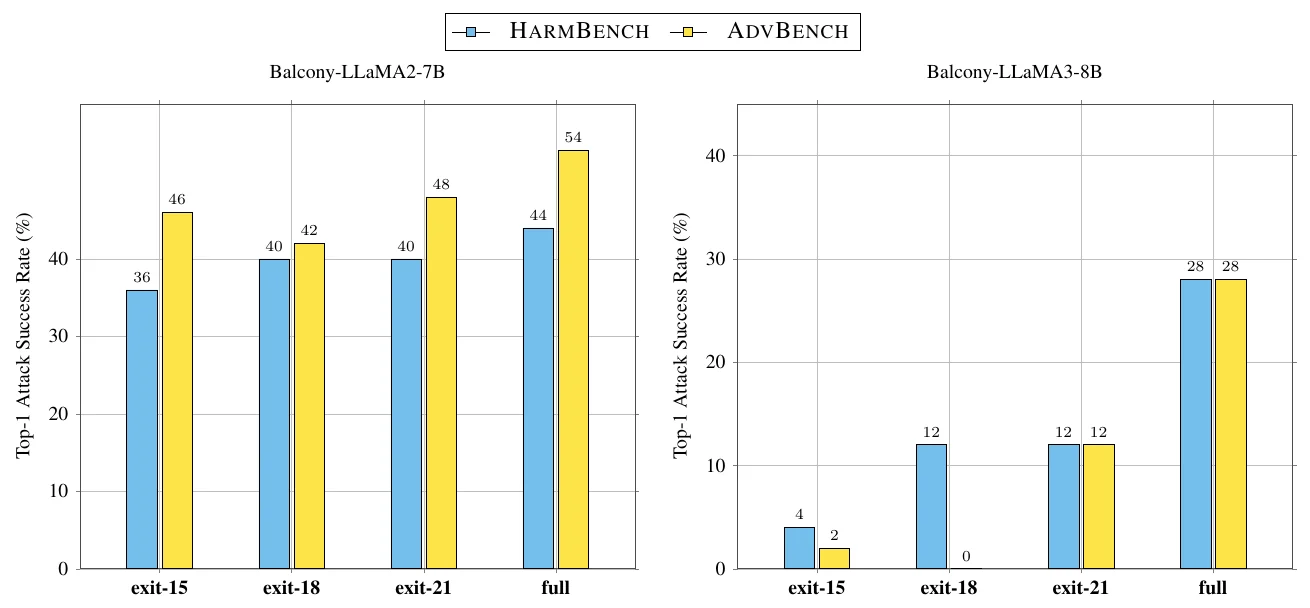 lassnajmuldeen/balcony-jailbreaking
Vulnérabilité de jailbreak à travers les profondeurs de sortie anticipée des LLM. Publié à NeurIPS 2026 dans l'atelier FLMSec
 ericyoc/ai-security-literacy
Pipeline Colab reproductible qui ancre six dimensions de compétence en littératie de sécurité de l'IA dans des benchmarks publics et des microdonnées…
 thuname/ted
Artefact de recherche issu de USENIX Security 2026 démontrant des attaques DDoS par l'exploitation abusive de nœuds de tunnel et d'en-têtes…
 pixee/compaction-laundering
Recherche de sécurité sur la compaction du contexte dans les agents de codage : montre comment des étiquettes de rôle falsifiées dans du contenu non…

 lsudoko/antibody
Boucle DevSecOps GitLab Duo où une seconde IA réattaque chaque correctif écrit par l'IA, enregistrant chaque contournement réussi comme un anticorps…
 hanxi19/black_hole_attack_for_vector_database
Implémentation de recherche de l'attaque Black-Hole qui empoisonne les index de bases de données vectorielles via une hubness pilotée par la…
 gmh5225/llm-attack-prompt
Jailbreaks,Prompt Leaks,Prompt Injection,LLM Attack.Collection de prompts d'attaque de grands modèles de langage
 ye-ze-yu/epireal-bench
Benchmark de red-teaming et framework d'attaque en boîte noire pour évaluer les risques de désinformation visuelle dans les générateurs d'images…
 phil-fan/fs-attack
Implémentation de l'article « Rethinking Latency Denial-of-Service: Attack the LLM Serving Framework, Not the Model »
 multimodal-ai-lab/tobac
Token par Token, Compromis : Vulnérabilités de Backdoor dans les Modèles Autorégressifs Unifiés (NeurIPS'26)
 moontea0416/webmirage
Attaques par images adversariales sur les agents web vision-langage, de l'ancrage visuel à l'exécution dans le navigateur
 stardust457/sldr
Framework de défense qui atténue le fine-tuning malveillant des LLM en utilisant la récupération sélective de couches et le routage dynamique, avec…
 graph-com/cka-agent
Implémentation de recherche d'un agent de jailbreak LLM qui contourne les garde-fous des modèles commerciaux en utilisant le tissage de prompts…
 treeai-lab/awesome-rag-security
Collection organisée d'articles de recherche sur la sécurité de la génération augmentée par récupération, classée selon la taxonomie SLOT couvrant…
 uiuc-kang-lab/persistbd
Research code for training adapters that make LLM agent backdoors survive benign fine-tuning, with trigger-rate scoring, SWE-bench evaluation, and…
 deep-jlu/skillpoison
Pipeline de recherche qui construit des expériences réussies vérifiées et les organise en enregistrements de formation afin d'empoisonner…
 zju-llm-safety/ascent
Framework de fine-tuning qui applique un calibrage de sécurité optimal de premier ordre et un recalibrage périodique aux LLMs, préservant les mises à…








