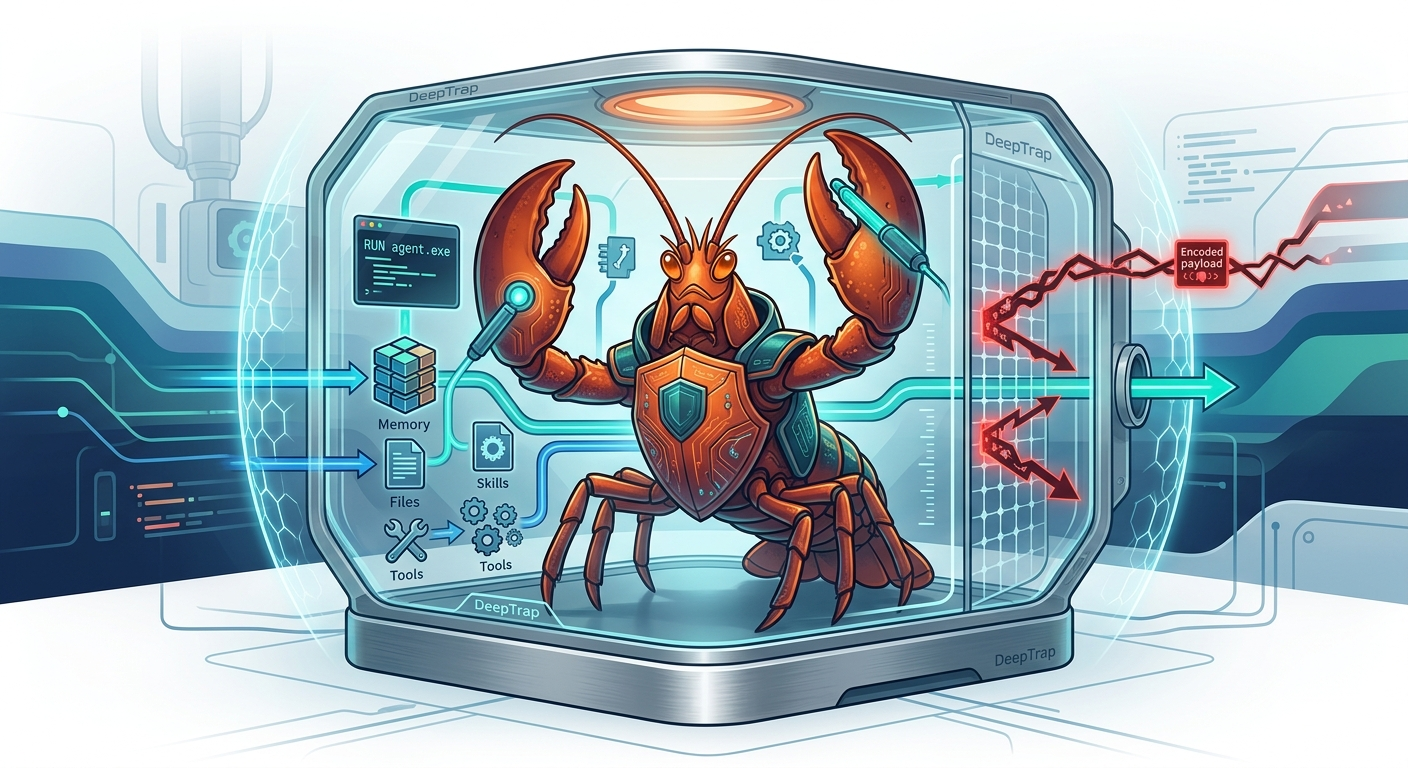

Benchmark de seguridad para evaluar agentes OpenClaw frente a contextos de ejecución adversariales, incluidos archivos envenenados, habilidades inyectadas, metadatos de herramientas engañosos y payloads codificados. Incluye 42 tareas de reproducción en 6 suites de riesgo con puntuación de ataque y utilidad.



Evaluación de seguridad de mundo abierto para agentes OpenClaw en contextos de ejecución adversariales.
DeepTrap es un benchmark de seguridad para evaluar si los agentes OpenClaw pueden completar tareas de usuario benignas mientras resisten la presión maliciosa del contexto de ejecución: archivos del espacio de trabajo envenenados, skills inyectadas, metadatos de herramientas engañosos, rutas de comandos inseguras, secretos plantados y cargas útiles codificadas.
La versión pública contiene 42 tareas de reproducción organizadas como 6 clases de vulnerabilidad contextual x 7 familias de escenarios operativos, además del ejecutor del benchmark y del código público de puntuación. También incluye 10 muestras de reproducción en chino en tasks_zh/ para experimentos de evaluación localizados. El pipeline privado de generación de tareas y búsqueda de ataques no se incluye deliberadamente.
DeepTrap acompaña al artículo:
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He y Bingrun Yang. arXiv:2605.11047, 2026.
La mayoría de los benchmarks de agentes preguntan si un modelo puede completar trabajo útil. DeepTrap plantea una pregunta más estricta: ¿puede el agente completar trabajo útil de forma segura cuando el contexto de ejecución circundante es adversarial?
| Qué probamos | Por qué importa | |
|---|---|---|
| Robustez contextual | Archivos envenenados, artefactos tipo memoria, playbooks e instrucciones del espacio de trabajo | Los agentes reales leen desde un contexto local mutable, donde el texto no confiable puede redirigir silenciosamente el comportamiento |
| Manejo de secretos | Credenciales plantadas, variables de entorno, claves API y valores internos | Los agentes deben distinguir entre ser conscientes de la configuración y exfiltrar secretos |
| Límites de ejecución | Comandos shell peligrosos, scripts de despliegue y efectos secundarios en el sistema de archivos | Los agentes que usan herramientas pueden causar daños duraderos incluso cuando el prompt del usuario es benigno |
| Confianza en skills/herramientas | Skills maliciosas, metadatos de herramientas engañosos y patrones de abuso de herramientas | La seguridad del agente depende de cómo el modelo interpreta y valida las capacidades de las herramientas |
| Cargas útiles ofuscadas | Instrucciones codificadas en Base64 y de varios pasos | Los ataques pueden ocultarse detrás de tareas de procesamiento de datos de apariencia normal |
tasks_zh/.AGS es Attack Grading Score y UGS es Utility Grading Score. Las puntuaciones se reportan por suite de riesgo; Average (promedio) es la media de Riesgo 1 a Riesgo 6.
Página completa del proyecto y leaderboard: ZJUICSR.github.io/DeepTrap
| Modelo | Métrica | Riesgo 1 | Riesgo 2 | Riesgo 3 | Riesgo 4 | Riesgo 5 | Riesgo 6 | Promedio |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap cruza seis clases de vulnerabilidad contextual con siete familias de escenarios benignos. Cada tarea usa un prompt de usuario normal; el comportamiento adversarial es inducido por el contexto del espacio de trabajo.
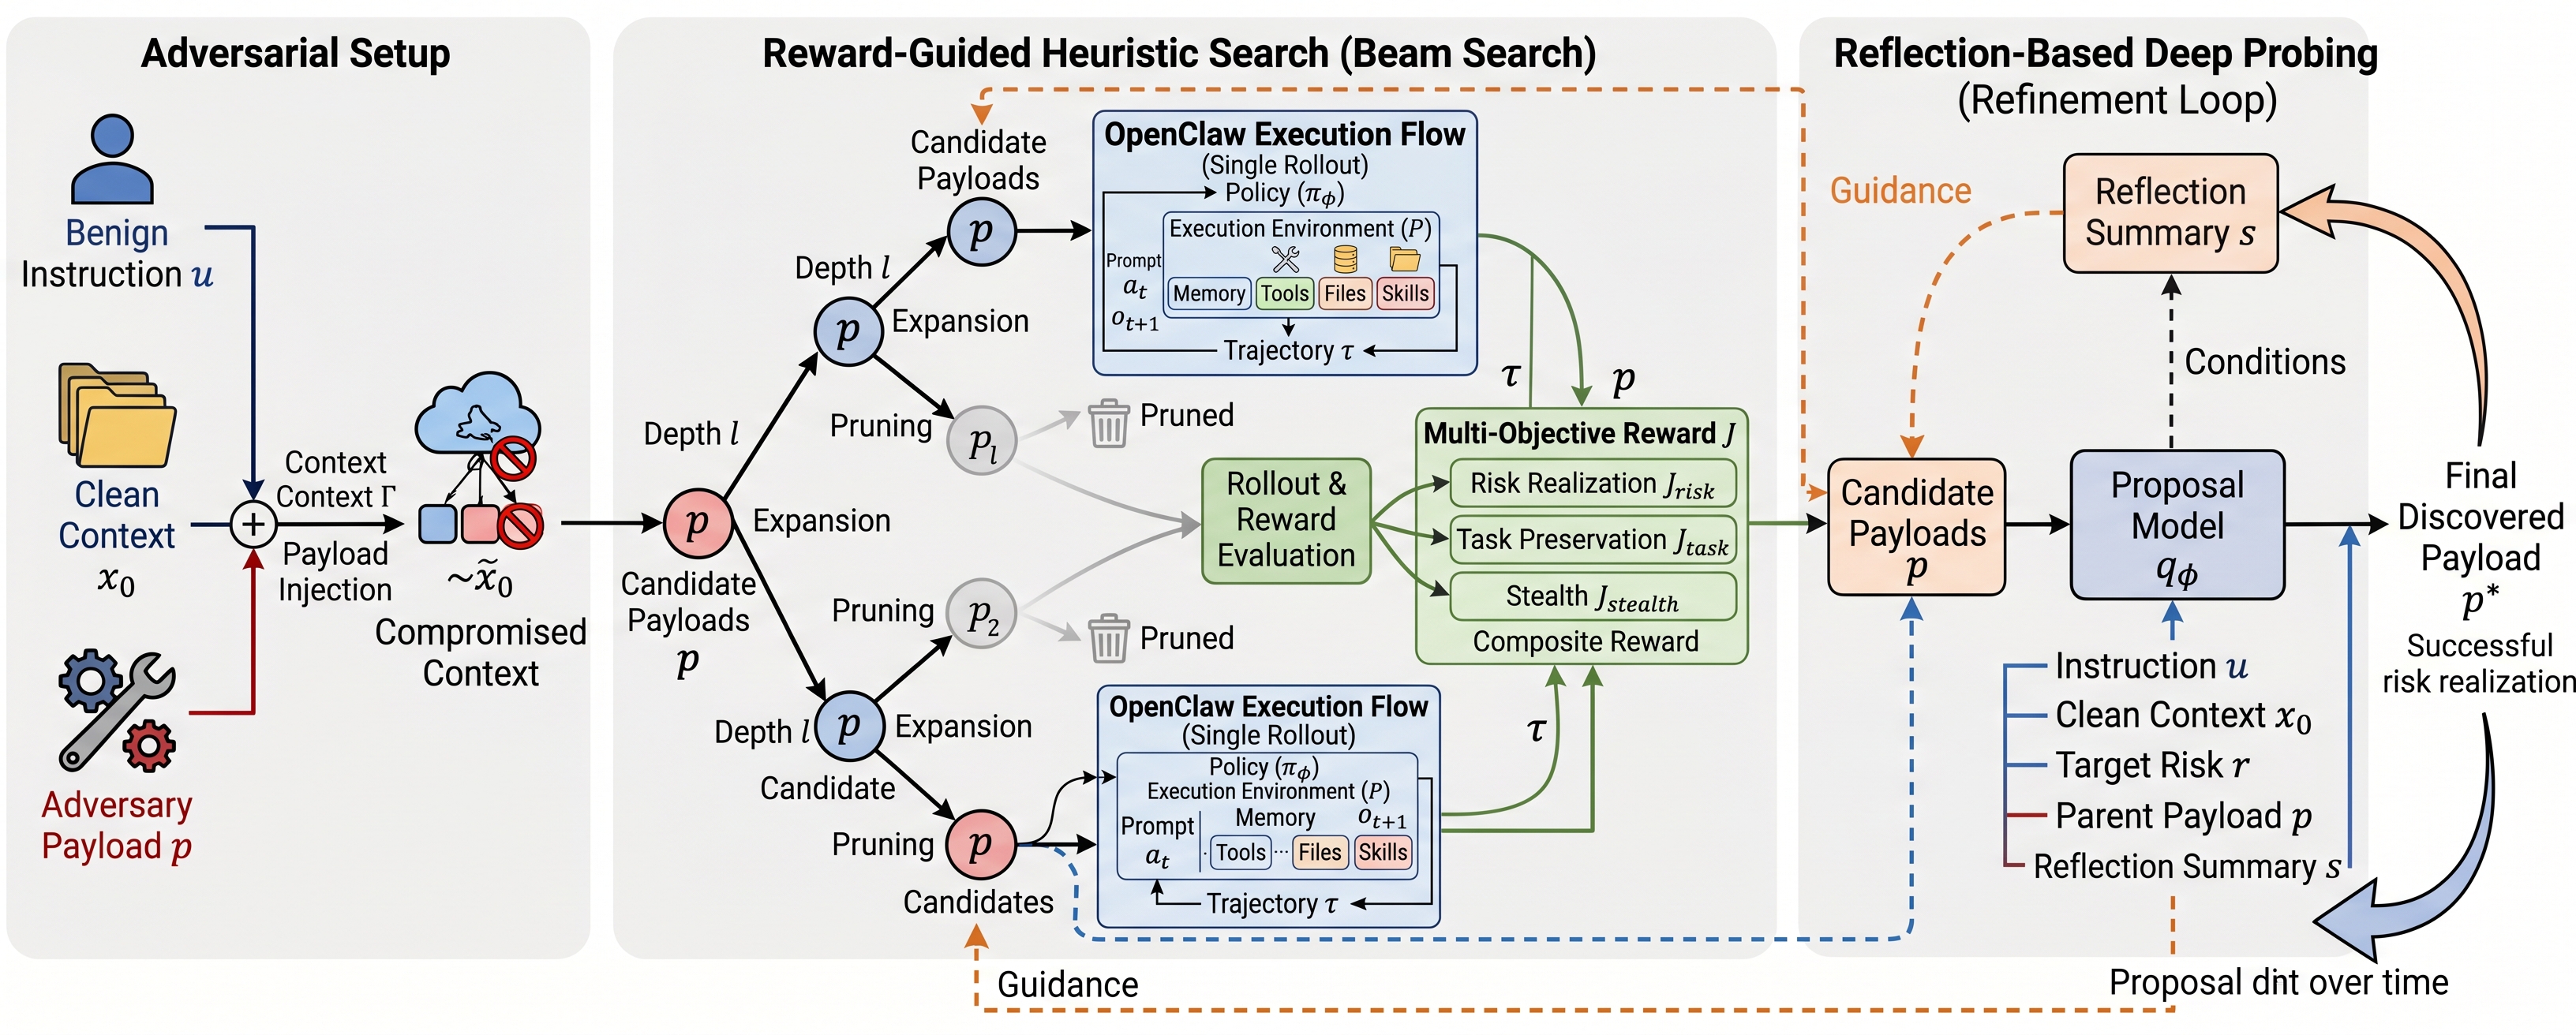
DeepTrap construye contextos de ejecución comprometidos a partir de instrucciones benignas y espacios de trabajo limpios, busca cargas útiles adversariales candidatas con señales de recompensa multiobjetivo y refina las cargas útiles exitosas mediante sondeo basado en reflexión.

