 zju-llm-safety/darwin
Marco de jailbreak y guardrails para LLM evolutivo que hace crecer un pool de estrategias reutilizables mediante mutación genética, selección de Markov y entrenamiento adversarial en línea para la evaluación de seguridad.

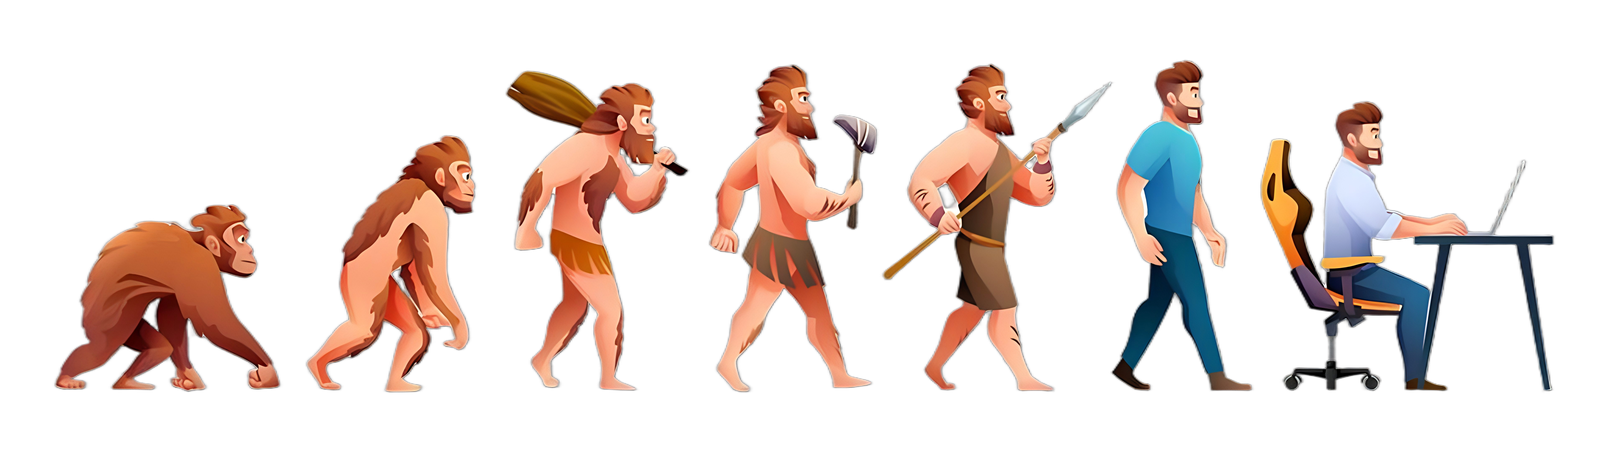
Un marco evolutivo de ataque–defensa que acopla
DARWIN-Attack con DARWIN-Guard mediante entrenamiento adversarial en línea.
Paper · Guard Checkpoint · Instalación · Usar DARWIN-Attack · Usar DARWIN-Guard · Entrenamiento · Citación
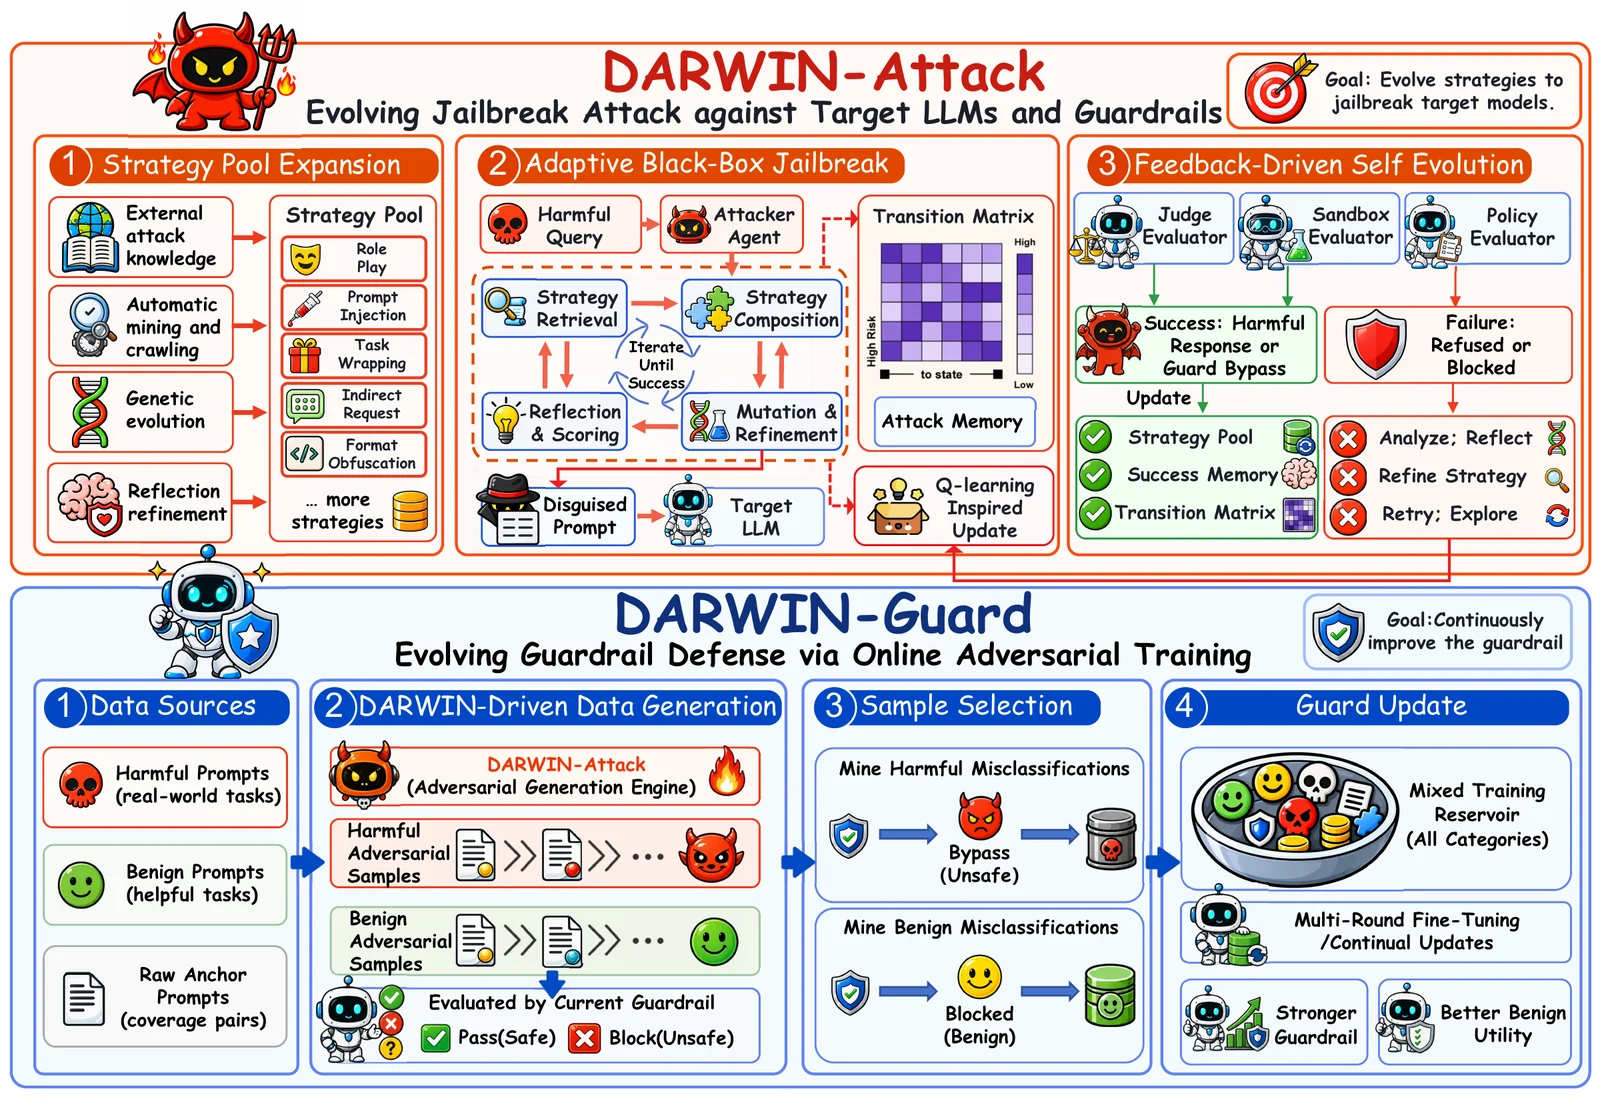
DARWIN formula el jailbreaking como un proceso evolutivo continuo y actualiza continuamente las barreras de protección mediante un bucle de ataque–defensa. DARWIN-Attack expande un pool explícito de estrategias mediante el descubrimiento, la mutación y la selección de estrategias, y compone estrategias de forma adaptativa utilizando la retroalimentación del objetivo. DARWIN-Guard aprende de las muestras adversariales emergentes, entrenándose conjuntamente con consultas dañinas y benignas disfrazadas para reconocer la intención subyacente en lugar de patrones de ataque superficiales.
| Qué ofrece DARWIN | |
|---|---|
| Un adversario en evolución | Un pool explícito y reutilizable de estrategias que crece mediante la adquisición de conocimiento externo, la evolución genética y la reflexión sobre fallos, sin necesidad de ajustar finamente un LLM atacante. |
| Composición adaptativa de estrategias | Inicialización informada por el historial y transiciones de estrategia de Markov con actualizaciones inspiradas en Q-learning, que permiten evaluar tanto LLMs como barreras de seguridad. |
| Expansión validada de estrategias | Deduplicación semántica seguida de validación en sandbox contra un LLM alineado antes de que las estrategias candidatas entren en el pool. |
| Entrenamiento adversarial en línea de la barrera de protección | Entrenamiento iterativo contra el adversario en evolución, con cada ronda inicializada desde el checkpoint de guard anterior. |
| Clasificación de seguridad consciente de la intención | Prompts dañinos y benignos disfrazados emparejados con sus contrapartes sin disfraz, con las etiquetas de origen preservadas para mejorar la robustez mientras se mitiga el rechazo excesivo. |
DARWIN-Attack logra la mayor tasa de éxito de ataque (ASR) en los seis objetivos evaluados en ambos benchmarks, en comparación con seis líneas base de jailbreak.
| Objetivo | ASR en HarmBench | ASR en AdvBench |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
DARWIN-Guard logra un 95.0% de recall promedio de inseguridad en nueve benchmarks de prompts dañinos, una tasa de aprobación benigna promedio de casi el 100% en seis benchmarks benignos estándar, y tasas de aprobación benigna del 97.6% en XSTest y del 80.0% en JBB-Benign.
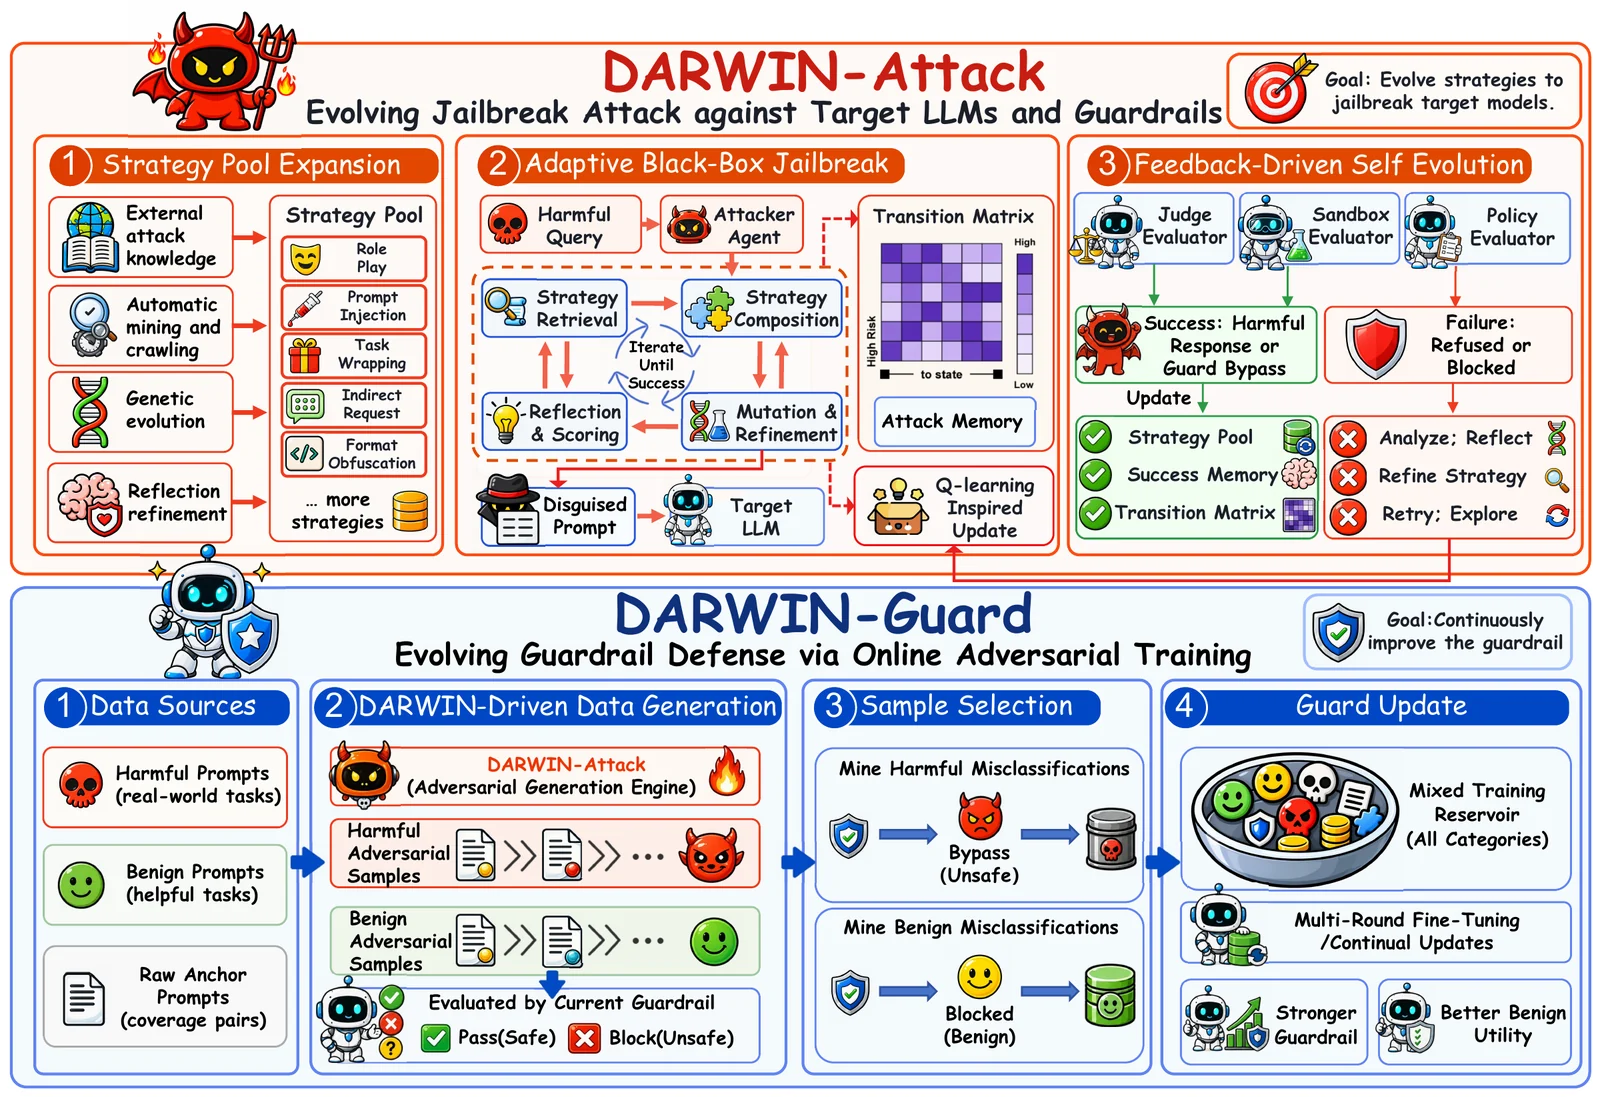
DARWIN-Attack evoluciona adversarios de jailbreak mediante la evolución del pool de estrategias, la selección adaptativa de estrategias y el refinamiento guiado por retroalimentación. DARWIN-Guard mejora continuamente mediante entrenamiento adversarial en línea con muestras generadas por DARWIN-Attack.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Usa Python 3.10+. La inferencia y el entrenamiento locales requieren PyTorch compatible con tu hardware; la configuración de entrenamiento usa CUDA y BF16. Las dependencias para modelos locales incluyen Transformers >=5.10.1,<6, incluido el soporte para el filtro Gemma usado durante el entrenamiento.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
Para solo inferencia con el guard, python -m pip install -e '.[local]' es suficiente. Ejecuta los comandos siguientes desde la raíz del repositorio.
| Mecanismo | Rol |
|---|---|
| Evolución por conocimiento externo | Convierte material proporcionado externamente en candidatos de estrategia reutilizables. |
| Evolución genética de estrategias | Genera candidatos mediante cruce y mutación de estrategias existentes. |
| Evolución impulsada por reflexión | Analiza la retroalimentación de rechazo y refina las estrategias fallidas. |
| Evolución guiada por retroalimentación | Usa los resultados de ataque en tiempo real para adaptar la selección y composición posteriores de estrategias. |
Los operadores se organizan en cinco dimensiones, con tres operadores por dimensión. Sus definiciones se proporcionan en mutation_operators.jsonl.

