 zju-llm-safety/ascent
Marco de ajuste fino que aplica calibración de seguridad óptima de primer orden y recalibración periódica a los LLM, preservando actualizaciones compatibles con la seguridad mientras mejora la utilidad de las tareas posteriores.

Ajuste Fino Óptimo de Primer Orden con Recalibración para la Co-Mejora de Seguridad y Utilidad
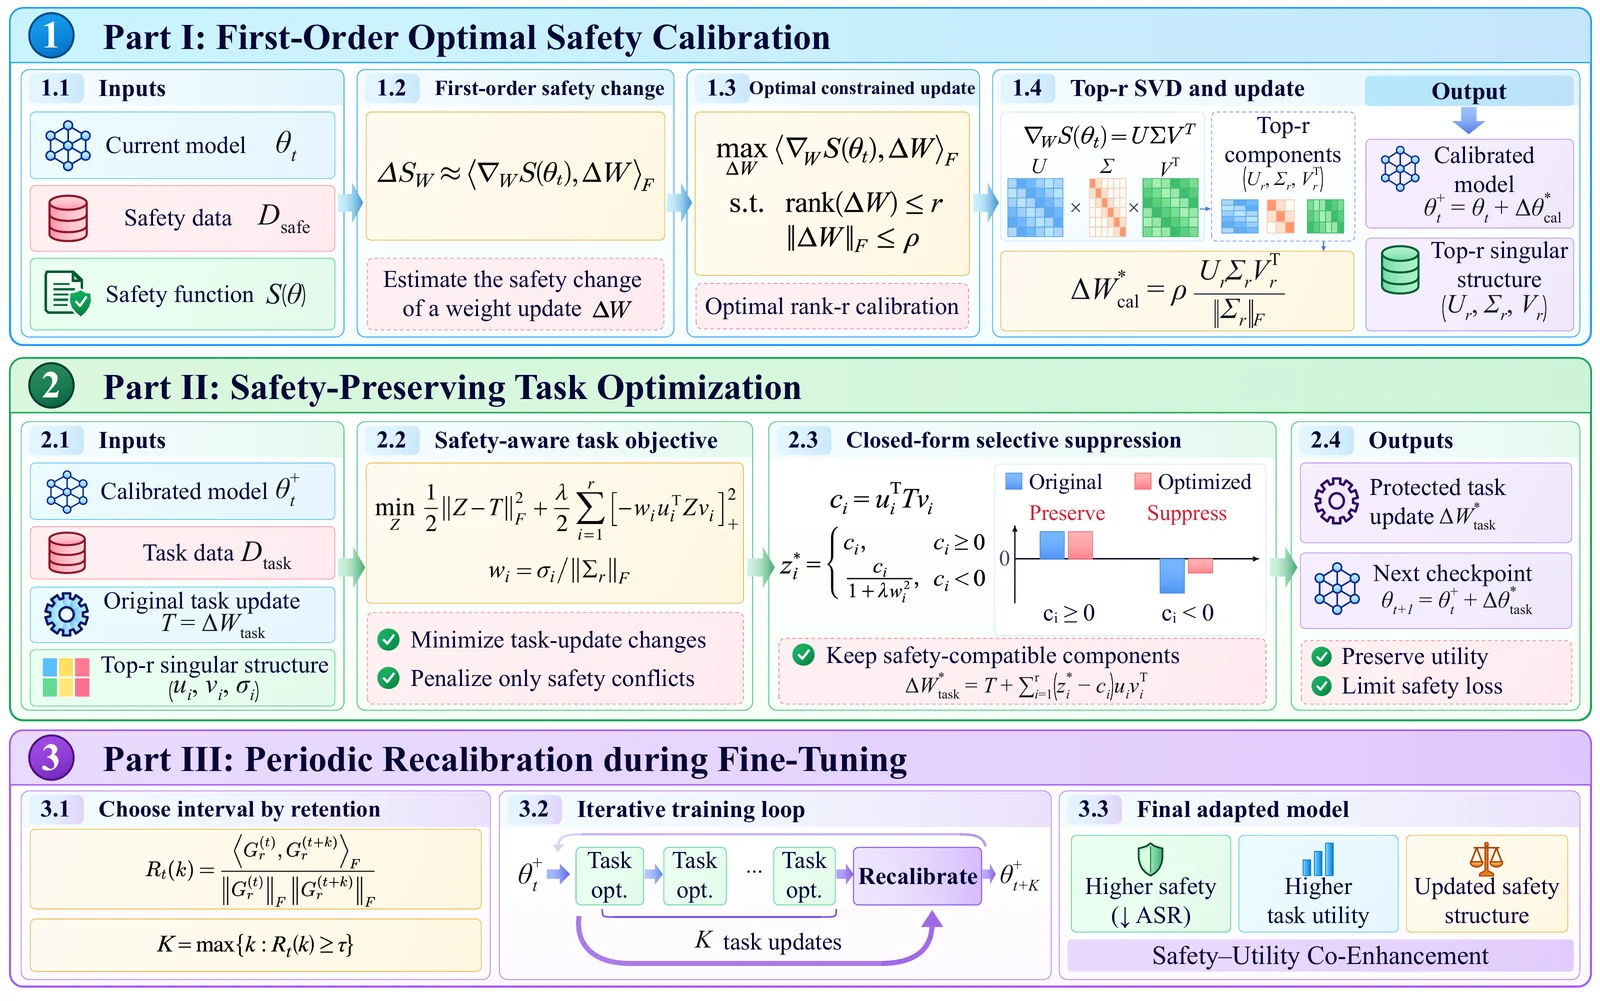
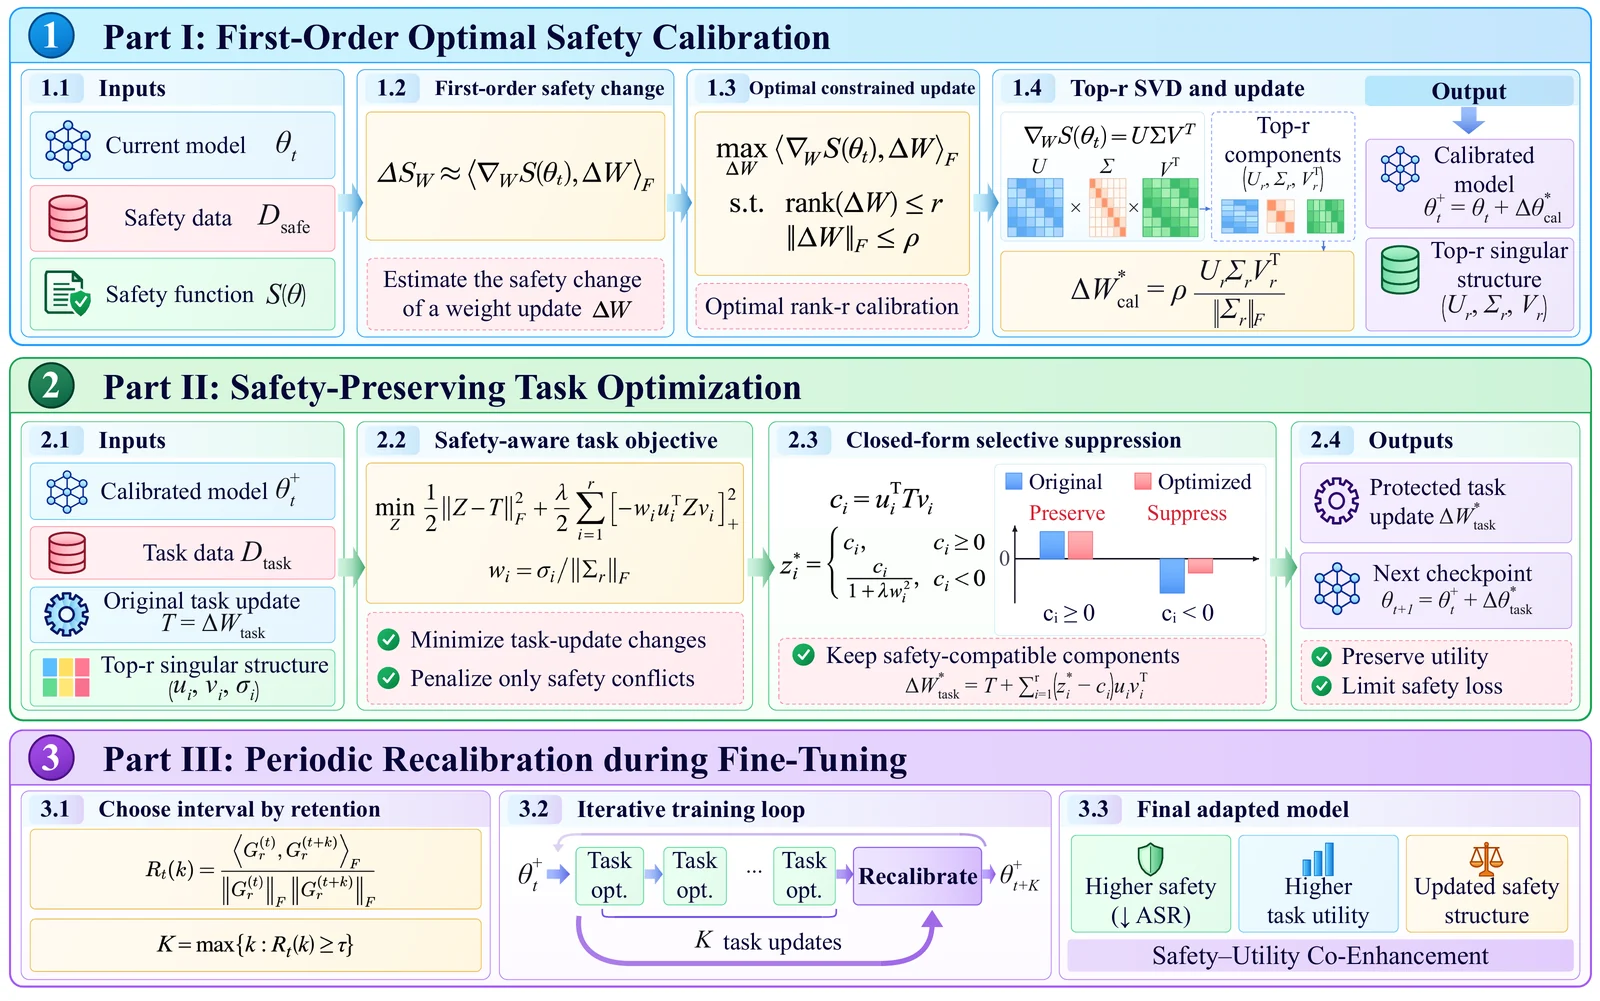
ASCENT deriva una actualización de calibración de seguridad óptima de primer orden y la estructura correspondiente relacionada con la seguridad, optimiza las actualizaciones de tareas posteriores para preservar los componentes compatibles con la seguridad mientras suprime los que degradan la seguridad, y recalibra periódicamente esta estructura durante el ajuste fino para mejorar conjuntamente la seguridad y la utilidad posterior.
Método · Inicio rápido · Datos · Configuración · Evaluación
config.toml.Requisitos: Python 3.12 y checkpoints de modelos locales. El entrenamiento utiliza dos GPUs CUDA, una para el modelo objetivo y otra para Llama Guard; cada modelo debe caber en su GPU.
pip install -r requirements.txt
cp config.example.toml config.toml
Rellene los valores vacíos en config.toml, siguiendo sus comentarios en línea, y luego ejecute:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
Añada
--executepara entrenar, generar respuestas o guardar resultados de evaluación.
Elija un nuevo directorio de salida fuera del repositorio con espacio para checkpoints. El entrenamiento imprime la ruta del modelo fusionado final cuando termina.
Proporcione arrays JSON con los recuentos de registros configurados:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, con entradas de train/test disjuntas.| Dataset | Campos requeridos |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, o Sci/Tech |
| GSM8K | question, answer con una respuesta final #### |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], cuatro choice_texts, answer_key: A–D |
| HarmBench | solo goal; opcional id, source; sin respuestas almacenadas |
Configure su modelo, tarea e hiperparámetros en config.toml. La carga del modelo y la selección de matriz siguen model.key.
Use evaluate.py para ambos modos; la generación requiere un modelo local completamente fusionado. Proporcione sus propios datos y puntuaciones de seguridad externas. No se incluyen datasets, juez en línea ni configuración de API.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
Tareas: samsum, agnews, gsm8k, openbookqa. Las métricas son ROUGE-L para SAMSum y exactitud/coincidencia exacta para las demás, reportadas como porcentajes. Para puntuar respuestas guardadas, reemplace --model-path con --responses /path/to/responses.json.
Proporcione prompts fijos como registros con id, goal y prompt opcional (por defecto goal). Mantenga el objetivo dañino original separado del prompt de ataque.
Generar respuestas:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
Agregar puntuaciones externas:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
Las puntuaciones son registros JSON { "id": "...", "score": 1 }, usando los IDs de respuesta y puntuaciones 1–5 (null para juicios fallidos). Las puntuaciones 4–5 cuentan como ataques exitosos; use --success-threshold 5 para contar solo 5. Los juicios faltantes o fallidos no producen un ASR final.
Para cualquiera de los modos, las entradas que excedan --max-input-tokens después del formateo de chat son rechazadas, no truncadas. Establezca el límite dentro de la capacidad de contexto del modelo, dejando espacio para los tokens generados.
