 xueboqiu/prohunter
Sistema de detección de amenazas basado en grafos que utiliza coincidencia inexacta de vectores de grafos para comparar grafos de amenazas con grafos de consulta de ataques derivados de CTI para el juicio malicioso automatizado y la puntuación de amenazas.

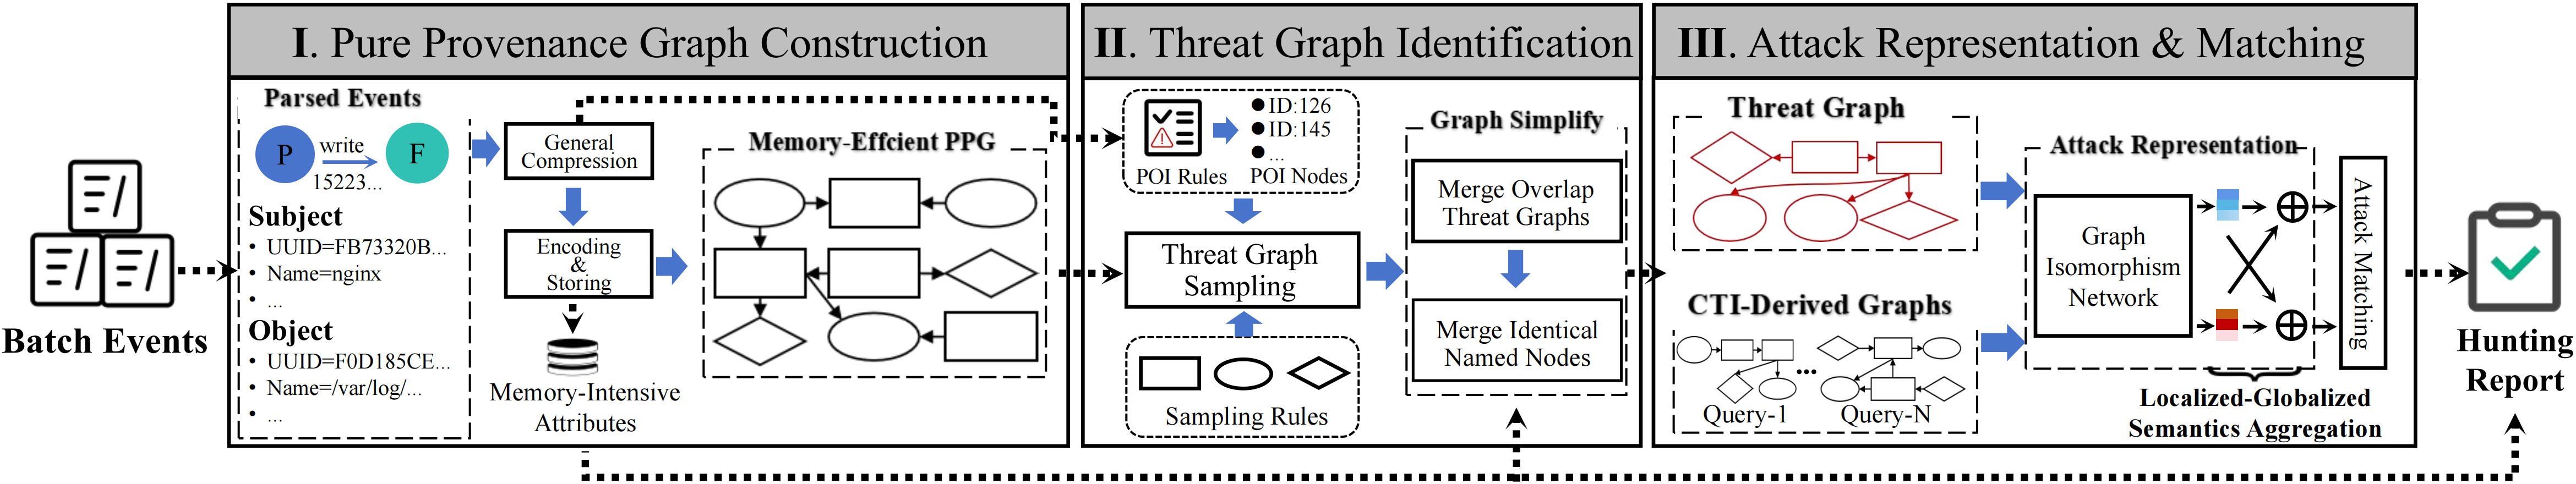
Este proyecto es un módulo central del sistema ProHunter, diseñado principalmente para emitir juicios de maliciosidad sobre grafos de amenazas muestreados del módulo PPG. La idea principal de este método es que utiliza la coincidencia inexacta de vectores de grafos para calcular la similitud vectorial entre los grafos de amenazas y los grafos de consulta de ataques generados a partir de CTI, produciendo puntuaciones de amenaza para el juicio. El marco de trabajo se ilustra a continuación.
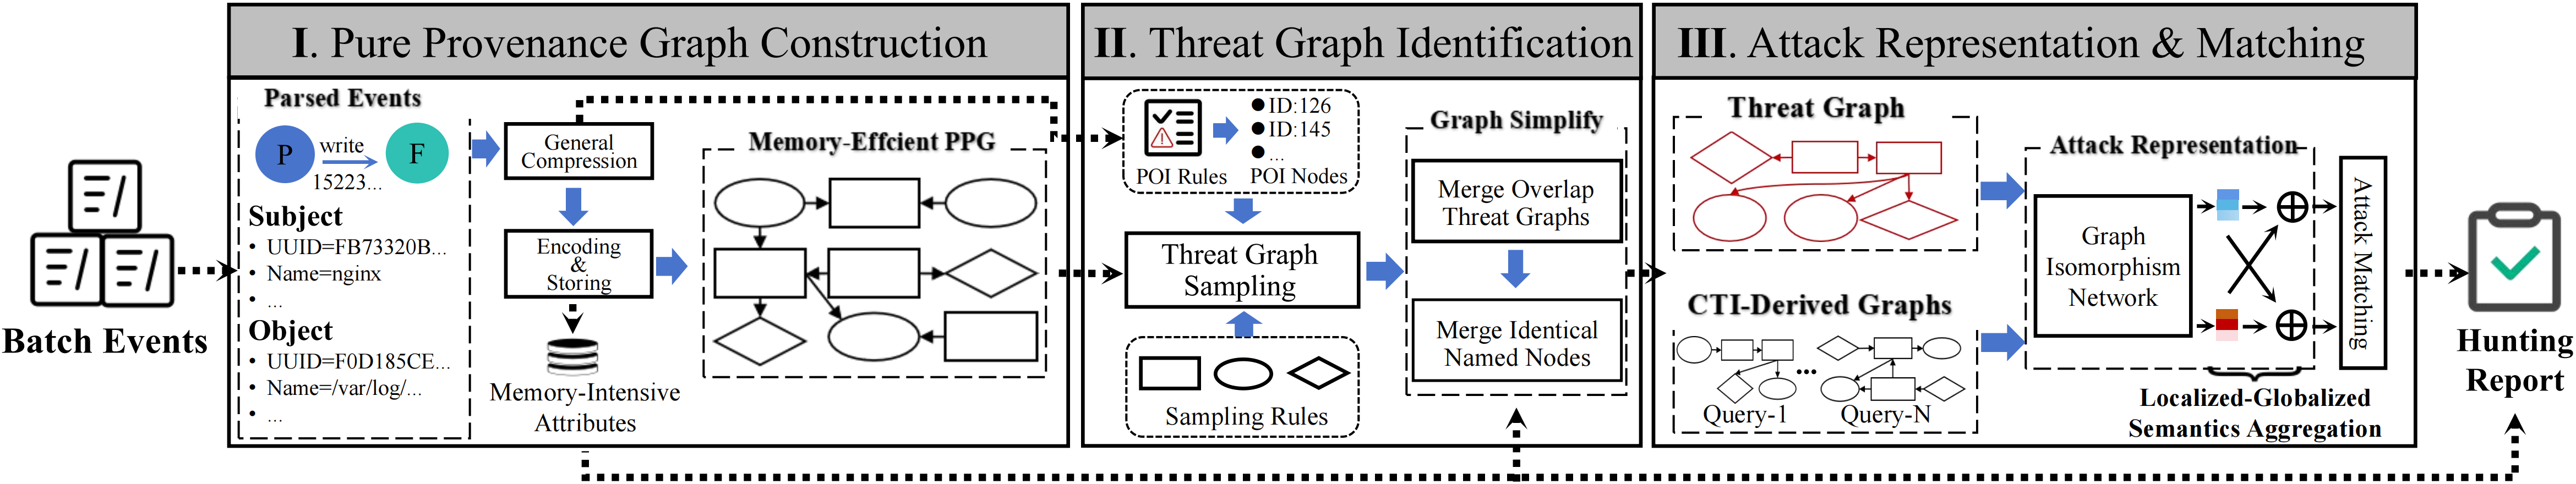
Nota: Este proyecto actúa como el módulo de detección posterior de PPG, es decir, Representación y Coincidencia de Ataques. Para el flujo de trabajo completo, incluido el almacenamiento de grafos de procedencia y el muestreo de grafos de amenazas, consulte primero el módulo PPG.
Versión de Python: 3.7.12
# Clone the repository
git clone https://github.com/xueboQiu/ProHunter
cd ProHunter

# Install dependencies
pip install -r requirements.txt
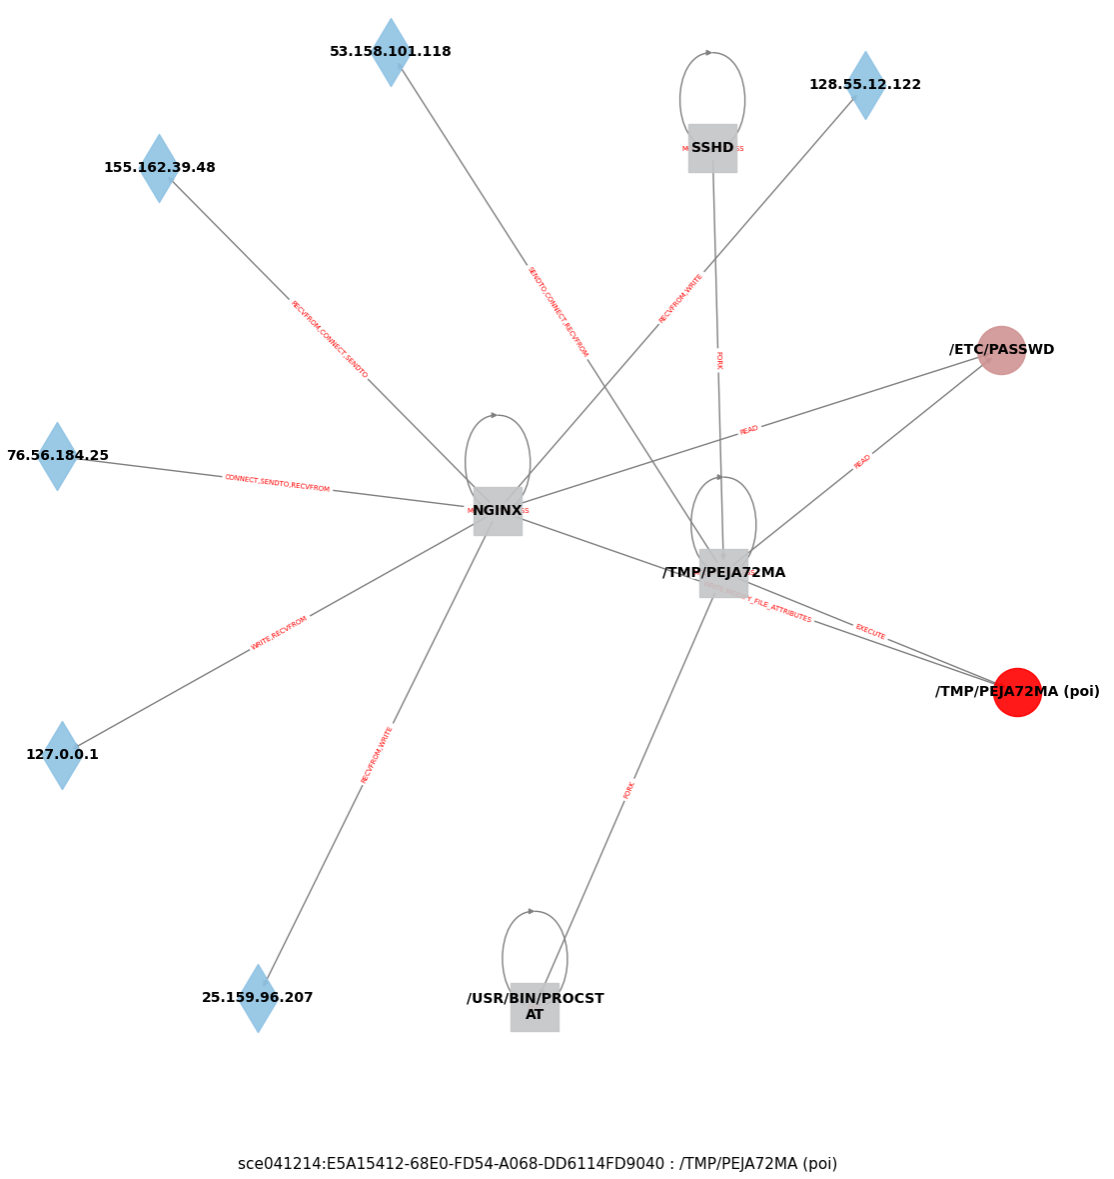
Visualice los grafos de amenazas muestreados por el módulo PPG.
Uso:
Coloque los datos de los grafos de amenazas en el directorio correspondiente del conjunto de datos:
dataset/darpa_cadets/sgs_demo/sce041214_E5A15412-68E0-FD54-A068-DD6114FD9040_2.txt # The case provided for visualization
Prepare el archivo de mapeo (p. ej., names.json), que se puede generar automáticamente ejecutando dataset_preprocess.py (consulte el flujo de trabajo del Módulo de detección de amenazas)
Modifique las rutas del conjunto de datos en subgraph_vision.py y ejecute el script de visualización:
python subgraph_vision.py
Especifique el conjunto de datos correspondiente en el script. El programa leerá y visualizará automáticamente los datos de subgrafos del directorio sgs_demo.
Ejemplo de resultado de visualización:
| Conjunto de datos | Archivos de registro | Plataforma | Enlace de descarga |
|---|---|---|---|
| E3-Cadets | ta1-cadets-e3-official-1.json.{0-4} | FreeBSD | DARPA E3 |
| E3-Theia | ta1-theia-e3-official-6r.json.{0-12} | Linux | DARPA E3 |
| E3-Trace | ta1-trace-e3-official.json.{0-203} | Linux | DARPA E3 |
| E5-Theia | ta1-theia-1-e5-official-2.bin.{27-31} | Linux | DARPA E5 |
| E5-Clearscope2_1 | ta1-clearscope-2-e5-official-1.bin.{15-20} | Android | DARPA E5 |
| E5-Clearscope2_2 | ta1-clearscope-2-e5-official-1.bin.{24-33} | Android | DARPA E5 |
| OPTC | benign/20-23Sep19/AIA-201-225/{*} | Windows | OpTC |
Coloque los archivos descargados en el directorio del proyecto siguiendo esta estructura:
datasets/darpa_{dataset_name}/raws/xx.json
python preprocess/dataset_preprocess.py # Extract triple information from raw datasets:
Esto genera los archivos de tuplas en:
datasets/darpa_{dataset_name}/tuples/xx.txt
python preprocess/parse_trace.py
python pretrain_gmpt_cl.py --mode={dataset_name} --eval=False
Nota: Los parámetros adicionales (p. ej., épocas, tasa de aprendizaje) pueden encontrarse en la función parse_args() del archivo util.py.
python pretrain_gmpt_cl.py --mode={dataset_name} --eval=True
El modelo cargará sus parámetros desde models/{dataset_name}/best.pth.
El proyecto incluye muestras preprocesadas del conjunto de datos CADETS para pruebas inmediatas:
# Direct evaluation (using pre-trained model)
python pretrain_gmpt_cl.py --mode=cadets --eval=True

# Re-train the model
python pretrain_gmpt_cl.py --mode=cadets --eval=False
python pretrain_gmpt_cl.py --mode=cadets --eval=True
Ejemplo de resultados de evaluación :

ProHunter/
├── dataset/
│   └── darpa_cadets/              # Example dataset
│       ├── raws/                  # Raw dataset files
│       ├── sgs_demo/
│       ├── test/
│       ├── train/
│       ├── tuples/                # Extracted tuples
│       ├── edge_type_map.json
│       ├── names.json             # UUID to name mapping
│       ├── node_type_map.json
│       └── types.json             # UUID to type mapping
├── models/
│   └── {dataset_name}/
│       └── best.pth               # Trained model parameters
├── preprocess/                    # Data preprocessing scripts
├── subgraph/
├── batch.py
├── darpa_loader.py                # DARPA data loader
├── darpa_model.py
├── dataloader.py                  # Data loading utilities
├── graph_matching.py
├── pretrain_gmpt_cl.py            # Main training & evaluation script
├── splitters.py
├── util.py                        # Utility functions & arguments
├── requirements.txt               # Dependencies
└── readme.md
