 ucsb-mlsec/vulnllm-r
LLM de razonamiento especializado para la detección de vulnerabilidades en código fuente en C/C++ y Python, con construcción de conjuntos de datos, entrenamiento SFT/DPO y scripts de reproducción de resultados.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
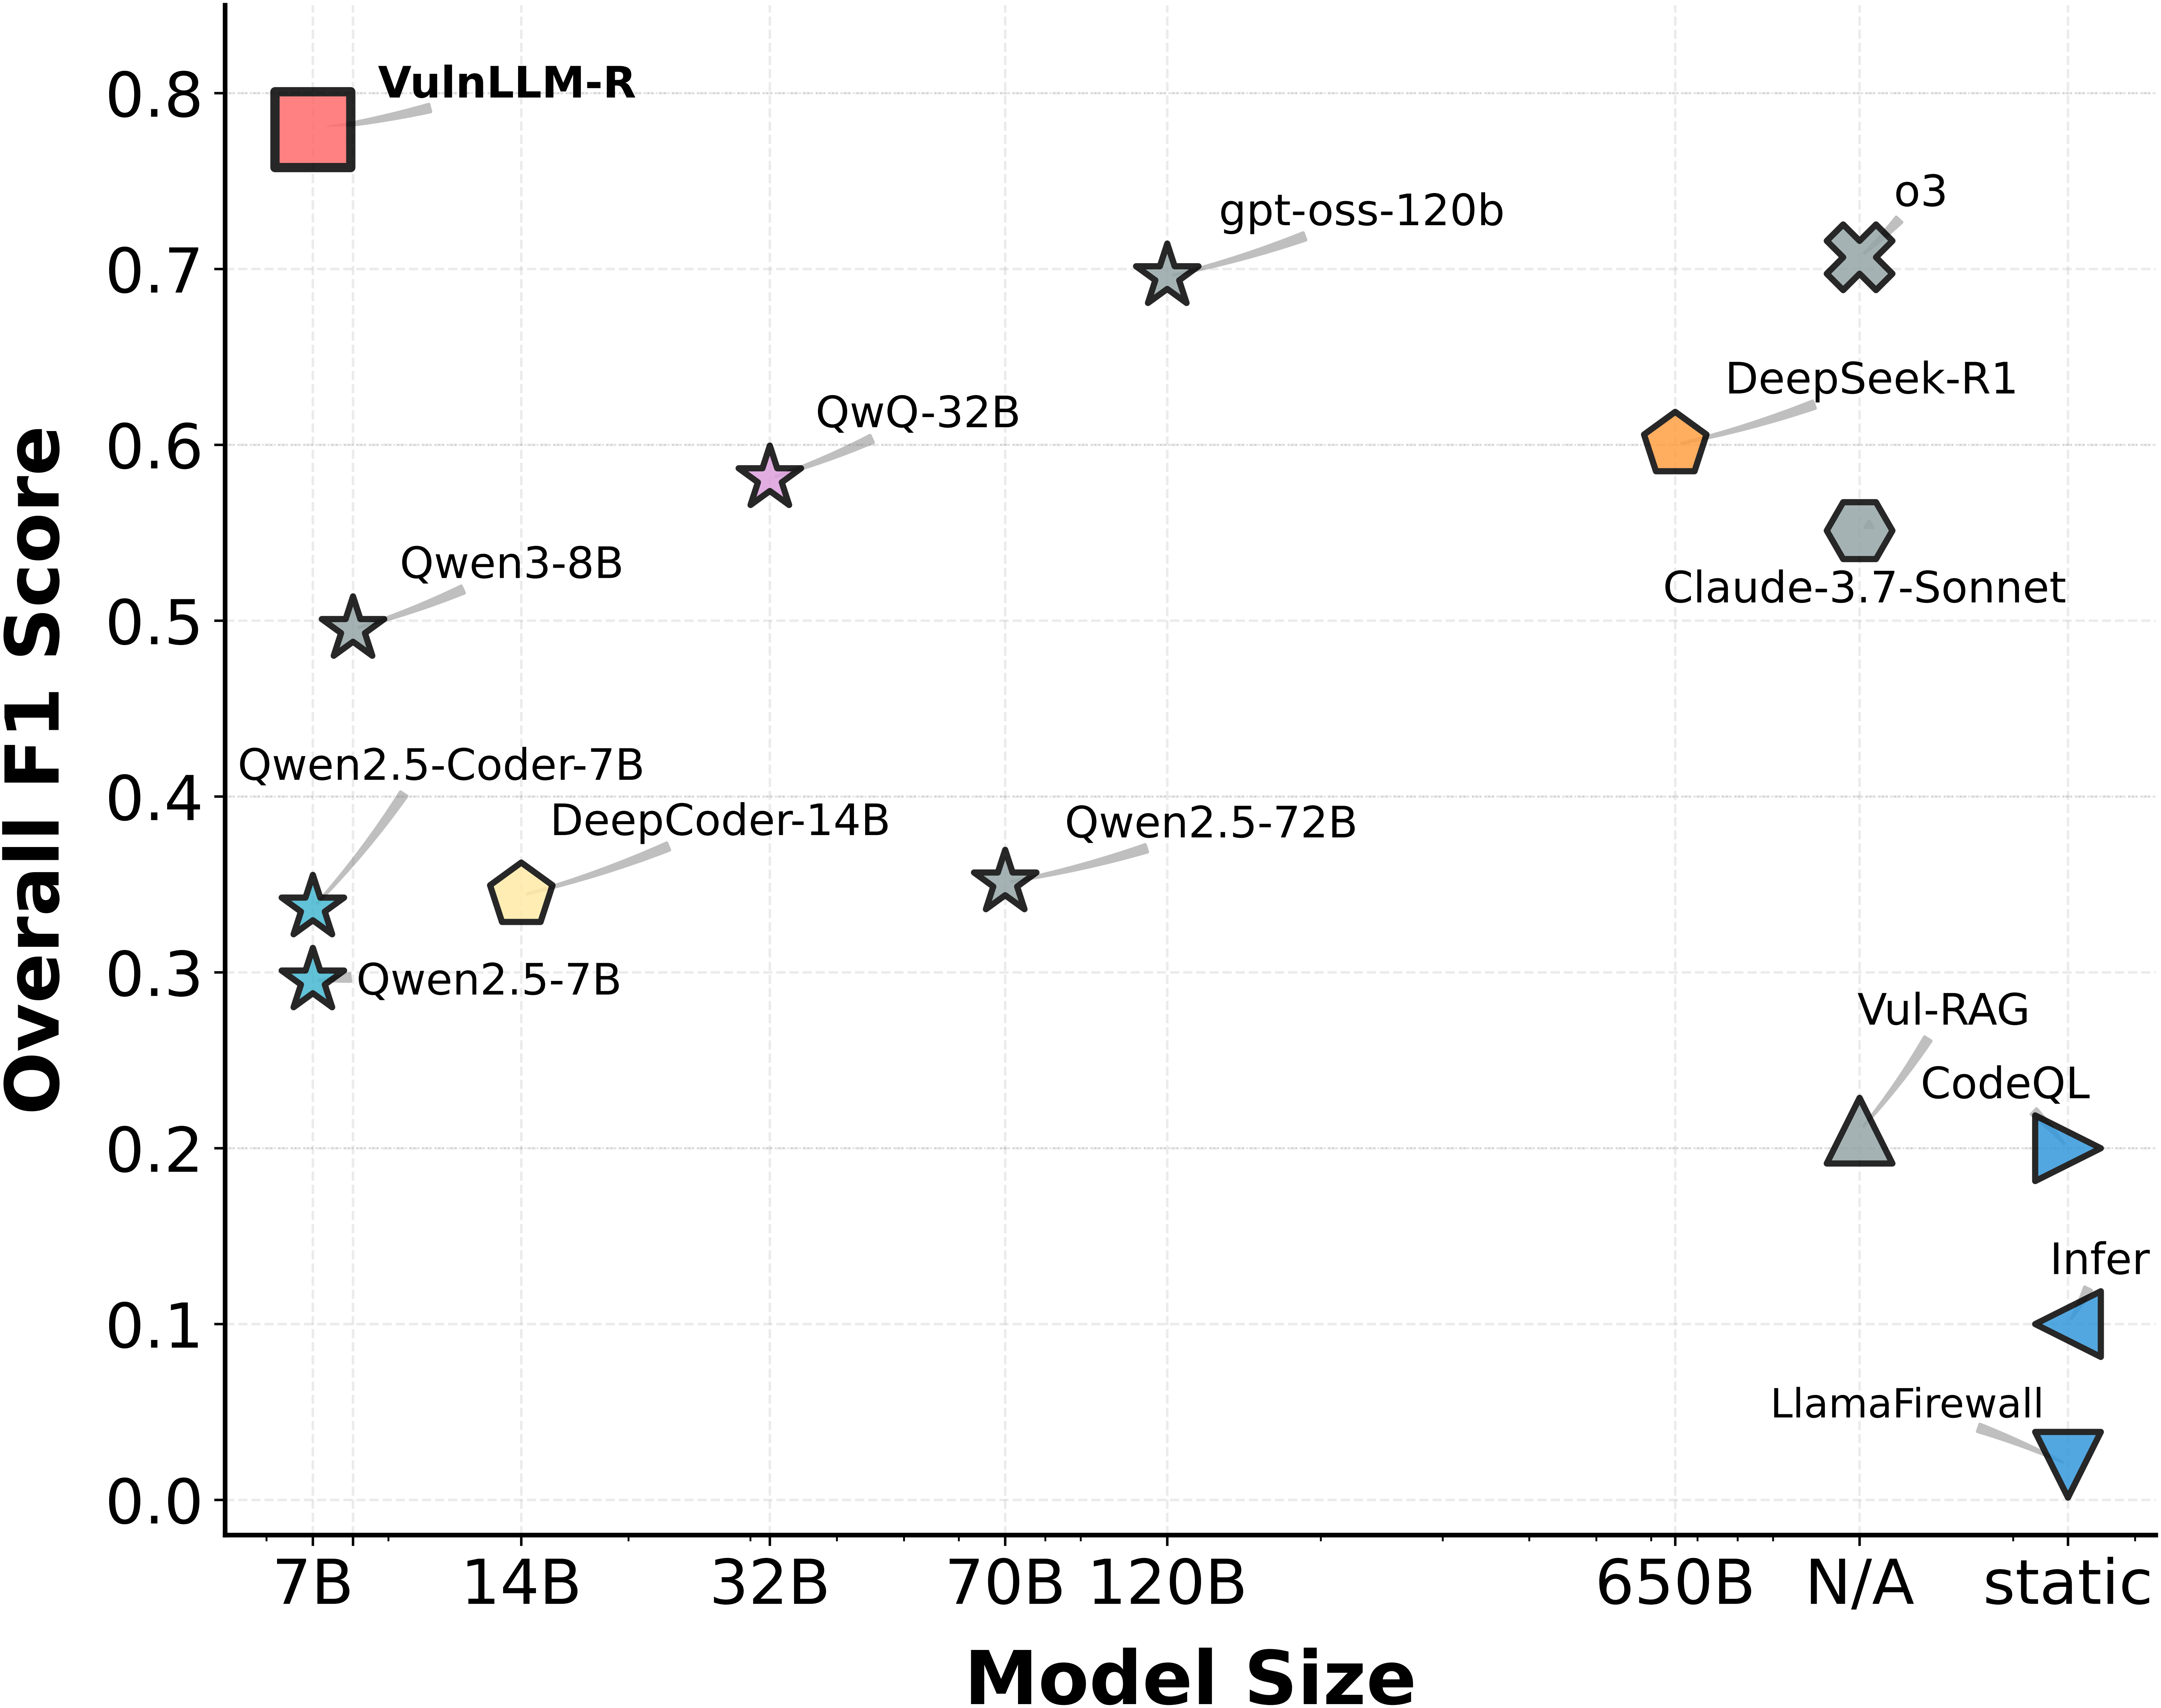
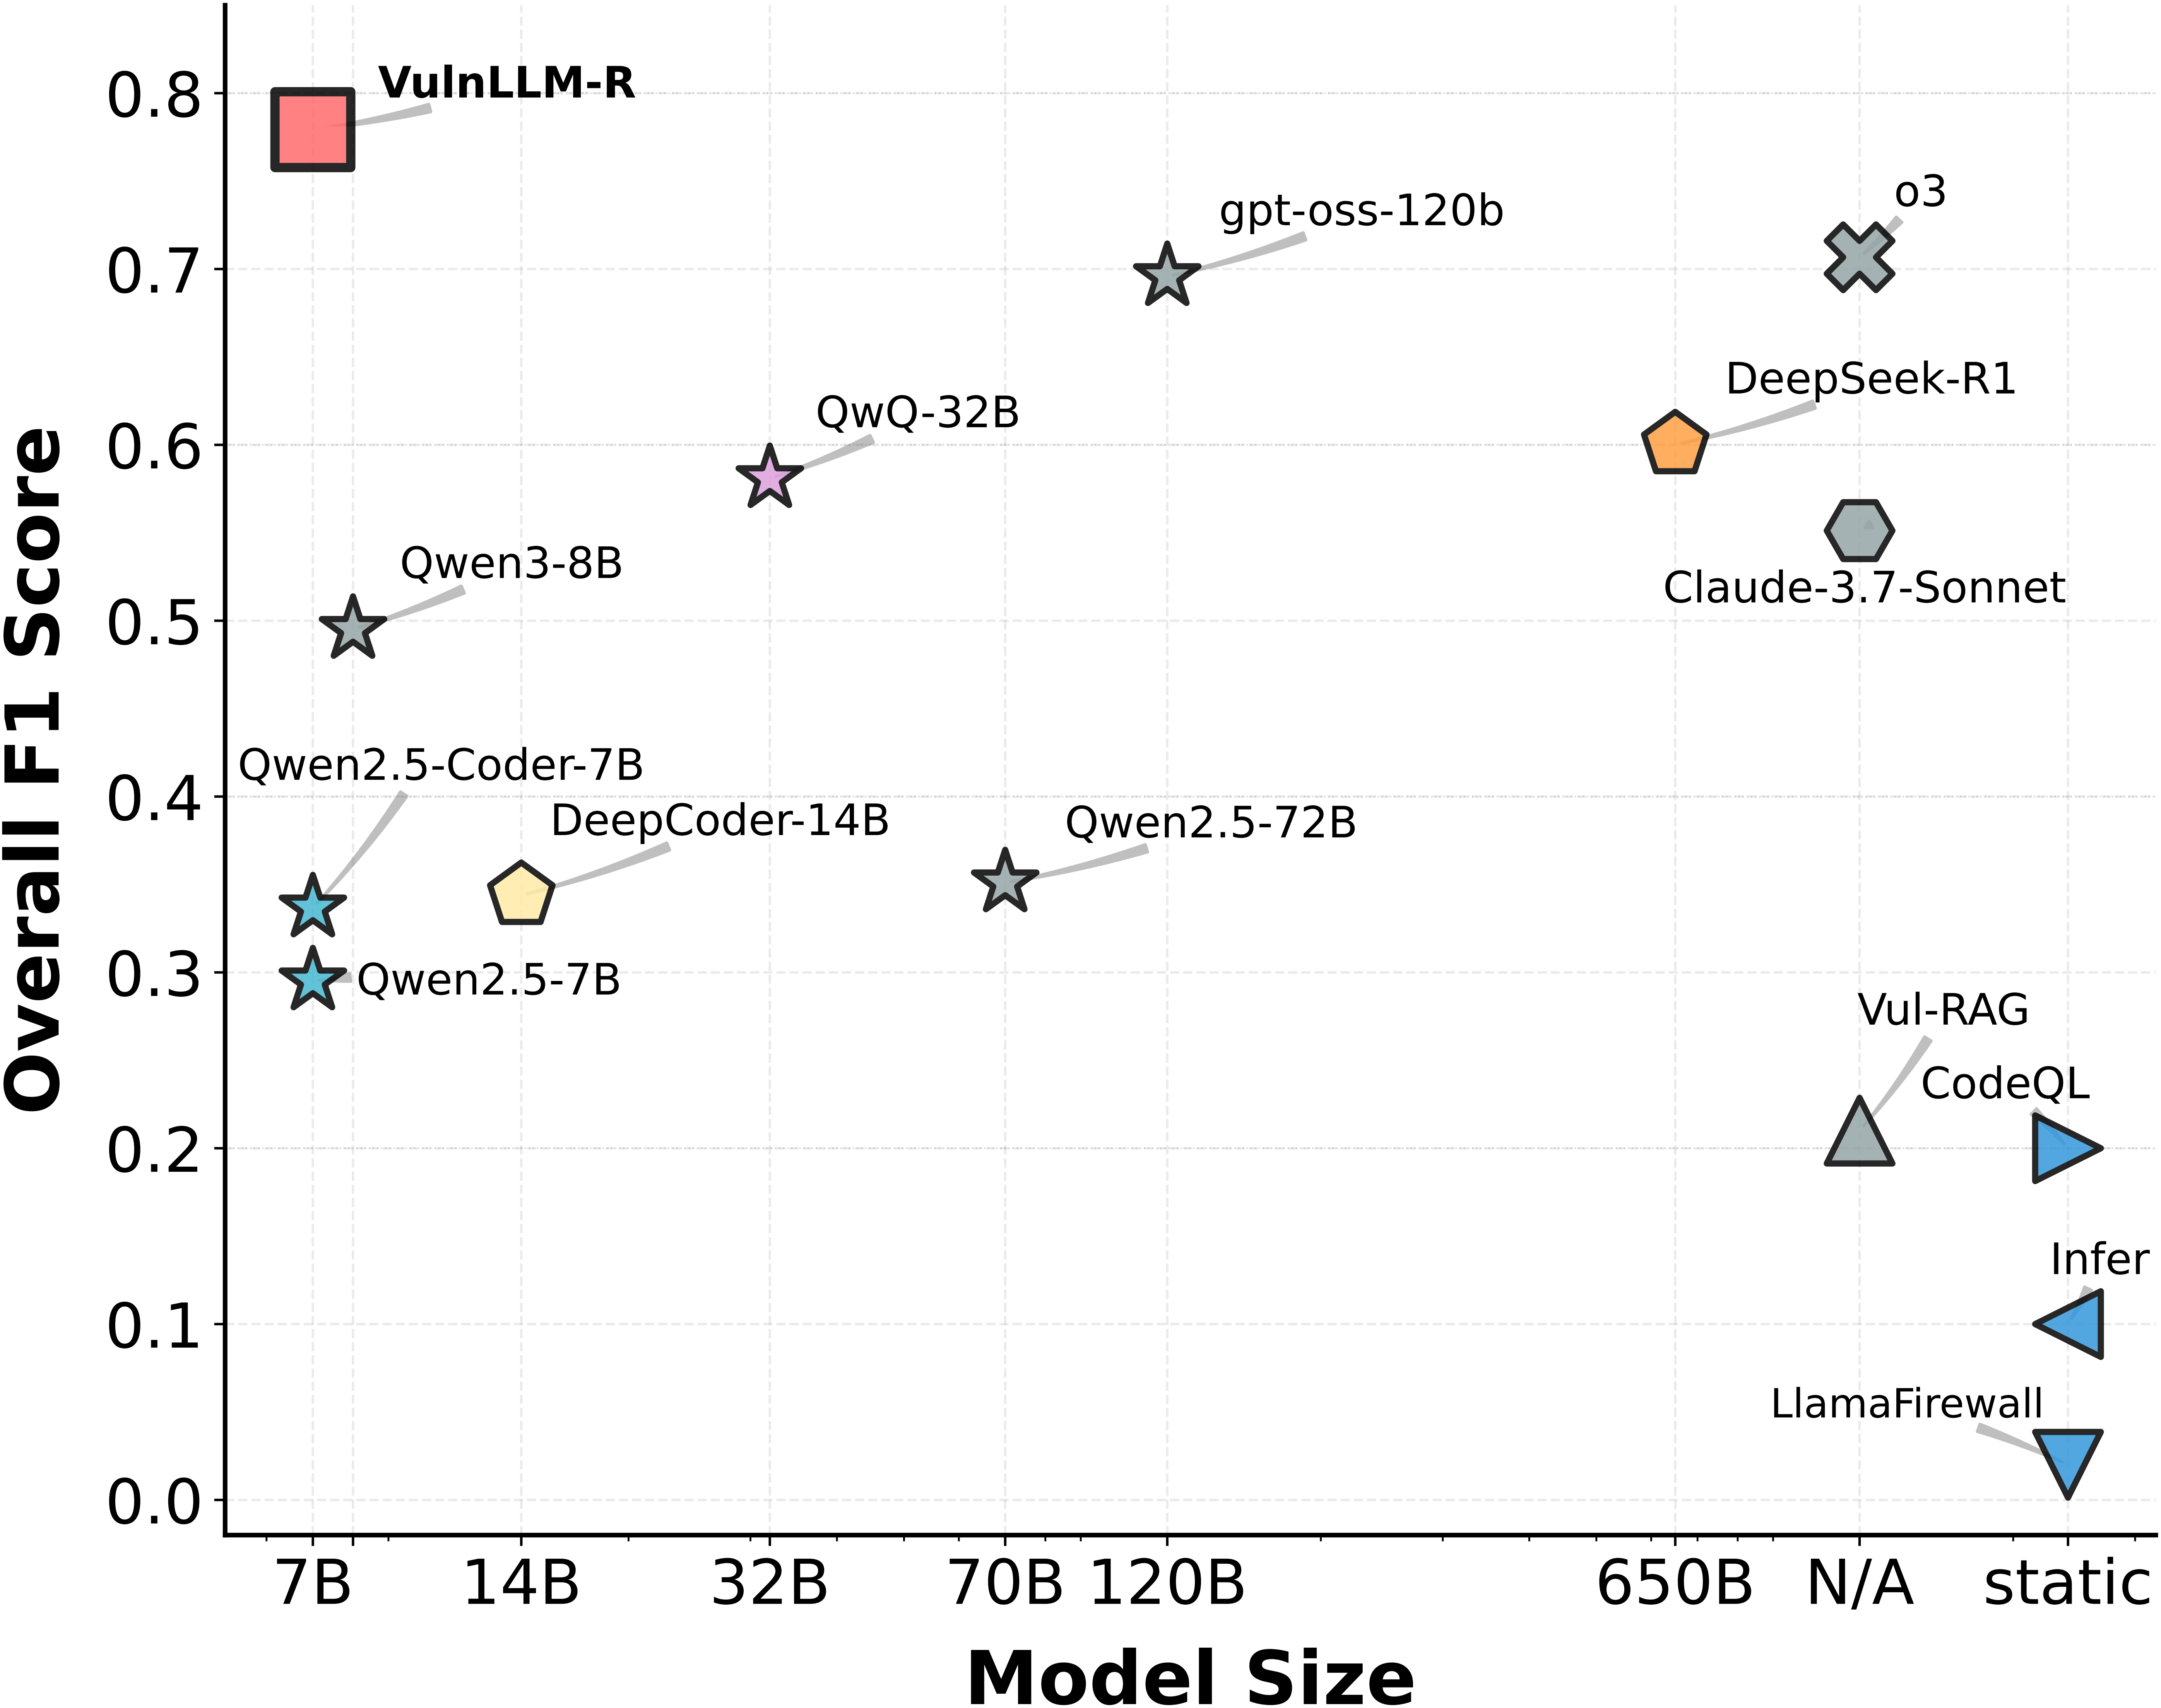
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
También proporcionamos la versión de razonamiento reducido de los conjuntos de datos destilados:
Fusionar los conjuntos de datos existentes de detección de vulnerabilidades a nivel de función: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], y Arvo [5]. Dentro de estos conjuntos de datos, PrimeVul tiene las funciones más complicadas. Creamos dos conjuntos de entrenamiento: limpio (sin PrimeVul) y ruidoso (con PrimeVul), de modo que podemos entrenar en conjuntos de datos relativamente simples y probar en el complejo conjunto de datos PrimeVul. Tenga en cuenta que llamamos ruidoso al conjunto de entrenamiento con PrimeVul no porque el conjunto de datos sea ruidoso. Es un nombre relativamente arbitrario que usamos al principio.
vulscan/data_process/data_utils contiene un conjunto de scripts para procesar y fusionar los
conjuntos de datos.
raw_to_us.py: Fusionar los datos brutos en nuestro conjunto de datos y eliminar datos redundantescheck_cwe_correct.py: Calcular la precisión para cada categoría de CWEgenerate_arvo_raw_data.py: Generar datos brutos estructurados a partir del conjunto de datos arvoarvo_to_us.py: Reformatear los datos brutos estructurados de arvo al formato de nuestro conjunto de datossplit_good_bad_for_juliet.py: Extraer datos del conjunto de datos Juliet 1.3 original y convertirlos al formato requerido,
que forma parte de nuestro c clean_datasetadd_sven_to_clean_dataset.py: Extraer datos del conjunto de datos Sven, que forma parte de nuestro C clean datasetsync_large_small.py: Sincronizar las modificaciones de noisy_dataset/large_train/c a
noisy_dataset/small_train/cremove_testing_from_training.py: Agregar la etiqueta human a cada dato, lo que significa que el punto ha sido verificado por
humanos y se usa como dato de prueba
-data_utils.py: Agregar el campo related_cwe al conjunto de datos.datasets/clean_dataset: los datos de entrenamiento sin PrimeVul
datasets/clean_dataset/python contiene los datos de SVEN y SecCodePLTdatasets/clean_dataset/c contiene los datos de Juliet y SVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train: Contiene los datos de entrenamiento de PrimeVul y SVEN con CWEs seleccionados (
usamos los datos de PrimeVul en este conjunto como entrenamiento)datasets/noisy_dataset/large_train: Contiene los datos de entrenamiento de PrimeVul, SVEN y SecCodePLT con
más CWEs (este conjunto puede usarse más adelante para entrenar modelos más grandes)datasets/noisy_dataset/test: Un pequeño conjunto de prueba de PrimeVul verificado por humanosdatasets/test
datasets/test/test_clean: Los datos de prueba de SVEN, SecCodePLT y Juliet; con CWEs OOD que no forman
parte del conjunto de entrenamientodatasets/test/test_primevul_pair: Los datos de prueba originales de PrimeVulvulscan/data_process/data_utils/get_cwe_stat.py para obtener el histograma del conjunto de datos