 suraj-ranganath/stealthrl
StealthRL: framework de RL para parafrasear texto de IA de forma adversaria y poner a prueba la robustez de los detectores.

Artículo (arXiv)
Demo
Modelo (Hugging Face)
Dataset de Referencia (Hugging Face)
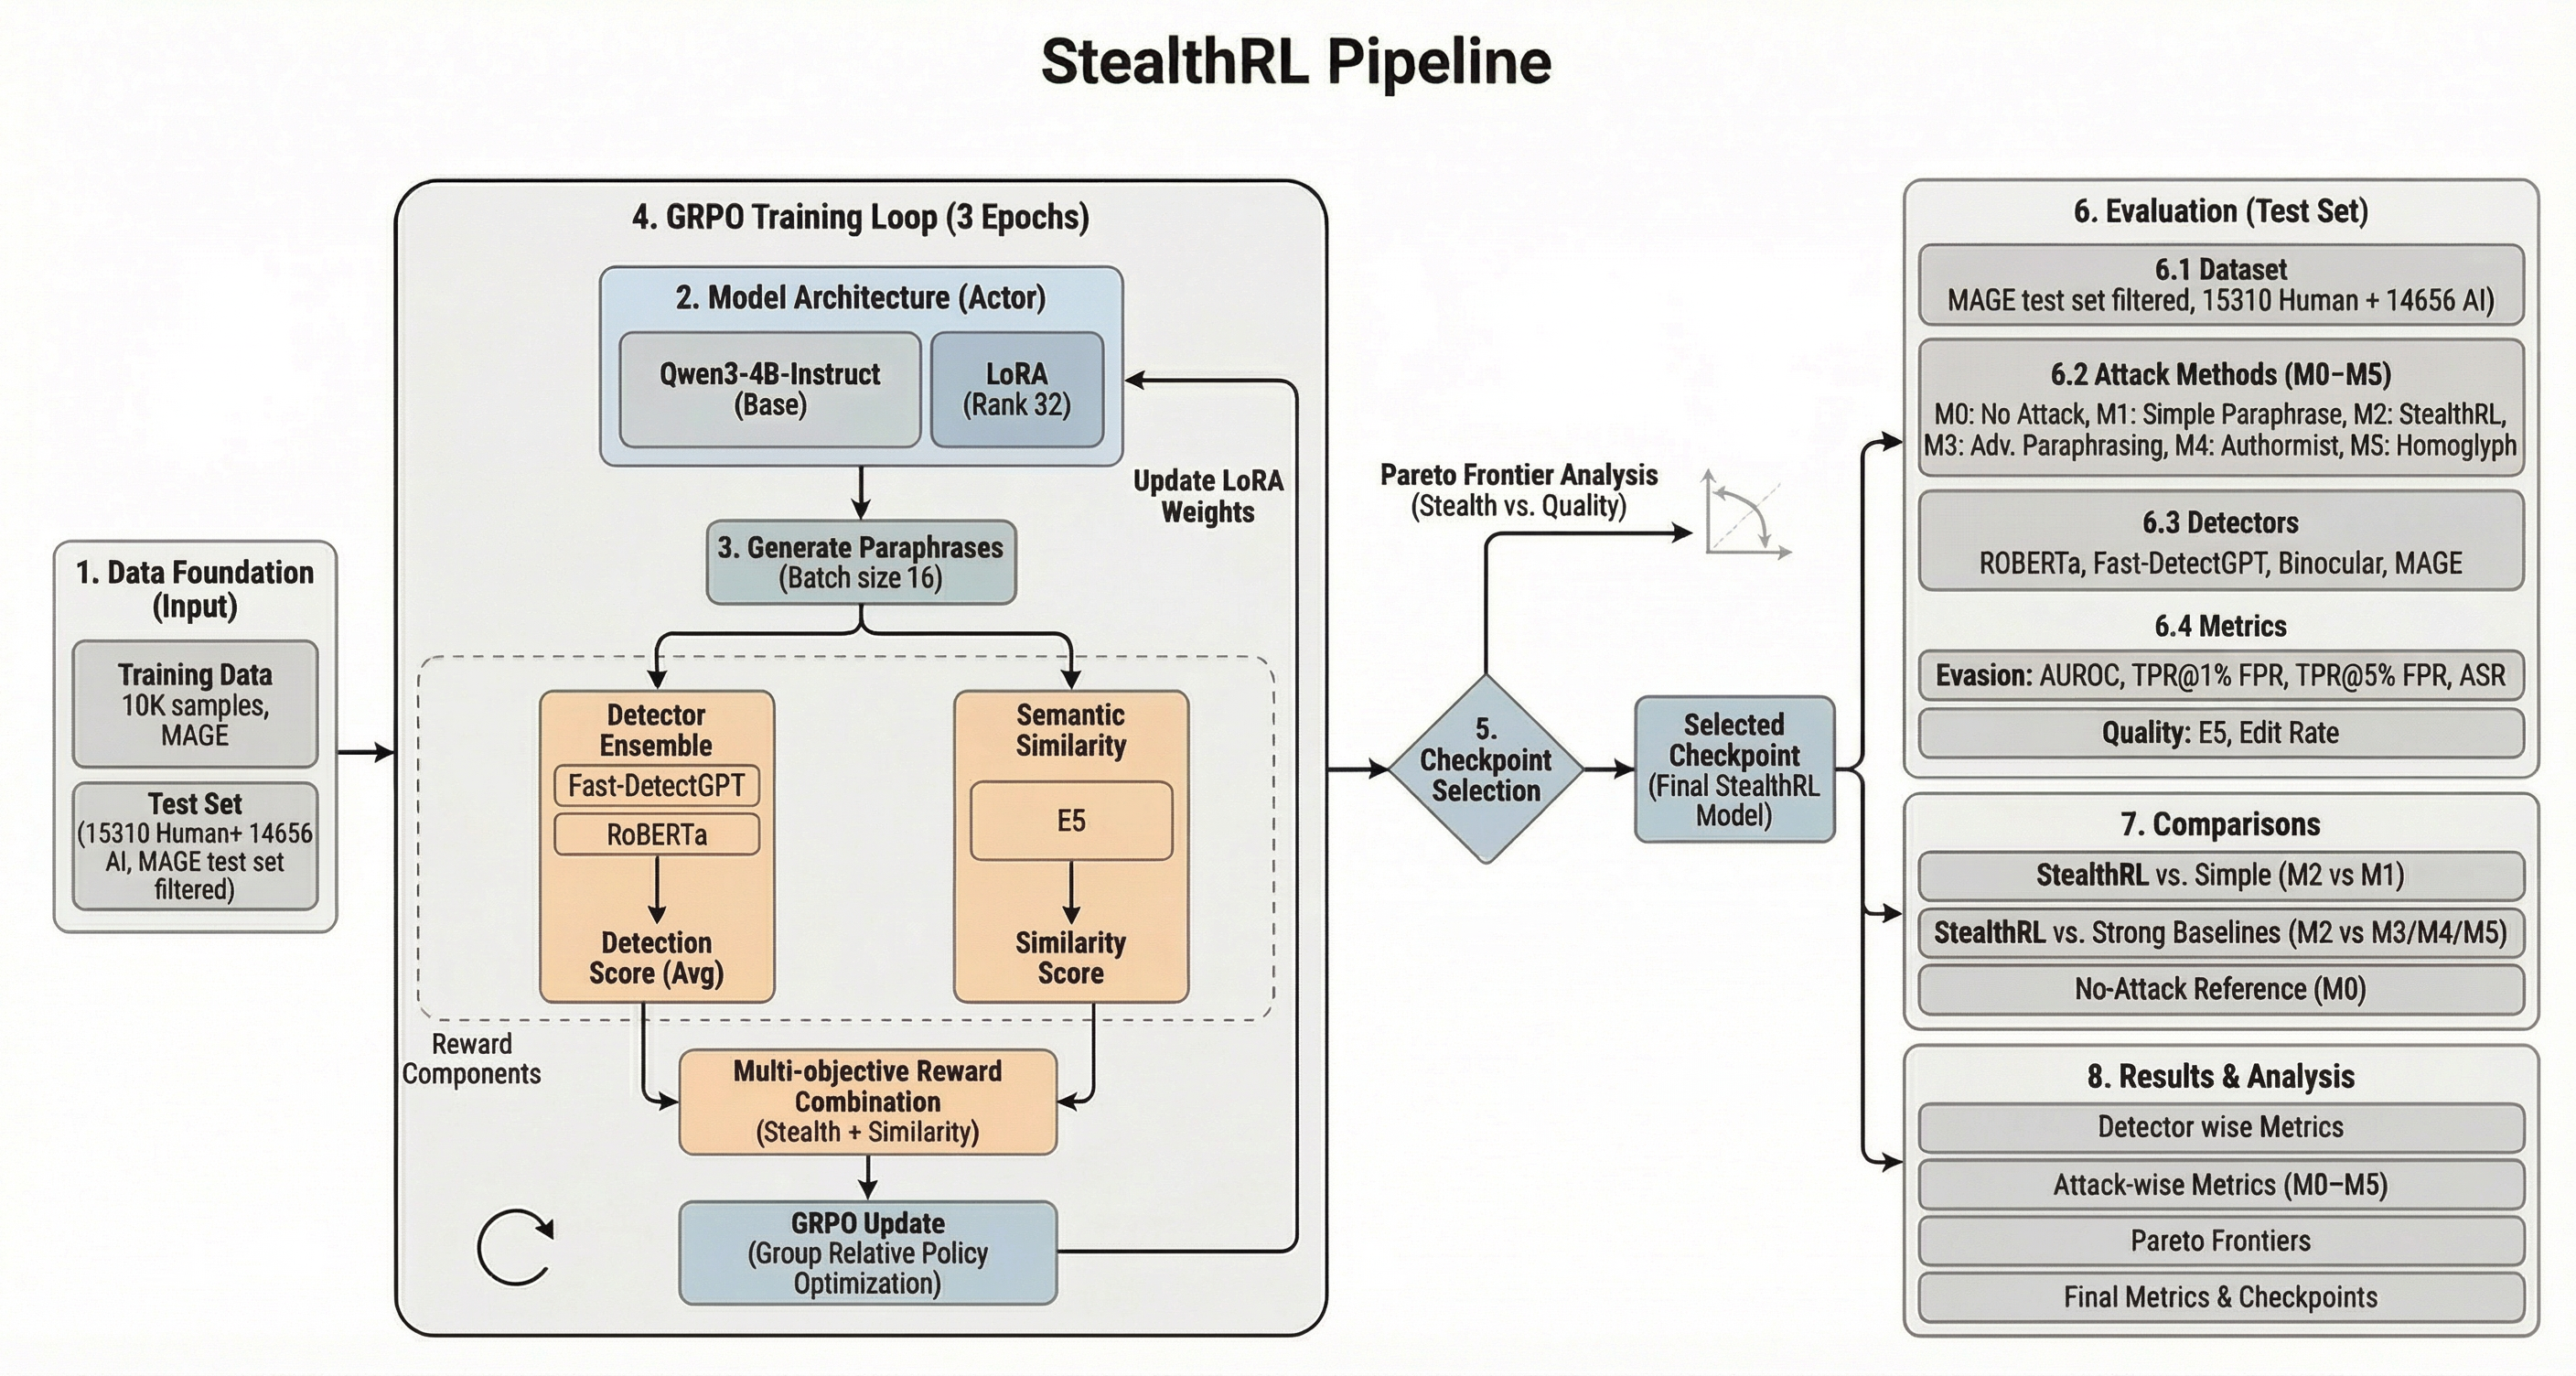
Los detectores de texto IA se utilizan cada vez más en entornos de alto riesgo, pero su robustez frente a la reescritura adversarial que preserva el significado sigue siendo incierta. Presentamos StealthRL, un marco de aprendizaje por refuerzo para poner a prueba los detectores de texto IA con ataques de paráfrasis adaptativos. StealthRL entrena una política de paráfrasis contra un conjunto de detectores mientras preserva el contenido semántico, y luego evalúa la transferencia a familias de detectores no vistas durante el entrenamiento. En el conjunto completo filtrado de prueba MAGE (15,310 humanos / 14,656 IA), StealthRL reduce el AUROC medio de 0.79 a 0.43 y alcanza un TPR@1%FPR medio de 0.024 en RoBERTa, Fast-DetectGPT, Binoculars y MAGE. El ataque se transfiere a dos detectores no utilizados durante el entrenamiento, lo que expone vulnerabilidades compartidas en lugar de un fallo de un solo detector. Además, analizamos las distribuciones de puntuaciones de los detectores y evaluamos la calidad con E5, BERTScore y valoraciones Likert basadas en LLM. Nuestros resultados muestran que los detectores de texto IA actuales siguen siendo frágiles bajo una presión realista de paráfrasis y proporcionan un protocolo reproducible para la evaluación de robustez adversarial.
Este repositorio es la base de código de investigación e ingeniería detrás de StealthRL. Contiene:
El repositorio pretende ser un punto de partida útil para investigadores que quieran:
stealthrl/: código de entrenamiento, envoltorios de detectores, recompensas, utilidades de datos y el paquete StealthBench originaleval/: infraestructura de evaluación de nivel de investigación utilizada para los resultados del artículoscripts/: puntos de entrada ejecutables para entrenamiento, evaluación, orquestación, gráficos y utilidadesconfigs/: configuraciones YAML para entrenamiento, evaluación y ablacionesfigures/: diagramas del pipeline y recursos estáticostests/: pruebas de integración y comprobaciones de corduraanalysis/: ayudas de análisis ad hoc y utilidades puntualespython -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
Según las partes del proyecto que quieras ejecutar, también puedes necesitar:
pip install tinker
pip install openai
pip install vllm
Notas:
tinker es necesario para la ruta de inferencia del checkpoint de StealthRL respaldada por la nube utilizada por M2.openai solo se requiere para el paso de evaluación de calidad GPT/Likert.vllm se recomienda para la generación local rápida en los baselines del artículo.Variables de entorno típicas utilizadas por el repositorio:
export HF_HOME=$HOME/.cache/huggingface
export TRANSFORMERS_CACHE=$HF_HOME
export OPENAI_API_KEY=...
export TINKER_API_KEY=...
Para el pipeline de evaluación del artículo por etapas, utilizamos un archivo env además de un JSON descriptor de checkpoint. Los scripts públicos te permiten sobrescribir ambas rutas explícitamente:
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_eval.py --quick
python scripts/run_stealthbench.py --config configs/stealthbench.yaml
Ahora carga los archivos de texto configurados, ejecuta los detectores configurados, guarda las salidas CSV y genera gráficos de comparación. El antiguo stub de solo TODO se ha eliminado.
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_public \
  --gpus 0 1 2 3
El repositorio incluye un sitio web de demostración respaldado por FastAPI en demo/. Ofrece una interfaz estática pulida y expone POST /api/paraphrase con soporte de clave API además de una cuota pública de 20/día para usuarios no autenticados.
pip install -r demo/requirements.txt
uvicorn demo.stealthrl_demo.app:app --reload --port 8080
De forma predeterminada, la demo se ejecuta en modo mock de costo cero para probar la interfaz. Para usar el sampler real de StealthRL, establece STEALTHRL_DEMO_INFERENCE_BACKEND=tinker, STEALTHRL_DEMO_CHECKPOINT_JSON y TINKER_API_KEY. Consulta demo/README.md para obtener notas sobre clave API, cuota, Docker e implementación en AWS.
El artículo presenta resultados sobre el conjunto completo filtrado de evaluación MAGE:
El pipeline de evaluación de nivel de investigación está implementado en el módulo eval/ junto con los scripts por etapas en scripts/.
Prepara las credenciales y los metadatos del checkpoint.
Crea un archivo env que contenga OPENAI_API_KEY y TINKER_API_KEY, y un JSON de checkpoint que describa la ruta del sampler Tinker de StealthRL.
Ejecuta el preflight.
python scripts/preflight_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_repro \
  --gpus 0 1 2 3
Inspecciona las salidas de métodos generadas, las puntuaciones de los detectores, las métricas y los gráficos en el directorio de ejecución elegido.
Si solo necesitas volver a ejecutar la evaluación de calidad basada en GPT sobre salidas en caché:
python scripts/run_gpt_quality_only.py \
  --run-root outputs/eval_runs/full_mage_repro \
  --env-file ~/.config/stealthrl/eval.env
python scripts/compute_bertscore_for_run.py \
  --run-dir outputs/eval_runs/full_mage_repro/assembled \
  --device cuda:0 \
  --batch-size 16 \
  --chunk-size 512
