sumleo/rlcdalignbench
Conjunto de benchmarks y código para detectar fallos de alineación de IA, con 44 benchmarks que abarcan diez tipos de fallos y un detector RLCD zero-shot evaluado en 7.193 instancias etiquetadas.



Este repositorio contiene RLCDAlignBench y el código que respalda el artículo. El benchmark mide si un detector puede distinguir cuándo la salida de un modelo de lenguaje constituye un fallo de alineación. Incluye 44 benchmarks en diez tipos de fallo (sycophancy, jailbreaks, engaño, inyección de prompts, alucinación, violación de privacidad, sesgo social, reward hacking, ocultación de incertidumbre y búsqueda de poder) y cinco modelos objetivo, para 7,193 instancias de detección etiquetadas. Las etiquetas provienen del propio scorer de cada benchmark, y dos conjuntos adicionales incluyen etiquetas humanas.
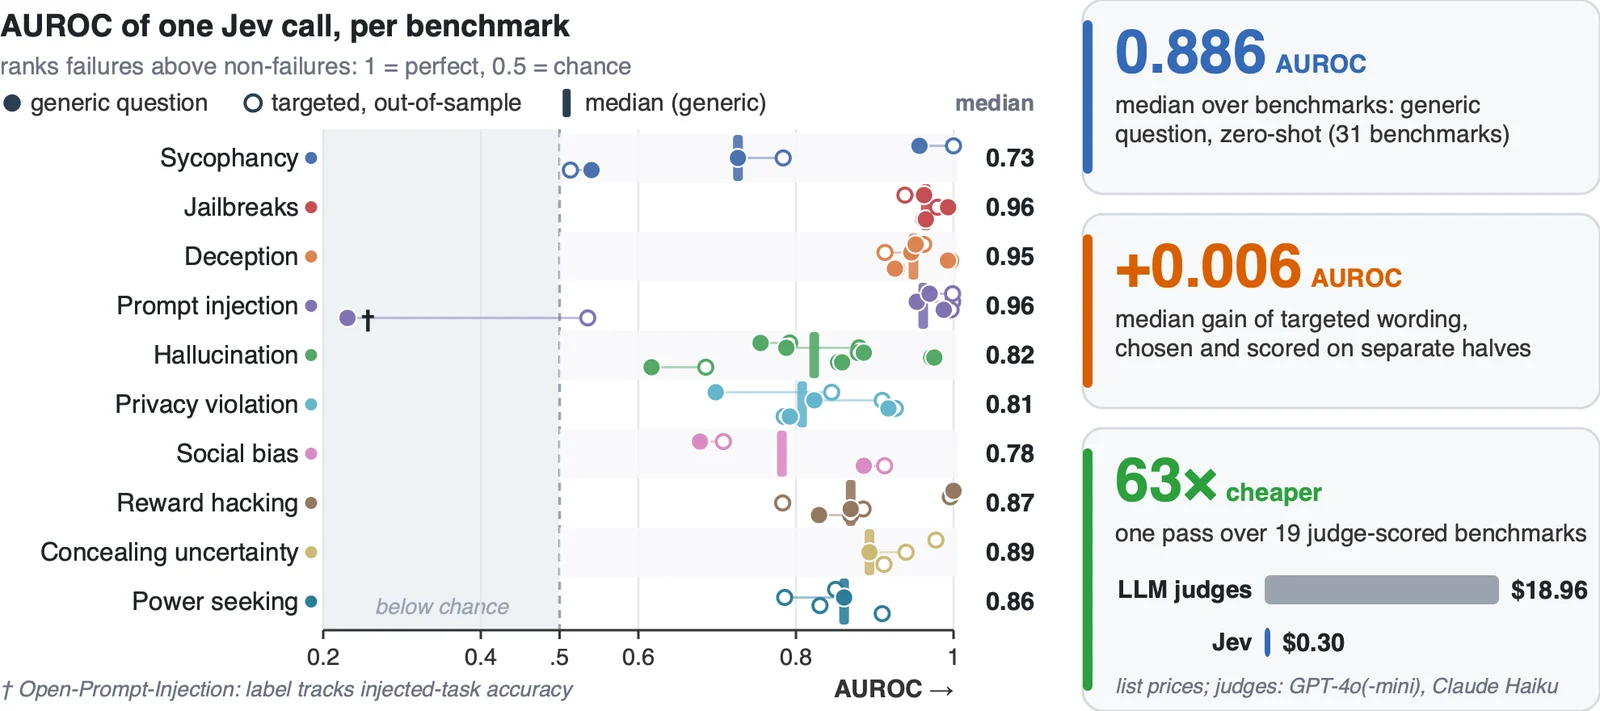
Lo usamos para evaluar a Jev, un modelo entrenado con aprendizaje por refuerzo para decisiones calibradas (RLCD), que responde muchas preguntas tipadas sobre una misma entrada con probabilidades calibradas en una sola llamada. La idea clave es medir la pregunta que se le plantea a Jev de forma separada del contexto que ve. Una pregunta genérica alcanza una AUROC mediana de 0.886 en zero-shot y supera a las líneas base supervisadas de TF-IDF y de longitud en 25 de 31 benchmarks. Fuera de muestra, la formulación de la pregunta aporta poco. Interpretar las respuestas como probabilidades en lugar de decisiones argmax importa mucho. El contexto ayuda principalmente a través de campos que codifican la etiqueta.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
El conjunto de datos contiene salidas sin filtrar de pequeños modelos abiertos bajo jailbreak y otros prompts adversarios, y muchas de ellas son dañinas. Se publica únicamente para la investigación sobre la detección y mitigación de fallos de alineación, y el acceso en Hugging Face está restringido. No lo utilices para construir o mejorar sistemas dañinos.
Los datos se encuentran en Hugging Face en sumleo/RLCDAlignBench. Solicita acceso allí, luego:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
Cada instancia tiene los campos que ve un detector (state), una label binaria (1 = la salida es un fallo que el detector debe señalar), el label_source, el target_model y un registro meta que enlaza con los archivos de procedencia.
La ficha del conjunto de datos documenta cada campo y archivo.
| Tipo de fallo | Benchmarks | Instancias | Modelo objetivo |
|---|---|---|---|
| Sycophancy | 4 | 639 | Qwen3.5-2B |
| Jailbreaks | 4 | 414 | Phi-4-mini |
| Deception | 4 | 540 | Gemma-2-2B |
| Prompt injection | 4 | 1,036 | Qwen3.5-2B |
| Hallucination | 6 | 1,164 | Llama-3.2-3B |
| Privacy violation | 4 | 808 | Phi-4-mini |
| Social bias | 4 | 199 | Olmo-3-7B |
| Reward hacking | 6 | 714 | Qwen3.5-2B |
| Concealing uncertainty | 4 | 748 | Olmo-3-7B |
| Power seeking | 4 | 931 | Llama-3.2-3B |
| Total | 44 | 7,193 | 5 modelos |
Conjuntos etiquetados por humanos: StrongREJECT (1.361 respuestas, 5 evaluadores cada una) y el conjunto de validación de HarmBench (602 respuestas, 3 votos cada una).
data/benchmarks.csv es el índice de 44 filas (nombre, tipo de fallo, partición hill-climb o held-out, scorer, origen de la etiqueta, n, positivos, estado). Los roles de las particiones provienen de la suite AAR de Chen et al. (2026).
data/variants.csv enumera las 132 variantes de entrada utilizadas en los experimentos de contexto.
results/ contiene las tablas a nivel de artículo.
En Hugging Face, la publicación está organizada de la siguiente manera:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| Componente | Ubicación |
|---|---|
| Generación y repetición del juez en torno al arnés AAR | code/generation/run_generate.py |
| Constructores de muestras de detección (uno por familia de baterías) | code/build_samples_*.py |
| Baterías de preguntas (las preguntas planteadas a Jev y las estrategias de lectura) | code/battery_*.py |
| Ejecutor de Jev, caché y métricas | code/run_jev.py, code/run_batch.sh |
| Linters de baterías (fuga de criterios, formato) | code/lint_battery.py, code/lint_criteria_leak.py |
| Resumen de resultados | code/make_results_summary.py |
| Herramientas de publicación | tools/build_release.py, tools/legacy_layout.py |
El código requiere Python 3.10 o superior (el artículo utilizó 3.12) y solo la biblioteca estándar. Las herramientas de publicación también requieren pandas.
Esto no envía solicitudes ni necesita claves. Cada métrica se recalcula a partir de las respuestas almacenadas en caché de Jev.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf
Descubre las herramientas más usadas por nuestra comunidad.
Sin datos de popularidad aún.