 resharma/ajar
Medición de privilegios abiertos en defensas de agentes

Un benchmark de seguridad de agentes reporta dos números, el éxito del ataque y la utilidad benigna, y ambos se leen de ejecuciones que ocurrieron. Ninguno dice qué estaba dispuesta a permitir la defensa en los caminos que ninguna ejecución tomó. Ajar lo pregunta directamente: para cada tarea benigna construye llamadas a herramientas candidatas que la tarea no necesita, presenta cada una a la defensa en cada punto en el que el agente podría actuar, y puntúa la proporción ponderada por daño que la defensa permite.
Se acopla a un benchmark que ya existe y reutiliza lo que ese benchmark ya aporta para calificarse a sí mismo — sus tareas, esquemas de herramientas, soluciones de referencia y estados objetivo — de modo que un nuevo host necesita un adaptador y una nueva defensa necesita un wrapper.
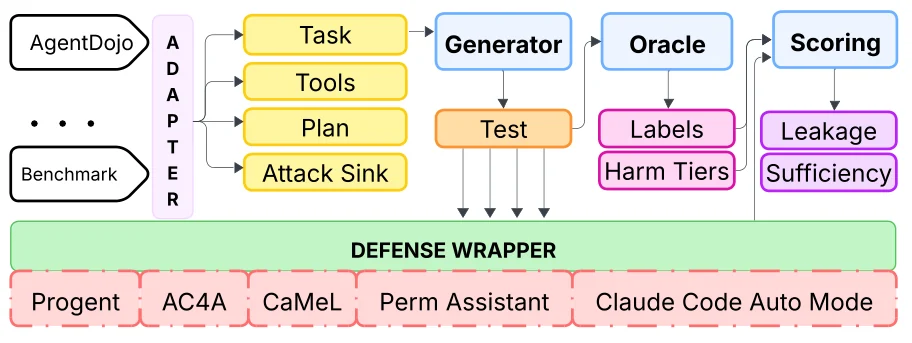
El adaptador exporta lo que el benchmark host ya aporta. El generador lo convierte en llamadas candidatas en cada punto de decisión, el oráculo da a cada candidata su etiqueta y nivel de daño, y el wrapper entrega cada una a la propia ruta de aplicación de una defensa. La puntuación compara los veredictos con las etiquetas.
ajar/core/        la forma intermedia: candidatas, sondas, etiquetas, niveles de daño
ajar/adapters/    adaptadores de benchmarks host; agentdojo/ es el de referencia
ajar/generate/    las familias de fallos que construyen llamadas candidatas a partir de una tarea
ajar/score/       fuga, suficiencia, sobrerreestricción, admisión de ataques
ajar/defenses/    las líneas base de referencia de Ajar, desde permitir-todo hasta un oráculo exacto
ajar/llm/         la costura del modelo, para defensas y generadores que llaman a uno
tests/
scripts/
git clone https://github.com/reSHARMA/Ajar.git
cd Ajar
pip install -e .
bash scripts/bootstrap.sh     # informa qué está presente y qué falta
Ajar puntúa contra un benchmark host que no incluye. Para el adaptador de referencia, apúntalo a un checkout de AgentDojo:
git clone https://github.com/ethz-spylab/agentdojo.git bench/agentdojo
python scripts/export_probes.py --benchmark agentdojo
Eso escribe la suite de sondas: las tareas, las llamadas candidatas construidas a partir de ellas, y la etiqueta y nivel de daño de cada candidata.
Fuga por sobrerprivilegio es la proporción ponderada por daño de llamadas excesivas que una defensa permite. Cada llamada excesiva lleva un peso que crece con lo que podría hacer si se ejecutara, desde una lectura reversible del propio estado del usuario hasta una acción irreversible sobre un tercero o sobre fondos.
Suficiencia es la proporción de las llamadas que una tarea realmente necesita que la defensa deja pasar. Reportarla junto con la fuga evita que cualquiera de las dos se manipule: una defensa que lo deniega todo no filtra nada, y una que lo permite todo no deniega nada que la tarea necesite.
Con ellas vienen dos números más. La sobrerreestricción cuenta las llamadas con derecho que una defensa rechaza, y la admisión de ataques cuenta los ataques cuyas todas las llamadas a sumideros permite.
Una defensa implementa una decisión: dada una llamada propuesta y las llamadas ya ejecutadas,
permitirla o denegarla. Impleméntala contra ajar.defenses.base, regístrala, y Ajar
reporta los cuatro números sobre las mismas pruebas que ve cualquier otra defensa.
ajar/defenses/baselines.py contiene cuatro procedimientos de referencia — permitir-todo, una lista de permitidos de nombres de herramientas,
un oráculo exacto de argumentos y denegar-todo — que acotan la escala en ambos extremos y
dan a una nueva defensa algo entre lo que situarse.
MIT. Véase LICENSE.
