 renatus-cartesius/reconswarm
Extiende tu reconocimiento con el poder de la nube

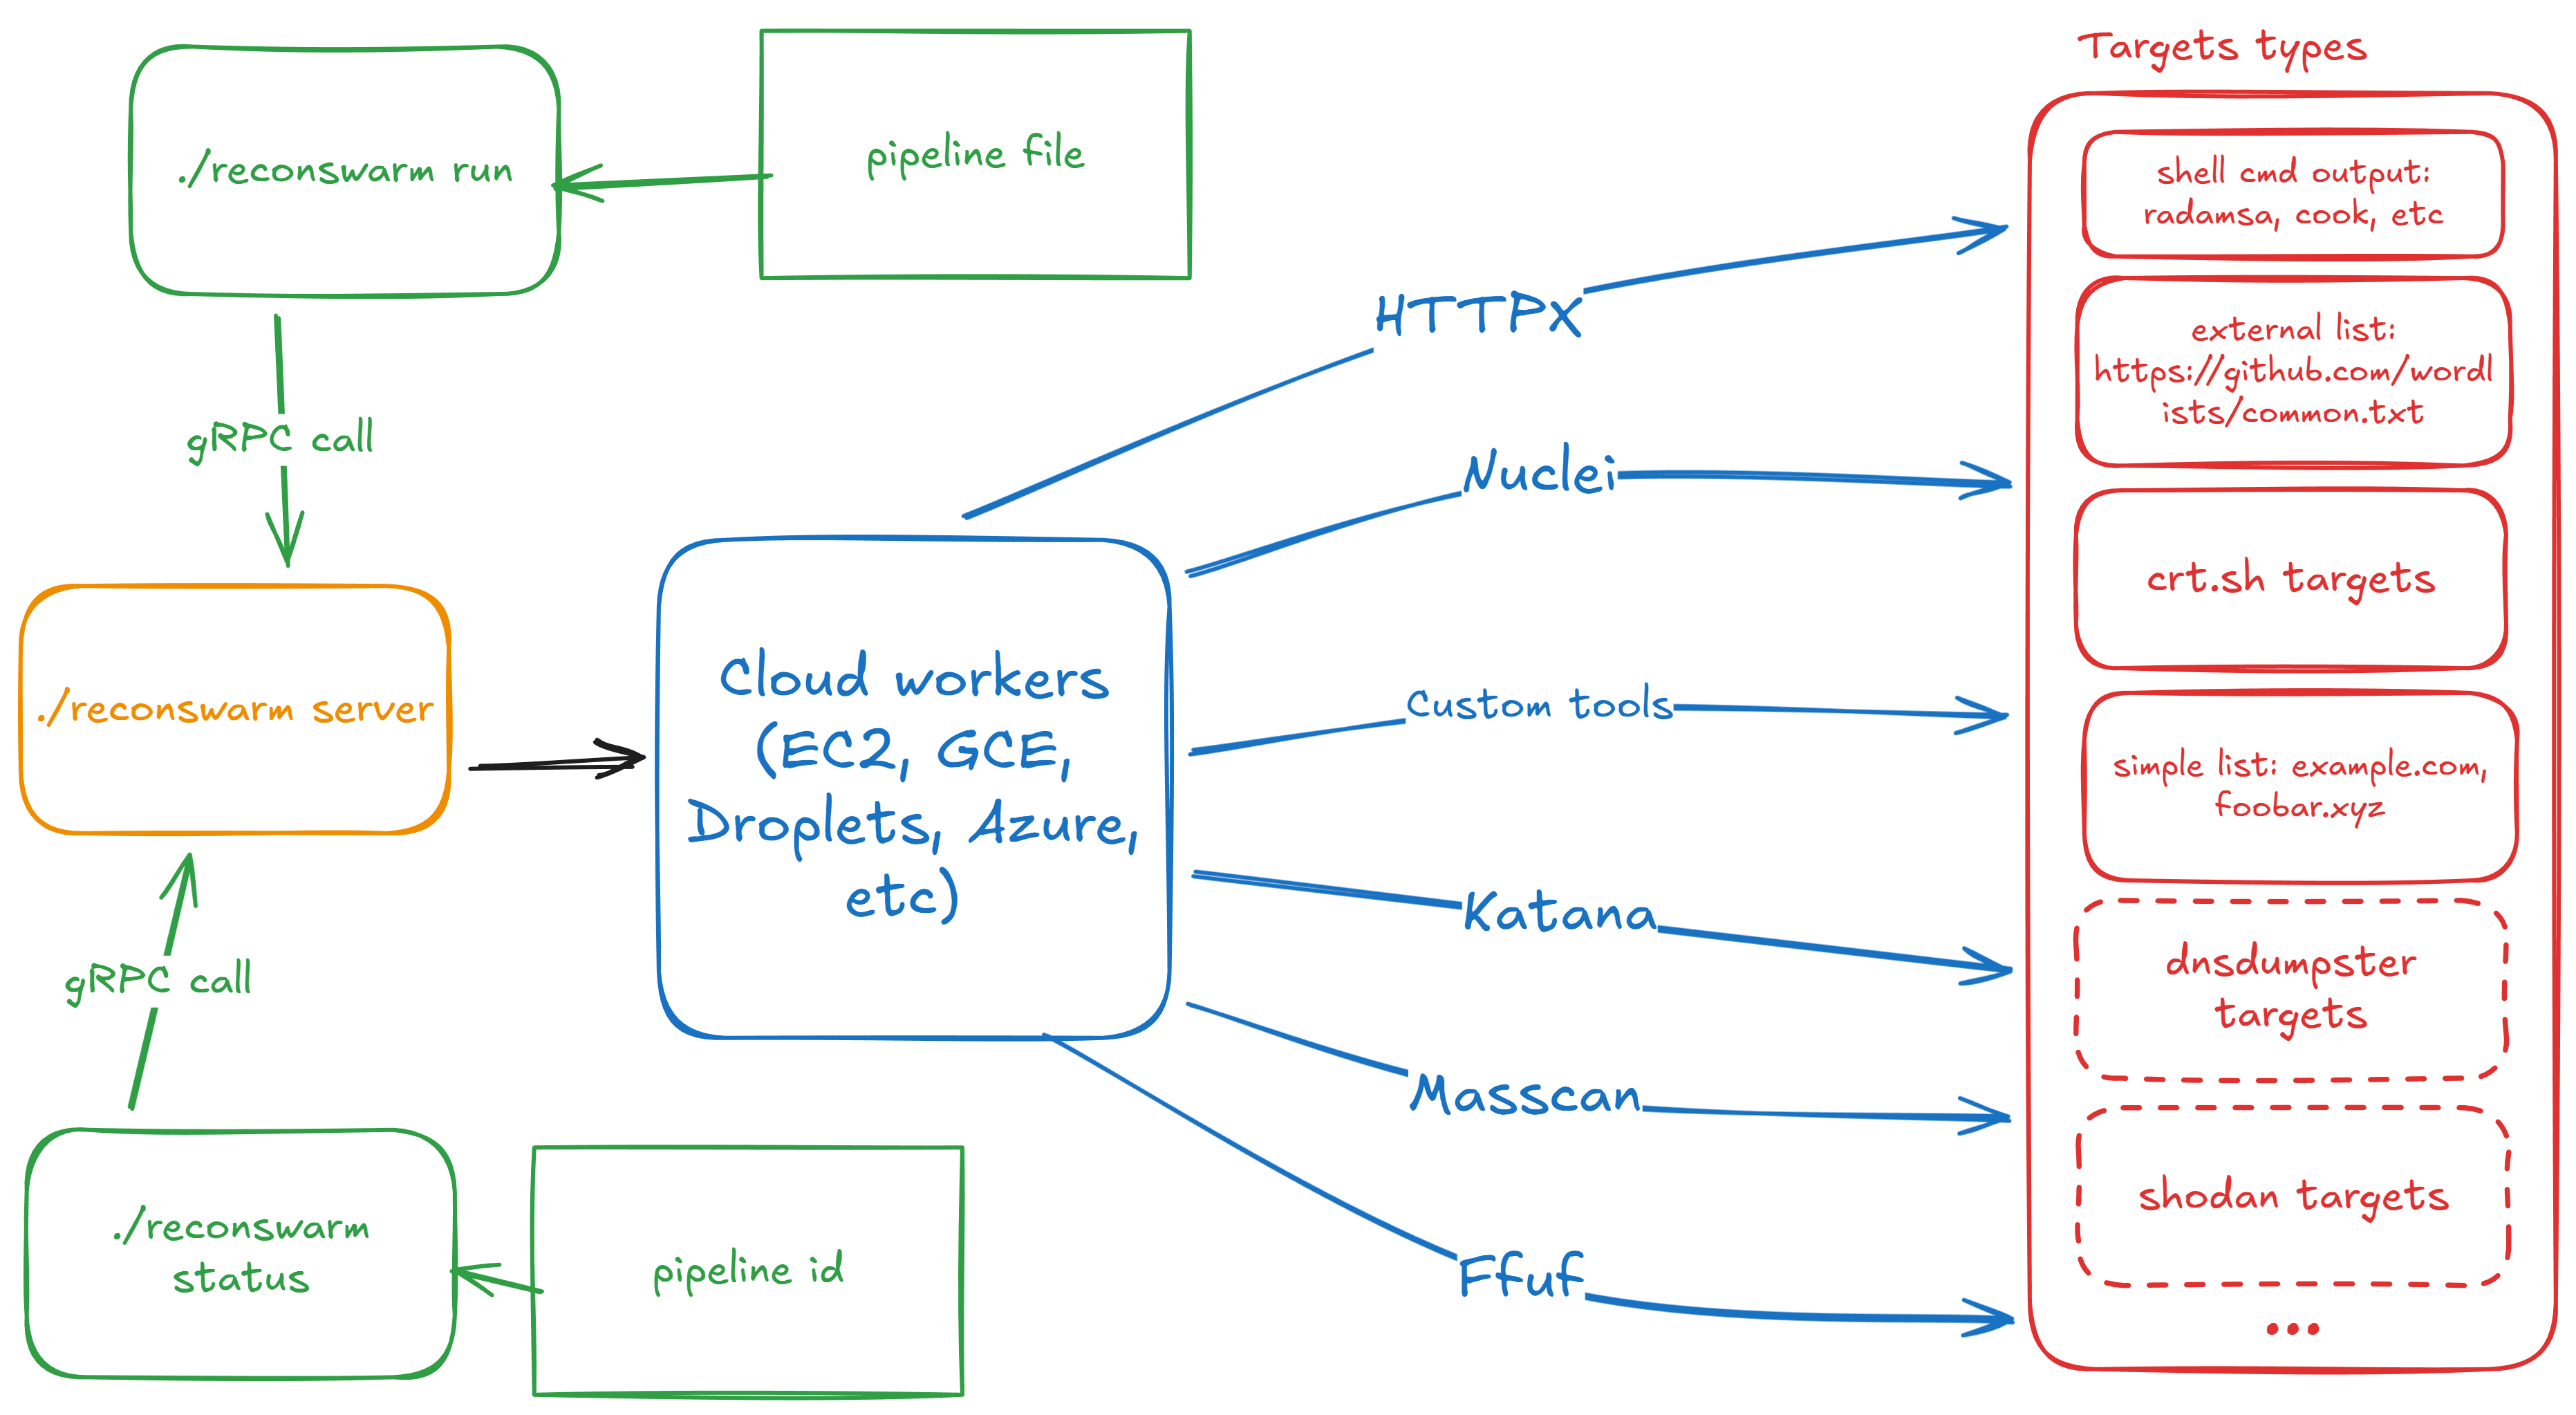
ReconSwarm es un framework modular de automatización de reconocimiento diseñado para pruebas de seguridad distribuidas. Aprovisiona infraestructura en la nube, ejecuta pipelines de reconocimiento en paralelo y recopila resultados con una configuración mínima.
ReconSwarm es adecuado para cazadores de recompensas, testers de penetración, ingenieros DevSecOps e investigadores de seguridad que necesitan flujos de trabajo de reconocimiento escalables y automatizados sin gestión manual de infraestructura.
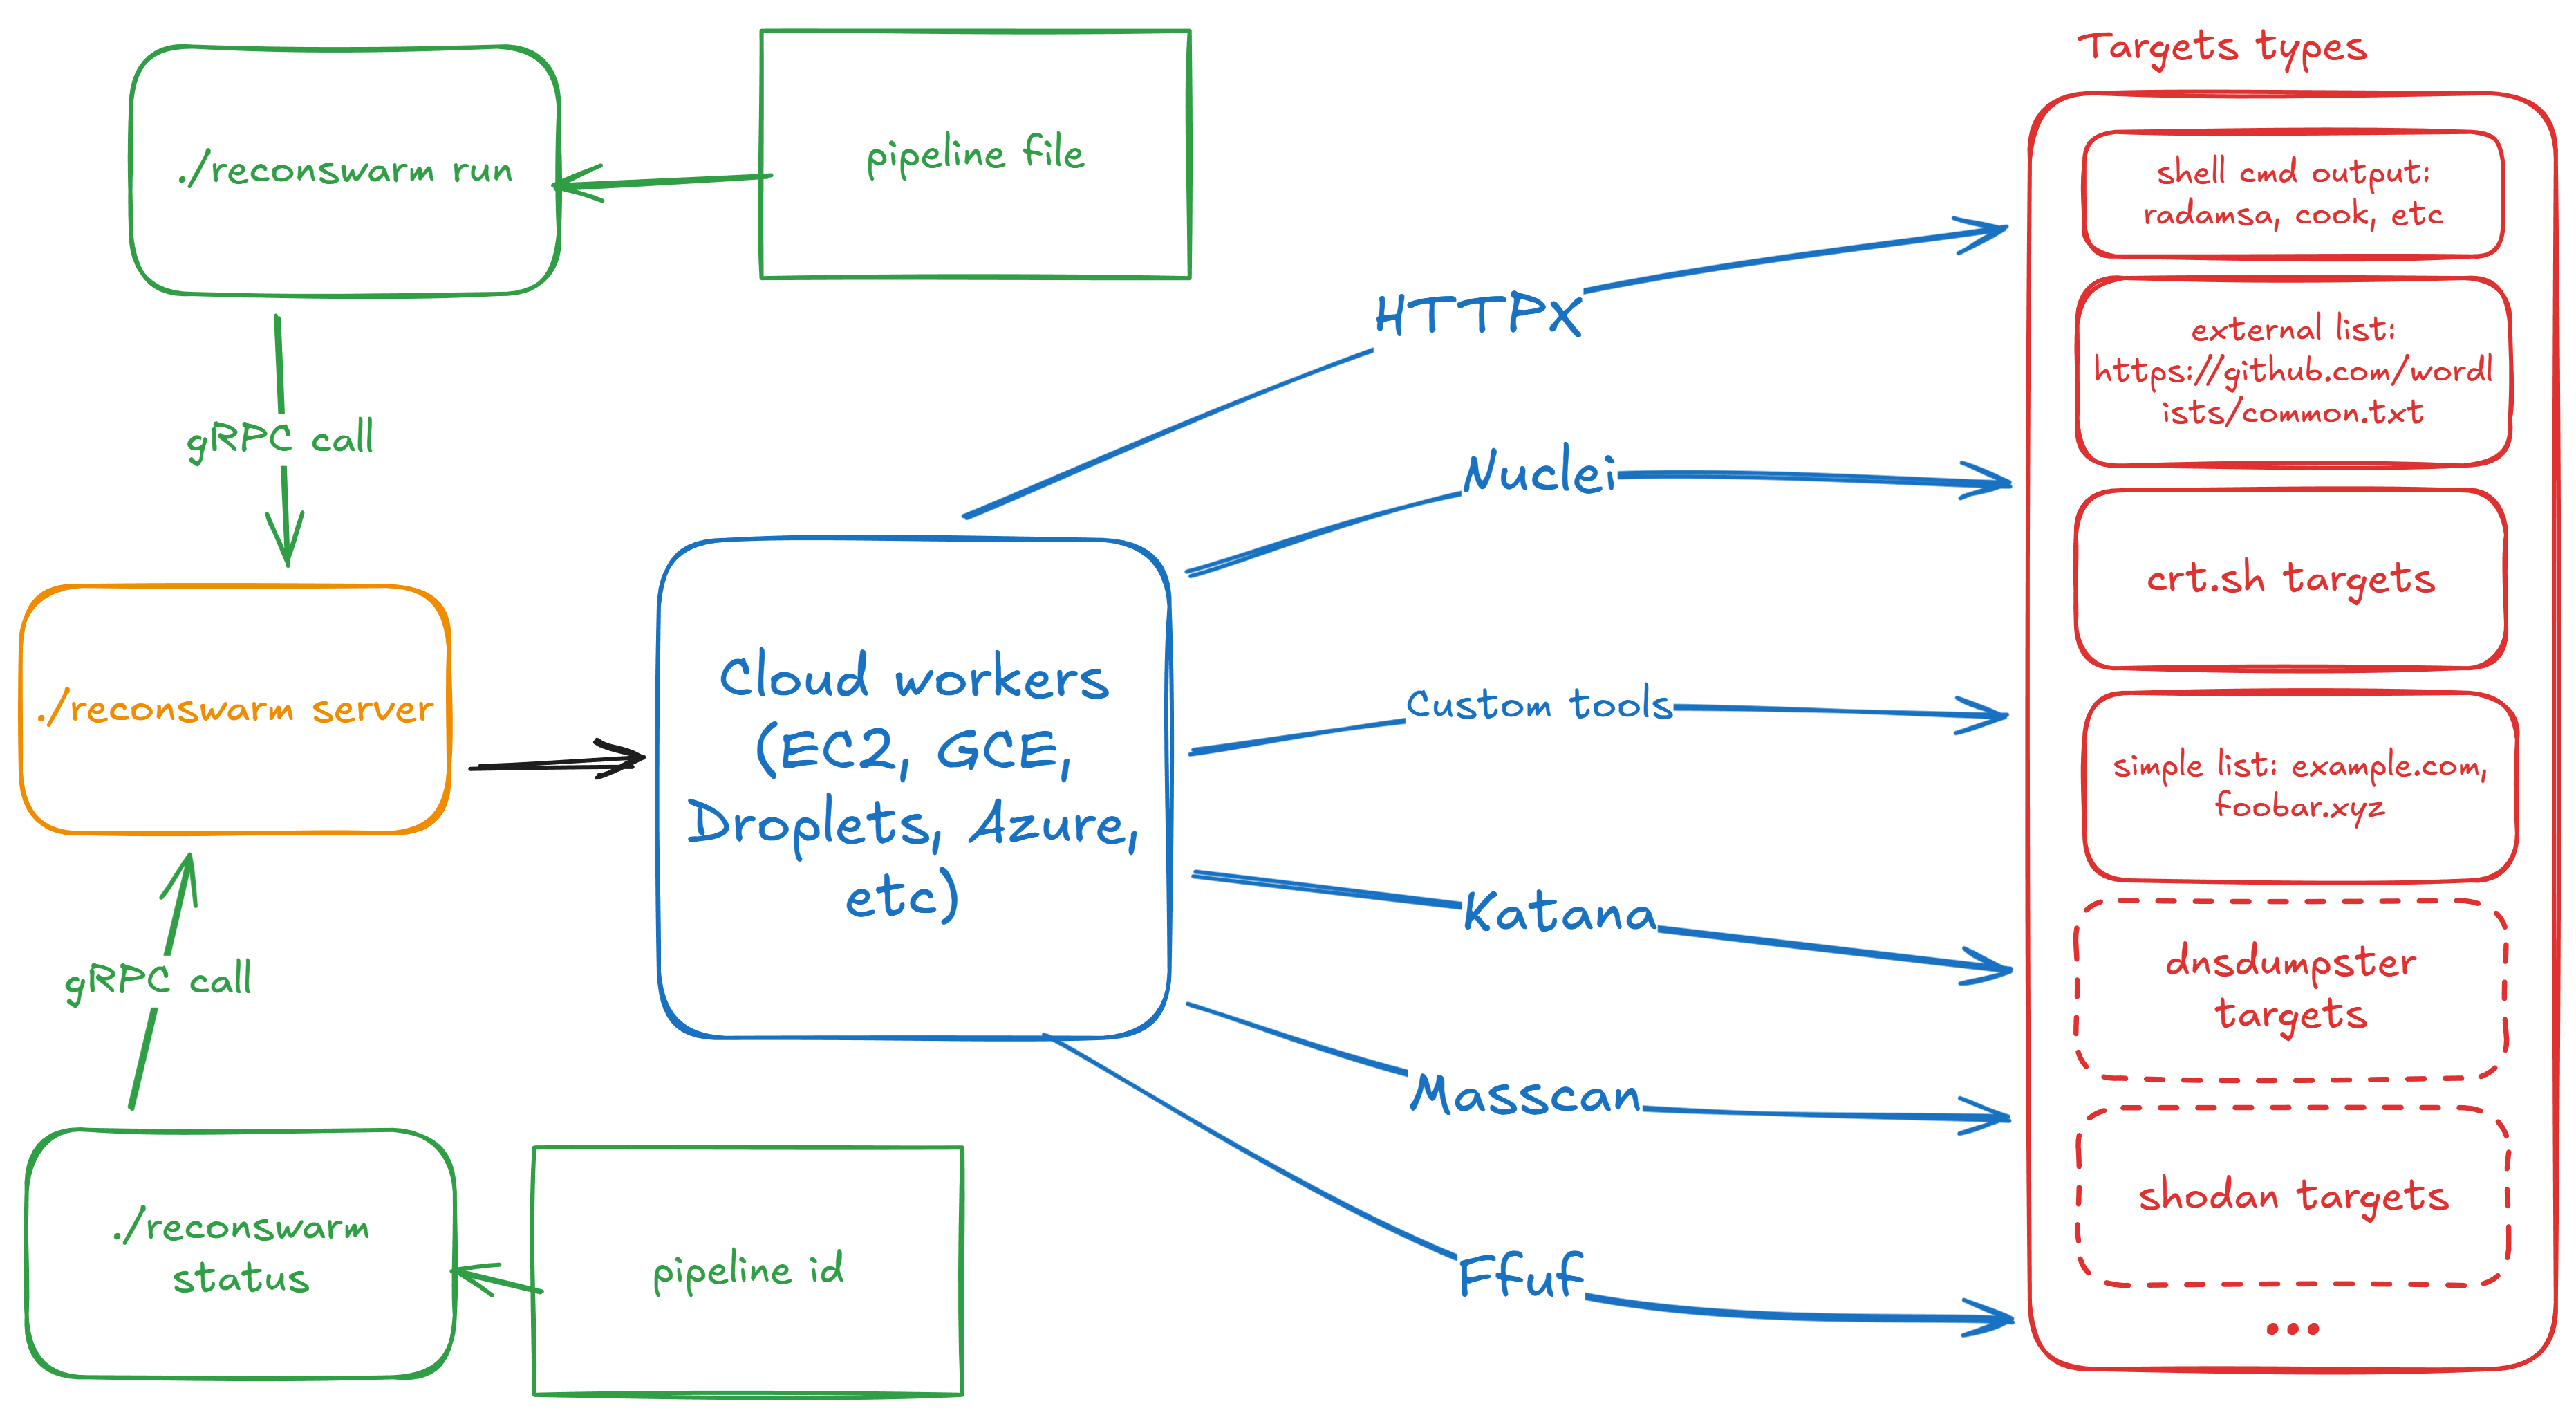
ReconSwarm sigue una arquitectura modular con una clara separación de responsabilidades entre el aprovisionamiento en la nube, el control remoto del sistema, la ejecución del pipeline y la gestión de la configuración.
ReconSwarm utiliza un patrón de unión discriminada para los aprovisionadores de nube. El campo provisioner.type determina qué configuración de proveedor está activa:
provisioner:
  type: yandex_cloud  # Campo discriminador
  yandex_cloud:       # Activo cuando type: yandex_cloud
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    # ... configuraciones específicas del proveedor
Se pueden integrar proveedores de nube adicionales implementando la interfaz Provisioner y agregando un nuevo tipo a la fábrica.
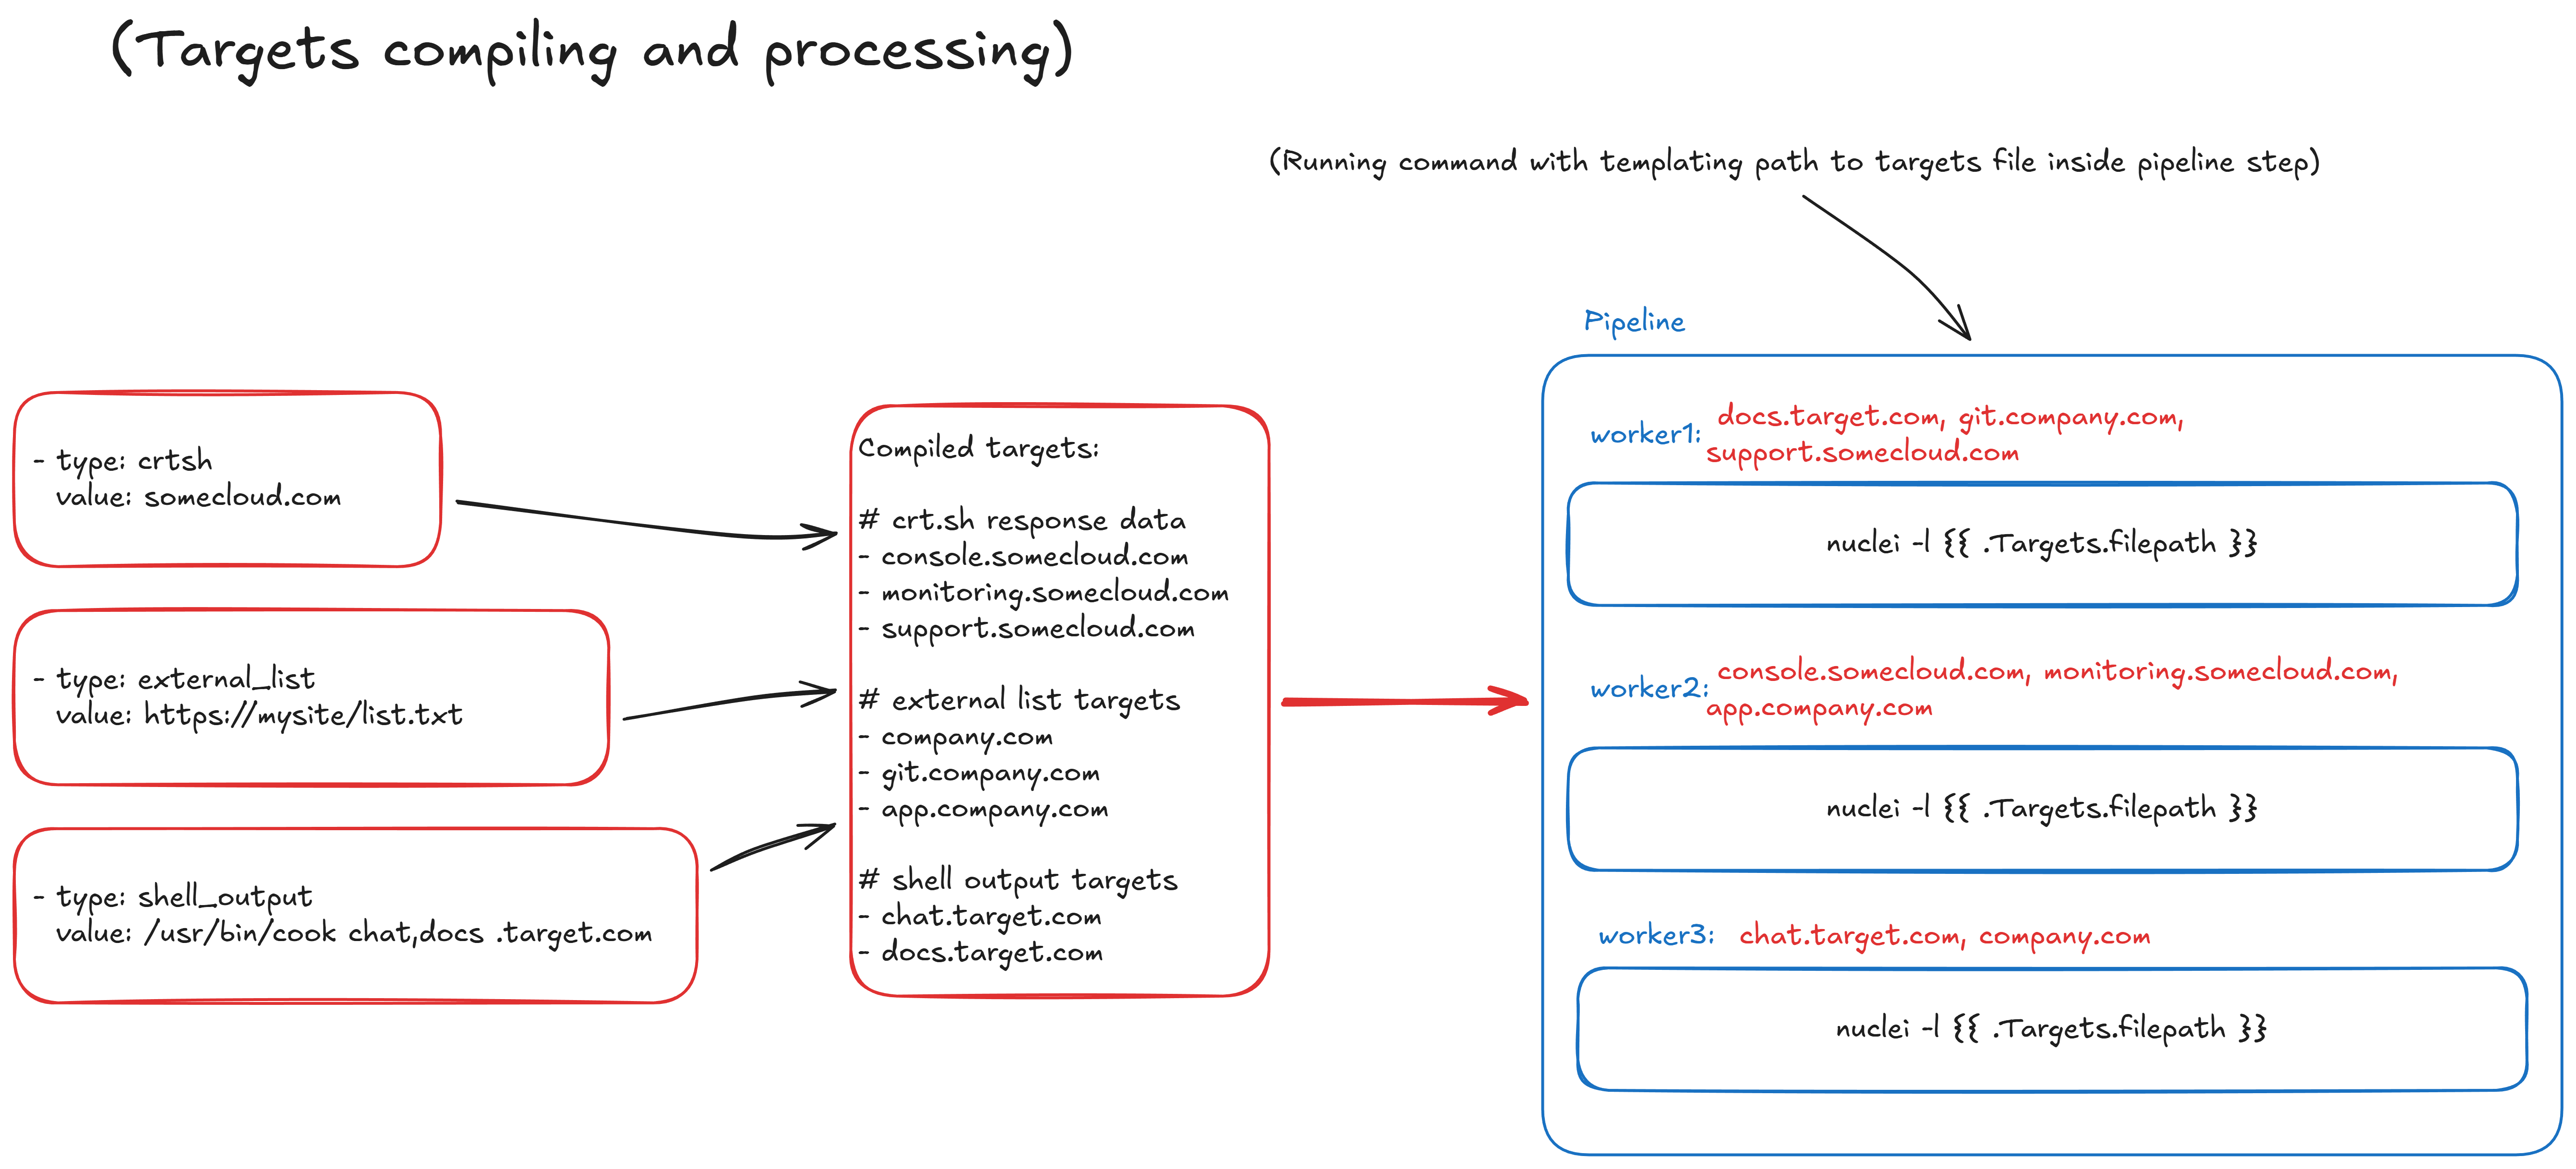
Las etapas son componentes extensibles que ejecutan operaciones en las máquinas virtuales worker:
Todos los campos de las etapas admiten renderizado de plantillas. Se pueden agregar nuevos tipos de etapas para extender la funcionalidad.
El servidor de ReconSwarm es completamente stateless — todo el estado se persiste en etcd:
Esta arquitectura permite:
| Capacidad | Descripción |
|---|---|
| Escalado horizontal | Ejecutar múltiples instancias del servidor detrás de un balanceador de carga. |
| Reinicios sin tiempo de inactividad | Reiniciar el servidor sin perder el estado del pipeline. |
| Recuperación ante fallos | Una nueva instancia del servidor retoma donde se quedó la anterior. |
| Inspección de estado | Consultar etcd directamente para depuración y monitoreo. |
Configuración de Alta Disponibilidad:
                    ┌─────────────┐
                    │   Cliente   │
                    └──────┬──────┘
                           │
                    ┌──────▼──────┐
                    │Balanceador  │
                    │   de Carga  │
                    └──────┬──────┘
              ┌────────────┼────────────┐
              │            │            │
       ┌──────▼──────┐ ┌───▼───┐ ┌──────▼──────┐
       │  Servidor 1 │ │ Serv2 │ │  Servidor 3 │
       └──────┬──────┘ └───┬───┘ └──────┬──────┘
              │            │            │
              └────────────┼────────────┘
                           │
                    ┌──────▼──────┐
                    │ etcd cluster│
                    └─────────────┘
Todos los servidores comparten el mismo clúster etcd y pueden manejar cualquier solicitud. Si un servidor falla en medio de un pipeline, otro servidor puede continuar la ejecución después de leer el estado desde etcd.
Nota: La implementación actual ejecuta los pipelines en memoria después de cargarlos desde etcd. La recuperación completa ante fallos con reanudación del pipeline está planificada para versiones futuras.
git clone <repository>
cd reconswarm
go mod download
task build
ReconSwarm separa la configuración del servidor de la configuración del pipeline:
| Tipo de Configuración | Archivo | Descripción |
|---|---|---|
| Servidor | reconswarm.yaml | Proveedor de nube, etcd, configuración del pool de workers. |
| Pipeline | Archivo YAML separado | Objetivos y etapas, se pasa mediante la bandera -f. |
La configuración del servidor se almacena en reconswarm.yaml (configurable mediante la variable de entorno CONFIG_PATH). Todos los valores de cadena admiten expansión de variables de entorno utilizando la sintaxis ${VAR} o $VAR.
# Configuración del servidor
server:
  port: 50051

# Conexión a etcd para gestión de estado
etcd:
  endpoints:
    - "localhost:2379"
  dial_timeout: 5  # segundos
  username: ""     # opcional, soporta ${ETCD_USER}
  password: ""     # opcional, soporta ${ETCD_PASSWORD}

# Aprovisionador de nube (unión discriminada)
provisioner:
  type: yandex_cloud  # Selector de proveedor

  # Configuración de Yandex Cloud (activa cuando type: yandex_cloud)
  yandex_cloud:
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    default_zone: "ru-central1-b"
    default_image: "fd8b1cmhmncn7lt4tqn4"
    default_username: "root"
    default_cores: 2
    default_memory: 2      # GB
    default_disk_size: 20  # GB

# Configuración del pool de workers
workers:
  max_workers: 5
  setup_commands:
    - "apt update"
    - "apt install -y docker.io"
La configuración del pipeline se almacena en un archivo YAML separado y se pasa mediante la bandera -f. Se admiten tanto el formato envuelto como el no envuelto:
