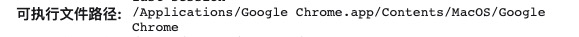
 qianlitp/crawlergo
Un potente rastreador de navegador para escáneres de vulnerabilidades web


Un potente rastreador de navegadores para escáneres de vulnerabilidades web
Documento en inglés | 中文文档
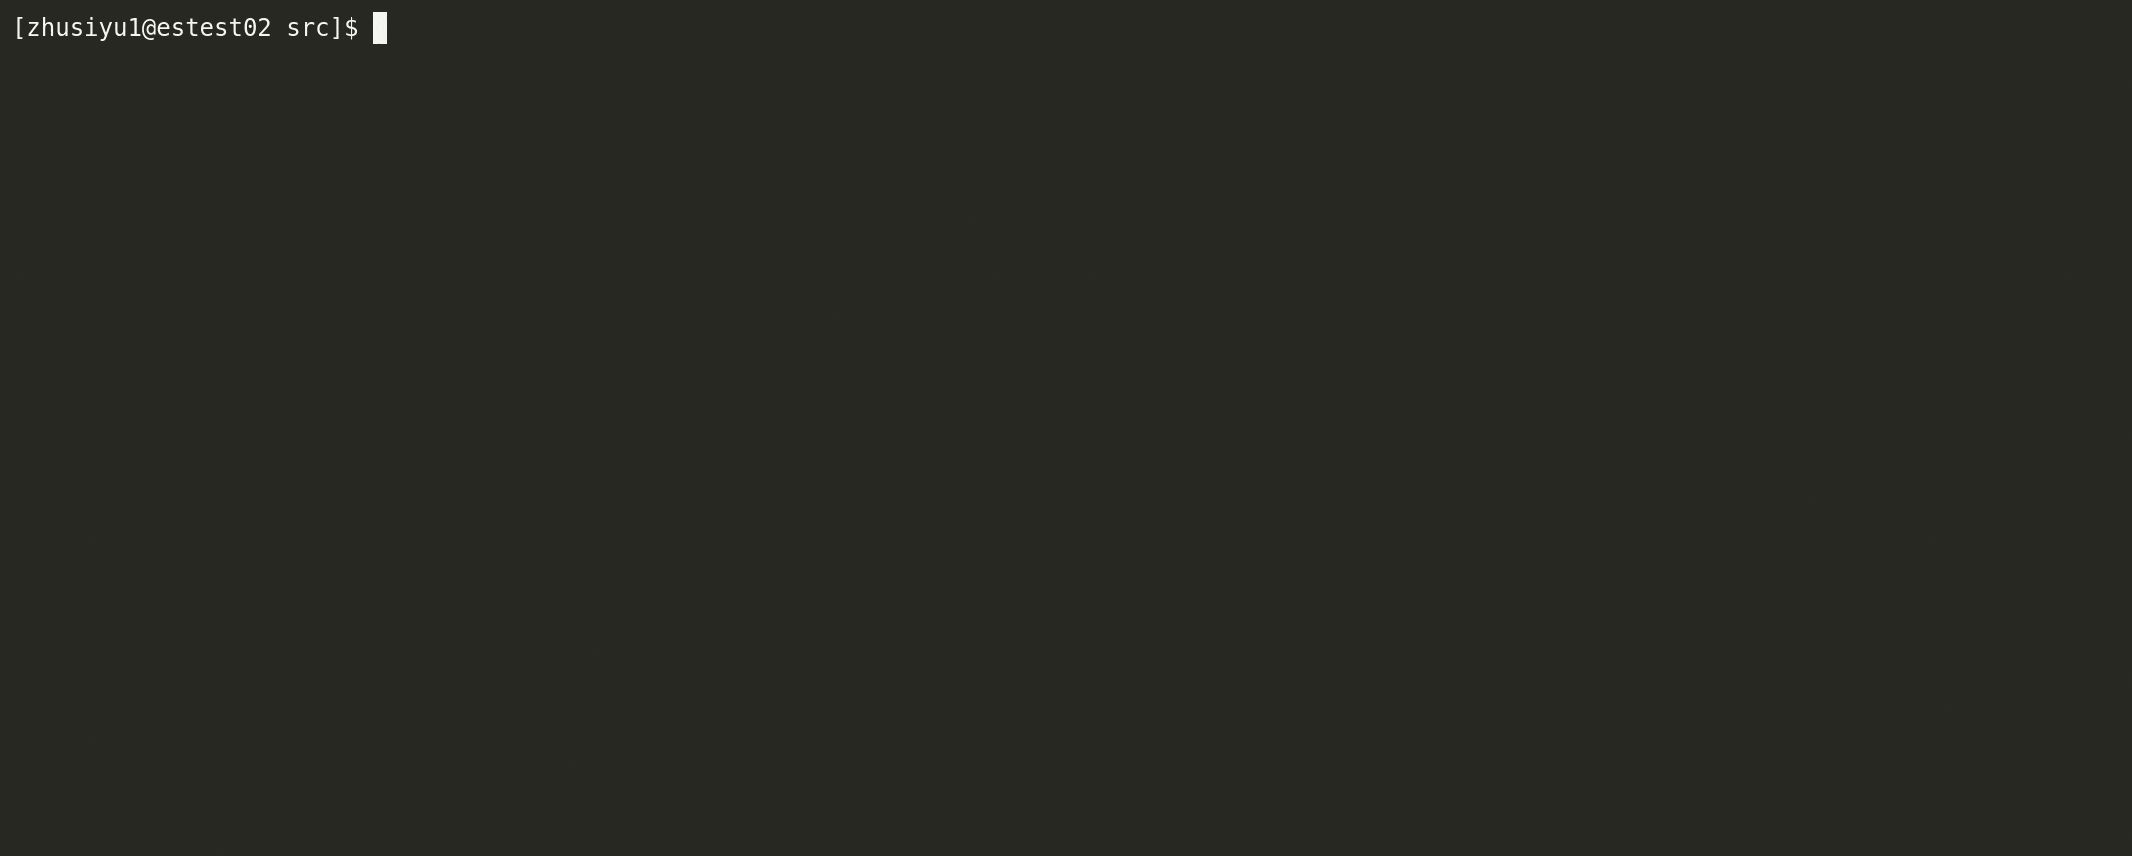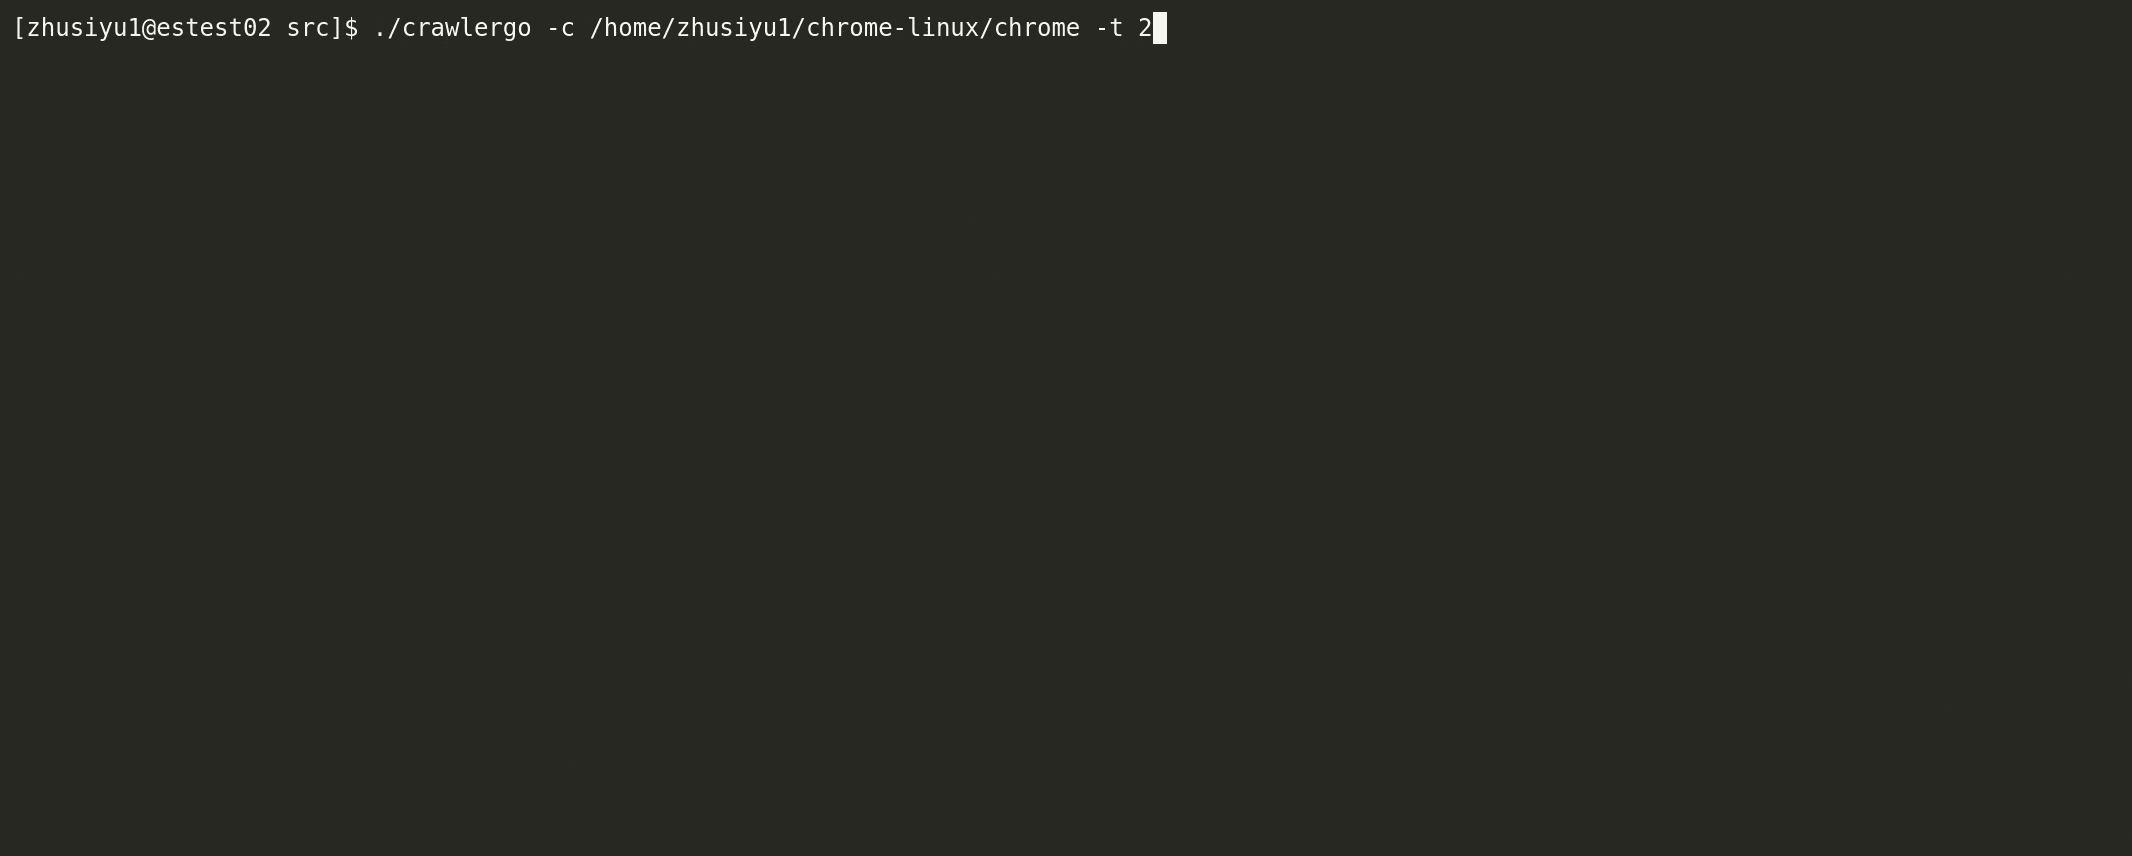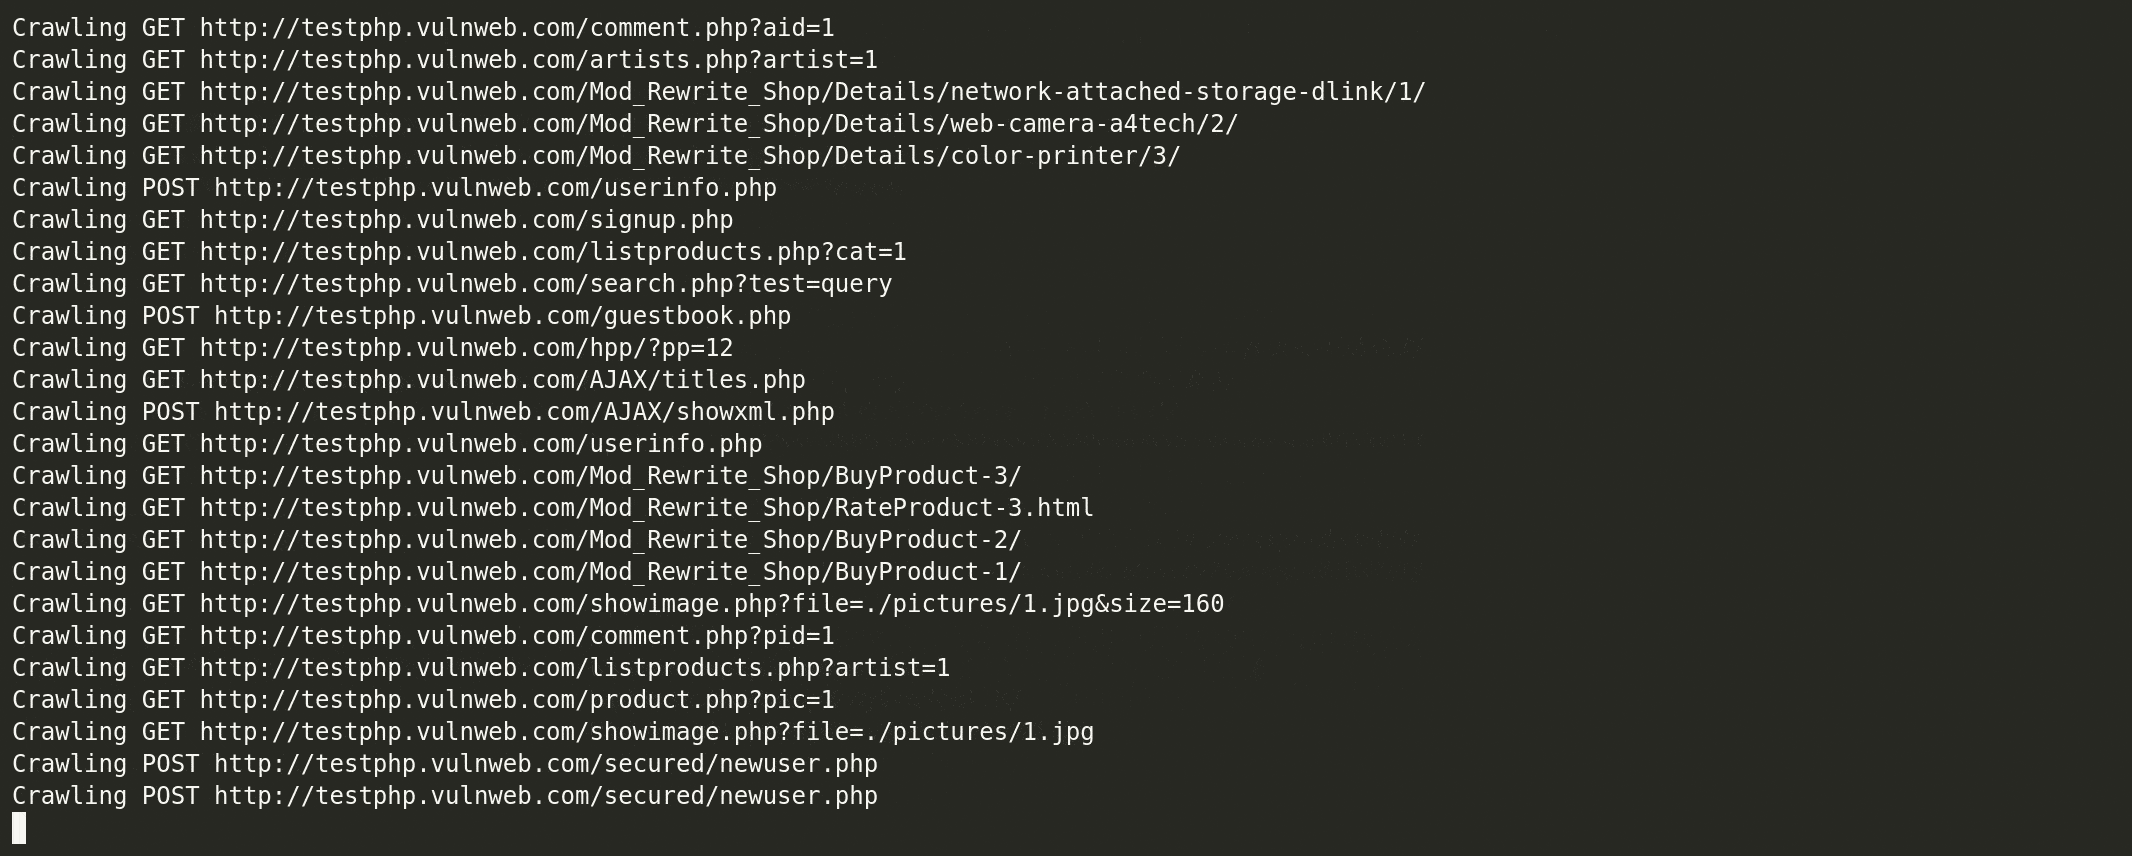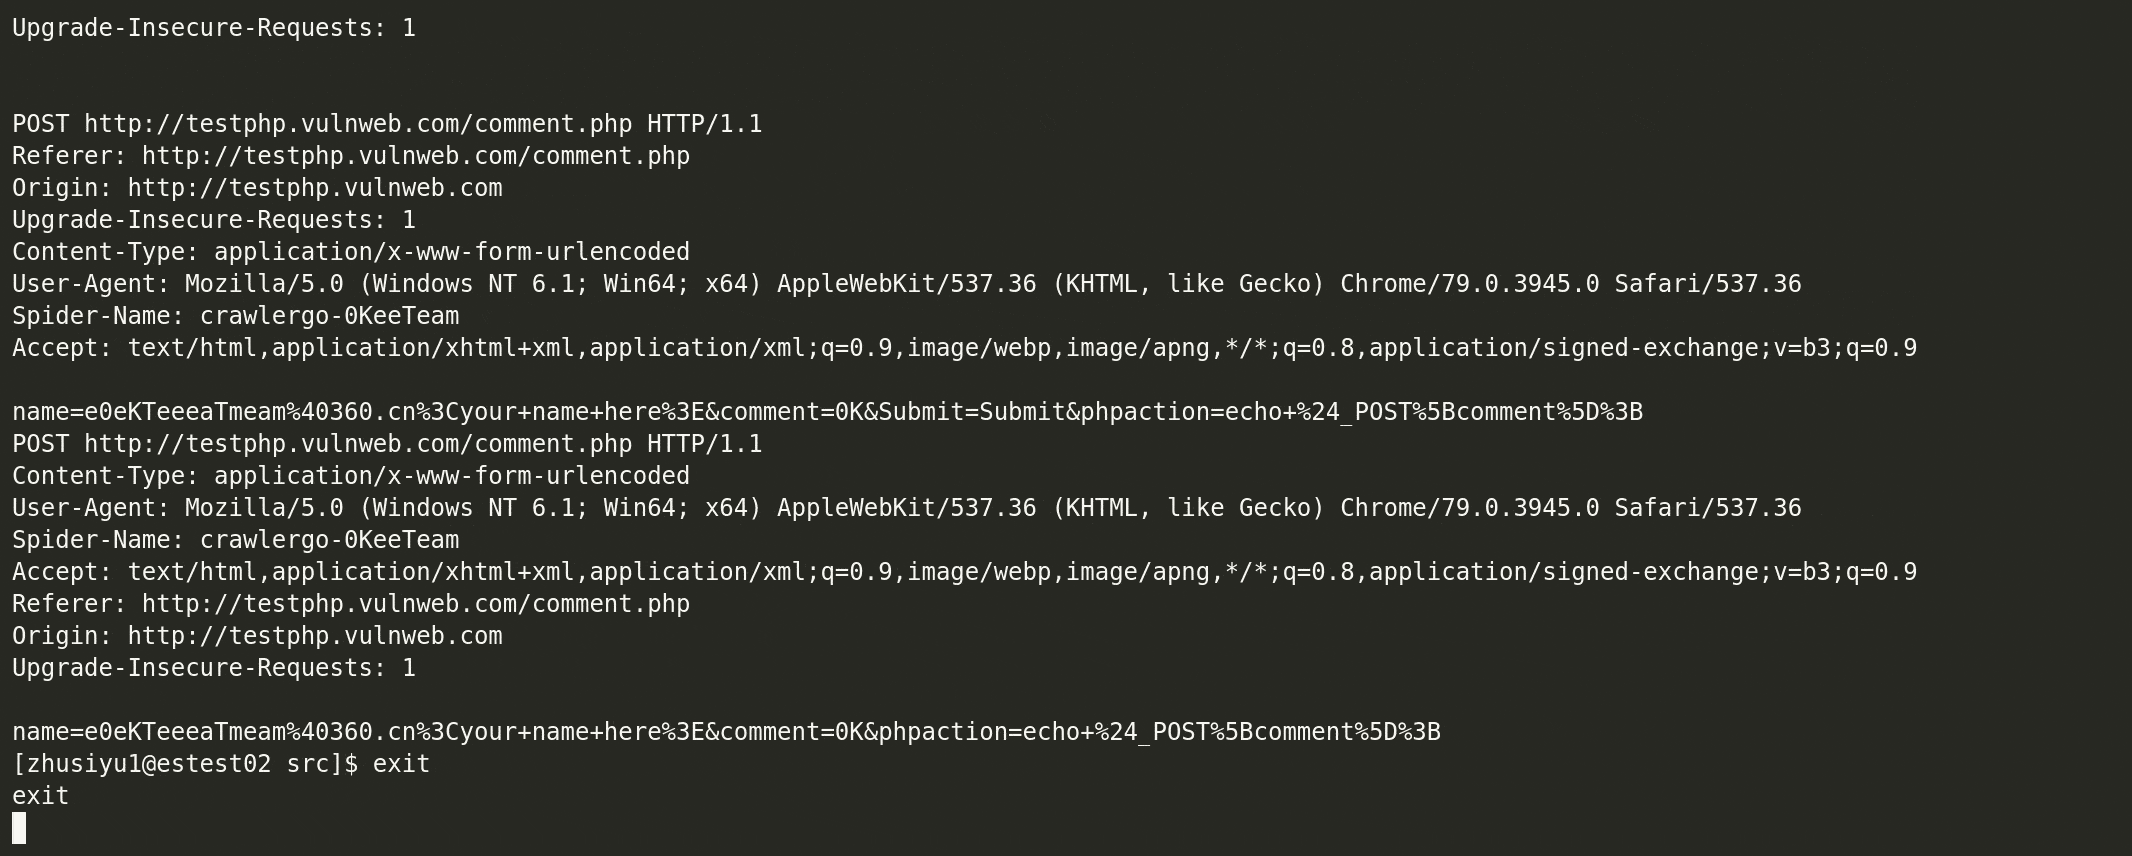
crawlergo es un rastreador de navegadores que utiliza el modo chrome headless para la recolección de URLs. Engancha posiciones clave de toda la página web en la etapa de renderizado del DOM, rellena y envía formularios automáticamente, con disparo inteligente de eventos JS, y recopila tantas entradas expuestas por el sitio web como sea posible. El módulo incorporado de deduplicación de URLs filtra una gran cantidad de URLs pseudoestáticas, manteniendo una velocidad rápida de análisis y rastreo para sitios web grandes, y finalmente obtiene una colección de alta calidad de resultados de solicitudes.
crawlergo actualmente soporta las siguientes características:
Por favor, lea y confirme descargo de responsabilidad cuidadosamente antes de instalar y usar.
Build
make build
make build_all
Si está utilizando un sistema linux y chrome le indica dependencias faltantes, consulte TroubleShooting a continuación.
Suponiendo que su directorio de instalación de chromium es /tmp/chromium/, configure 10 pestañas abiertas al mismo tiempo y rastree testphp.vulnweb.com:
bin/crawlergo -c /tmp/chromium/chrome -t 10 http://testphp.vulnweb.com/
También puede usar esto con docker sin complicaciones:
git clone https://github.com/Qianlitp/crawlergo
docker build . -t crawlergo
docker run crawlergo http://testphp.vulnweb.com/
bin/crawlergo -c /tmp/chromium/chrome -t 10 --request-proxy socks5://127.0.0.1:7891 http://testphp.vulnweb.com/
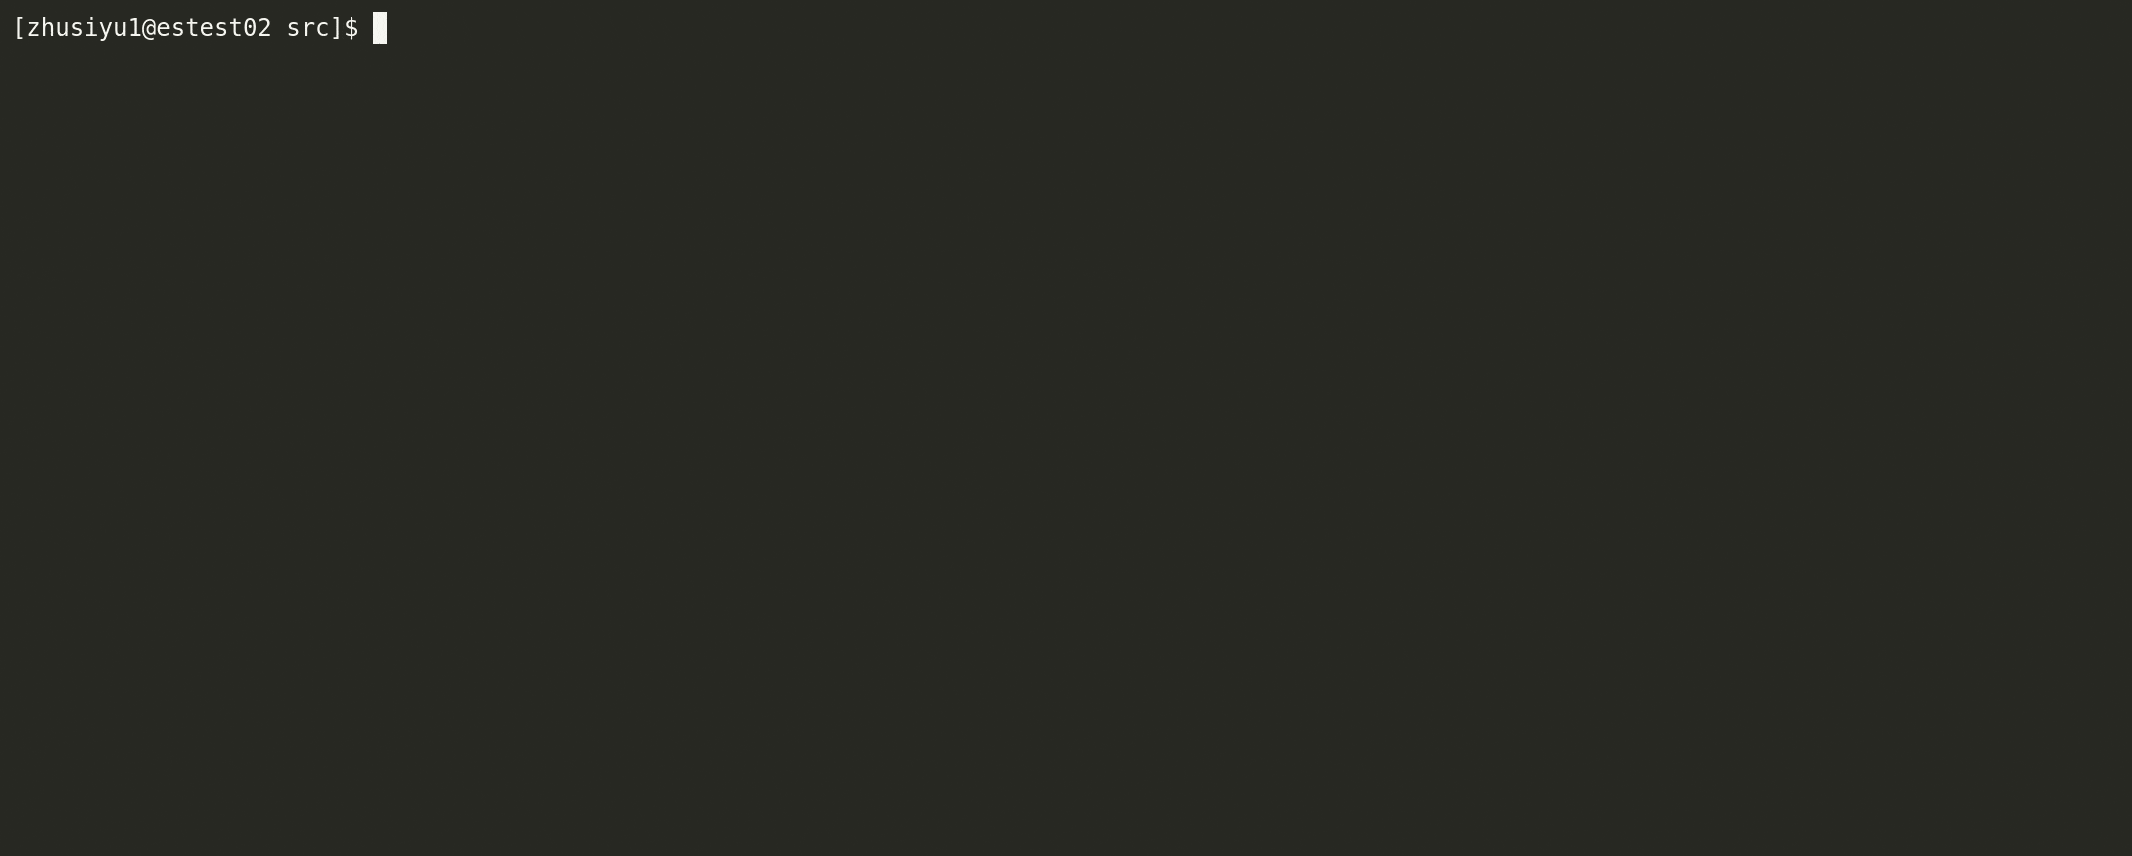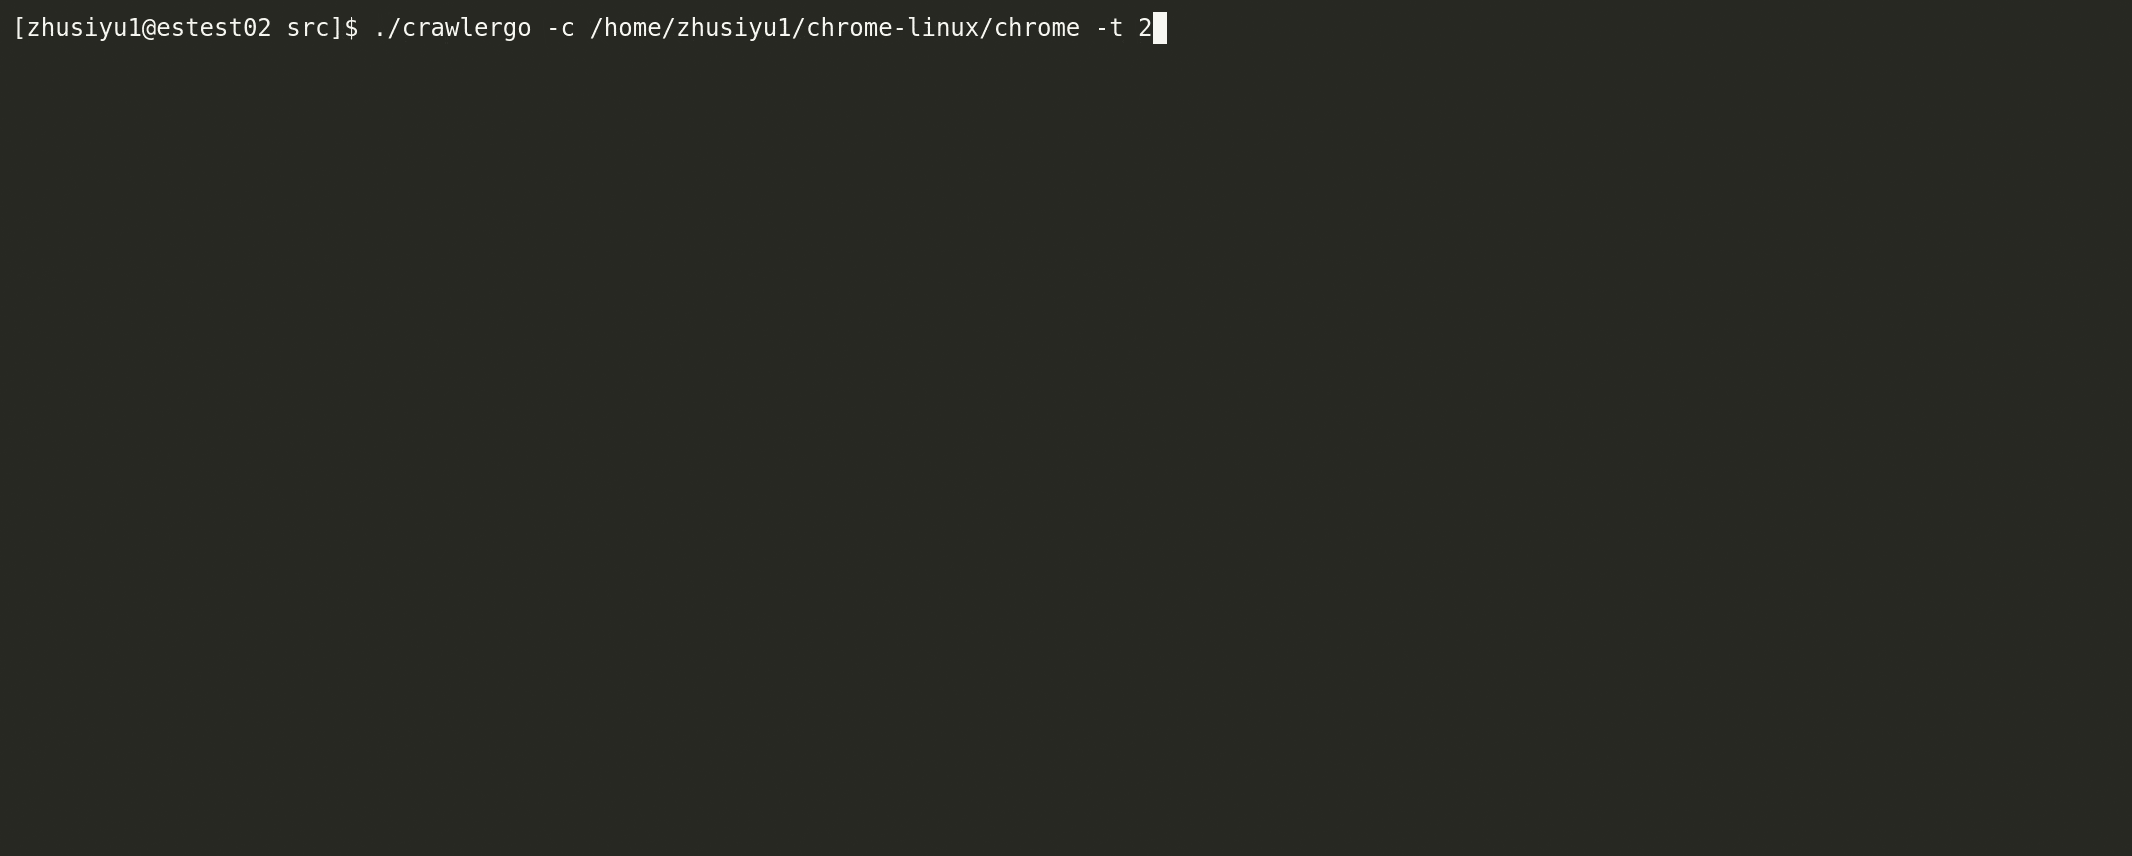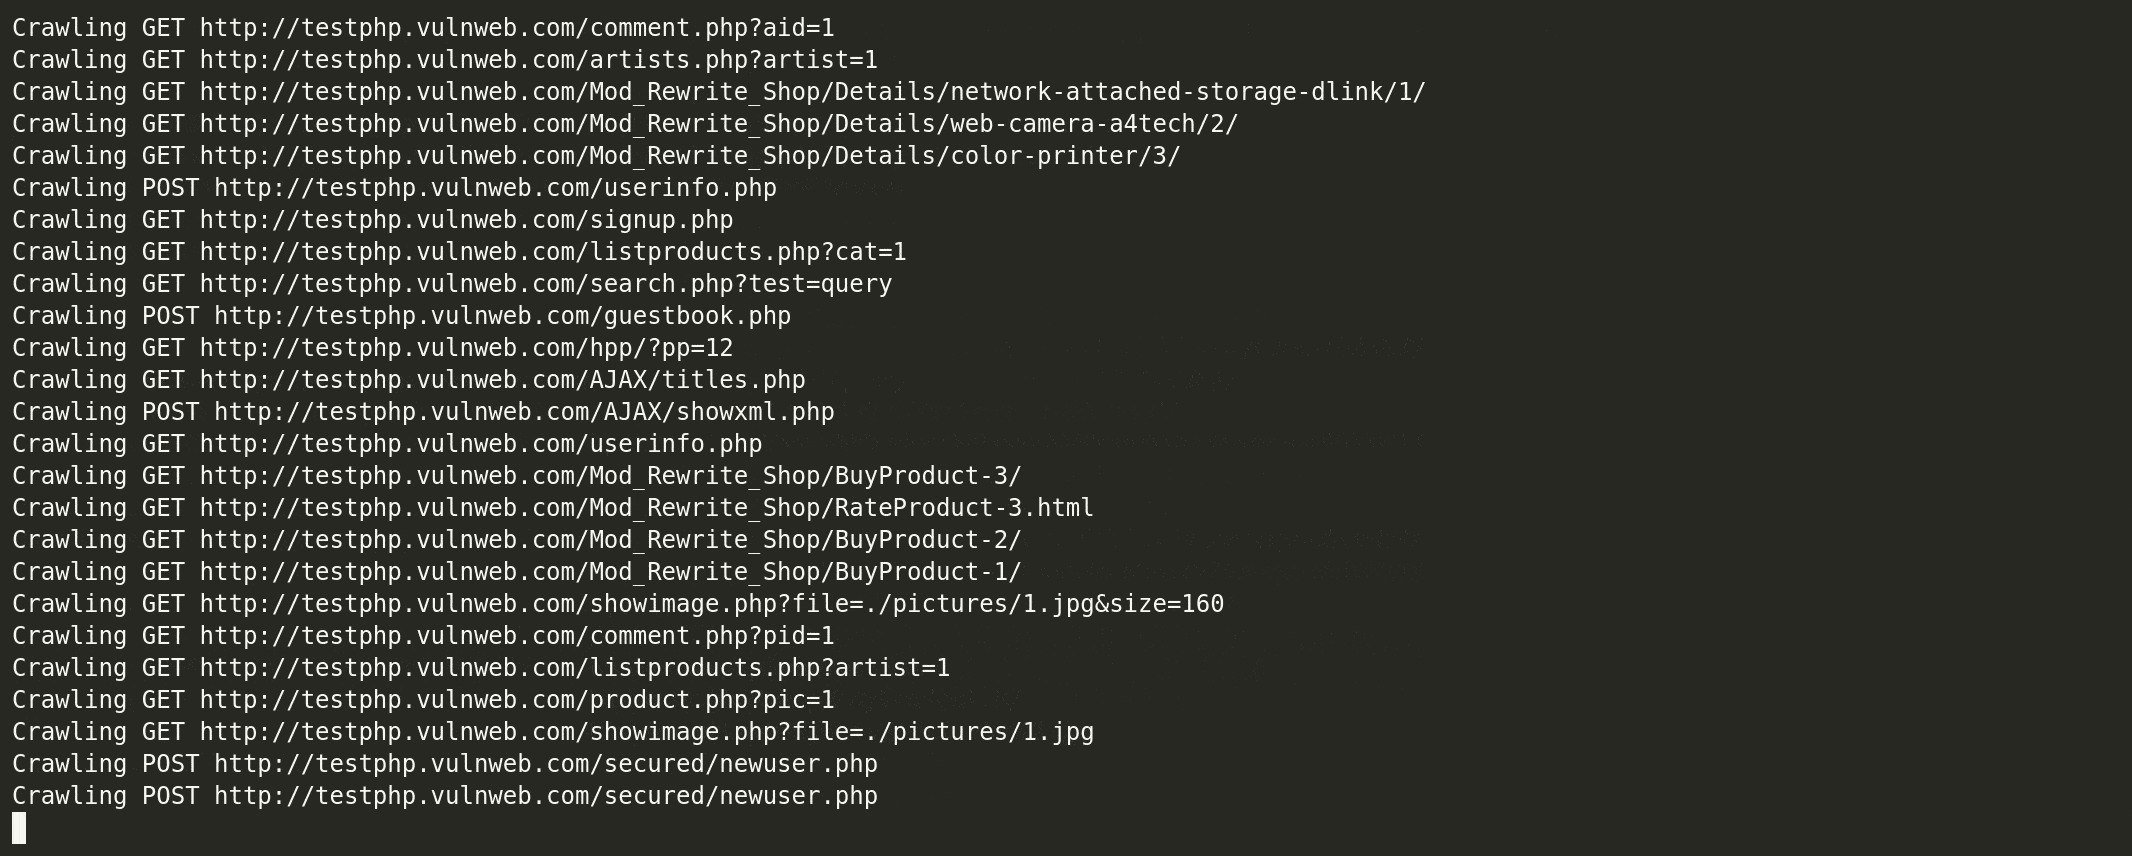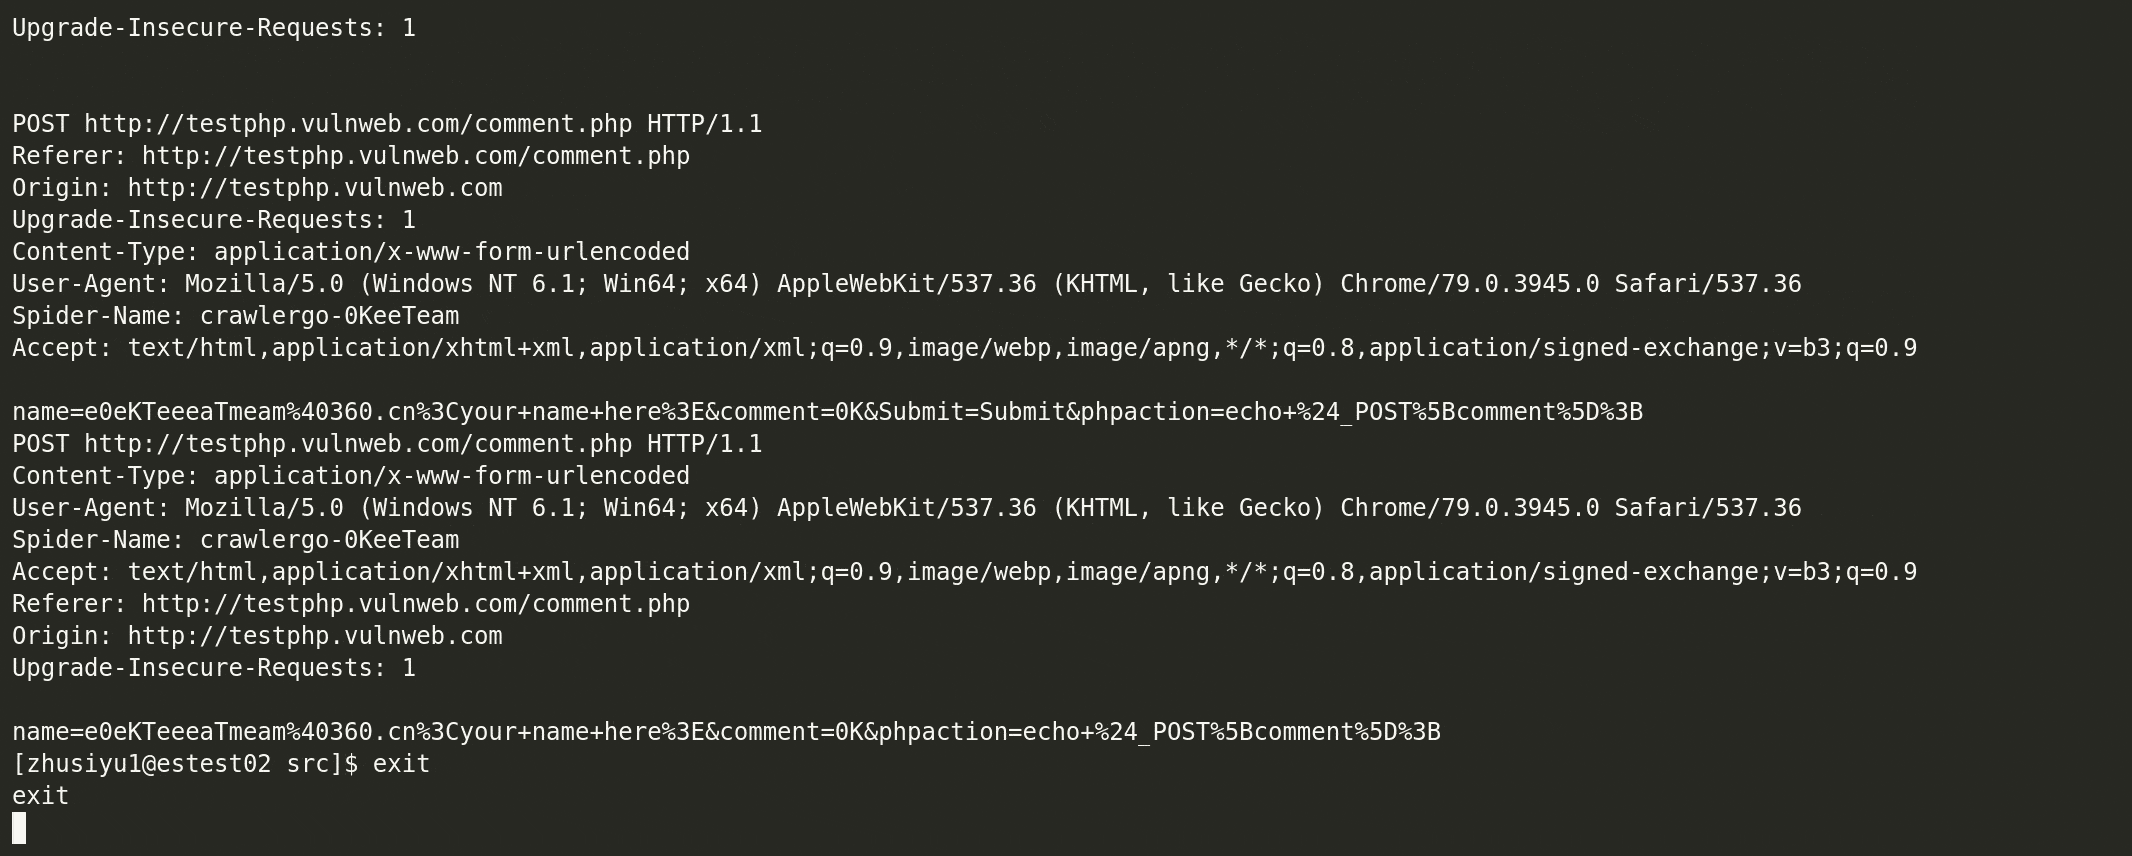
Por defecto, crawlergo imprime los resultados directamente en la pantalla. A continuación, configuramos el modo de salida a json, y el código de ejemplo para llamarlo usando python es el siguiente:
#!/usr/bin/python3
# coding: utf-8

import simplejson
import subprocess


def main():
    target = "http://testphp.vulnweb.com/"
    cmd = ["bin/crawlergo", "-c", "/tmp/chromium/chrome", "-o", "json", target]
    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    output, error = rsp.communicate()
	#  "--[Mission Complete]--"  es la cadena separadora de fin de tarea
    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])
    req_list = result["req_list"]
    print(req_list[0])


if __name__ == '__main__':
    main()
Cuando el modo de salida se establece en json, el resultado devuelto, después de la deserialización JSON, contiene cuatro partes:
all_req_list: Todas las solicitudes encontradas durante esta tarea de rastreo, que contienen cualquier tipo de recurso de otros dominios.req_list: Devuelve los resultados del dominio actual de esta tarea de rastreo, deduplicados pseudoestáticamente, sin enlaces de recursos estáticos. Es un subconjunto de all_req_list.all_domain_list: Lista de todos los dominios encontrados.sub_domain_list: Lista de subdominios encontrados.crawlergo devuelve la solicitud completa y la URL, que se pueden usar de diversas maneras:
Usado en conjunto con otros escáneres pasivos de vulnerabilidades web
Primero, inicie un escáner pasivo y establezca la dirección de escucha en: http://127.0.0.1:1234/
A continuación, suponiendo que crawlergo está en la misma máquina que el escáner, inicie crawlergo y establezca los parámetros:
--push-to-proxy http://127.0.0.1:1234/
Enlace de Host (no disponible para versiones altas de chrome) (example)
Cookies personalizadas (example)
Limpieza periódica de procesos zombie generados por crawlergo (example), contribuido por @ring04h
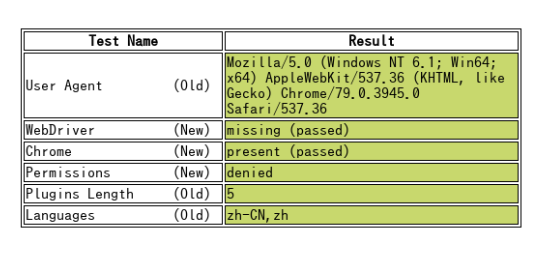
crawlergo puede evitar la detección del modo headless por defecto.
https://intoli.com/blog/not-possible-to-block-chrome-headless/chrome-headless-test.html
'Fetch.enable' no se encontró
Fetch es una función compatible con la nueva versión de chrome, si se produce este error, significa que su versión es demasiado baja, actualice la versión de chrome.
chrome se ejecuta con dependencias faltantes como xxx.so
// Ubuntu
apt-get install -yq --no-install-recommends \
     libasound2 libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 \
     libexpat1 libfontconfig1 libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 \
     libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 libgbm1 \
     libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 libxrender1 libxss1 libxtst6 libnss3

// CentOS 7
sudo yum install pango.x86_64 libXcomposite.x86_64 libXcursor.x86_64 libXdamage.x86_64 libXext.x86_64 libXi.x86_64 \
     libXtst.x86_64 cups-libs.x86_64 libXScrnSaver.x86_64 libXrandr.x86_64 GConf2.x86_64 alsa-lib.x86_64 atk.x86_64 gtk3.x86_64 \
     ipa-gothic-fonts xorg-x11-fonts-100dpi xorg-x11-fonts-75dpi xorg-x11-utils xorg-x11-fonts-cyrillic xorg-x11-fonts-Type1 xorg-x11-fonts-misc -y

sudo yum update nss -y
El mensaje de ejecución muestra Navigation timeout / navegador no encontrado / no conoce la ruta del ejecutable del navegador correcta
Asegúrese de que la ruta del ejecutable del navegador esté configurada correctamente, escriba: chrome://version en la barra de direcciones y busque la ruta del archivo ejecutable: