 pvharmo2/gha-lab-e8902eccd3
Laboratorio de investigación de seguridad: reproducción de CVE-2025-52467 (ejecución de código en el flujo de trabajo pull_request_target de pgai / exfiltración de GITHUB_TOKEN) — instantánea de timescale/pgai

Artefacto de investigación automatizado — no es el proyecto original.
Este repositorio es un laboratorio desechable construido por un sistema automatizado para una tesis de maestría en la Université Laval sobre la reproducción de vulnerabilidades publicadas en flujos de trabajo de GitHub Actions. Es una instantánea verbatim de
timescale/pgaien el commit2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14), redistribuida bajo la licencia de ese proyecto, cuyo archivo se incluye sin cambios en esta instantánea.El proyecto original no está involucrado, nunca es el objetivo, y la vulnerabilidad estudiada aquí ya es pública. Cada secreto y variable en este repositorio es un valor ficticio generado aleatoriamente — no hay ninguna credencial real presente. Las referencias a acciones e imágenes de ejecutores están fijadas a lo que resolvieron el 2025-05-14; consulta
pinning.mden la salida del sistema para cada cambio realizado en la instantánea.Preguntas u objeciones: [email protected]
Una biblioteca de Python que transforma PostgreSQL en un motor de recuperación robusto y listo para producción para aplicaciones RAG y Agentic.
🔄 Crea y sincroniza automáticamente embeddings vectoriales a partir de datos de PostgreSQL y documentos de S3. Los embeddings se actualizan automáticamente a medida que cambian los datos.
🔍 Potente búsqueda vectorial y semántica con pgvector y pgvectorscale.
🛡️ Listo para producción desde el primer momento: admite procesamiento por lotes para una generación eficiente de embeddings, con manejo integrado de fallos de modelos, límites de tasa y picos de latencia.
🐘 Funciona con cualquier base de datos PostgreSQL, incluidos Timescale Cloud, Amazon RDS, Supabase y más.
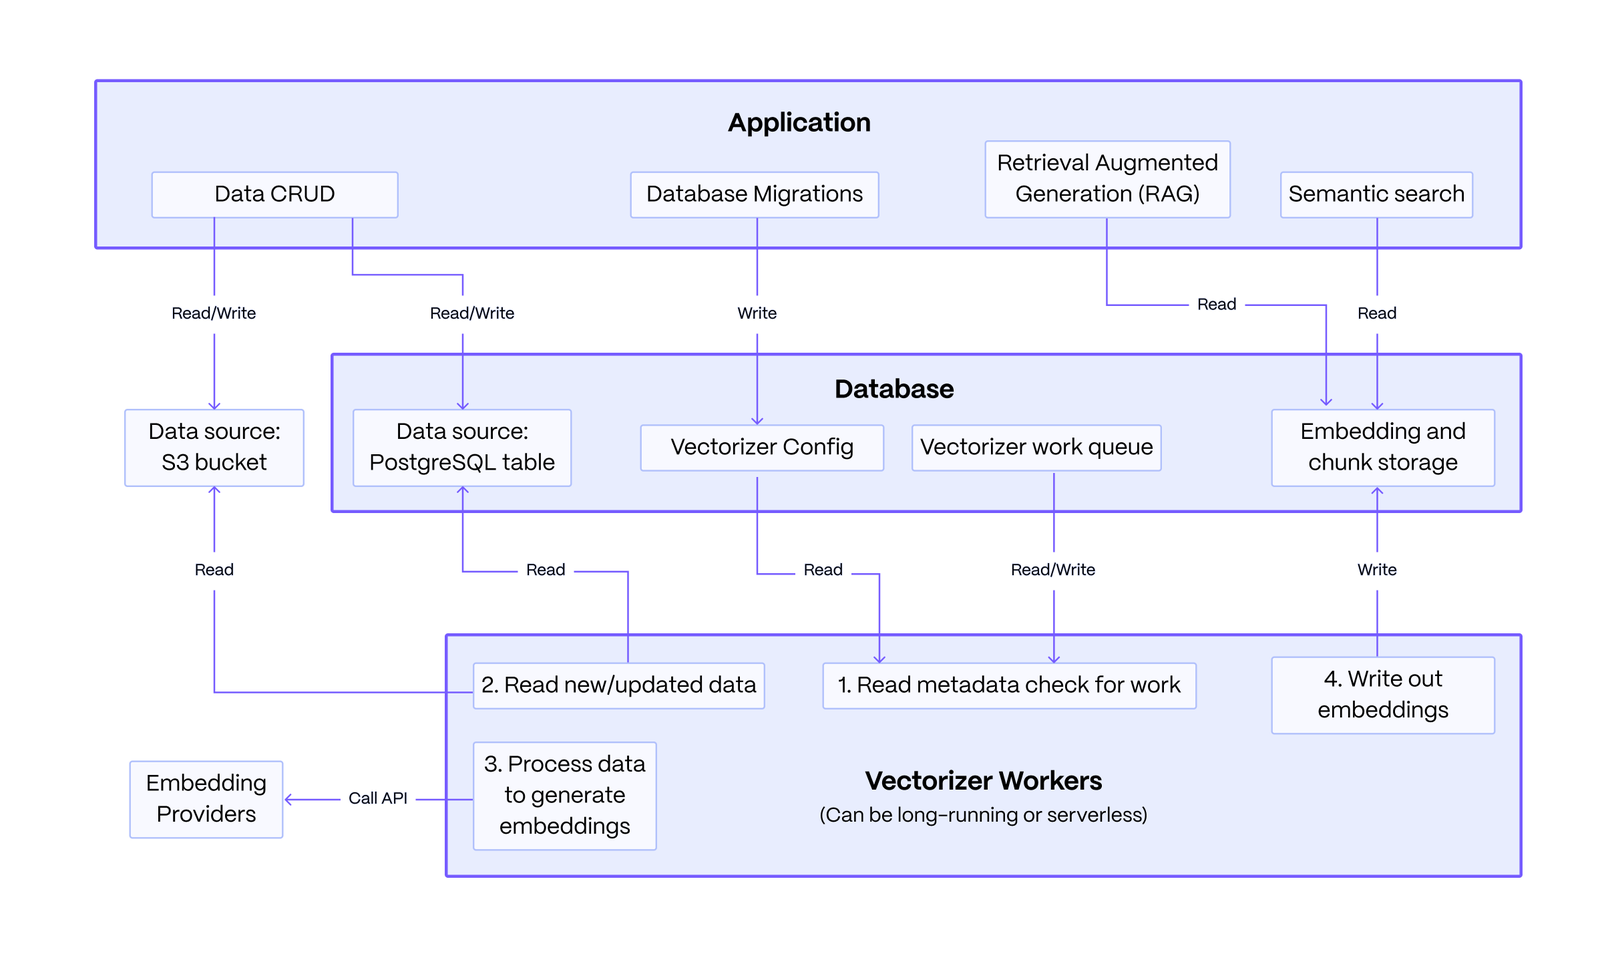
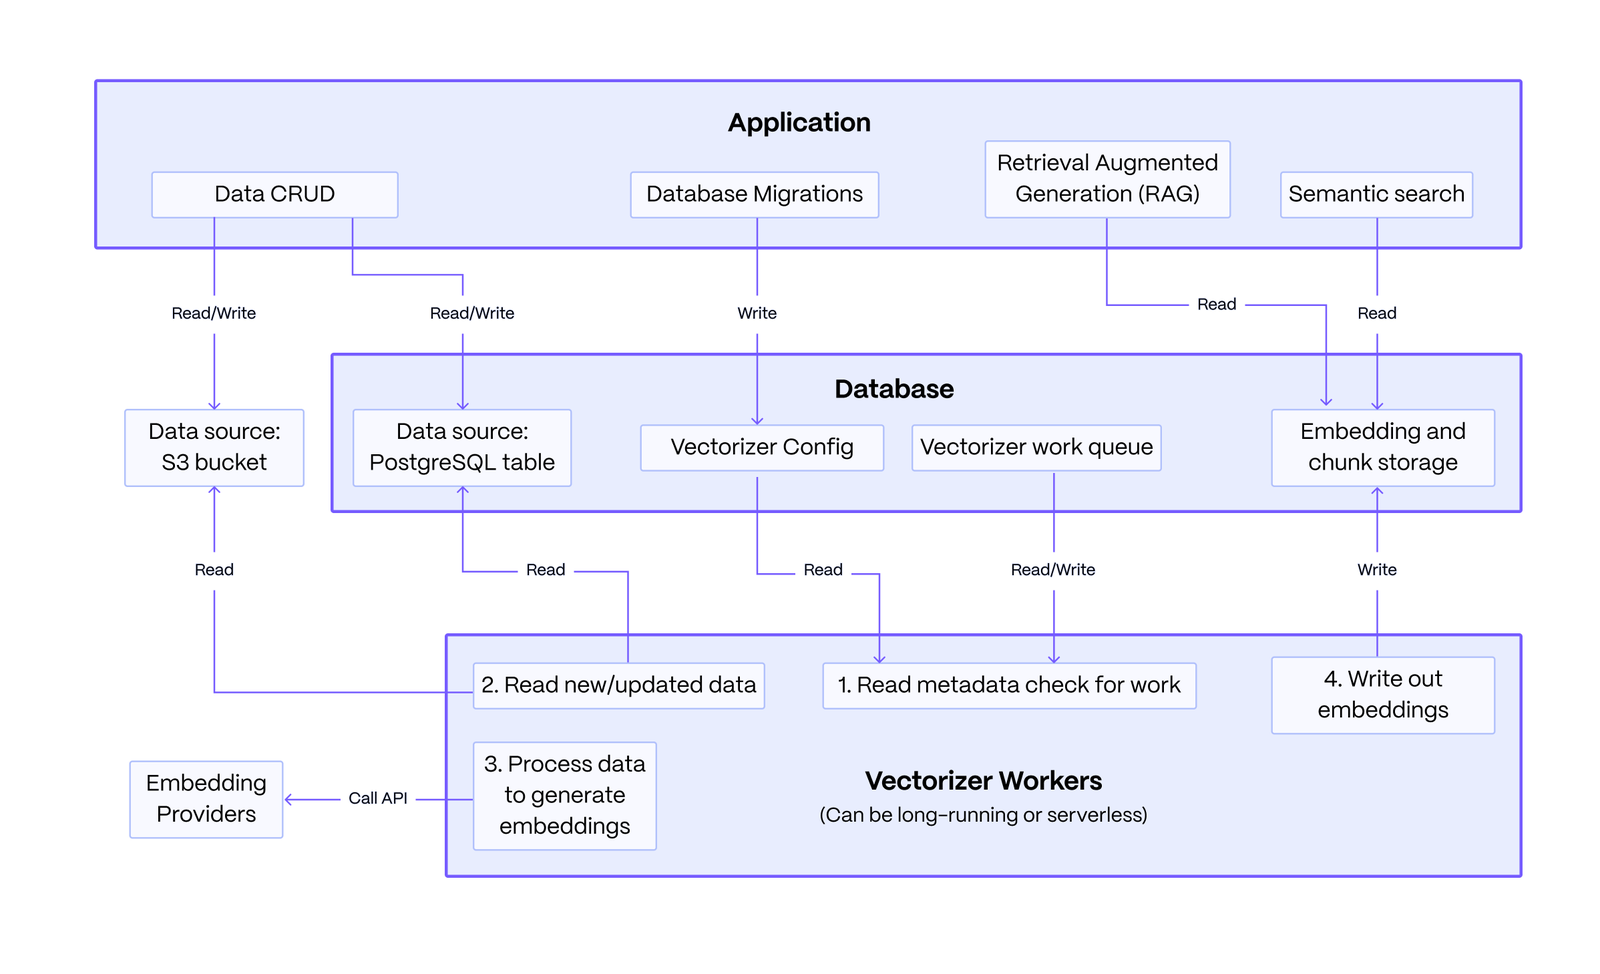
Arquitectura básica: El sistema consta de una aplicación que tú escribes, una base de datos PostgreSQL y workers vectorizadores sin estado. La aplicación define una configuración de vectorizador para incrustar datos de fuentes como PostgreSQL o S3. Los workers leen esta configuración, procesan la cola de datos en embeddings y texto fragmentado, y escriben los resultados de vuelta. La aplicación luego consulta estos datos para impulsar RAG y la búsqueda semántica.
La fortaleza clave de esta arquitectura reside en su resiliencia: las modificaciones de datos realizadas por la aplicación están desacopladas del proceso de embedding, lo que garantiza que los fallos en el servicio de embedding no afecten las operaciones de datos principales.
Primero, instala el paquete pgai.``` pip install pgai
Luego, instala los componentes de la base de datos pgai. Puedes hacerlo desde la terminal usando la CLI o en el código de tu aplicación Python usando el paquete de Python pgai.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
Esta guía de inicio rápido demuestra cómo pgai Vectorizer permite la búsqueda semántica y RAG sobre datos de PostgreSQL al crear y sincronizar automáticamente los embeddings a medida que los datos cambian.
El "ingrediente secreto" clave de pgai Vectorizer es su enfoque declarativo para la generación de embeddings. Simplemente define tu pipeline y deja que Vectorizer maneje la complejidad operativa de mantener los embeddings sincronizados, incluso cuando los endpoints de embeddings no son confiables. Puedes definir una versión simple del pipeline de la siguiente manera:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
El vectorizador creará automáticamente embeddings para todas las filas de la
tabla `wiki` y, lo que es más importante, mantendrá los embeddings sincronizados con los
datos subyacentes a medida que estos cambien.  **Piénsalo casi como declarar un índice** en
la tabla `wiki`, pero en lugar de que la base de datos gestione la estructura de datos del índice
por ti, el Vectorizador gestiona los embeddings.

## Ejecutar el inicio rápido

**Requisitos previos:**
- Una base de datos PostgreSQL ([instrucciones de Docker](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- Una clave de API de OpenAI (usamos OpenAI para los embeddings en el inicio rápido, pero puedes usar [múltiples proveedores](#modelos-de-embedding-compatibles)).

Crea un archivo `.env` con lo siguiente:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
Puedes descargar el código Python completo y el requirements.txt del ejemplo de inicio rápido y ejecutarlo en el mismo directorio que el archivo .env.
