 praetorian-inc/noseyparker
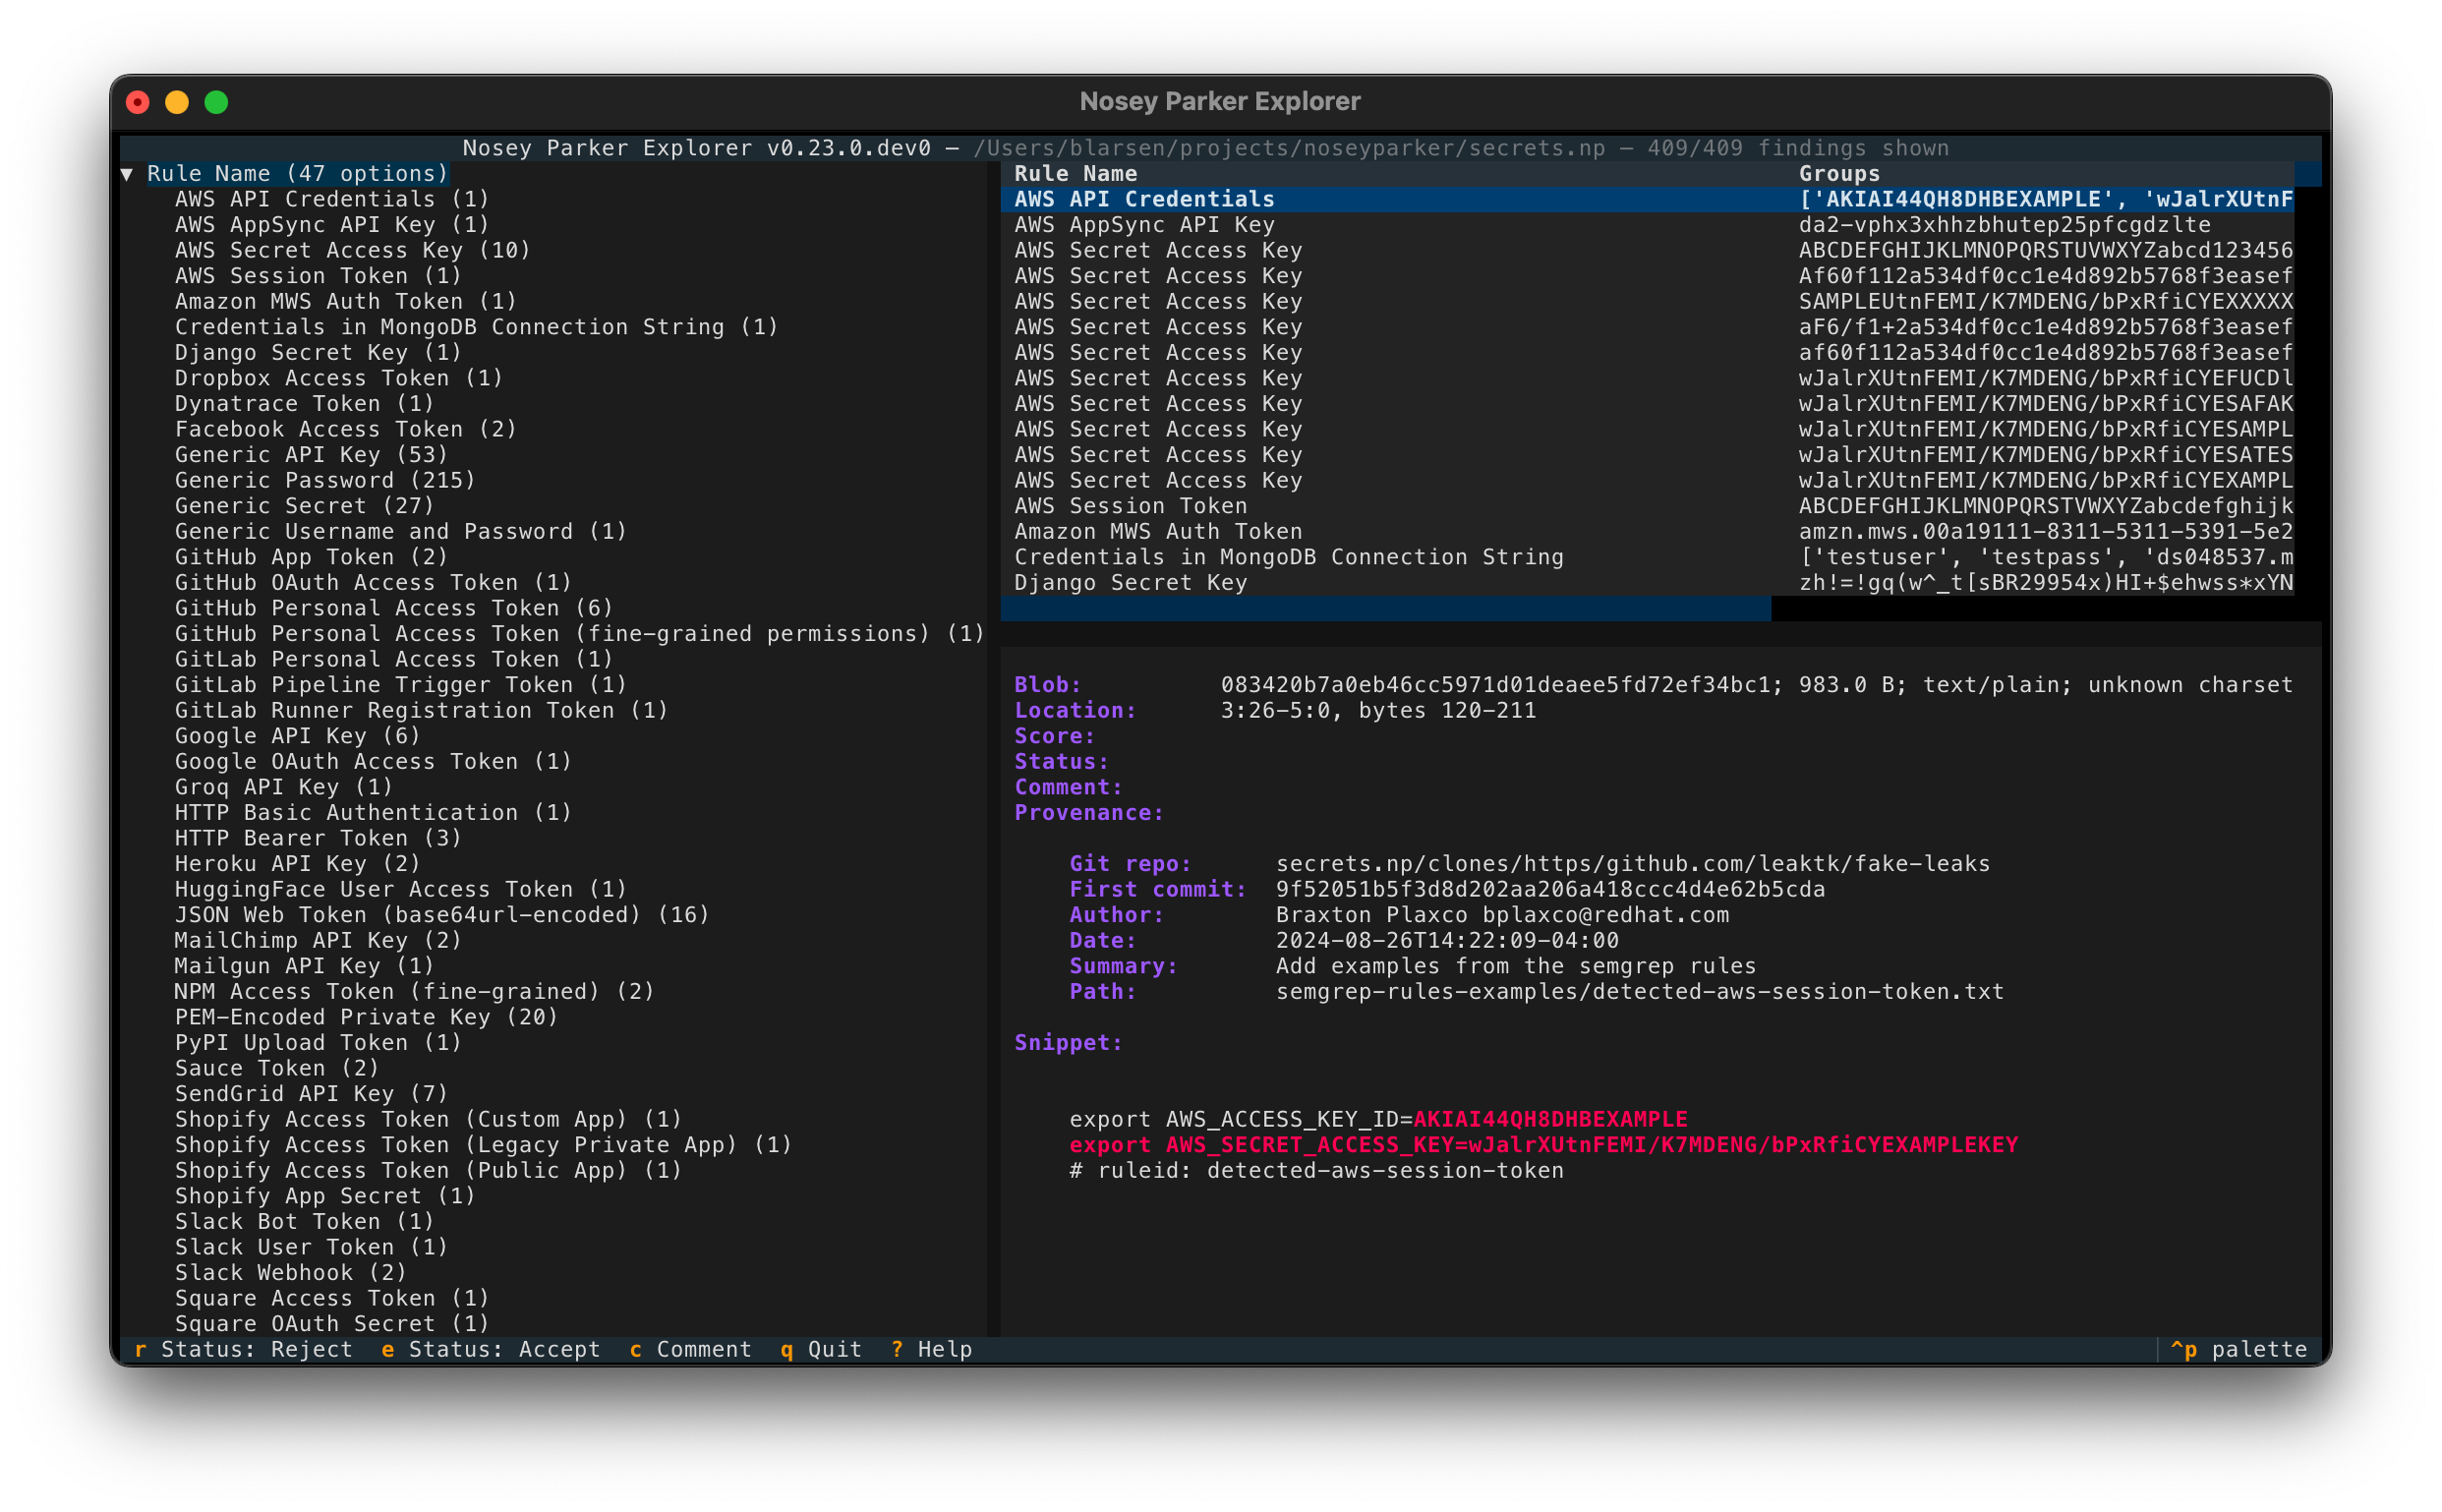
Nosey Parker es una herramienta de línea de comandos que encuentra secretos e información sensible en datos textuales y en el historial de Git.

Consulte nuestra publicación de anuncio https://www.praetorian.com/blog/titus-open-source-secret-scanner/. El repositorio de Titus se puede encontrar en https://github.com/praetorian-inc/titus
Nosey Parker es una herramienta CLI que encuentra secretos e información sensible en datos textuales.
Es esencialmente una herramienta especializada tipo grep para la detección de secretos.
Ha sido diseñada para seguridad ofensiva (por ejemplo, facilitando el movimiento lateral en equipos rojos), pero también puede ser útil para pruebas de seguridad defensivas. Ha encontrado secretos en cientos de compromisos de seguridad ofensivos en Praetorian.
Características clave:
El flujo de trabajo típico consta de tres fases:
scanreportbrew install noseyparker
La página de la última versión contiene binarios preconstruidos para x86_64/aarch64 Linux y macOS.
docker pull ghcr.io/praetorian-inc/noseyparker:latest
El commit más reciente también está disponible a través de la etiqueta main.
docker pull ghcr.io/praetorian-inc/noseyparker-alpine:latest
El commit más reciente también está disponible a través de la etiqueta main.
https://aur.archlinux.org/packages/noseyparker
Nosey Parker no se compila de forma nativa en Windows (#121). Es posible ejecutarlo en Windows usando WSL1 y la versión nativa de Linux.
Esto se ha probado con varias versiones de Ubuntu Linux y macOS tanto en x86_64 como en aarch64.
Dependencias necesarias:
cargo: enfoque recomendado: instalar desde https://rustup.rscmake: necesario para construir la crate vectorscan-sys y otras dependenciasboost: necesario para construir la crate vectorscan-sys (versión compatible >=1.57)git: necesario para incrustar información de versión en la CLI de noseyparkerpatch: necesario para construir la crate vectorscan-syspkg-config: necesario para construir la crate vectorscan-syssha256sum: necesario para calcular resúmenes (a menudo proporcionado por el paquete coreutils)zsh: necesario para los scripts de construccióncreate-release.zsh$ rm -rf release && ./scripts/create-release.zsh
Si tiene éxito, esto producirá una estructura de directorios en release poblada con artefactos de la versión.
El programa de línea de comandos estará en release/bin/noseyparker.
Ejecutar el binario noseyparker sin argumentos imprime ayuda de nivel superior y sale.
Puede obtener ayuda abreviada para un comando en particular ejecutando noseyparker COMMAND -h.
Hay ayuda más detallada disponible con el comando help o la opción larga --help.
Las versiones preconstruidas también incluyen páginas de manual que recopilan la ayuda de línea de comandos en un solo lugar. Estas páginas de manual convertidas a formato Markdown también están incluidas en el repositorio aquí.
Si tiene una pregunta que no responda esta documentación, por favor inicie una discusión.
El almacén de datos es un directorio especial que Nosey Parker utiliza para registrar sus hallazgos y mantener su estado interno.
Un almacén de datos será creado implícitamente por el comando scan si es necesario.
Cada entrada escaneada se llama blob. Cada blob tiene un ID de blob único, que es un resumen SHA-1 calculado de la misma manera que lo hace git.
Cada blob tiene una o más entradas de procedencia asociadas. Una entrada de procedencia es metadato que describe cómo se descubrió la entrada, como un archivo en el sistema de archivos o un archivo en el historial de un repositorio Git.
Nosey Parker es un sistema basado en reglas que utiliza expresiones regulares.
Cada regla tiene un patrón único con al menos un grupo de captura que aísla el contenido de la coincidencia del contexto circundante.
Puede listar las reglas disponibles con noseyparker rules list.
Una colección de reglas está organizada en un conjunto de reglas.
El conjunto de reglas predeterminado de Nosey Parker incluye reglas que detectan cosas que parecen ser secretos.
Hay otros conjuntos de reglas disponibles; puede listarlos con noseyparker rules list.
Cuando el patrón de una regla coincide con una entrada, produce una coincidencia. Una coincidencia se define de manera única por una regla, ID de blob, desplazamiento de inicio en bytes y desplazamiento de fin en bytes; estos campos se utilizan para calcular un identificador de coincidencia único.
Las coincidencias que comparten una regla y grupos de captura se combinan en un hallazgo. En otras palabras, un hallazgo es un grupo de coincidencias. Esta es la unidad de informe de nivel superior de Nosey Parker.
Al usar la imagen Docker, reemplace noseyparker en los siguientes comandos con una invocación de Docker que utilice un volumen montado:
docker run -v "$PWD":/scan ghcr.io/praetorian-inc/noseyparker:latest <ARGS>
El contenedor Docker se ejecuta con /scan como su directorio de trabajo, por lo que montar $PWD en /scan dentro del contenedor hará que la finalización con tabulador y las rutas relativas en su invocación de línea de comandos funcionen.
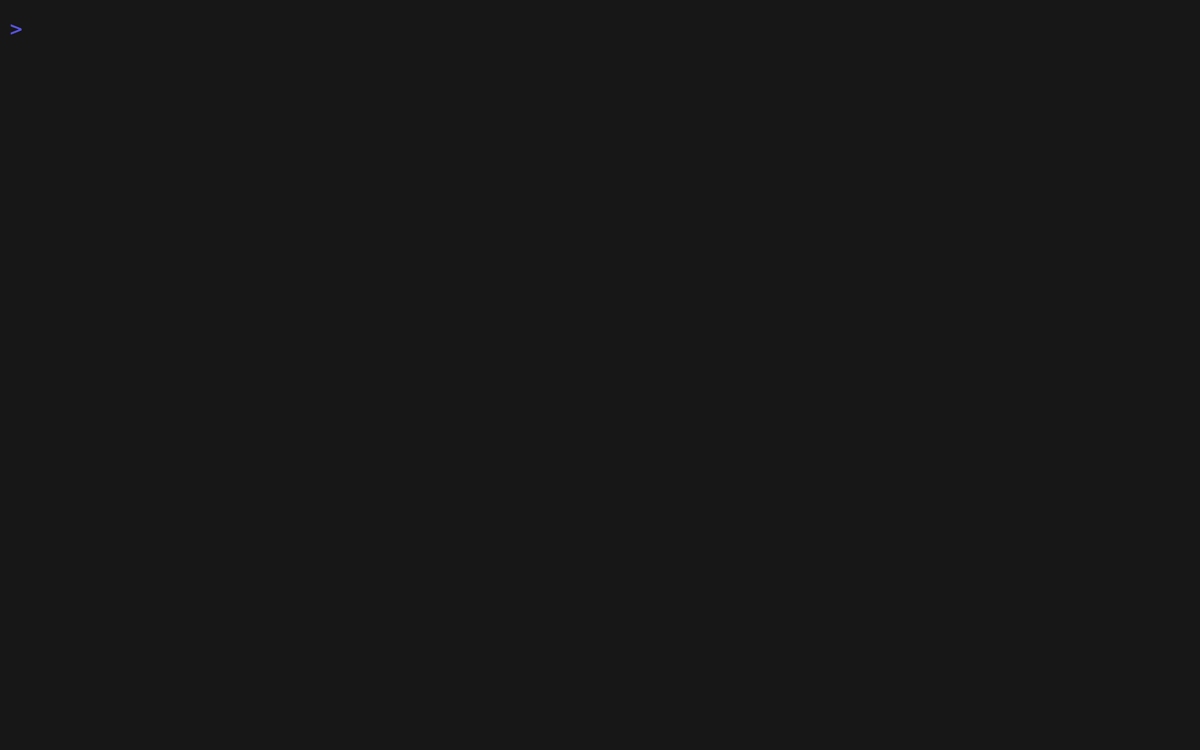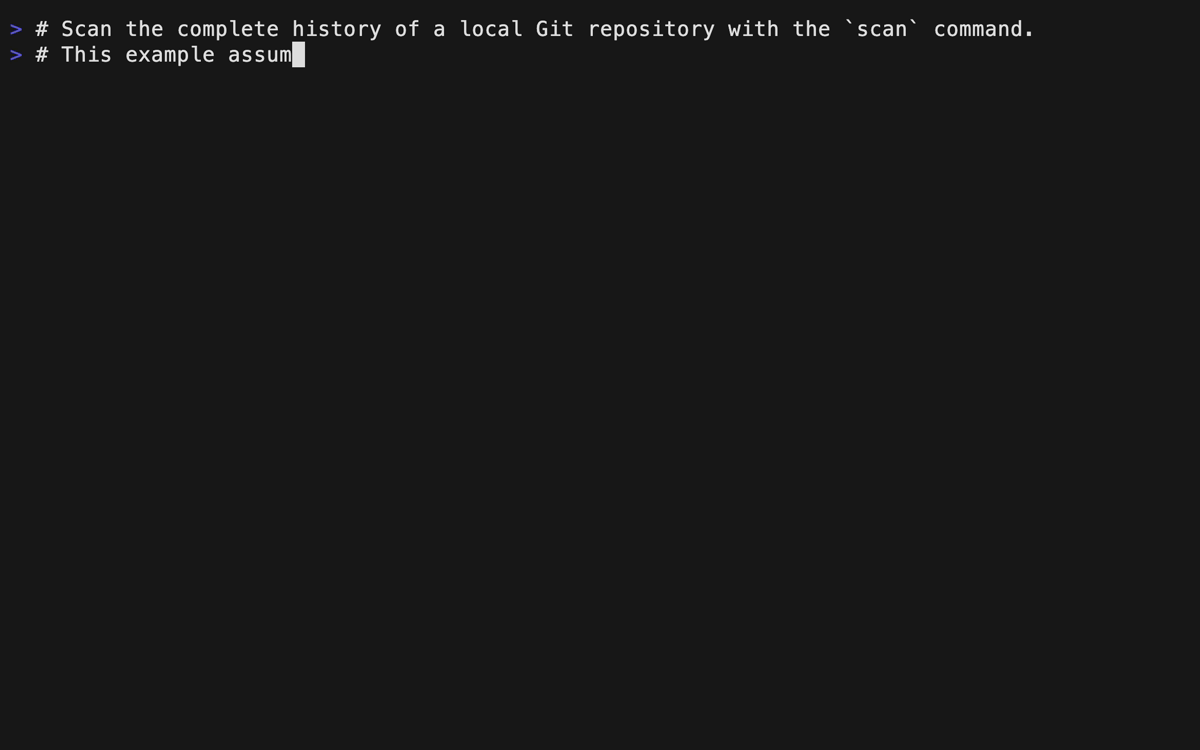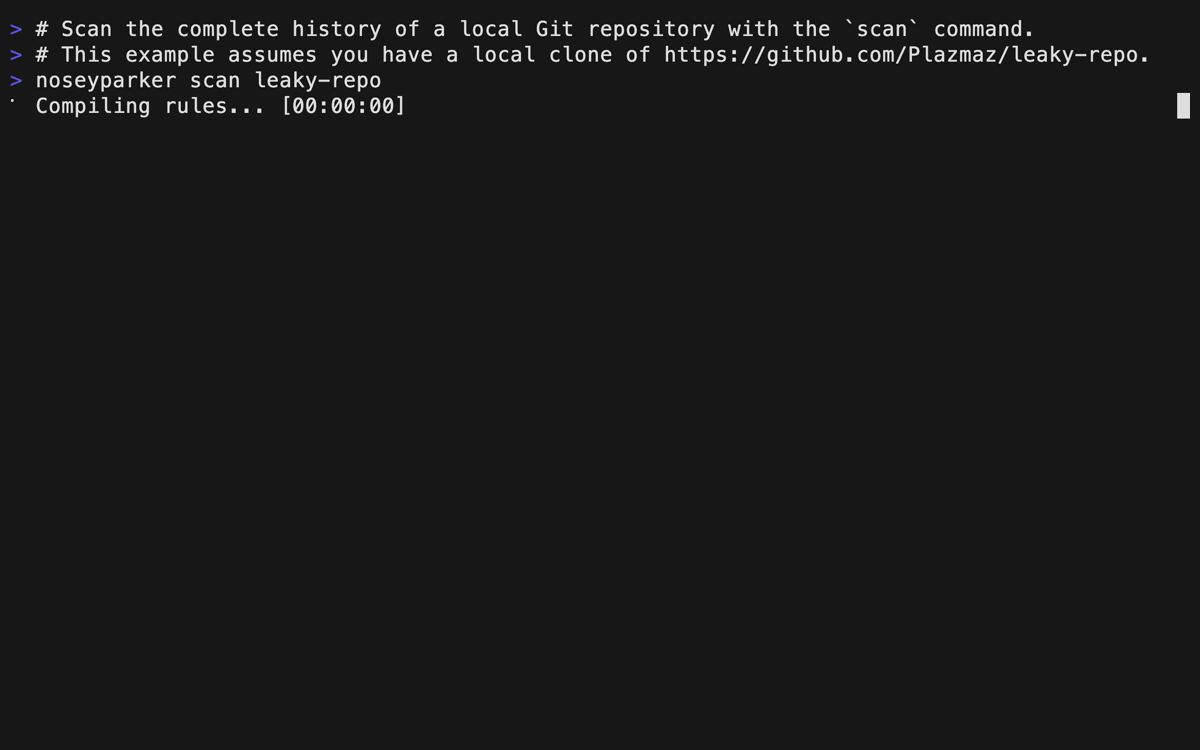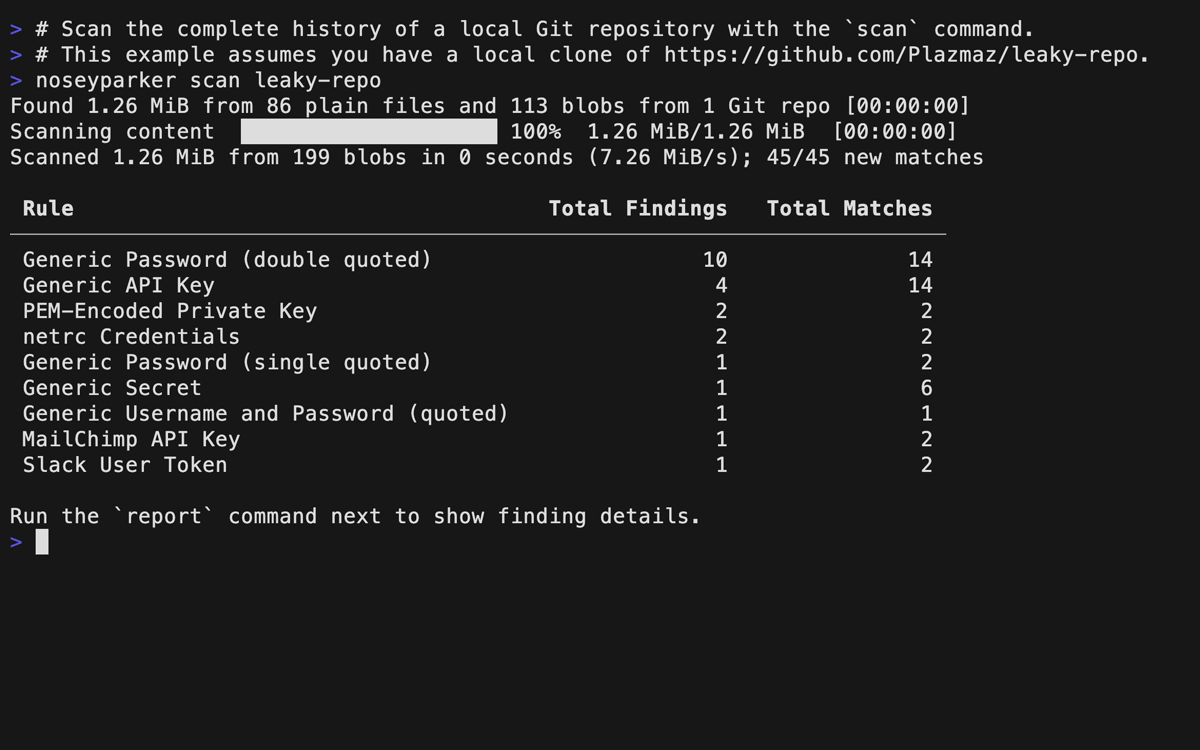
Nosey Parker tiene soporte nativo para escanear archivos, directorios y el historial completo de repositorios Git.
