confusable-vision
El primer conjunto de datos de confundibles fuente por fuente del mundo. Qué caracteres Unicode se parecen a cuáles, medido a partir de los contornos de las fuentes en lugar de los píxeles. La versión actual, 2026.09.26, compara cada letra y dígito que dibuja cada una de las 322 fuentes, al tamaño y posición de línea base que tiene cada glifo en texto corrido. Los parecidos de letras y dígitos ASCII se verifican luego en contexto: colocados entre otras letras en fuentes comunes al tamaño al que la gente las lee, y comparados con pares que todos aceptan como similares, como 0 y O.
addons.mozilla.org usa caracteres de confusable-vision para verificar nombres de complementos en busca de parecidos, acreditado en el código fuente de Mozilla; véase Usado por.
Usado por
- Mozilla addons-server, el código detrás de addons.mozilla.org, añade caracteres de la salida de confusable-vision a la tabla que usa para plegar parecidos a ASCII al verificar nombres de complementos:
src/olympia/amo/confusables.py, pull requests #24468, #24541, #24612 y #24665 (de febrero a marzo de 2026).
- disarm (raeq/disarm), que canonicaliza Unicode adversarial antes de que llegue a clasificadores, índices e identificadores, añade pares medidos de confusable-vision a sus tablas de confundibles:
data/confusables_supplement.tsv, data/confusables_vision.tsv.
- SilverSpeak (ACMCMC/silverspeak), una biblioteca de Python para realizar y neutralizar ataques de homoglifos en texto, construye los vecinos visuales de su grafo de homoglifos a partir de los archivos de descubrimiento de confusable-vision (
docs/hkb.md).
- namespace-guard distribuye los pares medidos, y a través de él llegan a agent-sanitizer, que usa namespace-guard como su motor predeterminado para plegar caracteres parecidos en la entrada de llamadas a herramientas de un agente de IA a ASCII (deps.dev).
Estos proyectos tomaron sus datos de las salidas de confusable-vision de febrero y marzo de 2026.
Comentado en Hacker News: Rendericé 1.418 confundibles en 230 fuentes y Confusables.txt y NFKC discrepan en 31 caracteres.
Versión 2026.09.26 en cifras:
- 322 fuentes: todas las fuentes de macOS, incluidas las que descarga bajo demanda como PingFang, más Roboto, Noto Sans, Noto Serif, Noto Sans CJK y DejaVu. 64.751 puntos de código en 140 sistemas de escritura.
- 11.517 pares similares en al menos una fuente o combinación de fuentes, de los cuales 5.975 superan los umbrales sugeridos.
- 719 pares de un carácter y una secuencia ASCII de dos letras, como ǁ y ll, o Ы y bl.
- 3.055 candidatos a parecidos de letras, dígitos y secuencias ASCII verificados en contexto: 646 similares en el nivel estricto, 358 más en el nivel amplio, 101 más que coinciden con el diseño de la letra de otra fuente común. 224 de los estrictos no están en el confusables.txt de Unicode.
Los datos se publican como una versión versionada en data/release/2026.09.26/ (CC-BY-4.0). namespace-guard y d0ma1n se construyen sobre ella.
Qué cambió desde la versión 2
La versión 2 (2026.09.24, y 2026.09.25 para los datos de TLD) comparaba solo los pares y fuentes que ejecuciones anteriores habían comparado. Una auditoría de glifos idénticos encontró que capturaba 637 de los 2.654 casos en que una fuente dibuja dos caracteres con el mismo glifo. La versión 3 corrige eso y añade tres cosas:
- Cobertura. Cada letra y dígito que dibuja cada fuente se compara con todos los demás de esa fuente, incluidos Han y Hangul. La versión 2 tomaba sus caracteres de una lista fija, por lo que nunca alcanzó la mayor parte de Yi, aborigen canadiense, etíope o los sistemas de escritura índicos, y se perdió las fuentes solo de escritura y PingFang.
- Las caras correctas. Las colecciones de fuentes se cargan en la cara que un navegador usa para texto de cuerpo. Las ejecuciones anteriores tomaban la primera cara, que para algunas colecciones era negrita, black o cursiva.
- Contornos superpuestos, como en fuentes variables como San Francisco, se miden como la unión de sus trazos, tal como los ve un lector.
- Secuencias de dos letras. Cada secuencia de dos letras o dígitos ASCII (3.844) se compone como la compone cada fuente, con su kerning y ligaduras, y se compara como un carácter.
- El umbral entre fuentes lo fija el cuartil superior de las fuentes de página, de modo que añadir fuentes al estudio no puede moverlo.
- La verificación en contexto (abajo).
Las cifras de marzo de 2026 (249.976 pares de un solo carácter y 2.524.275 pares de bigramas en 245 fuentes) provienen de mediciones que ignoraban tamaño y línea base. Quedan superadas; los archivos de esas ejecuciones permanecen en data/output/ como referencia.
Cómo funciona
Medición de glifos
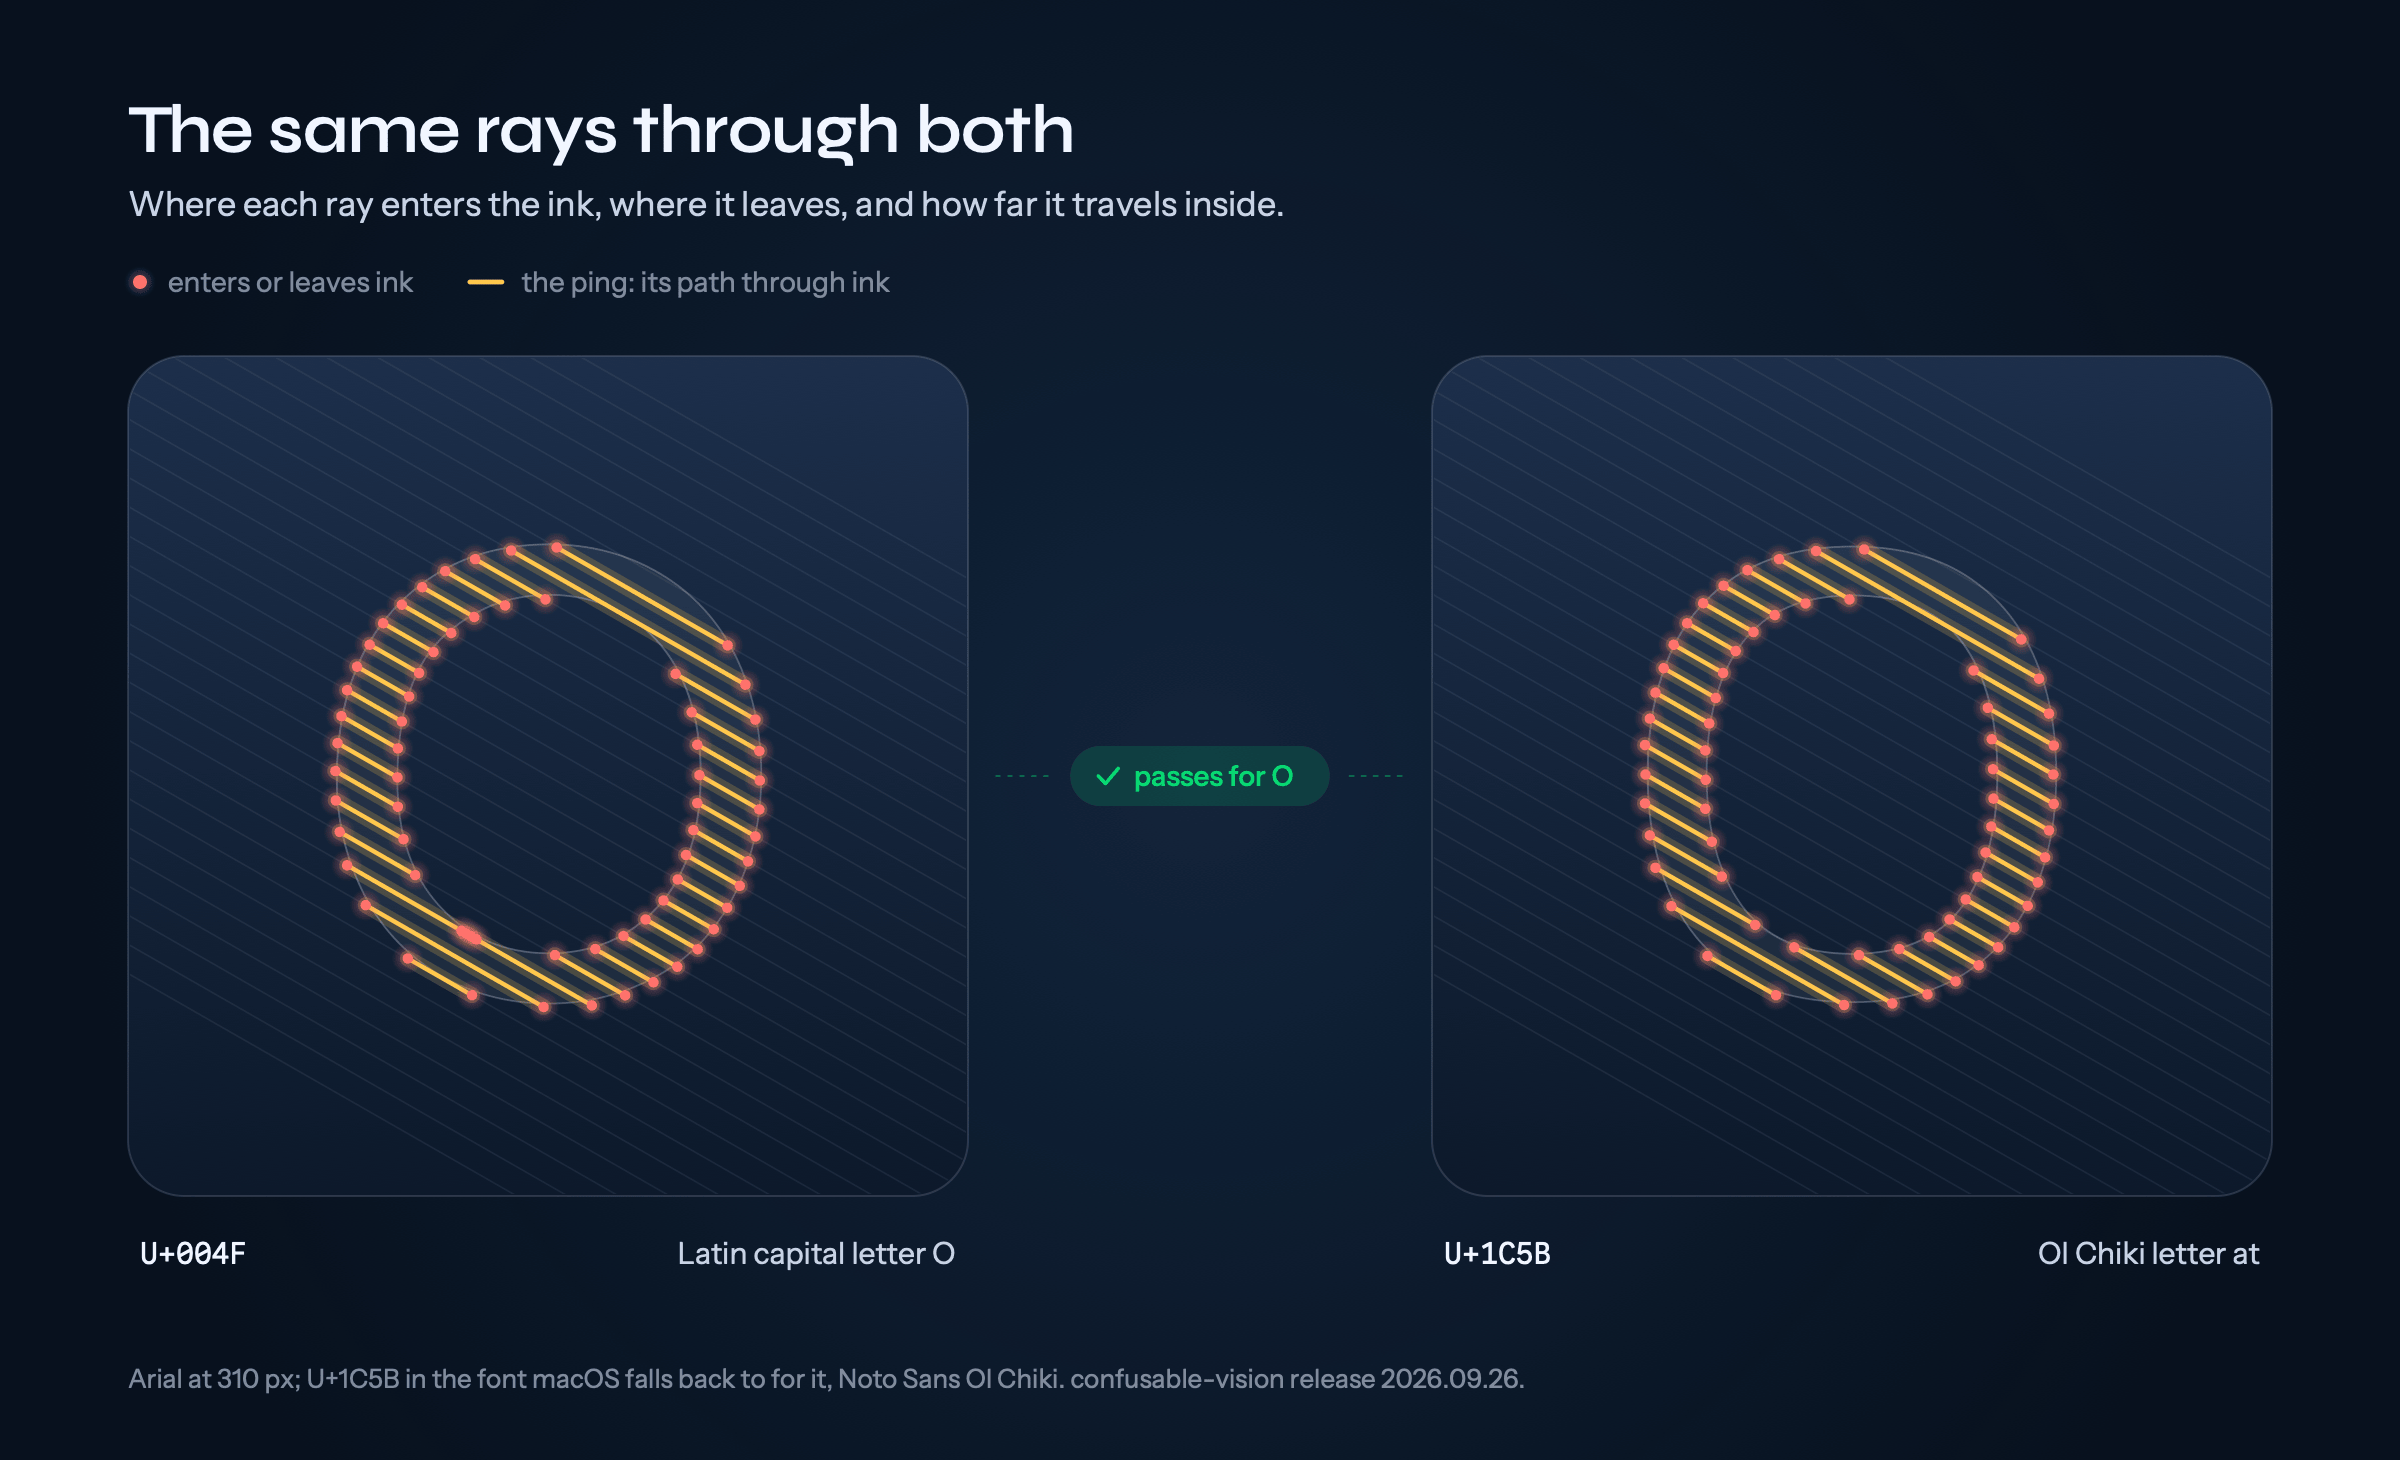
RaySpace lanza rayos paralelos a través del contorno de cada glifo en 36 ángulos, 50 rayos cada uno, y registra cinco cosas por rayo: cuántas veces cruza el contorno, dónde, en qué ángulo, cuánto viaja a través de la tinta cada vez (su ping, el ancho del trazo a lo largo del rayo), y el hueco más ancho entre trazos. Cada glifo se mide dos veces: en su propia caja, para la forma, y en un marco fijo sobre la línea base, de modo que el tamaño y la posición cuentan. Dos caracteres son similares en una fuente cuando la distancia de forma es inferior a 0,5 y la distancia anclada a la línea base es inferior a 0,2. La comparación se ejecuta en Rust (native/cv-pairs), en todos los núcleos.
- Dentro de una fuente: cada par de letras y dígitos que dibuja la fuente.
- Entre fuentes: un carácter en su propia fuente, como lo dibujaría el fallback de un navegador, contra las 62 letras y dígitos ASCII de cada una de las 26 fuentes de página que carecen de él. Cuenta cuando la letra ASCII es la más cercana, y el carácter está tan cerca de ella como esa letra lo está de sí misma en el cuartil superior de las otras fuentes de página.
- Secuencias: cada carácter contra las 3.844 secuencias ASCII de dos caracteres, tal como las compone cada fuente (Core Text; HarfBuzz las compone de forma idéntica salvo por el tracking de la fuente del sistema).
Verificación en contexto