

AttackGen es una herramienta de pruebas de respuesta a incidentes de ciberseguridad que aprovecha el poder de los grandes modelos de lenguaje y el completo marco MITRE ATT&CK. La herramienta genera escenarios de respuesta a incidentes personalizados basados en grupos de actores de amenaza seleccionados por el usuario y los detalles de su organización.
# AttackGen
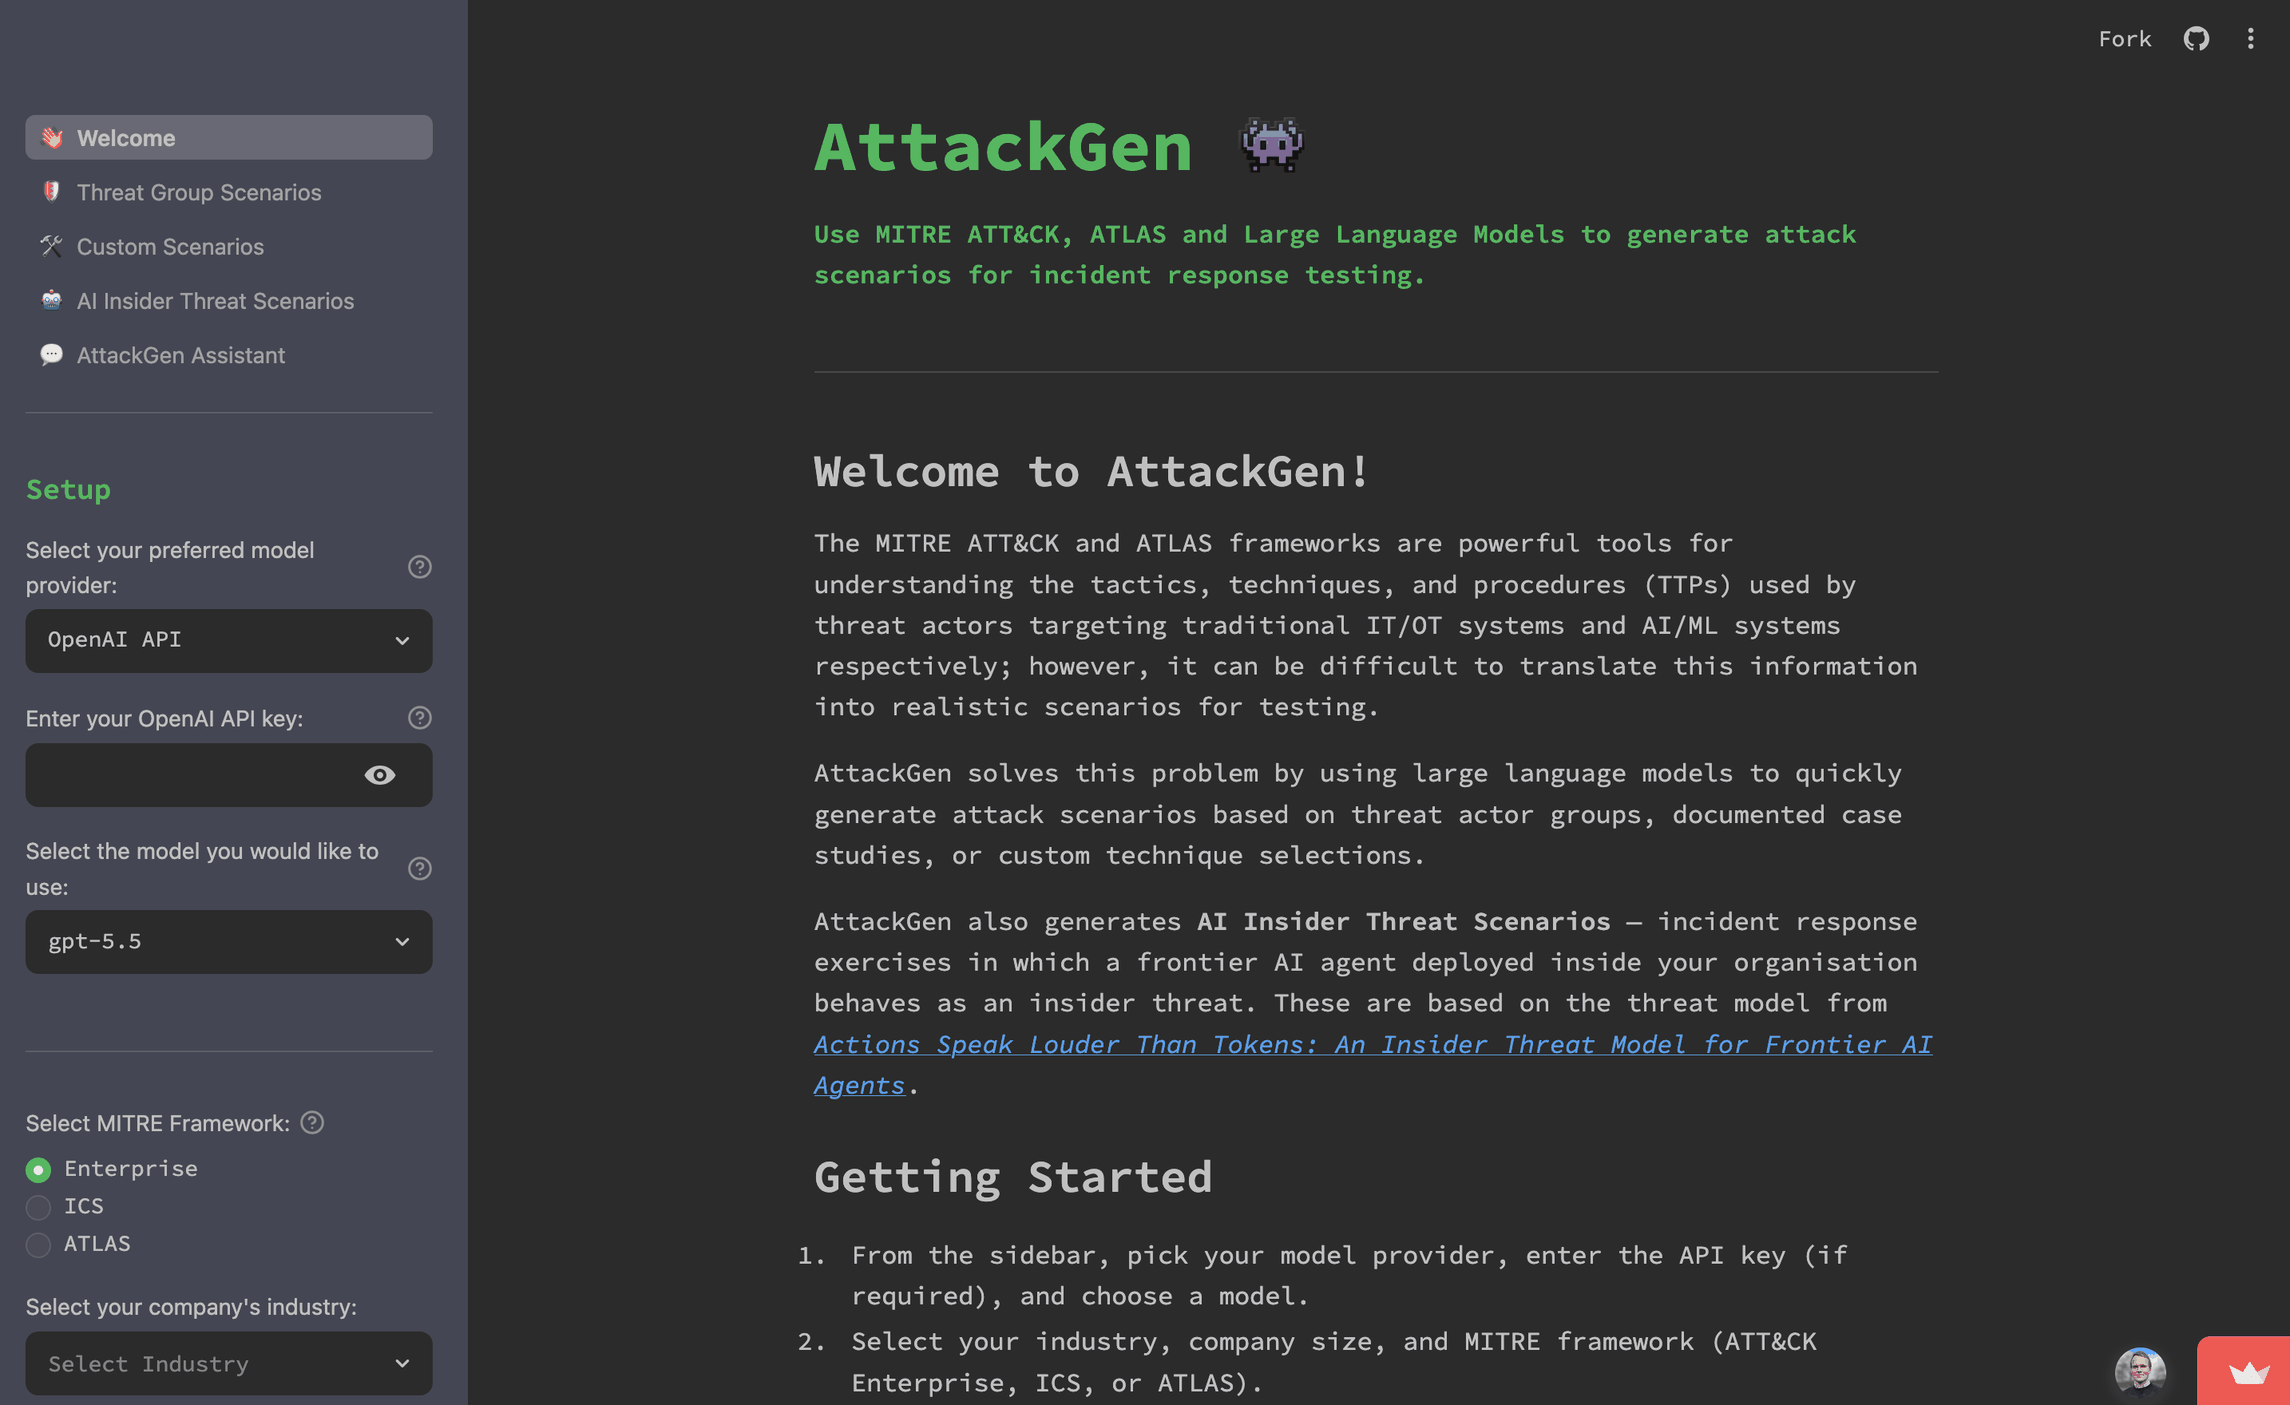
AttackGen es una herramienta de pruebas de respuesta a incidentes de ciberseguridad que aprovecha el poder de los grandes modelos de lenguaje y los completos marcos MITRE ATT&CK y ATLAS. La herramienta genera escenarios de respuesta a incidentes personalizados basados en los grupos de actores de amenazas seleccionados por el usuario, estudios de casos de ataques de IA y los detalles de su organización.
## Tabla de contenidos
- [Dale una estrella al repositorio](#star-the-repo)
- [Características](#features)
- [Versiones](#releases)
- [Requisitos](#requirements)
- [Instalación](#installation)
- [Configuración de LangSmith](#langsmith-setup)
- [Configuración de datos](#data-setup)
- [Ejecutar AttackGen](#running-attackgen)
- [Servidor MCP](#mcp-server)
- [Habilidades del agente](#agent-skills)
- [Uso](#usage)
- [Buenas prácticas de seguridad](#security-best-practices)
- [Contribuir](#contributing)
- [Licencia](#licence)
## Dale una estrella al repositorio
Si encuentras útil AttackGen, considera darle una estrella al repositorio en GitHub. Esto ayuda a que más personas descubran la herramienta. ¡Tu apoyo es muy apreciado! ⭐
## Características
- Genera escenarios únicos de respuesta a incidentes basados en los grupos de actores de amenazas o los casos de estudio de ATLAS elegidos.
- Permite especificar el tamaño y el sector de su organización para obtener un escenario adaptado.
- Es compatible con los marcos MITRE ATT&CK Enterprise, ICS (Sistemas de Control Industrial) y ATLAS (Adversarial Threat Landscape for AI Systems).
- Muestra una lista detallada de las técnicas utilizadas por el grupo de actores de amenazas o el caso de estudio seleccionado.
- Cree escenarios personalizados basados en una selección de técnicas de ATT&CK o ATLAS.
- Utilice plantillas de escenarios para generar rápidamente escenarios personalizados basados en tipos comunes de ciberincidentes, incluidos patrones de ataque específicos de IA/ML.
- Genere **Escenarios de amenaza interna de IA**: ejercicios de respuesta a incidentes en los que un agente de IA de frontera desplegado dentro de su organización se comporta como una amenaza interna, basados en el modelo de amenazas de [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk). Los escenarios se configuran según el arquetipo de despliegue del agente (nivel de autonomía), la categoría de amenaza, las amenazas STRIDE y una semilla de escenario opcional en texto libre.
- AttackGen Assistant: una interfaz de chat para actualizar y/o formular preguntas sobre los escenarios generados, con una ruta directa de vuelta a la página de la que procede el escenario.
- Configuración guiada: cada página muestra la misma barra lateral de **Setup**, enumera todos los requisitos pendientes en un único resumen de preparación y mantiene **Generate** deshabilitado hasta que el flujo de trabajo esté listo.
- Los resultados persisten durante la sesión: cada página de escenario conserva su último resultado, sus entradas capturadas y sus descargas entre reejecuciones y navegaciones, y solo un **Regenerate** o **Clear result** explícito lo reemplaza o lo elimina.
- Los escenarios largos incluyen un resumen compacto y navegación por secciones, con accesos directos a los injects, los criterios de éxito, las métricas, los artefactos y las reglas de enfrentamiento con las que el facilitador dirige el ejercicio.
- Recopile comentarios de los usuarios sobre la calidad de los escenarios generados.
- Complemento de Detección y Respuesta: para las técnicas del escenario, AttackGen enumera las estrategias de detección, analíticas, fuentes de registro y mitigaciones de ATT&CK correspondientes, descargables como un archivo `_detection.md` independiente.
- Descarga de la capa de ATT&CK Navigator para los escenarios de Threat Group y Custom, para que pueda ver las técnicas del escenario en el [ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/).
- Alternadores opcionales en las páginas Threat Group y Custom: **AI-enhanced adversary** reformula la misma kill chain como acelerada por IA, y **Purple-team narrative** añade un recorrido del defensor etapa por etapa construido a partir de las detecciones y mitigaciones proporcionadas.
- Escenarios descargables en formato Markdown, además del informe de detección y la capa de Navigator.
- Servidor MCP (`attackgen-mcp`) que expone kill chains, informes de detección, capas de Navigator y generación de escenarios a clientes agénticos, además de la Agent Skill `attackgen-tabletop` para convertir esa salida en un ejercicio de mesa listo para el facilitador.
- Utilice la API de OpenAI, la API de Anthropic (modelos Claude), la API de Google AI, la API de Mistral, la API de Groq o cualquier endpoint personalizado compatible con OpenAI (Ollama, LM Studio, Azure OpenAI, OpenRouter, etc.) para generar escenarios de respuesta a incidentes. Todos los proveedores se enrutan a través de [LiteLLM](https://github.com/BerriAI/litellm) tras un único wrapper interno, por lo que añadir un nuevo modelo es un cambio de una línea.
- Disponible como imagen de contenedor Docker para facilitar el despliegue.
- Integración opcional con [LangSmith](https://docs.smith.langchain.com/) para una potente depuración, pruebas y monitorización del rendimiento de los modelos.
- Gestión segura de credenciales mediante un archivo .env para las claves de API y los secretos.
## Releases
### v0.17
| ¿Qué hay de nuevo? | ¿Por qué es útil? |
| ----------- | ----------------- |
| Aplicar los refinamientos del asistente a las descargas | - Los cambios llegan a los archivos: el chat del asistente antes solo servía para refinar una conversación, por lo que las descargas de escenario y de Detección y Respuesta nunca cambiaban. Un nuevo botón **Apply changes to downloads** las reescribe a partir de la conversación, en una llamada dedicada al modelo que devuelve el documento revisado completo. En el modo **Scenario + Detection & Response** revisa ambos, proporcionando a cada uno el texto actual del otro para que se mantengan alineados.<br><br>- La sección de referencia se mantiene exacta: una aplicación de Detección y Respuesta reescribe solo la narrativa. La referencia determinista de detección y mitigación extraída de los datos de ATT&CK se conserva byte a byte. La capa de Navigator no se regenera y se indica que refleja las técnicas del escenario original.<br><br>- Seguro de probar: una respuesta vacía del modelo se rechaza sin realizar cambios. La página del escenario y el asistente indican en un resultado refinado la hora de la última aplicación, y **Revert to original** restaura el escenario y la narrativa juntos.<br><br>- Descarga donde editas: el asistente ahora ofrece los mismos botones **Download Scenario** y **Download Detection & Response** que la página del escenario.<br><br>- Una conversación por escenario: cada chat pertenece al escenario sobre el que trata, por lo que un escenario recién generado inicia una conversación nueva, y todo el historial permanece visible tras una aplicación. |
| Flujo de trabajo de escenarios guiado y resiliente | - Preparación antes del clic: cada página ahora enumera lo que aún falta —primero la selección propia de la página, luego cualquier campo de Setup incompleto— y mantiene **Generate** deshabilitado hasta que no quede nada pendiente, para que un clic nunca se malgaste descubriendo un error de validación.<br><br>- Opciones antes de la acción: los interruptores de adversario mejorado con IA y de equipo púrpura se sitúan encima de **Generate**, y la opción de equipo púrpura indica que realiza una segunda llamada al modelo.<br><br>- Confirma antes de gastar: antes de iniciar la generación se muestra un resumen de una línea del framework, el perfil de la organización, la selección y los modificadores.<br><br>- Resultados que sobreviven a la navegación: cada página conserva su último resultado, las entradas que lo produjeron y los nombres de sus descargas durante la sesión; abre el asistente y vuelve, y el escenario, su capa de Navigator y su informe de Detección y Respuesta siguen ahí. Editar el formulario deja el resultado en su sitio con una nota de que tus selecciones han cambiado; **Regenerate** y **Clear result** son acciones explícitas.<br><br>- Oriéntate en un escenario largo: un resumen compacto y un índice de secciones se sitúan encima del Markdown completo, con accesos directos a inyectores, preguntas de debate, criterios de éxito, métricas, artefactos y reglas de enfrentamiento.<br><br>- Estados vacíos útiles: sin escenario, el asistente enlaza a las tres formas de crear uno; con uno, nombra el escenario que está tratando y enlaza de vuelta a la página que lo generó. |
| Recuperarse de una narrativa fallida o lenta | - Conserva lo que funcionó: si la narrativa opcional de equipo púrpura falla o se detiene, el escenario base, sus descargas, la capa de Navigator y la referencia determinista de Detección y Respuesta siguen siendo totalmente utilizables, con un mensaje que indica qué falló.<br><br>- Reintenta solo lo que falló: **Retry purple-team narrative** vuelve a ejecutar únicamente la narrativa, sin una segunda llamada al escenario base, y la fusiona en la vista y la descarga de Detección y Respuesta. Un escenario base fallido ofrece su propio reintento usando las entradas capturadas en **Generate**.<br><br>- Un temporizador que sigue avanzando: el tiempo transcurrido ahora avanza mientras se espera el primer token de un modelo, por lo que una espera larga ya no parece un bloqueo. |
| Fallos más claros cuando las técnicas no se cargan | - Los fallos se informan como fallos: un grupo de amenazas cuya búsqueda de técnicas falla ya no se muestra como un grupo sin técnicas, y Custom Scenarios ya no oculta su selector de técnicas ni te pide que selecciones técnicas cuando la lista no se pudo cargar.<br><br>- Un siguiente paso, no un callejón sin salida: ambos bloqueos ahora indican qué puedes hacer ante el fallo. |
| Accesibilidad y texto más conciso | - Compatible con teclado y lectores de pantalla: los controles que solo muestran iconos tienen nombres accesibles significativos, las etiquetas de los formularios son únicas y el orden del teclado y el foco son visibles y lógicos. El diseño ya no se desborda horizontalmente en el ancho de un teléfono, y las advertencias vacías de color de tema en la consola han desaparecido.<br><br>- Verificado en CI: las pruebas de humo en navegadores reales para la higiene de la consola y la accesibilidad ahora se ejecutan en cada pull request y condicionan la imagen de la versión.<br><br>- Menos que leer: las páginas de escenarios ya no repiten el resumen previo al vuelo en un segundo panel expandible ni explican su propia gestión de estado. |
| Actualización del registro de modelos | - Modelos más recientes: la lista de modelos se actualiza según la documentación actual de cada proveedor — **GPT-6 Astra** encabeza la lista de OpenAI, **Claude Opus 5.5**, **Claude Opus 5** y **Claude Fable 5.1** se unen a la de Anthropic, y Google incorpora **Gemini 3.8 Flash** junto a **Gemini 3.5 Flash Lite**, conservando en cada caso una generación anterior por continuidad. La lista de Anthropic ahora lidera con **Claude Opus 5.5** —el valor predeterminado de la barra lateral cuando no has elegido uno— en lugar del más caro Fable 5.1.<br><br>- Eliminadas las entradas retiradas: se han quitado los ids que los proveedores han reemplazado o dado de baja —Claude Opus 4.7 y 4.8 (más de una generación de Opus por detrás una vez que llega Opus 5.5) y `llama-3.3-70b-versatile` y `llama-3.1-8b-instant` de Groq (ambos dados de baja el 16 de agosto de 2026)— para que la barra lateral no pueda ofrecer un modelo que solo da error al pulsar **Generate**. El nivel de razonamiento de pesos abiertos de Groq es ahora `qwen/qwen3.8-27b`.<br><br>- Regla de temperatura mantenida con rigor: `supports_temperature` se establece según el comportamiento real de muestreo de cada modelo de Anthropic —todos los Claude a partir de 4.7 rechazan una temperatura personalizada, y Haiku 4.5 sigue siendo el único modelo listado que la acepta. La prueba que protege esto ahora falla cuando una nueva entrada de Anthropic omite el indicador, en lugar de solo cuando alguien lo establece manualmente. |
| Mantenimiento de plataforma y seguridad | - Python 3.11 como mínimo: Python 3.10 ya no es compatible. LiteLLM 1.98.0 y versiones posteriores importan una función de tipado que solo existe a partir de 3.11.<br><br>- Imagen base parcheada: la imagen de Docker se reconstruye sobre un `python:3.14-slim` actual, eliminando las CVE de la imagen base de Debian señaladas por Trivy, incluidas tres críticas en `perl-base`.<br><br>- Errores reales de llamadas fallidas: ahora se declara `tenacity`, de modo que una llamada a un modelo fallida informa del error real del proveedor (por ejemplo, una clave de API no válida) en lugar de una instrucción para instalar `tenacity`.<br><br>- Los comentarios permanecen con su escenario: una valoración se registra respecto a la ejecución que produjo el escenario en pantalla, nunca respecto a la última ejecución de otra página. |
<details>
<summary>Versiones anteriores (v0.16 y anteriores)</summary>
### v0.16
| ¿Qué hay de nuevo? | ¿Por qué es útil? |
| ----------- | ----------------- |
| Generación con el escenario base primero | - El escenario antes de la espera: la generación ahora se ejecuta por fases — el escenario base se renderiza primero con sus botones **Download Scenario** y **Download ATT&CK Navigator Layer** ya activos, y la narrativa opcional de purple-team se transmite después. Si esa segunda pasada es lenta, o no la necesitas, el escenario es utilizable de inmediato en lugar de retenerse hasta que todo termine.<br><br>- Entradas congeladas al generar: cada ejecución trabaja a partir de una instantánea tomada en el momento en que pulsas **Generate**, de modo que cambiar la barra lateral a mitad de ejecución no puede reescribir a medias el escenario que se está produciendo.<br><br>- Progreso honesto: una etiqueta de tiempo transcurrido en ejecución y fases con nombre — preparación de entradas, generación del escenario base, construcción de las exportaciones deterministas, generación de la narrativa de purple-team — muestran en qué punto se encuentra realmente una ejecución larga. |
| Selectores neutros y sin callejones sin salida | - Solo opciones que funcionan: los selectores de grupo de amenazas y de caso de estudio ahora ofrecen únicamente las opciones que realmente producen un escenario, de modo que una selección ya no puede llevar a un callejón sin salida.<br><br>- Orden natural: los grupos se ordenan en orden numérico natural, de modo que APT3 aparece antes que APT28 y APT30 en lugar de ordenarse como texto y quedar entre ellos. |
| Barra lateral de configuración compartida en cada página | - Configura una vez: el proveedor, el modelo, el framework, el sector y el tamaño de la empresa ahora residen en una única barra lateral **Setup** compartida en cada página de escenario — Threat Group, Custom y AI Insider Threat — en lugar de volver a introducirse en cada una.<br><br>- Sobrevive a la navegación: las selecciones no secretas persisten al moverte entre páginas y se reflejan en la URL, mientras que las claves de API se mantienen deliberadamente fuera de la cadena de consulta. |
| Mantenimiento de plataforma y seguridad | - MCP en el SDK 2.x: el servidor MCP se ha migrado al SDK `mcp` 2.x.<br><br>- Imagen base más reciente: la imagen de Docker ahora se construye sobre `python:3.14-slim`.<br><br>- La CI bloquea en lugar de advertir: los escaneos de seguridad ahora hacen fallar la compilación ante hallazgos en lugar de solo reportarlos — pip-audit y Bandit bloquean, Trivy ya no cuenta erróneamente el SBOM vendorizado de pip como paquetes instalados, y las CVE accionables de la imagen están resueltas. GitHub Actions ha abandonado el entorno de ejecución de Node 20 y Dependabot ahora rastrea las propias acciones del flujo de trabajo. |
### v0.15
| ¿Qué hay de nuevo? | ¿Por qué es útil? |
| ----------- | ----------------- |
| Preajuste de escape del entorno de evaluación y semilla de escenario | - Ensayar un incidente específico: una nueva plantilla de amenaza interna por IA ensaya a un agente de evaluación que alcanza sistemas reales desde un entorno que se supone aislado, lo que obliga a la contención, la rotación de credenciales, la notificación a terceros y la preservación de evidencias. Cubre las revelaciones de julio de 2026 sobre agentes de evaluación que escaparon de sus sandboxes, donde el límite de aislamiento se *suponía* en lugar de aplicarse.<br><br>- Las plantillas ahora llegan al prompt: las plantillas de inicio rápido antes solo rellenaban previamente los widgets de la página y nunca influían en el escenario generado. Ahora incluyen un `brief` narrativo y las `required_decisions` que las preguntas de debate deben forzar, ambos integrados en el prompt, de modo que una plantilla produce un tabletop cronometrado utilizable en lugar de un conjunto desordenado de preguntas. Esto las divide en dos clases: las seis plantillas **arquetipo** originales solo establecen decisiones, por lo que el modelo inventa la premisa y volver a ejecutar una genera un ejercicio nuevo para el mismo perfil de amenaza; las plantillas de **incidente** también establecen un brief, fijando la situación.<br><br>- Semilla de escenario de texto libre: un cuadro de semilla opcional en la página de amenaza interna por IA orienta la narrativa en cualquier escenario. Seleccionar una plantilla lo rellena previamente, y puedes editarlo o escribir el tuyo desde cero.<br><br>- Taxonomía ampliada a 27 amenazas / 6 categorías: añade una sexta categoría de amenaza (**Contención e impacto en terceros**) y cuatro amenazas STRIDE sobre las que gira el ejercicio: `S5` reproducción de credenciales de carga de trabajo reutilizables, `R4` supresión de telemetría del lado del agente, `I5` compromiso de terceros y aguas abajo, y `E5` fallo de aseguramiento del límite de contención. AttackGen ahora *amplía* el modelo de amenazas publicado en lugar de reflejarlo.<br><br>- Plantillas utilizables a través de MCP: `get_ai_insider_prompt` y `generate_ai_insider_scenario` aceptan `template=` y `scenario_seed=`, y `list_ai_insider_options` devuelve cada plantilla con las selecciones y el brief que aplica, de modo que un cliente puede elegir un preajuste por sus méritos y llamar solo con una plantilla, un sector y un tamaño de empresa. Antes se listaban los nombres de las plantillas, pero ninguna herramienta aceptaba una. |
| Habilidad attackgen-tabletop: ruta de amenaza interna por IA | - Una segunda ruta de ejercicio: la [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) ahora construye un tabletop a partir del modelo de amenaza interna por IA, así como a partir de una kill chain de MITRE. Elige una plantilla de inicio rápido (o un arquetipo de despliegue y categorías de amenaza) y convierte la carga útil de `get_ai_insider_prompt` en un MSEL.<br><br>- Misma forma, distinta columna vertebral: el ejercicio mantiene las mismas seis secciones, pero la tabla de kill chain se convierte en un perfil de agente y un alcance de amenazas STRIDE, la tarjeta de puntuación de detección se evalúa contra la postura de detección del arquetipo de despliegue —de modo que las filas que *no* se activarían se convierten en el hallazgo— y las decisiones requeridas de la plantilla se convierten en preguntas de debate obligatorias.<br><br>- Ruta elegida por ti: la descripción de la habilidad ahora se activa con frases sobre agentes descontrolados, de modo que pedir un "tabletop de amenaza interna por IA" llega a la ruta correcta. Un actor externo con tácticas aceleradas por IA permanece en la ruta de MITRE.<br><br>- Respuesta, no explotación: ambas rutas están explícitamente acotadas a ensayar las decisiones que debe tomar un equipo de respuesta —sin código de explotación, cargas útiles ni vulnerabilidades reales sin parchear— y la ruta de IA atribuye el comportamiento del agente a la configuración, el acceso y el objetivo en lugar de al motivo humano. |
| Corrección: Los prompts de MCP AI-Insider omitían las capacidades del agente | - Misma plantilla, mismo prompt: El bloque de capacidades del agente de frontera —las líneas basadas en benchmarks que hacen creíble un escenario de AI insider— se omitía en cada llamada a `get_ai_insider_prompt` / `generate_ai_insider_scenario` que no nombrara `capabilities` explícitamente. Ninguna plantilla las proporciona, por lo que el argumento quedaba vacío y el prompt sustituía una línea genérica "assume a capable frontier coding agent", mientras que la página 3 enviaba las cuatro para la misma plantilla.<br><br>- Los valores predeterminados ahora coinciden con la aplicación: Omitir `capabilities` aplica el conjunto completo, como hace el multiselect de la página. Pasar `[]` sigue dejándolas sin especificar, por lo que la exclusión deliberada no cambia. |
| Corrección: Generación de escenarios de Anthropic Claude 4.7+ | - Todos los modelos Claude vuelven a funcionar: Claude 4.7 y posteriores rechazan cualquier `temperature` de muestreo, devolviendo `BadRequestError: 'temperature' is deprecated for this model`. Cuatro de los cinco modelos de Anthropic listados —Fable 5, Opus 4.8, Sonnet 5 y Opus 4.7— no podían generar un escenario en ninguna página; solo Haiku 4.5 funcionaba.<br><br>- Condicionado por modelo, no por proveedor: La regla de temperature se enrutaba anteriormente desde el proveedor, lo que no puede expresar un proveedor cuyos modelos no coinciden. `ModelInfo.supports_temperature` ahora marca los modelos que rechazan una, de modo que Haiku 4.5 conserva su temperature configurada mientras sus hermanos la omiten. OpenAI sigue siendo una regla a nivel de proveedor (todos los modelos de chat actuales son modelos de razonamiento), y los modelos no registrados —endpoints locales de Ollama / LM Studio— siguen recibiendo una temperature. |
### v0.14
| ¿Qué hay de nuevo? | ¿Por qué es útil? |
| ----------- | ----------------- |
| Servidor MCP para clientes agénticos | - Generación de escenarios como herramientas: un nuevo servidor FastMCP (`mcp_server.py`, SDK oficial `mcp`) expone AttackGen a clientes agénticos mediante stdio, de modo que un asistente como Claude Code o Claude Desktop puede obtener datos de MITRE y generar escenarios sin la interfaz de Streamlit.<br><br>- Dos niveles: las **herramientas de datos** (`list_threat_groups`, `list_case_studies`, `get_kill_chain`, `get_detection_report`, `get_navigator_layer`, `list_ai_insider_options`, `get_ai_insider_prompt`) no realizan ninguna llamada al LLM ni necesitan clave de API: devuelven datos estructurados de MITRE y, cuando resulta útil, un prompt listo para ejecutar, por lo que es seguro alojarlas por HTTP. Las **herramientas de generación** (`generate_threat_group_scenario`, `generate_custom_scenario`, `generate_ai_insider_scenario`) toman una configuración de tipo bring-your-own-key y devuelven Markdown terminado; mantén estas en stdio local.<br><br>- Implementación compartida: el servidor reutiliza los mismos constructores headless de `core/prompts.py` y los cargadores de `core/attack_data.py` que usan las páginas de Streamlit, de modo que los escenarios coinciden con la aplicación en lugar de divergir. Inícialo con `python -m mcp_server` o con el script de consola `attackgen-mcp`. |
| Habilidad de agente attackgen-tabletop | - Tabletops listos para el facilitador: una nueva [Habilidad de agente](https://github.com/mrwadams/attackgen/blob/main/skills) se basa en las herramientas de datos MCP para convertir un grupo de amenazas o un caso de estudio de MITRE ATT&CK/ATLAS en un tabletop de respuesta a incidentes (IR) / MSEL completo: narrativa del escenario, kill chain mapeada por fases, inyecciones con marca temporal, preguntas de debate de NIST SP 800-61 y una tarjeta de puntuación de cobertura de detección.<br><br>- Se ejecuta con el modelo del llamador: la habilidad aporta la elaboración del ejercicio mientras que el servidor MCP aporta los datos, por lo que se ejecuta con el propio modelo del cliente sin necesidad de una clave de API adicional.<br><br>- Dos formatos de salida: se entrega como Markdown (predeterminado) o como un informe HTML autocontenido y apto para impresión. |
| El asistente refina la salida de detección y respuesta | - Edición de equipo púrpura: el asistente de AttackGen ahora puede refinar la narrativa de **Detección y respuesta**, no solo el escenario. Cuando se genera un escenario con el conmutador de narrativa de equipo púrpura 🟣 (páginas Threat Group / Custom), aparece un selector **Editing:** en la página del asistente para que el chat pueda dirigirse al escenario o al recorrido del defensor; anteriormente el asistente solo disponía del texto del escenario.<br><br>- Modo de edición combinado: un tercer objetivo **Scenario + Detection & Response** refina ambos a la vez, de modo que un cambio transversal —un sector, actor de amenazas, técnica o cronología distintos— se aplica de forma coherente tanto en el escenario del atacante como en la narrativa del defensor, en lugar de hacerse dos veces y divergir.<br><br>- Hechos deterministas intactos: solo la narrativa del LLM es objeto de refinamiento; la unión local de detecciones STIX nunca se edita mediante LLM. Cada modo de edición mantiene su propio historial de chat, y la pasada combinada se etiqueta como `purple_team_narrative` en LangSmith. |
| Registro de modelos más simple | - Una cosa menos por modelo: el kwarg `max_completion_tokens` y la regla de temperatura para modelos de razonamiento ahora se enrutan desde el **proveedor** en lugar de un flag por modelo `uses_max_completion_tokens`; todos los modelos de chat actuales de OpenAI los usan, por lo que el flag duplicaba un hecho que la clave del proveedor ya capturaba. Añadir un nuevo modelo de OpenAI sigue siendo una edición de una sola entrada en `MODELS`, sin ningún flag adicional que recordar.<br><br>- Sin cambios de comportamiento: es solo una simplificación interna; el wrapper construye kwargs de LiteLLM idénticos para todos los modelos actuales. |
### v0.13.1
| ¿Qué hay de nuevo? | ¿Por qué es útil? |
| ----------- | ----------------- |
| Corrección: generación de escenarios con OpenAI GPT-5.x | - Manejo correcto de modelos de razonamiento: los modelos de razonamiento GPT-5.x de OpenAI rechazan cualquier `temperature` de muestreo distinta de su valor predeterminado, por lo que todas las generaciones con GPT-5.x fallaban con `BadRequestError: 'temperature' does not support 0.7 with this model`. AttackGen ya no envía una temperatura personalizada a estos modelos, mientras que otros proveedores conservan el valor configurado. |
| Actualización del registro de modelos | - Modelos más recientes: se actualizó la lista de modelos según la documentación actual de cada proveedor — **OpenAI GPT-5.6** (niveles Sol / Terra / Luna), **Claude Fable 5** y **Claude Sonnet 5**, conservando una generación anterior por proveedor para mantener la continuidad.<br><br>- Eliminación de entradas obsoletas: se descartaron los modelos que los proveedores han reemplazado o están retirando — en particular `qwen3-32b` de Groq (descontinuado el 17 de julio de 2026) y Magistral Medium de Mistral — para que la barra lateral no pueda ofrecer un modelo que genere errores al seleccionarlo.<br><br>- Se añadió un nivel rápido/económico de Groq (`llama-3.1-8b-instant`). |
### v0.13
| ¿Qué hay de nuevo? | ¿Por qué es útil? |
| ----------- | ----------------- |
| Modo Purple-Team: Detección y Respuesta | - Compañero defensivo: Cada grupo de amenazas y escenario personalizado ahora muestra una sección de **Detección y Respuesta** que vincula cada una de las técnicas del escenario con las estrategias de detección, analíticas, fuentes de logs y mitigaciones de MITRE ATT&CK ya presentes en los datos incluidos — convirtiendo una narrativa puramente ofensiva en un ejercicio de purple-team ("aquí está el ataque, y aquí está exactamente lo que tu SOC debería haber visto").<br><br>- Sin llamada al LLM para los hechos: La sección de detección es una **unión de datos local**, no una llamada al modelo — por lo que las analíticas, fuentes de logs y mitigaciones que enumera son el contenido real y actual de MITRE en lugar de conjeturas del modelo. Se ofrece como su propia descarga `..._detection.md` junto al escenario y la capa.<br><br>- Fuentes de logs a habilitar: Un resumen por escenario enumera las distintas fuentes de logs que leen las detecciones (p. ej. `WinEventLog:Security (EventCode=4624)`), para que un SOC pueda ver de un vistazo qué telemetría asume el ejercicio.<br><br>- Narrativa purple-team opcional: Un conmutador por página **🟣 Narrativa purple-team** añade una segunda pasada del modelo que recorre el escenario etapa por etapa desde el lado del defensor — qué debería dispararse, qué ve el analista, cómo responder — fundamentado estrictamente en las detecciones y mitigaciones anteriores (sin detecciones inventadas).<br><br>- Compatible con ATLAS: Los escenarios de ATLAS enumeran mitigaciones (ATLAS aún no tiene estrategias de detección) y lo indican, en lugar de no mostrar nada. |
| MITRE ATT&CK v19.1 y datos más recientes de ATLAS | - Frameworks actualizados: Los datos de MITRE ATT&CK Enterprise e ICS se actualizaron de v18.1 a **v19.1**, y MITRE ATLAS se actualizó a la última versión, de modo que los escenarios generados reflejan las tácticas, técnicas y casos de estudio actuales.<br><br>- Listas de grupos actualizadas: Los desplegables de grupos de amenazas se regeneran a partir de los paquetes de v19.1 (174 grupos activos de Enterprise y 14 de ICS). Los grupos que MITRE ha revocado o fusionado en origen (p. ej. APT34 → OilRig, UNC2452 → APT29) ya no aparecen, mientras que sí lo hacen grupos recién rastreados como MirrorFace.<br><br>- Más casos de estudio de ATLAS: La biblioteca de casos de estudio de ATLAS creció hasta 57 (17 incidentes, 40 ejercicios).<br><br>- Actualización repetible: Un nuevo `scripts/generate_groups.py` regenera las asignaciones de grupos a partir de los paquetes STIX incluidos, complementando el script existente de casos de estudio de ATLAS — de modo que la próxima actualización es un paso automatizado en lugar de una curación manual. |
---
[Read more](https://github.com/mrwadams/attackgen)

