 markoglasgow/gemma_crackme_tutorial
Tutorial paso a paso sobre el uso del modelo de IA local Gemma 4 E4B de Google para realizar ingeniería inversa de un crackme de Windows con Ghidra, incluyendo la configuración para inferencia local y el renombrado automático de funciones/variables.

Estaba jugando con el nuevo modelo local de pesos abiertos Gemma E4B que Google lanzó, y para mi sorpresa estaba viendo un gran éxito al usarlo para escenarios locales de ingeniería inversa sin conexión. Quería escribir este tutorial para difundir que la IA local ahora es lo suficientemente buena para muchas tareas básicas de reversa, y que las cosas probablemente mejorarán rápidamente de aquí en adelante.
Una de las partes más tediosas de hacer reversa a un nuevo binario es al principio, cuando no tienes información sobre cuáles son las funciones y variables importantes. Hay muchos trucos que los reversers usan para empezar, incluyendo mirar referencias a cadenas, diferencia de binarios, o emparejar funciones similares.
La IA es muy buena ayudando aquí, y personalmente he tenido gran éxito usando la API de OpenAI para marcar un binario o limpiar la salida del descompilador. Sin embargo, hay varias desventajas al usar estas APIs:
Costo: La descompilación y el desensamblado generan toneladas de tokens. Las APIs cobran $ por token, por lo que los binarios más grandes pueden requerir bastantes $$$ para analizar. Si estás lidiando con un objetivo grande con muchos binarios que se actualizan cada semana, estos costos pueden acumularse rápidamente y son prohibitivos para los ingenieros inversos aficionados.
Privacidad: Cuando usas una API remota, el anfitrión de la IA tiene visibilidad de lo que estás haciendo. Esto es un factor excluyente en algunos escenarios profesionales.
Control: Cuando dependes de una API remota, no tienes control sobre qué modelos se te están sirviendo, ni sobre cuál es la calidad de los modelos. Si dependes de ellos para cosas críticas, esto puede ser un problema cuando se vuelven lentos o se caen cuando los necesitas, o cuando la calidad de su salida se degrada hasta el punto de ser inútiles.
Ejecutar tus propios modelos de IA locales soluciona algunos de estos puntos problemáticos:
Costo: Puede ser mucho más barato ejecutar un modelo local que depender de un servicio alojado. Si bien tu modelo local probablemente sea más pequeño y lento que el de un buen proveedor, si es lo suficientemente bueno y se ejecuta en un tiempo razonable, puede tener sentido ahorrar dinero ejecutando tu propio modelo, especialmente si estás procesando grandes cantidades de datos para tareas simples.
Privacidad: Cuando ejecutas el modelo localmente, no se realizan llamadas de red y tienes control completo sobre tu privacidad. Nadie puede ver para qué estás usando el modelo en tu propia máquina.
Control: La belleza de un modelo de pesos abiertos es que nadie puede quitártelo. OpenAI o Anthropic podrían algún día hacer que sus modelos SotA no estén disponibles, ya sea mediante aumentos de precio o eliminando explícitamente sus APIs. Pero con un modelo de pesos abiertos, tienes el control de tu destino, para bien o para mal.
Sin embargo, los modelos de IA locales tienen sus desventajas:
Tamaño: Cuanto más grande es tu modelo, más inteligente es. Sin embargo, la mayoría de los modelos grandes no caben en hardware de consumo. Debido a eso, si ejecutas un modelo local, lo más probable es que estés ejecutando un modelo 10x-100x más pequeño que un modelo SotA (State-of-the-Art, estado del arte). Esta disminución en tamaño conduce directamente a una disminución en la inteligencia del modelo, haciéndolos inadecuados para muchas tareas que la gente da por sentadas en modelos SotA como ChatGPT/Codex o Claude.
Velocidad: Los modelos locales probablemente se ejecutarán más lentamente en tu máquina que cuando se usa una API de IA. Nuevamente, esto se debe a las limitaciones del hardware de consumo y a algunos de los trucos que los proveedores de API pueden hacer y que generalmente no están disponibles para ti.
Configuración: Ejecutar modelos locales es como intentar ejecutar Linux en una laptop reacondicionada versus entrar a la Apple Store y comprar una Macbook Air nueva. La experiencia de Codex y Claude Code es la experiencia Apple Store de la IA. La experiencia del modelo de IA local es el tipo con un fedora en su garaje golpeando una computadora endeble tratando de hacerla funcionar. Como mínimo, tienes que preocuparte por las siguientes cosas:
No es un viaje fácil, y mucha gente se rinde y asume que los modelos de IA locales no están a la altura de la tarea, porque nunca encontraron la combinación correcta de hardware/modelo/configuración/indicaciones/arnés para hacerlos funcionar para su tarea. Si bien en muchos casos tienen razón, espero que este tutorial al menos arroje luz sobre lo lejos que han llegado los modelos locales, cómo pueden ayudar con la ingeniería inversa, e inspire a las personas a darle una oportunidad a la IA local.
(la contraseña del archivo es crackmes.one). He alojado un enlace alternativo aquí en el repositorio por si el enlace original deja de funcionar.
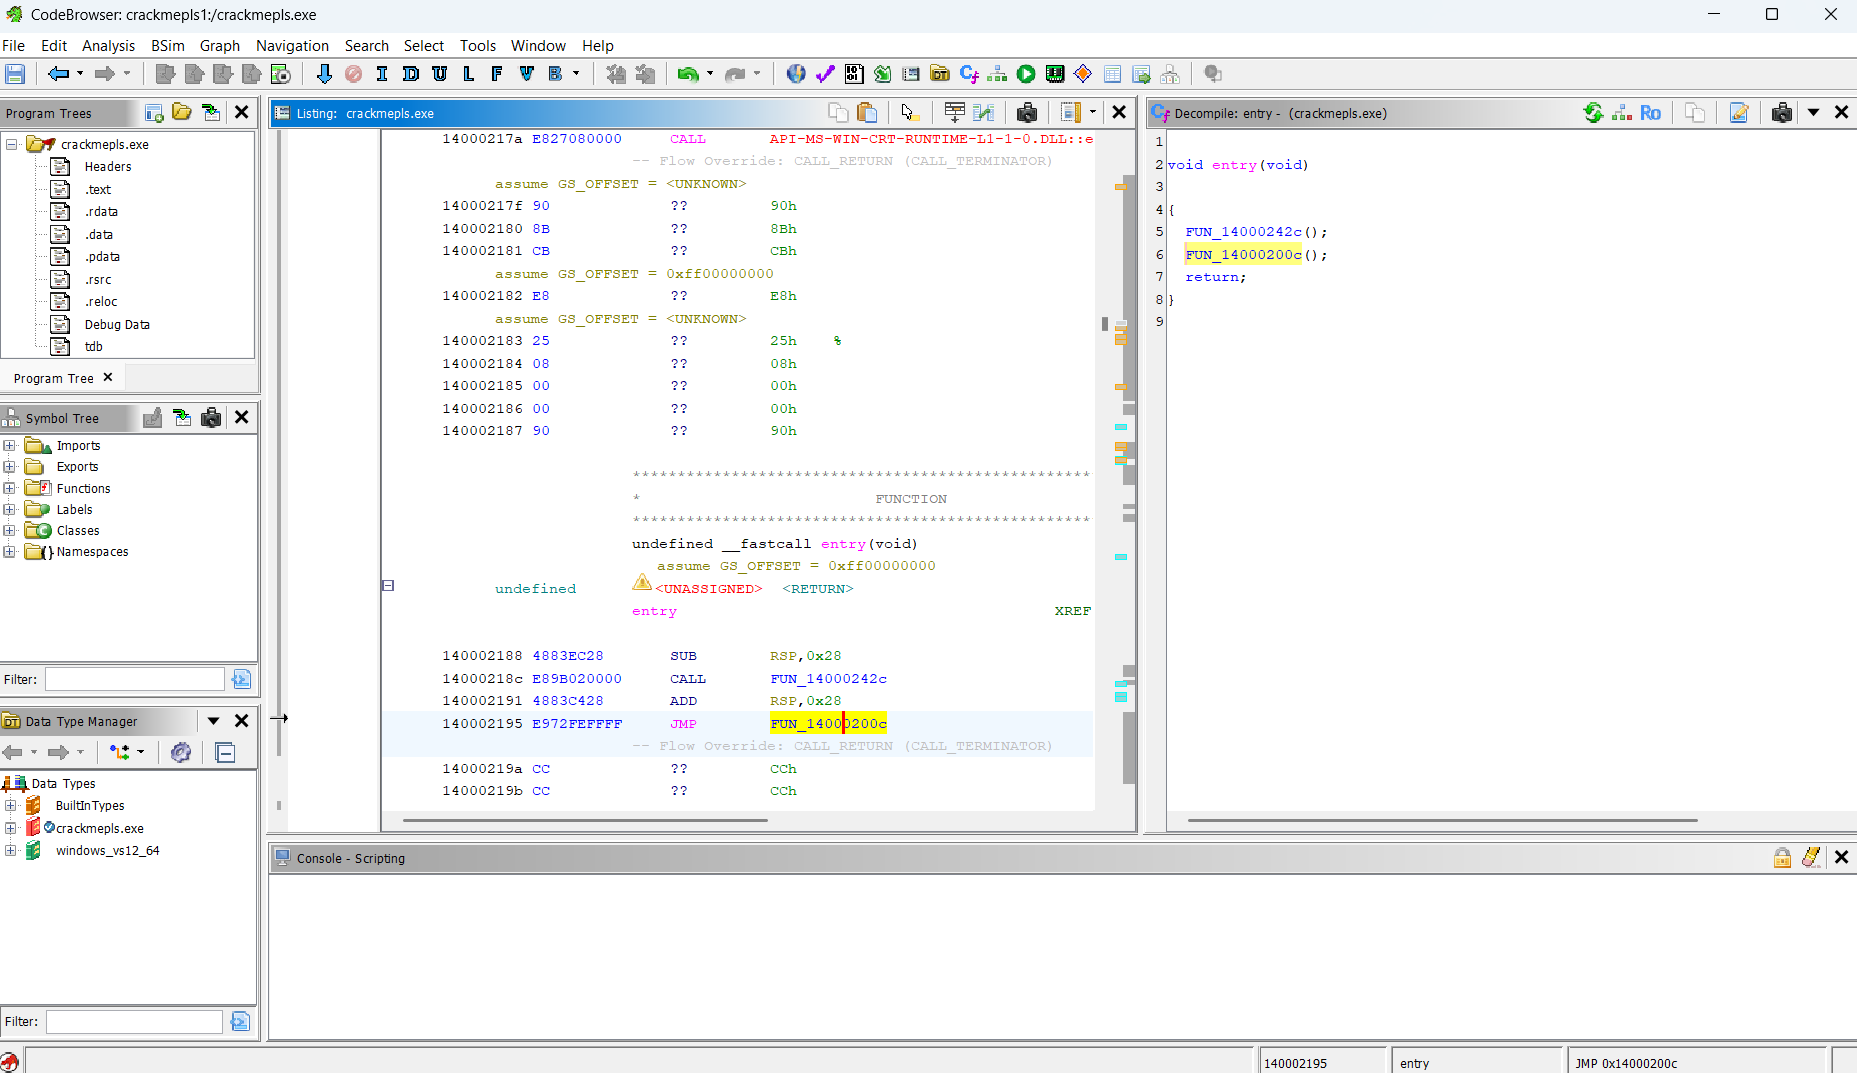
Ghidra 12.04 se utiliza para desensamblado y descompilación. Necesitarás instalar OpenJDK 21 para usarlo: https://github.com/nationalsecurityagency/ghidra
Mientras trabajaba en este tutorial, hice vibe-coding con Claude Code de un plugin de Ghidra para renombrar funciones y variables con IA. Puedes descargar el plugin desde aquí: https://github.com/markoglasgow/Ghidra_FastAIRenamer_Plugin
Para instalarlo, simplemente mueve el archivo zip ghidra_12.0.4_PUBLIC_20260427_FastAIRenamerPlugin.zip a ${GHIDRA_HOME}\Extensions\Ghidra, luego ejecuta Ghidra ejecutando ${GHIDRA_HOME}\ghidraRun.bat. Para activar el plugin, en la pantalla inicial de Ghidra en el menú superior selecciona File -> Install Extensions, luego en el navegador de plugins marca la casilla junto a FastAIRenamerPlugin, luego haz clic en Ok. Ghidra te pedirá que reinicies, hazlo de inmediato.
