 hpthreatresearch/subcrawl
Marco modular para el descubrimiento y análisis de directorios abiertos en la web. Rastrea URLs, extrae contenido, aplica escaneo con YARA/ClamAV y envía los resultados a MISP, SQLite o la consola para inteligencia de amenazas.

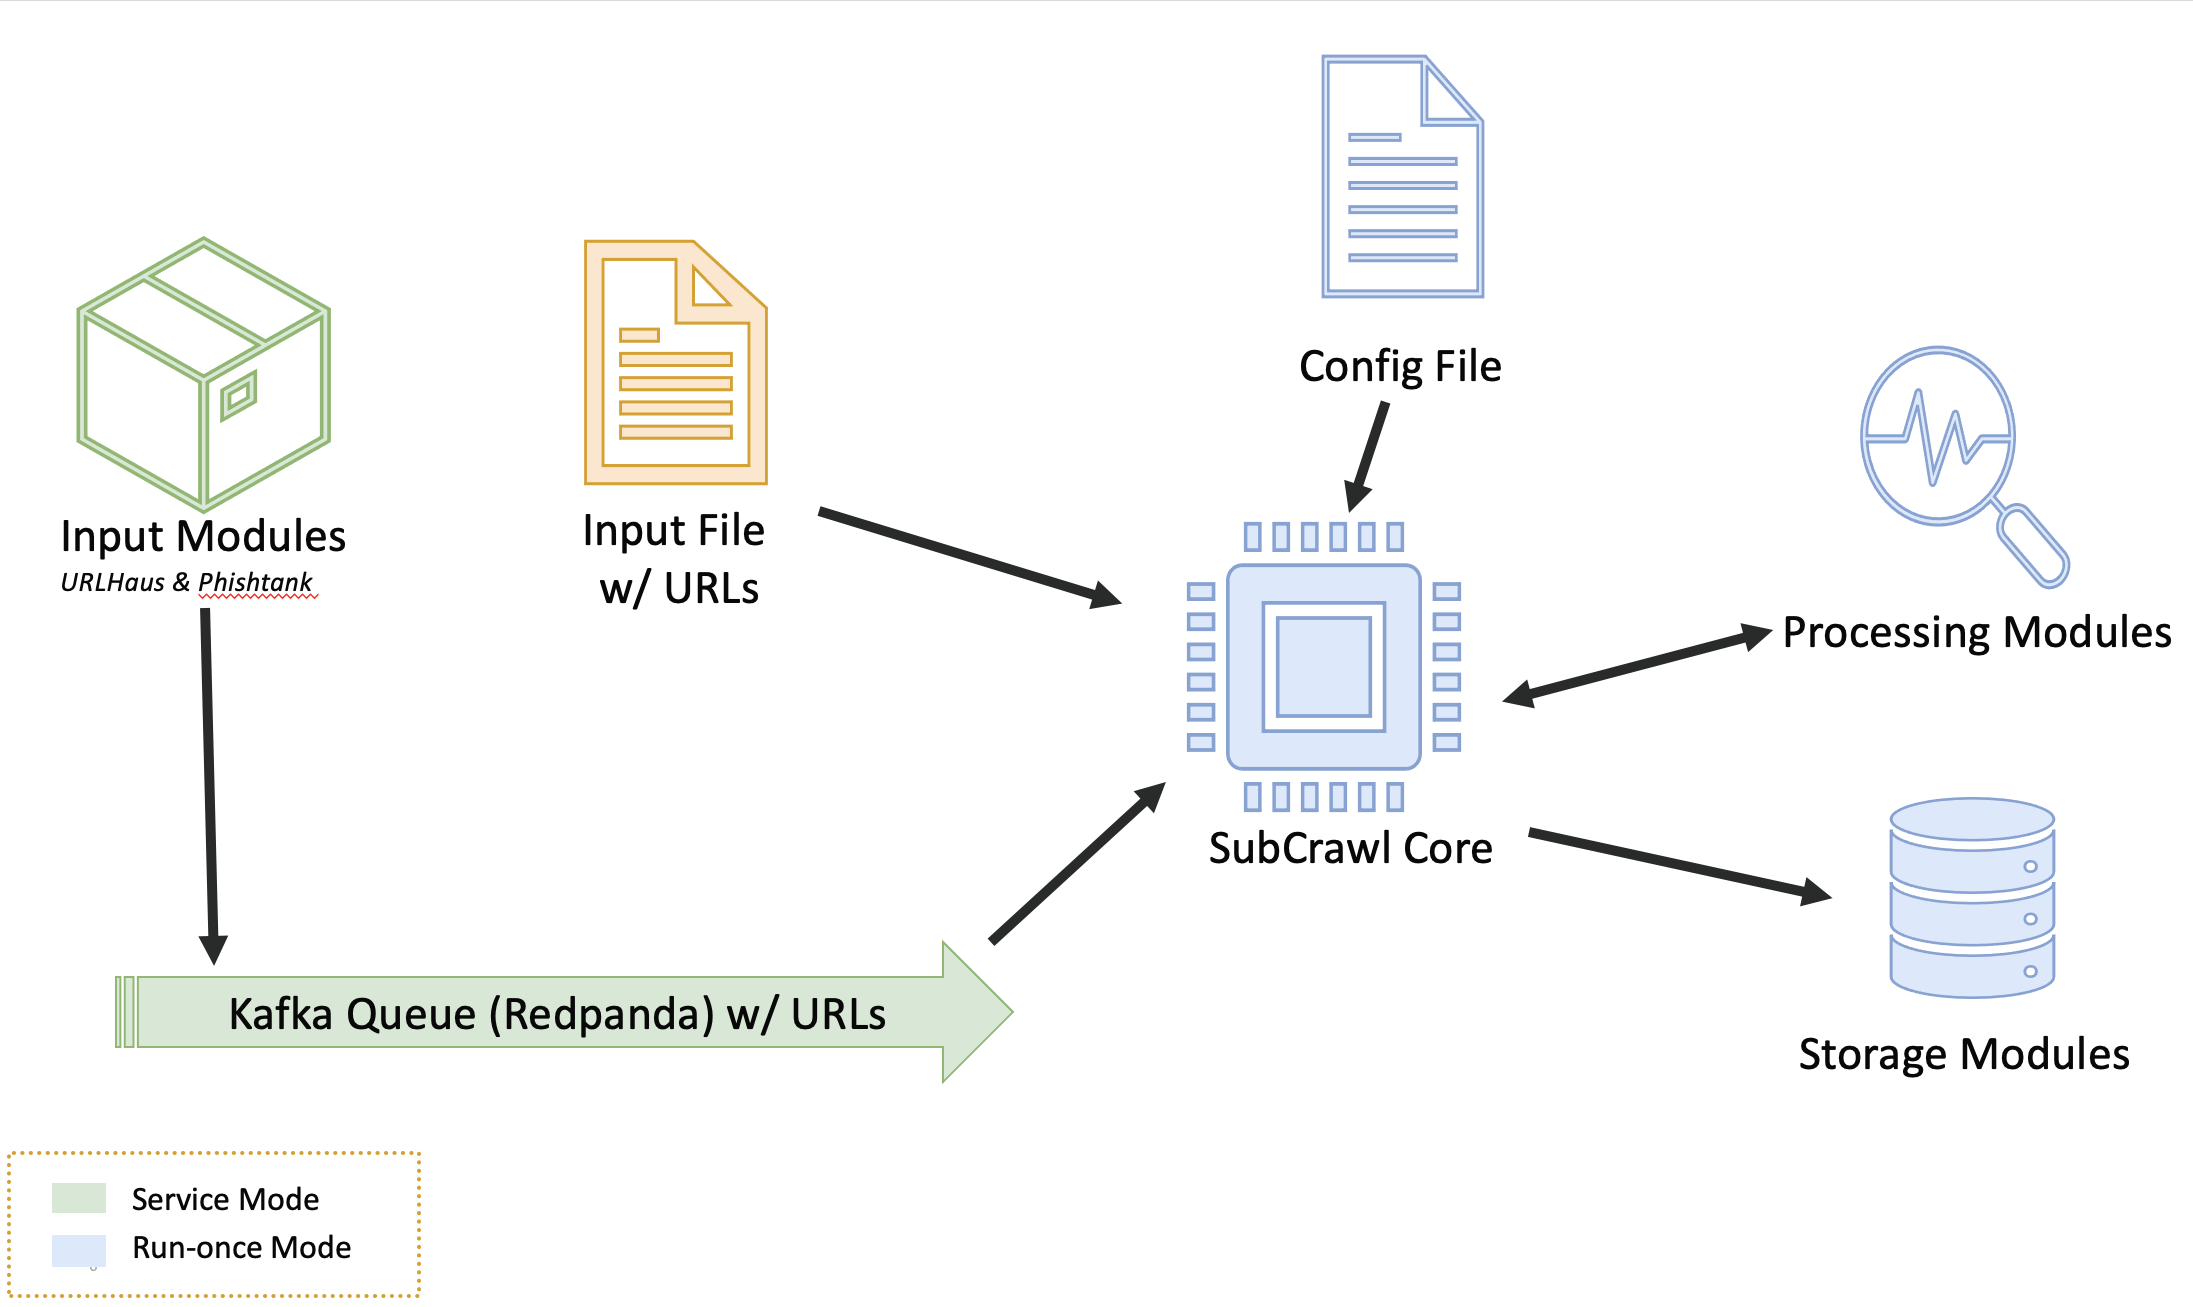
SubCrawl es un framework desarrollado por Patrick Schläpfer, Josh Stroschein y Alex Holland del equipo de Threat Research de HP Inc. SubCrawl está diseñado para encontrar, escanear y analizar directorios abiertos. El framework es modular, compuesto por cuatro componentes: módulos de entrada, módulos de procesamiento, módulos de salida y el motor de rastreo principal. Las URL son los valores de entrada primarios, que el framework analiza y añade a un sistema de colas antes de rastrearlas. El análisis de las URL es un primer paso importante, ya que toma una URL enviada y genera URLs adicionales para rastrear eliminando subdirectorios, uno a la vez, hasta que no quede ninguno. Este proceso garantiza un intento de escaneo más completo de un servidor web y puede llevar al descubrimiento de contenido adicional. Cabe destacar que SubCrawl no utiliza un método de fuerza bruta para descubrir URLs. Todo el contenido escaneado proviene de las URLs de entrada, el proceso de análisis de la URL y el descubrimiento durante el rastreo. Cuando se descubre un directorio abierto, el motor de rastreo extrae enlaces del directorio para su evaluación. El motor de rastreo determina si el enlace es otro directorio o un archivo. Los directorios se añaden a la cola de rastreo, mientras que los archivos son sometidos a un análisis adicional por los módulos de procesamiento. Se generan y almacenan resultados para cada URL escaneada, como los hashes SHA256 y difusos del contenido, si se encontró un directorio abierto, o coincidencias con reglas YARA. Finalmente, los datos de resultado se procesan según uno o más módulos de salida, de los cuales actualmente hay tres. El primero proporciona integración con MISP, el segundo simplemente imprime los datos en la consola, y el tercero almacena los datos en una base de datos SQLite. Dado que el framework es modular, no solo es fácil configurar qué módulos de entrada, procesamiento y salida se desean, sino también desarrollar nuevos módulos de manera sencilla.
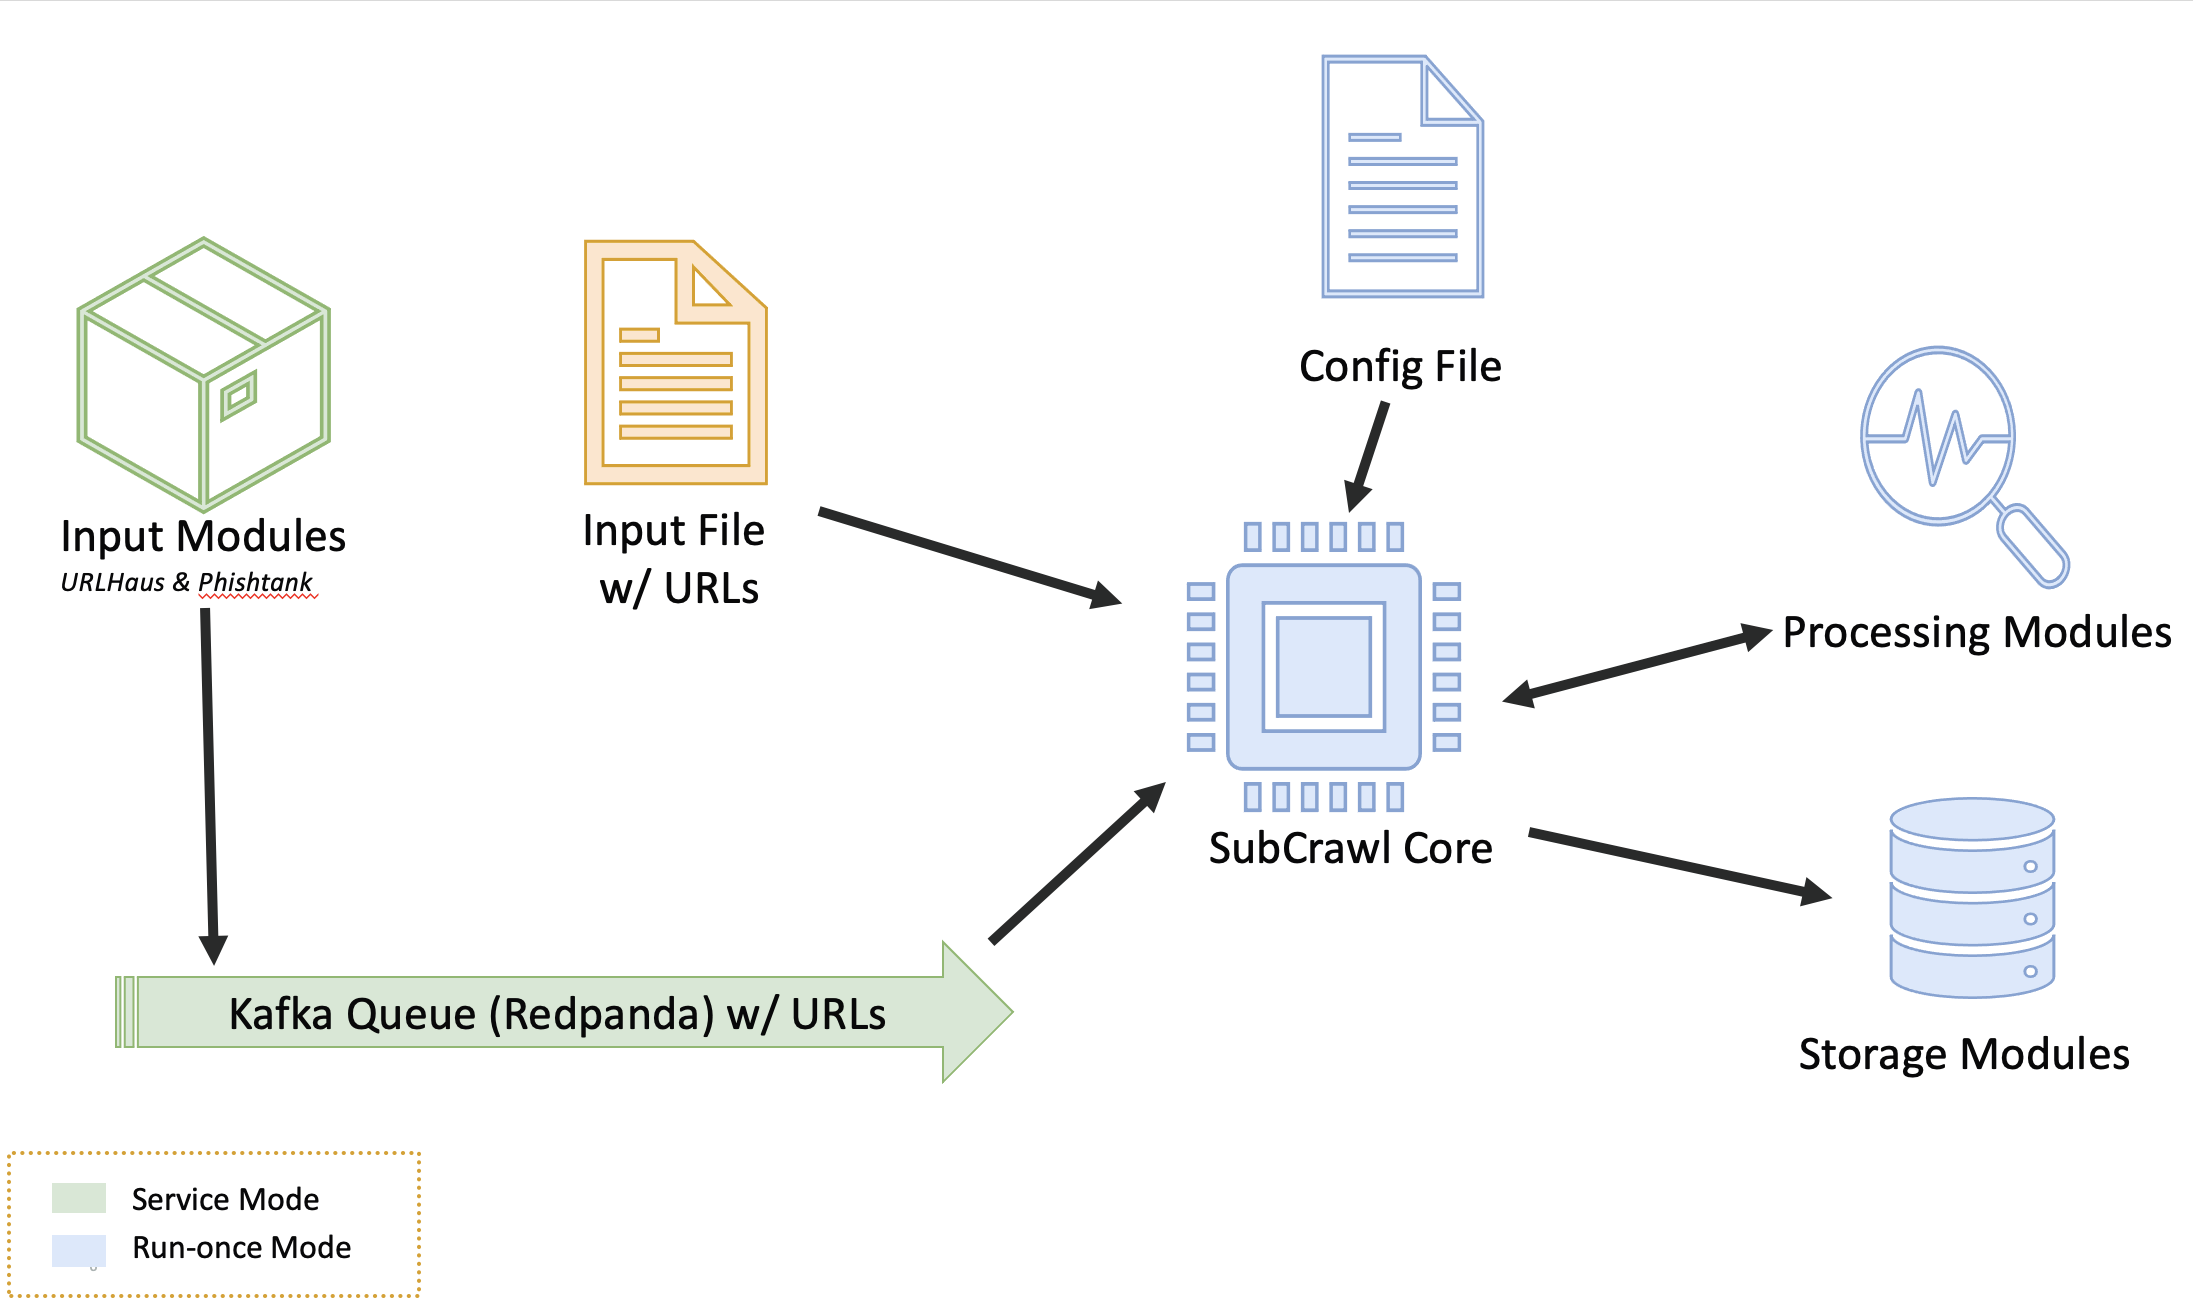 Figura 1 - Arquitectura de SubCrawl
SubCrawl admite dos modos de operación diferentes. Primero, SubCrawl puede iniciarse en modo de ejecución única. En este modo, el usuario proporciona las URLs a escanear en un archivo donde cada valor de entrada está separado por un salto de línea. El segundo modo de operación es el modo servicio. En este modo, SubCrawl se ejecuta en segundo plano y depende de los módulos de entrada para suministrar las URLs a escanear. La Figura 1 muestra una visión general de la arquitectura de SubCrawl. Los componentes que se utilizan en ambos modos de operación son azules, los componentes del modo de ejecución única son amarillos y los del modo servicio son verdes.
Según el modo de ejecución elegido, deben cumplirse otras condiciones previas.
SubCrawl está escrito en Python3. Además, hay varios paquetes necesarios antes de ejecutar SubCrawl. El siguiente comando puede usarse para instalar todos los paquetes requeridos antes de ejecutar SubCrawl. Desde el directorio crawler, ejecute el siguiente comando:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
Si SubCrawl se inicia en modo servicio, esto se puede hacer mediante Docker. Por esta razón, se requiere la instalación de Docker y Docker Compose. Se pueden encontrar buenas instrucciones de instalación directamente en el sitio web de Docker.com.
SubCrawl tiene ayuda incorporada a través del argumento -h/--help o simplemente ejecutando el script sin ningún argumento.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Cosechando la Web Abierta ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
Este modo es adecuado si desea escanear rápidamente una cantidad manejable de dominios. Para ello, las URLs a escanear deben guardarse en un archivo, que luego sirve como entrada para el rastreador. A continuación se muestra un ejemplo de ejecución en modo de ejecución única, notar que el argumento -f se usa con una ruta a un archivo.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
Con el modo servicio, se puede escanear una mayor cantidad de dominios y guardar los resultados. Según el módulo de almacenamiento seleccionado, los datos pueden analizarse y evaluarse con más detalle. Para que la ejecución del modo servicio sea lo más fácil posible para el usuario, incorporamos todas las funcionalidades en una imagen Docker. En modo servicio, los dominios a escanear se obtienen a través de módulos de entrada. De forma predeterminada, se descargan nuevas URL de malware y phishing desde URLhaus y PhishTank y se ponen en cola para su escaneo. Los módulos de procesamiento y almacenamiento deseados se pueden ingresar directamente en config.yml. Por defecto, los siguientes módulos de procesamiento están activados, utilizando el almacenamiento SQLite:
Además del módulo de almacenamiento SQLite, se desarrolló una interfaz web simple que permite ver y gestionar los dominios y URLs escaneados.
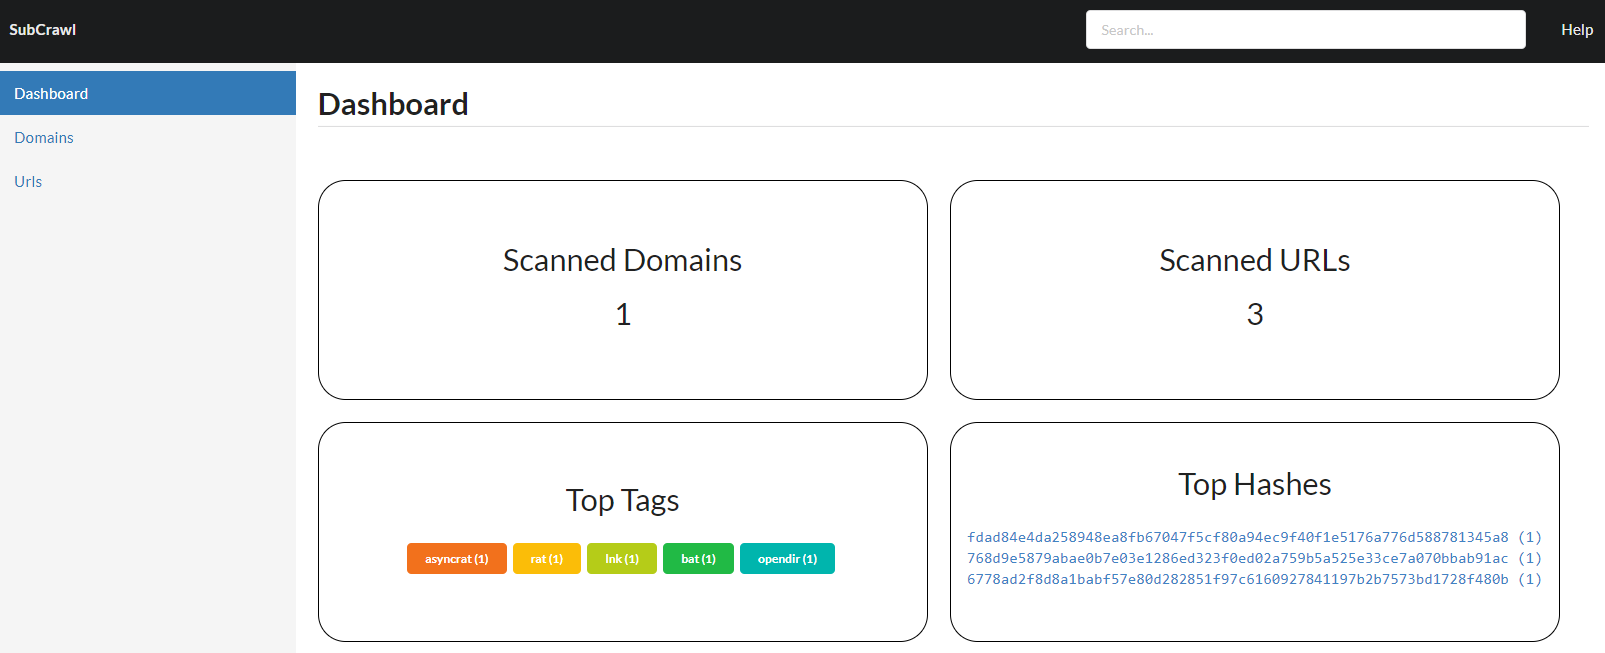
Sin embargo, si esta interfaz no es suficiente para la evaluación posterior de los datos, se puede activar el módulo de almacenamiento MISP de forma alternativa o adicional. La configuración correspondiente debe realizarse en config.yml en la sección MISP.
Los siguientes dos comandos son suficientes para clonar el repositorio GIT, crear el contenedor Docker e iniciarlo directamente. Luego, la interfaz web se puede alcanzar en la dirección https://localhost:8000/. Tenga en cuenta que una vez que los contenedores se hayan iniciado, los módulos de entrada comenzarán a agregar URLs a la cola de procesamiento y el motor comenzará a rastrear hosts.
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
