
 google/oss-fuzz-gen
Fuzzing impulsado por LLM a través de OSS-Fuzz.

Este marco de trabajo genera objetivos de fuzzing para proyectos reales de C/C++/Java/Python con
diversos Modelos de Lenguaje Grande (LLM) y los evalúa mediante la
plataforma OSS-Fuzz.
Más detalles disponibles en Fuzzing impulsado por IA: Rompiendo la barrera de la caza de errores:

Los modelos compatibles actualmente son:
Los objetivos de fuzzing generados se evalúan con cuatro métricas frente a los datos más actualizados del entorno de producción:
OSS-Fuzz.Aquí hay un ejemplo de resultado de experimento del 31 de enero de 2024. El experimento incluyó más de 1300 benchmarks de 297 proyectos de código abierto.
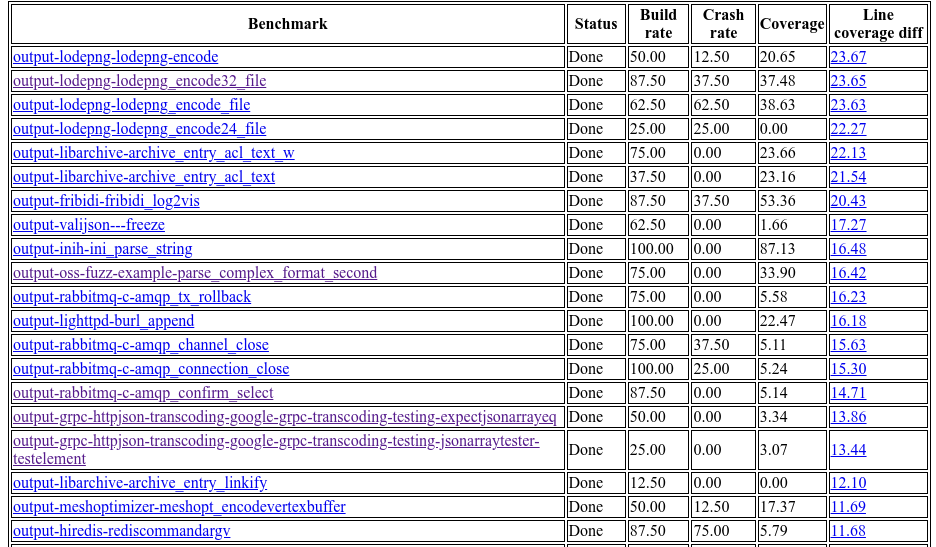
En general, este marco de trabajo logra aprovechar con éxito los LLM para generar objetivos de fuzzing válidos (que generan un aumento de cobertura distinto de cero) para 160 proyectos de C/C++. El aumento máximo de cobertura de líneas es del 29% respecto a los objetivos existentes escritos por humanos.
Tenga en cuenta que estos informes no son públicos, ya que pueden contener vulnerabilidades no divulgadas.
Consulte nuestra guía de uso detallada para obtener instrucciones sobre cómo ejecutar este marco de trabajo y generar informes basados en los resultados.
También puede ejecutar o evaluar agentes individuales sin ejecutar experimentos completos, utilizando el marco de ejecución de agentes integrado. Consulte la documentación del marco de trabajo para obtener instrucciones detalladas sobre cómo ejecutar agentes individuales o secuencias de agentes.
¿Está interesado en investigaciones o colaboraciones con la comunidad de código abierto? No dude en crear un issue o enviarnos un correo electrónico: [email protected].







