 comerc/cve-2025-68664
Divulgación detallada de CVE-2025-68664, una vulnerabilidad crítica de deserialización en el núcleo de LangChain que permite la exfiltración de secretos y potencial RCE a través de indicaciones manipuladas y flujos de serialización.

Autor: Yarden Porat
Investigación de Cyata: Vulnerabilidad LangGrinch en LangChain
Publicado: https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
Ayer, LangChain publicó una advertencia crítica sobre una vulnerabilidad que descubrí en langchain-core: CVE-2025-68664 / GHSA-c67j-w6g6-q2cm.
A principios de este año, mi investigación se centró en la explotación de administradores de secretos en nuestro trabajo "Vault Fault" – sistemas diseñados específicamente como un perímetro de seguridad alrededor de tus credenciales más sensibles. Una conclusión se repetía una y otra vez: cuando una plataforma procesa accidentalmente datos formados por un atacante como una estructura de confianza, ese perímetro se derrumba rápidamente. Esta vez, el sistema que se "rompe" no es tu administrador de secretos. Es el framework de agentes que podría usarlos.
¿Por qué esta vulnerabilidad merece especial atención?
Está en el núcleo. No es un error de una herramienta específica, ni un caso extremo de integración, ni "un paquete comunitario que hizo algo extraño". Las API vulnerables (dumps() / dumpd()) se encuentran en el propio langchain-core.
El radio de impacto es enorme. Por volumen de descargas, langchain es uno de los componentes de framework de IA más ampliamente desplegados en el mundo hoy. A finales de diciembre de 2025, la telemetría pública de paquetes muestra cientos de millones de instalaciones, con pepy.tech reportando ~847 millones de descargas totales y pypistats mostrando ~98 millones de descargas en el último mes.
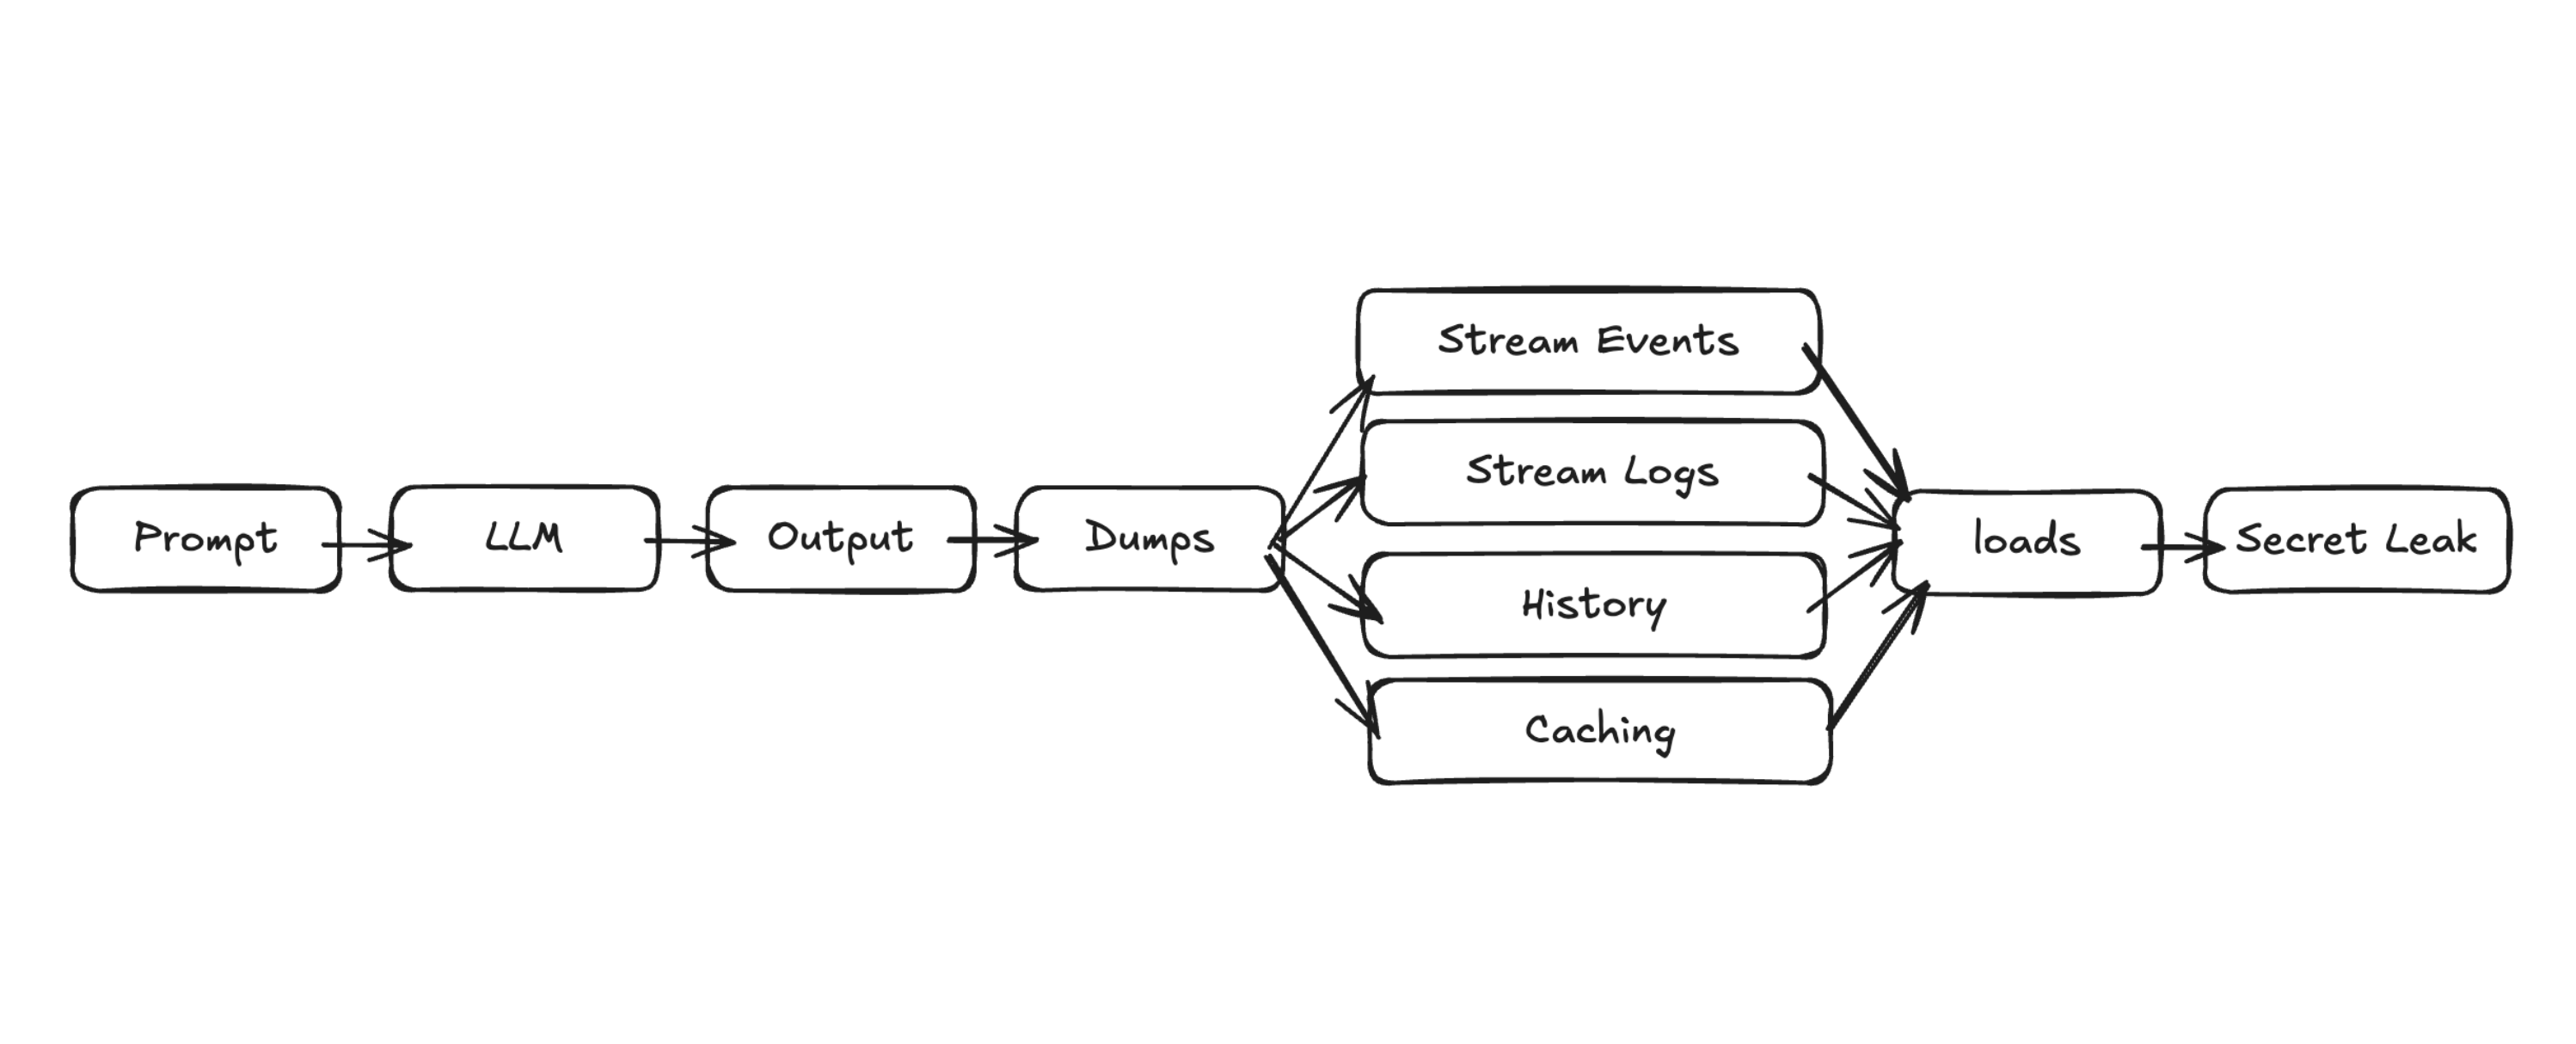
Un solo prompt puede desencadenar muchos mecanismos. El camino real más común aquí no es "el atacante te envía un blob serializado y tú llamas a load()". Es más sutil: las salidas de los LLM pueden influir en campos como additional_kwargs o response_metadata, y estos campos pueden ser serializados y luego deserializados a través de funciones normales del framework, como eventos/logs de streaming. En palabras simples, esto significa que un exploit puede ser lanzado con un solo prompt de texto, que en cascada llega a un pipeline interno inesperadamente complejo.
Antes de que sigas leyendo, los parches ya han sido publicados en las versiones 1.2.5 y 0.3.81. Si usas LangChain en producción, esto es más complicado de lo que parece; por favor, actualiza lo antes posible.
LangChain utiliza un formato de serialización interno especial, donde los diccionarios que contienen el marcador 'lc' representan objetos de LangChain. La vulnerabilidad consistía en que dumps() y dumpd() no escapaban correctamente los diccionarios controlados por el usuario que incluían accidentalmente la clave reservada 'lc'.
Por lo tanto, una vez que un atacante pueda forzar al ciclo de orquestación de LangChain a serializar y luego deserializar contenido que incluya la clave 'lc', podrá instanciar un objeto arbitrario inseguro, potencialmente desencadenando múltiples caminos favorables para el atacante.
La advertencia enumera 12 flujos vulnerables diferentes que son extremadamente comunes en casos de uso reales, como el streaming estándar de eventos, logging, historial de mensajes/memoria o caché:
Las consecuencias más devastadoras incluyen:
Extracción de secretos de variables de entorno. La advertencia señala que esto ocurre al deserializar con secrets_from_env=True. Notablemente, esto era el valor predeterminado hasta ayer. 🙂
Instanciación de objetos en espacios de nombres previamente aprobados (incluyendo langchain_core, langchain_openai, langchain_aws, langchain_anthropic…), potencialmente provocando efectos secundarios en los constructores (llamadas de red, operaciones con archivos, etc.).
Bajo ciertas condiciones, la instanciación de objetos LangChain puede conducir a la ejecución arbitraria de código.
Esto se clasifica bajo CWE-502: Deserialización de datos no confiables, con una puntuación CVSS CNA de 9.3 (Crítica).
En vísperas de Navidad, estaba haciendo el trabajo menos festivo: mirando el código de serialización y preguntándome "espera… ¿por qué esto se considera de confianza?"
La investigación de seguridad a menudo se ve dramática desde fuera. En realidad, suele ser lectura minuciosa, pequeñas hipótesis y una lenta acumulación de momentos de "esto es extraño".
Comenzó como muchas en Cyata: con una pregunta simple que hacemos constantemente al evaluar stacks de IA para riesgo real:
¿Dónde están los límites de confianza en las aplicaciones de IA, y realmente saben los desarrolladores dónde están esos límites?
LangChain es un framework potente, y como la mayoría de los frameworks modernos, necesita mover datos estructurados complejos: mensajes, llamadas a herramientas, eventos de streaming, trazas, cachés y "runnables".
Revisando investigaciones anteriores, ya había un extenso trabajo sobre herramientas e integraciones de LangChain, pero muy pocos hallazgos en la biblioteca principal.
Empecé la investigación trabajando hacia atrás. Encontrar lugares interesantes (sumideros), luego descubrir cómo un atacante podría alcanzarlos. La deserialización era un objetivo obvio.
Me llevó bastante tiempo encontrar algo significativo. Pero después de un tiempo, encontré que, asumiendo un primitivo de deserialización controlado por el atacante, podía lanzar un SSRF ciego que podría usarse para la exfiltración de variables de entorno (se detallará pronto). Como el resultado estaba limitado a la exfiltración de secretos y no a mi objetivo principal de RCE, seguí auditando la deserialización y me tomé mi tiempo.
El bug no era un trozo de código malo, era la ausencia de código. dumps() simplemente no escapaba los diccionarios controlados por el usuario que contenían claves 'lc'. Escape faltante en la ruta de serialización, no de deserialización.
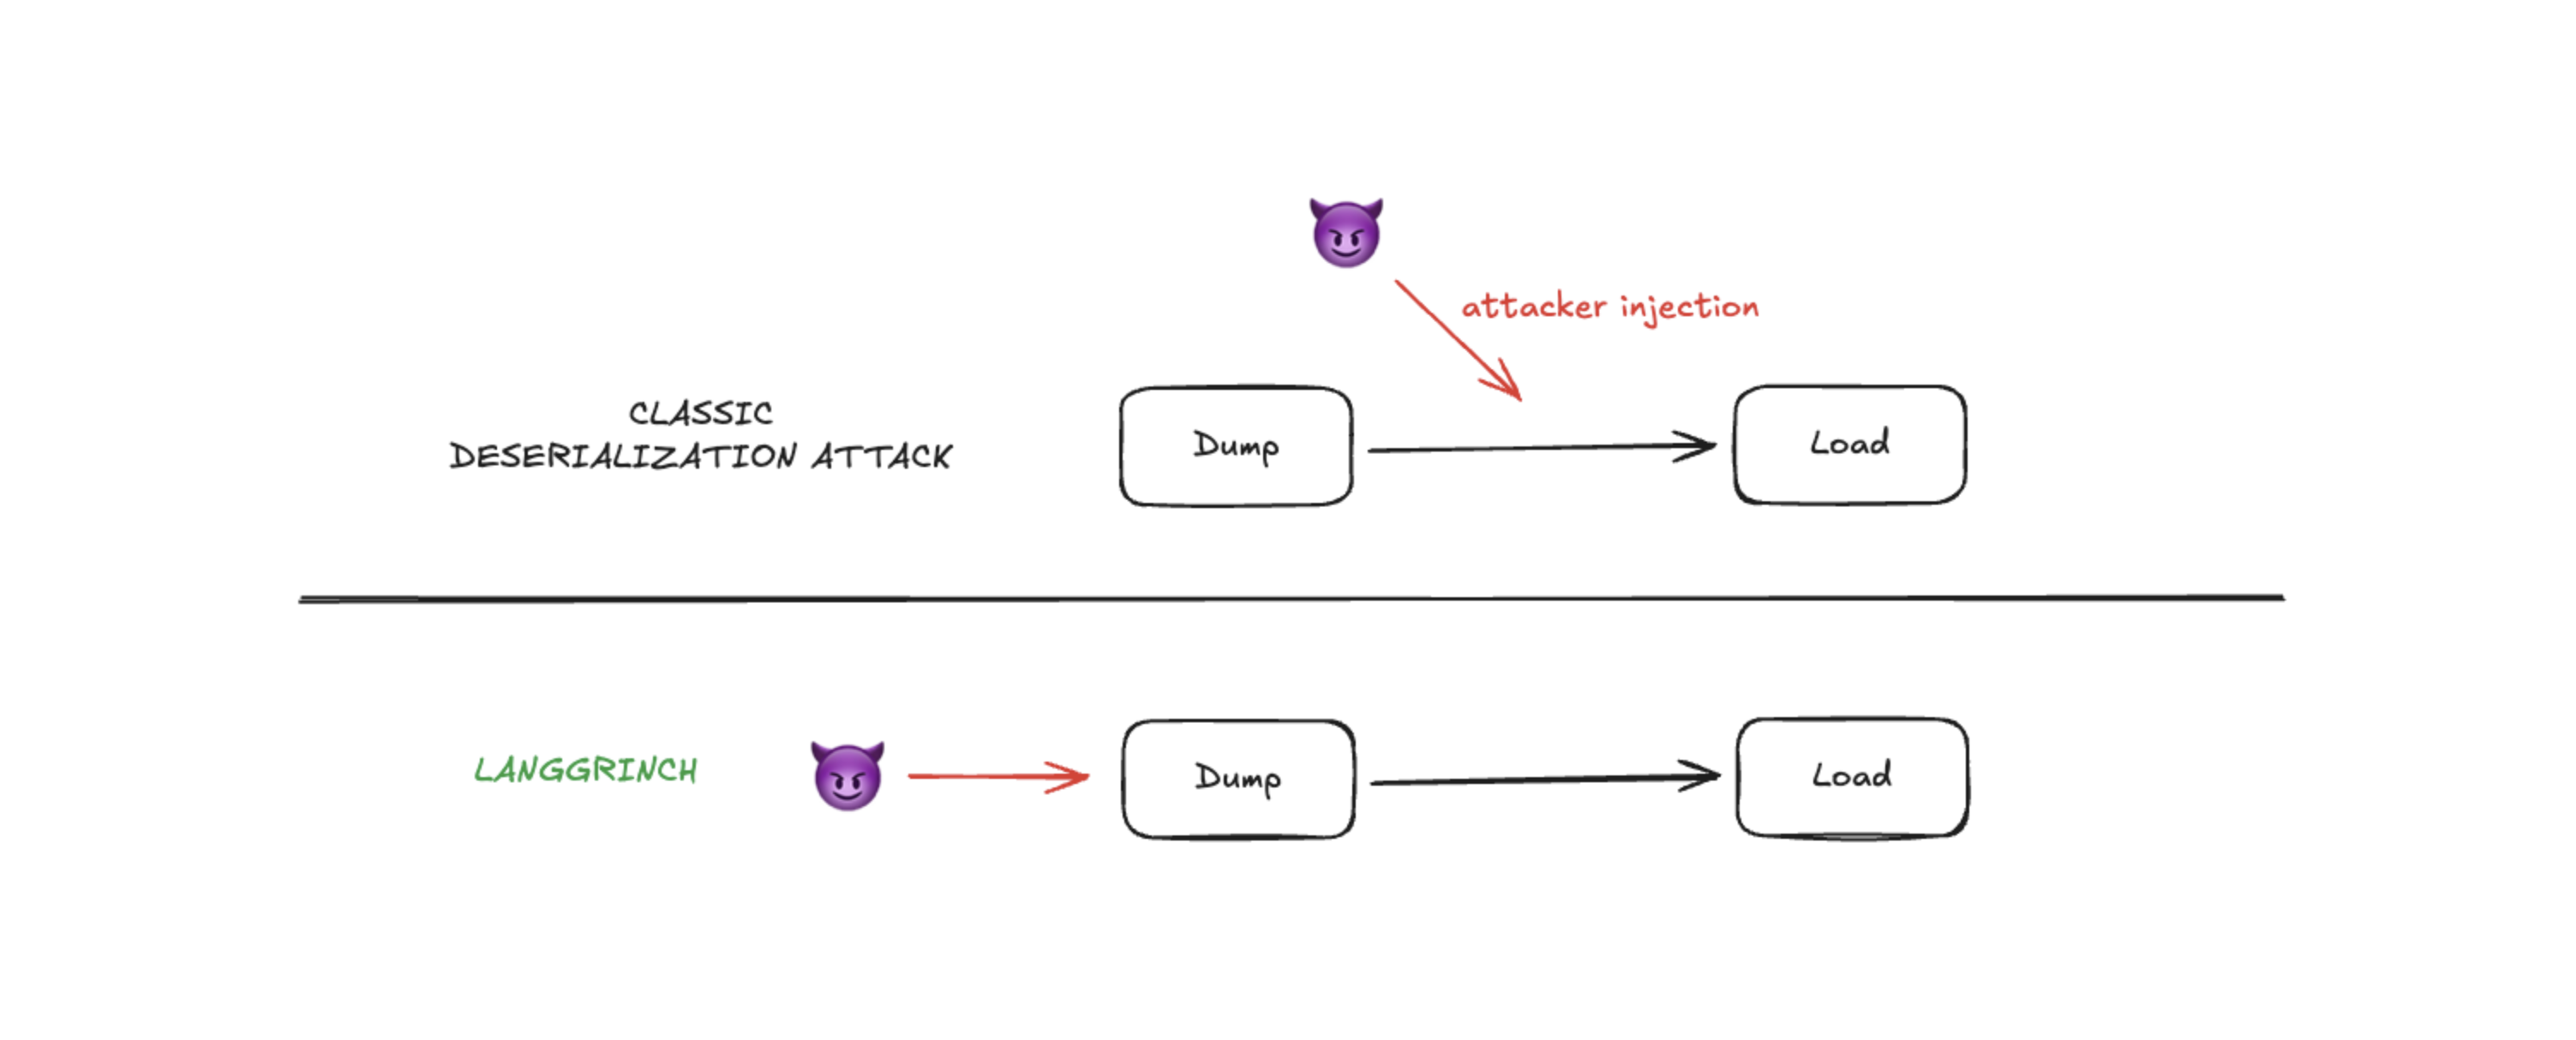
Es mucho más fácil notar algo incorrecto que notar la ausencia de algo, especialmente cuando estás auditando load(), no dumps(). En uno de los frameworks de IA más exhaustivamente auditados. Dos años y medio.
A partir de ahí, la investigación se convirtió en un ejercicio estructurado:
Identificar dónde el contenido no confiable (principalmente diccionarios arbitrarios) entra en la serialización (salidas de LLM, inyección de prompts, entrada del usuario, herramientas externas, documentos extraídos).
Identificar cuándo esos datos serializados se deserializan.
Determinar qué puede lograr un atacante con la instanciación arbitraria de objetos.
En ese momento, el hallazgo principal era lo suficientemente claro y accionable para un informe responsable: había una brecha de escape en dumps() / dumpd() alrededor de diccionarios con la clave 'lc'.
La advertencia posterior capturó lo que a menudo vemos en la práctica: campos como additional_kwargs y response_metadata pueden ser influenciados por la salida del LLM y la inyección de prompts, y estos campos pueden serializarse y deserializarse en muchos flujos.
En honor al equipo de LangChain: la respuesta y las acciones posteriores fueron decididas, no solo parcheando el bug, sino también endureciendo los valores predeterminados que eran demasiado permisivos para el mundo en el que vivimos ahora.
