 chenaotian/cve-2022-0492
Análisis técnico detallado y exploit funcional para el escape de contenedor del kernel de Linux CVE-2022-0492 mediante cgroup release_agent, con configuración de laboratorio paso a paso y guía de mitigación.

[toc]
Identificador de vulnerabilidad: CVE-2022-0492
Producto vulnerable: linux kernel - cgroup
Versiones afectadas: ~linux kernel 5.17-rc3
Impacto: Cuando el contenedor no tiene medidas de seguridad adicionales, obtener permisos de root dentro del contenedor permite escapar al host.
Simplemente use Docker en un kernel Linux con la versión vulnerable.
#关闭所有安全防护启动docker
docker run --rm -it -h cve --name cve --security-opt="seccomp=unconfined" --security-opt="apparmor=unconfined" ubuntu:20.04 /bin/bash
Este artículo utiliza Docker como entorno experimental.
El método de explotación de esta vulnerabilidad ya es conocido, pero el punto de fallo radica en la falta de verificación de permisos al modificar el release_agent de cgroup, lo que reduce aún más la barrera para la explotación de escape (anteriormente se requería el privilegio CAP_SYS_ADMIN, esta vulnerabilidad no lo necesita). Las diferencias específicas en los requisitos de explotación se ven en la sección "Condiciones de explotación".
Analizando el parche, corrigió la función cgroup_release_agent_write añadiendo autenticación. Esto significa que el release_agent de cgroup ya no permite su modificación por usuarios sin permisos:
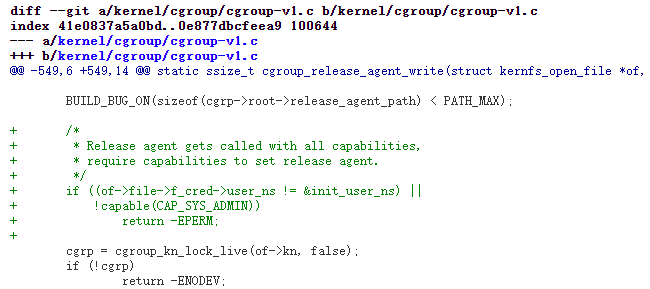
Por lo tanto, se determina que esta vulnerabilidad es un control de acceso defectuoso.
cgroup, o Grupo de Control de Linux, es una funcionalidad del kernel de Linux que se utiliza para limitar, controlar y aislar los recursos de un grupo de procesos (como CPU, memoria, entrada/salida de disco, etc.).
cgroup tiene los siguientes subsistemas:
devices para permisos de dispositivos a nivel de procesocpuset asigna la cantidad de CPU y nodos de memoria que un proceso puede usarcpu controla la proporción de CPUcpuacct estadísticas de uso de CPU, como tiempo de ejecución, tiempo estrangulado (throttled)freezer pausa los procesos en el Cgroupnet_cls junto con tc (controlador de tráfico) limita el ancho de banda de rednet_prio establece la prioridad del tráfico de red de los procesoshuge_tlb limita el uso de HugeTLBperf_event permite que la herramienta Perf realice mediciones de rendimiento basadas en grupos de CgroupLos cgroup en el host están todos en /sys/fs/cgroup, donde se pueden ver los subsistemas de cgroup:

El subsistema cgroup correspondiente en Docker es un nodo hijo del cgroup en el host. Ver el cgroup de memoria en Docker:

El nodo con el nombre del contenedor correspondiente en el directorio de Docker del host es exactamente el mismo:

cgroup se utiliza a través del sistema de archivos. Montando cgroup en un directorio mediante mount, cgroup interactúa con nosotros a través del sistema de archivos virtual VFS. Las interfaces de cgroup se presentan en forma de archivos, y se pueden configurar parámetros de cgroup directamente usando operaciones de archivo.
mount -t cgroup -o memory cgroup /tmp/testcgroup

Se pueden crear nodos hijos de cgroup creando subdirectorios en el directorio: mkdir /tmp/testcgroup/x.
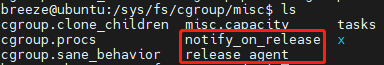
Cada subsistema de cgroup tiene un parámetro notify_on_release, que es de tipo booleano (1 o 0). Puede activar o desactivar la instrucción del agente de liberación. Si notify_on_release está habilitado (1), cuando el cgroup ya no contenga ninguna tarea (es decir, cuando el último proceso del cgroup sale y el archivo tasks del cgroup está vacío de PID), el kernel del sistema ejecutará el contenido del archivo especificado por el parámetro release_agent. El valor de notify_on_release se modifica mediante el archivo notify_on_release.
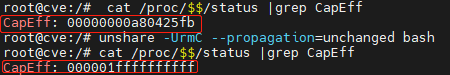
La vulnerabilidad radica en la modificación del release_agent. Originalmente, cualquiera que pudiera operar cgroup podía modificar el release_agent, y solo se requería CAP_SYS_ADMIN para usar cgroup. Pero luego los investigadores descubrieron que mediante el comando unshare se podía crear un nuevo namespace y obtener todas las capabilities, por lo que la restricción de CAP_SYS_ADMIN dejó de existir, reduciendo drásticamente la barrera de explotación.
La función del comando unshare es eliminar la compartición de los namespaces especificados con el proceso padre y luego ejecutar el programa especificado uniéndose al namespace recién creado. Lo relevante para nuestra explotación es que el namespace creado por unshare posee todas las capabilities, incluida CAP_SYS_ADMIN.
Esta explotación es igual que el método tradicional de escape usando CAP_SYS_ADMIN + release_agent de cgroup, pero las condiciones de explotación son diferentes.
Las diferencias en las condiciones de explotación respecto al escape tradicional con release_agent son:
release_agent tradicional: el contenedor necesita tener CAP_SYS_ADMIN y no tener apparmor ni selinux activados.
cve-2022-0492: el contenedor está desprotegido (más específicamente, seccomp no deshabilita unshare, apparmor no activa cgroup de solo lectura, selinux desactivado), y se obtienen permisos de root dentro del contenedor. No se necesita CAP_SYS_ADMIN.
Vale la pena mencionar que apparmor de Docker por defecto activa cgroup de solo lectura, y seccomp de Docker por defecto deshabilita unshare sin el privilegio CAP_SYS_ADMIN. k8s por defecto suele tener contenedores desprotegidos. En resumen, como la explotación es relativamente fácil, se puede intentar en escenarios específicos.
Después de la corrección: según el código del parche:
Para modificar el archivo release_agent se necesitan dos condiciones:
Por lo tanto, después de la corrección, el privilegio CAP_SYS_ADMIN obtenido mediante unshare ya no puede modificar el release_agent, porque el nuevo namespace obtenido con unshare no es el namespace raíz. Pero si el contenedor ya tiene el privilegio CAP_SYS_ADMIN, todavía puede usar este método para escapar.
Si Docker se inicia con el parámetro --cap-add=SYS_ADMIN o --privileged (contenedor privilegiado), entonces tiene el privilegio CAP_SYS_ADMIN y no necesitamos obtenerlo adicionalmente, como en el siguiente comando de inicio:
