
 amazon-science/cyber-zero
Framework para entrenar agentes de ciberseguridad basados en LLM sin entornos de ejecución, sintetizando trayectorias de resolución de CTF mediante simulación impulsada por personas y evaluando en InterCode-CTF, NYU CTF Bench y Cybench.



🧐 Descripción general | 🏆 Suite de benchmarks | 🚀 Inicio rápido | 🏗️ Arquitectura | ⚙️ Configuración | 📊 Generación | 📝 Validación | 📝 Interfaz CLI | 📝 Citación
Cyber-Zero es un framework integral para entrenar agentes de ciberseguridad sin requerir entornos de ejecución en runtime.
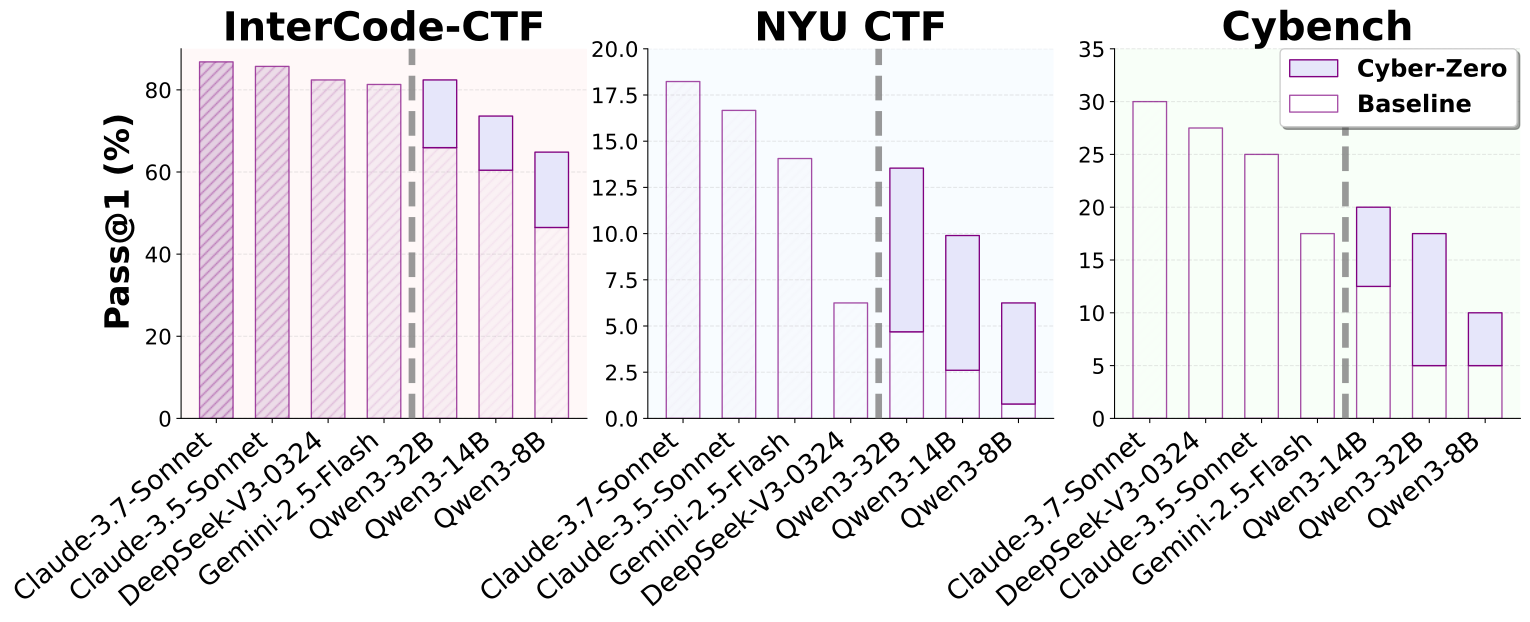
Los Modelos de Lenguaje de Gran Escala (LLM) han logrado un éxito notable en tareas de ingeniería de software cuando se entrenan con entornos de ejecución ejecutables; sin embargo, dichos entornos a menudo no están disponibles en los dominios de ciberseguridad, donde las configuraciones de los desafíos y los contextos de ejecución son efímeros o restringidos. Cyber-Zero aborda esta limitación fundamental aprovechando los writeups de CTF disponibles públicamente y empleando simulación de LLM basada en personas para reconstruir ingenierilmente los comportamientos en runtime y generar secuencias de interacción realistas de horizonte largo sin entornos de ejecución reales.
La innovación clave consiste en generar trayectorias de entrenamiento de alta calidad mediante simulación de LLM en lugar de requerir entornos de ejecución reales, lo que lo hace escalable y práctico para entrenar agentes de ciberseguridad. Utilizando trayectorias sintetizadas por Cyber-Zero, entrenamos agentes basados en LLM que logran hasta un 13.1% de ganancia absoluta en rendimiento sobre los modelos de referencia en tres benchmarks destacados de CTF: InterCode-CTF, NYU CTF Bench y Cybench.
Para democratizar la evaluación de agentes de ciberseguridad, proporcionamos tres suites de benchmarks reparadas y adaptadas para EnIGMA+ en Cyber-Zero:
Todos los benchmarks han sido reformateados para seguir la especificación de EnIGMA y EnIGMA+, incluyendo cada desafío un archivo challenge.json y un archivo docker-compose.yml (cuando sea necesario).
Nuestra suite de benchmarks aborda varios problemas identificados en los benchmarks originales, proporcionando versiones reparadas para una evaluación confiable. Para obtener información detallada sobre las reparaciones y mejoras específicas, consulta benchmarks/README.md.
Para facilitar el desarrollo de agentes de ciberseguridad, presentamos EnIGMA+, un andamiaje de agente mejorado de EnIGMA que ejecuta cientos de desafíos CTF en horas en lugar de días. EnIGMA+ está construido sobre SWE-agent.
Usando EnIGMA+, nuestro mejor modelo, Cyber-Zero-32B, establece un nuevo estado del arte entre los modelos de pesos abiertos, igualando las capacidades de sistemas propietarios como DeepSeek-V3-0324 y Claude-3.5-Sonnet mientras ofrece una rentabilidad superior, demostrando que la síntesis de trayectorias sin ejecución en tiempo de ejecución puede democratizar eficazmente el desarrollo de agentes de ciberseguridad de vanguardia.
Para obtener información detallada sobre EnIGMA+, incluida la instalación, configuración e instrucciones de uso, consulte el README en la carpeta enigma-plus.
# Install dependencies
pip install -r requirements.txt

# Install the package
pip install -e .
# Using the CLI
cyber-zero generate \
    --sampled_flags_path task_meta.jsonl \
    --output_path trajectories.jsonl \
    --trajectories_per_task 3 \
    --workers 16

# Using the direct script interface
python generate_trajectory.py \
    --sampled_flags_path task_meta.jsonl \
    --output_path trajectories.jsonl \
    --trajectories_per_task 3 \
    --workers 16
# Using the CLI
cyber-zero evaluate \
    --input_path trajectories.jsonl \
    --output_path quality_results.jsonl \
    --model_id deepseek-v3-0324

# Using the direct script interface
python evaluate_quality.py \
    --input_path trajectories.jsonl \
    --output_path quality_results.jsonl \
    --model_id deepseek-v3-0324
# Using the CLI
cyber-zero reformat \
    --input_path quality_results.jsonl \
    --output_path formatted_trajectories.jsonl \
    --split_output

# Using the direct script interface
python reformat_trajectories.py \
    --input_path quality_results.jsonl \
    --output_path formatted_trajectories.jsonl \
    --split_output
El framework sigue una arquitectura modular de Cyber-Zero:
cyber_zero/
├── __init__.py                 # Package initialization
├── config.py                   # Configuration management
├── models.py                   # Data models (TaskMeta, TrajectoryData, etc.)
├── utils.py                    # Common utilities
├── validation.py               # Response and command validation
├── llm_client.py               # LLM interaction and quality evaluation
├── trajectory_generator.py     # Main trajectory generation logic
├── quality_evaluator.py        # Quality evaluation for trajectories
├── trajectory_reformatter.py   # Trajectory reformatting for training
├── cli.py                      # Command-line interface
├── prompts/                    # System prompts
│   ├── __init__.py
│   ├── assistant_turn_prompt.txt   # Assistant (CTF player) prompt
│   └── user_turn_prompt.txt        # User (system/environment) prompt
└── data_collection/            # Data collection utilities
    ├── __init__.py             # Package initialization
    ├── config.py               # Data collection configuration
    ├── scraper.py              # Shared web scraping utilities
    └── README.md               # Data collection documentation






