 albertan017/llm4decompile
Ingeniería inversa: Descompilando código binario con grandes modelos de lenguaje

<p align="center">
<picture>
<source media="(prefers-color-scheme: dark)" srcset="https://github.com/albertan017/LLM4Decompile/blob/main/samples/logo-dark.png">
<img alt="LLM4Decompile" src="https://raw.githubusercontent.com/albertan017/LLM4Decompile/main/samples/logo-light.png" width=55%>
</picture>
</p>
<p align="left">
📊 <a href="#evaluation">Resultados</a>
| 🤗 <a href="#models">Modelos</a>
| 🚀 <a href="#quick-start">Inicio rápido</a>
| 📚 <a href="#humaneval-decompile">HumanEval-Decompile</a>
| 📎 <a href="#citation">Citación</a>
| 📝 <a href="https://arxiv.org/abs/2403.05286">Paper</a>
| 🖥️ <a href="https://colab.research.google.com/drive/1X5TuUKuNuksGJZz6Cc83KKI0ATBP9q7r?usp=sharing">Colab</a>
| ▶️ <a href="https://www.youtube.com/watch?v=x7knF3Z1yLk">YouTube</a>
</p>
Ingeniería inversa: descompilación de código binario con grandes modelos de lenguaje
[](https://trendshift.io/repositories/8664)
## Updates
* [2025-10-04]: Publicación de SK²Decompile: descompilación binaria de dos fases basada en LLM, del esqueleto a la piel. Fase 1, Recuperación de estructura (Esqueleto): transforma código binario/pseudocódigo en representaciones intermedias ofuscadas 🤗 [Enlace HF](https://huggingface.co/LLM4Binary/sk2decompile-struct-6.7b). Fase 2, Nombrado de identificadores (Piel): genera código fuente legible con identificadores significativos 🤗 [Enlace HF](https://huggingface.co/LLM4Binary/sk2decompile-ident-6.7).
* [2025-05-20]: Publicación de [decompile-bench](https://huggingface.co/collections/LLM4Binary/decompile-bench-68259091c8d49d0ebd5efda9), que contiene dos millones de pares de funciones binario-fuente para entrenamiento y 70 000 pares de funciones para evaluación. Consulte la carpeta [decompile-bench](https://github.com/albertan017/LLM4Decompile/tree/main/decompile-bench) para más detalles.
* [2024-10-17]: Publicación de [decompile-ghidra-100k](https://huggingface.co/datasets/LLM4Binary/decompile-ghidra-100k), un subconjunto de 100 000 muestras de entrenamiento (25 000 por nivel de optimización). Proporcionamos un [script de entrenamiento](https://github.com/albertan017/LLM4Decompile/blob/main/train/README.md) que se ejecuta en aproximadamente 3,5 horas en una GPU A100 de 40 GB. Alcanza una tasa de reejecutabilidad de 0,26, con un coste total inferior a $20 para replicar rápidamente LLM4Decompile.
* [2024-09-26]: Actualización de un [cuaderno de Colab](https://colab.research.google.com/drive/1X5TuUKuNuksGJZz6Cc83KKI0ATBP9q7r?usp=sharing) para demostrar el uso del modelo LLM4Decompile, incluidos ejemplos de los modelos LLM4Decompile-End y LLM4Decompile-Ref.
* [2024-09-23]: Publicación de [LLM4Decompile-9B-v2](https://huggingface.co/LLM4Binary/llm4decompile-9b-v2), ajustado a partir de [Yi-Coder-9B](https://huggingface.co/01-ai/Yi-Coder-9B), que alcanzó una tasa de reejecutabilidad de **0.6494** en el benchmark Decompile.
* [2024-06-19]: Publicación de la serie [V2](https://huggingface.co/LLM4Binary/llm4decompile-6.7b-v2) (LLM4Decompile-Ref). V2 (1.3B-22B), basada en **Ghidra**, se entrena con 2 000 millones de tokens para **refinar** el pseudocódigo descompilado por Ghidra. La versión 22B-V2 supera a la 6.7B-V1.5 en un 40,1% adicional. Consulte la [carpeta ghidra](https://github.com/albertan017/LLM4Decompile/tree/main/ghidra) para más detalles.
* [2024-05-13]: Publicación de la serie [V1.5](https://huggingface.co/LLM4Binary/llm4decompile-6.7b-v1.5) (LLM4Decompile-End, descompila el binario directamente mediante LLM). V1.5 se entrena con un conjunto de datos más grande (15 000 millones de tokens) y una **longitud máxima de token de 4096**, con un rendimiento notable (más de un **100% de mejora**) en comparación con el modelo anterior.
* [2024-03-16]: Adición del modelo [llm4decompile-6.7b-uo](https://huggingface.co/arise-sustech/llm4decompile-6.7b-uo), entrenado sin conocimiento previo de los niveles de optimización (O0~O3), con una reejecutabilidad media en torno a 0,219, el mejor rendimiento de nuestros modelos.
## Acerca de
* **LLM4Decompile** es el primer modelo de lenguaje grande de código abierto dedicado a la descompilación. Su versión actual permite descompilar binarios Linux x86_64, desde los niveles de optimización O0 a O3 de GCC, a código fuente C legible. Nuestro equipo está comprometido con ampliar las capacidades de esta herramienta, con esfuerzos en curso para incorporar una gama más amplia de arquitecturas y configuraciones.
* **LLM4Decompile-End** se centra en descompilar el binario directamente. **LLM4Decompile-Ref** refina el pseudocódigo descompilado por Ghidra.
## Evaluación
### Marco
<p align="center">
<img src="https://raw.githubusercontent.com/albertan017/LLM4Decompile/main/samples/compile-decompile.png" alt="image" width="400" height="auto">
</p>
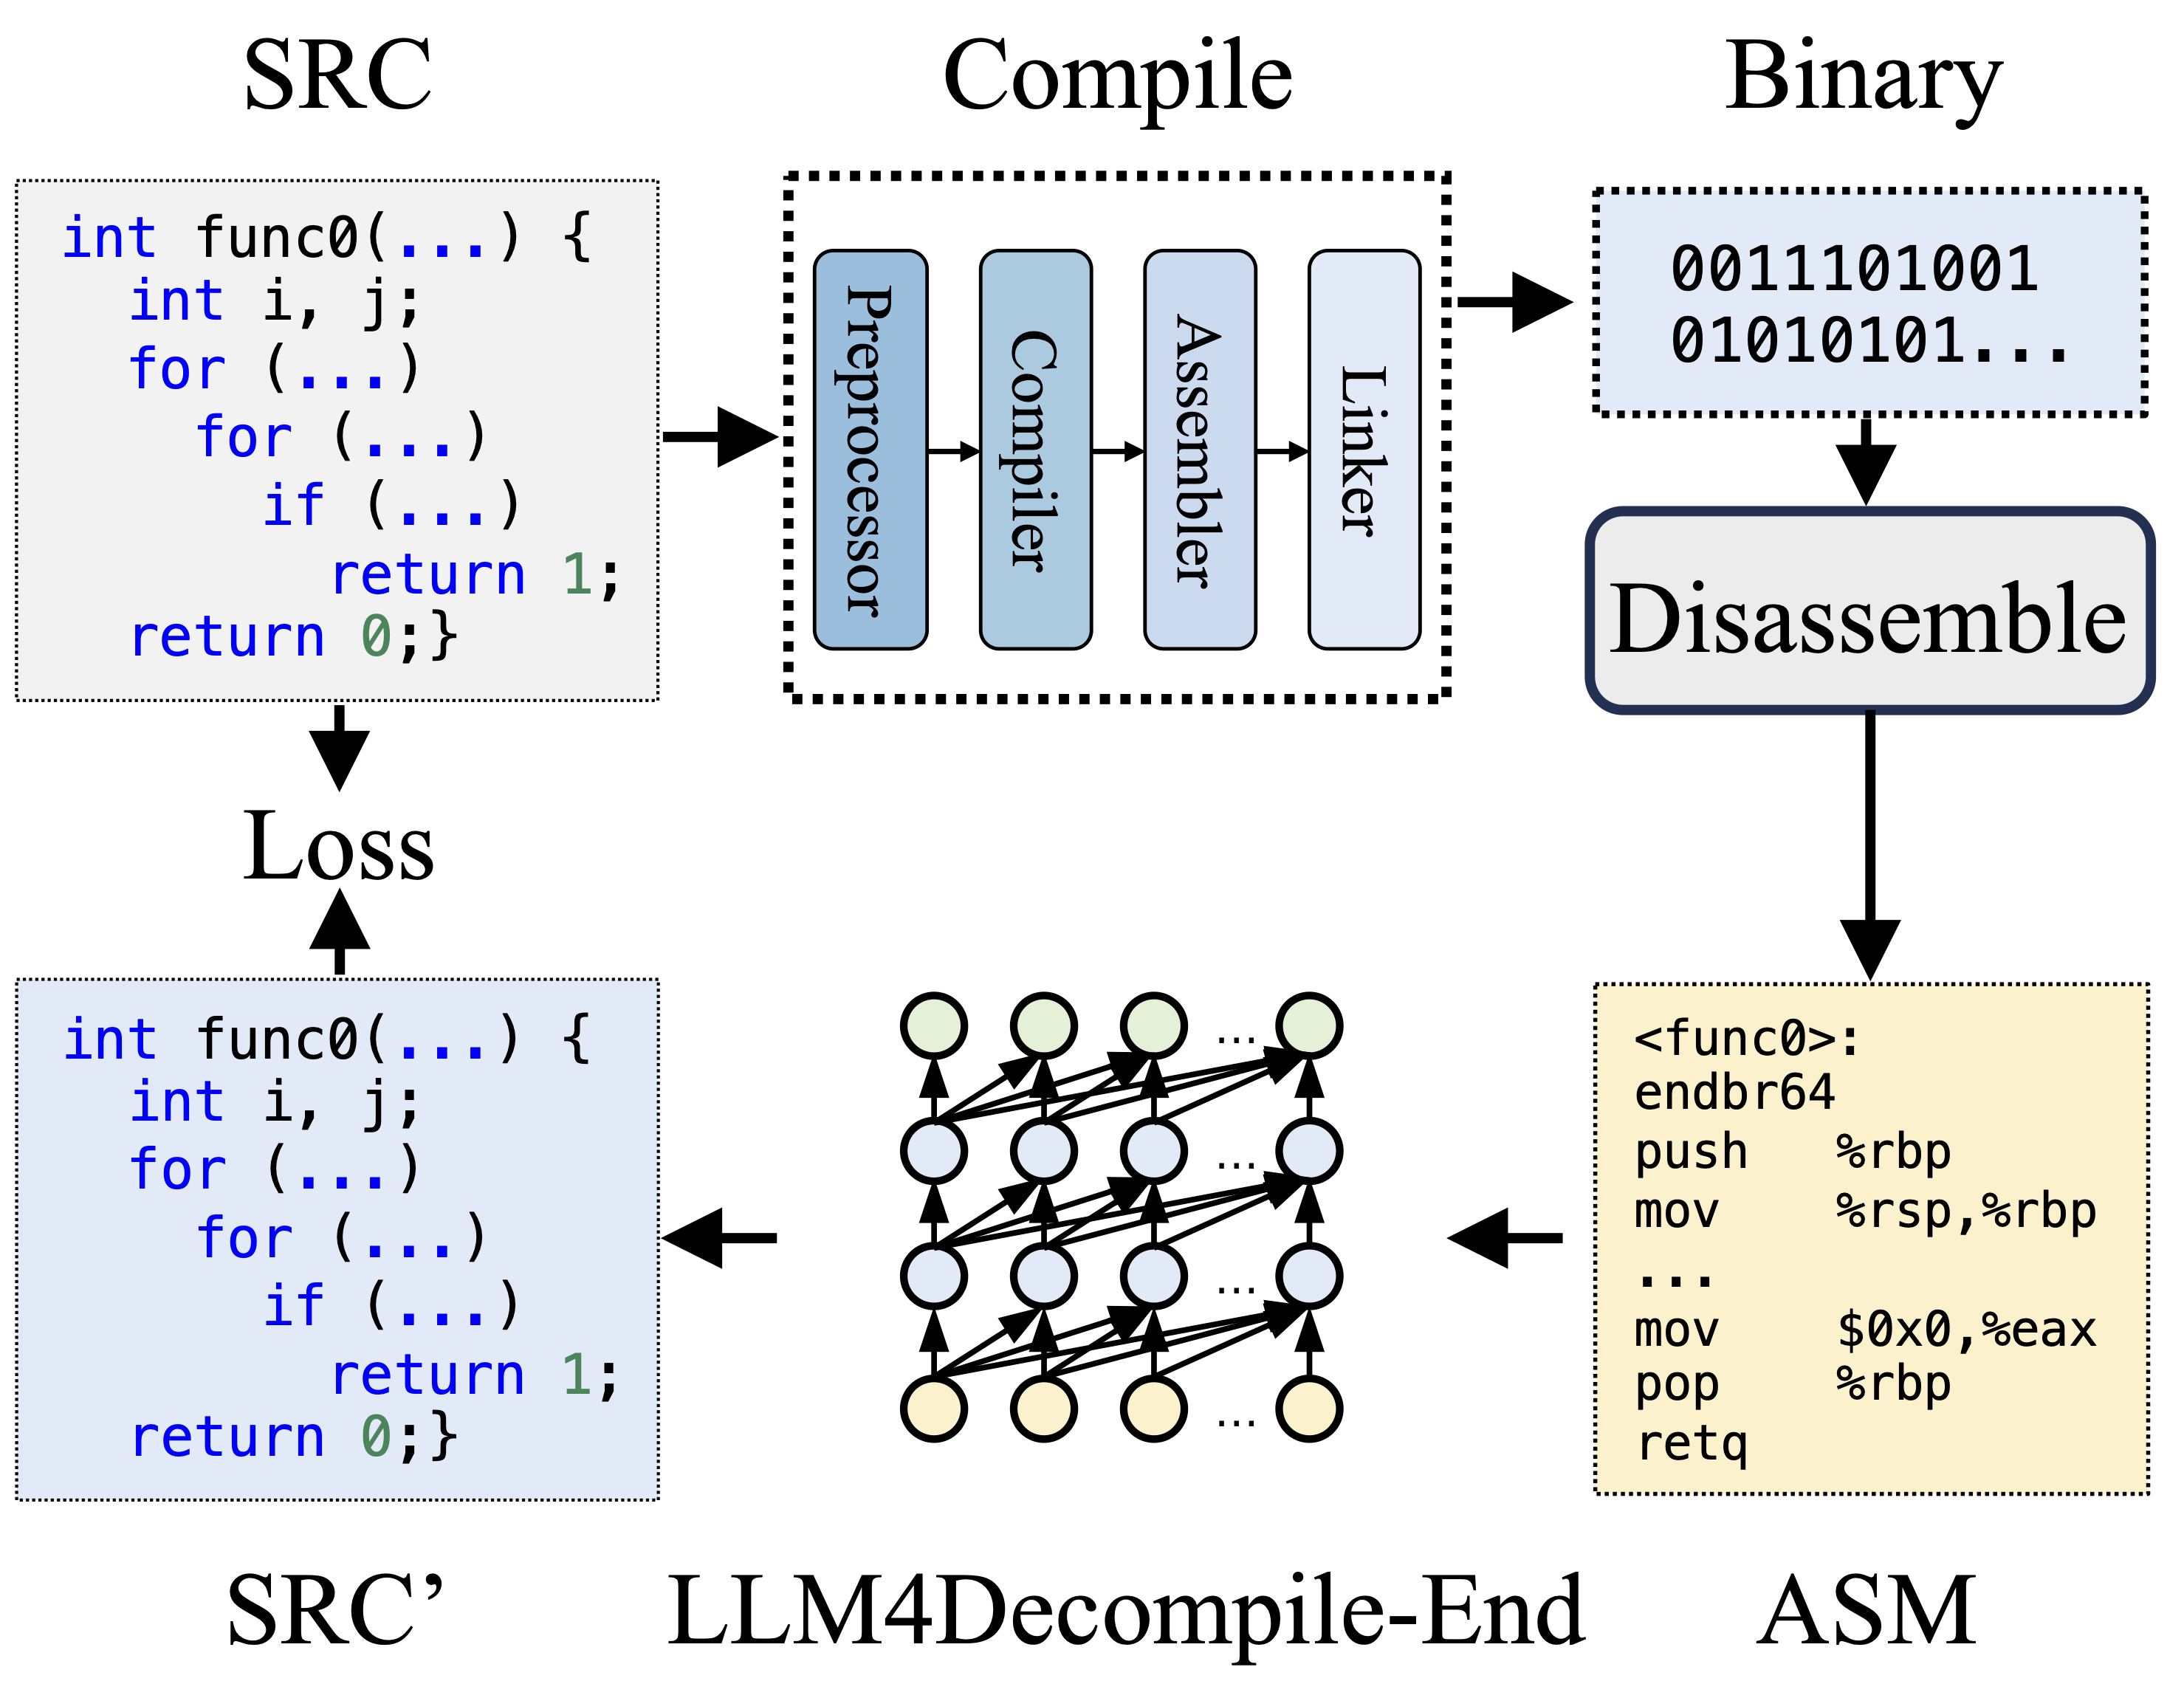
Durante la compilación, el preprocesador procesa el código fuente (SRC) para eliminar comentarios y expandir macros o includes. A continuación, el código limpio se envía al compilador, que lo convierte en código ensamblador (ASM). El ensamblador transforma este ASM en código binario (0s y 1s). El enlazador finaliza el proceso enlazando las llamadas a funciones para crear un archivo ejecutable. La descompilación, por otro lado, consiste en convertir el código binario de nuevo en un archivo fuente. Los LLM, al estar entrenados con texto, no pueden procesar datos binarios directamente. Por lo tanto, los binarios deben desensamblarse primero con ```Objdump``` a lenguaje ensamblador (ASM). Cabe señalar que el binario y el ASM desensamblado son equivalentes, pueden interconvertirse y, por tanto, nos referimos a ellos de forma intercambiable. Finalmente, la pérdida se calcula entre el código descompilado y el código fuente para guiar el entrenamiento. Para evaluar la calidad del código descompilado (SRC'), se comprueba su funcionalidad mediante aserciones de prueba (reejecutabilidad).
### Métricas
* **Reejecutabilidad** evalúa si el código descompilado puede ejecutarse correctamente y superar todos los casos de prueba predefinidos.
### Benchmarks
* **HumanEval-Decompile**: una colección de 164 funciones C que dependen exclusivamente de bibliotecas C **estándar**.
* **ExeBench**: una colección de 2621 funciones extraídas de proyectos **reales**, cada una de las cuales utiliza funciones, estructuras y macros definidas por el usuario.
### Resultados
<p align="center">
<img src="https://raw.githubusercontent.com/albertan017/LLM4Decompile/main/samples/results_end_final.png" alt="results" width="800" height="auto">
</p>
<p align="center">
<img src="https://raw.githubusercontent.com/albertan017/LLM4Decompile/main/samples/results_refine_final.png" alt="image" width="800" height="auto">
</p>
## Modelos
Nuestro LLM4Decompile incluye modelos con tamaños de entre 1300 millones y 33 000 millones de parámetros, y hemos puesto estos modelos a disposición en Hugging Face.
| Model | Checkpoint | Size | Re-executability | Note |
|-----------------------|-------------------------------------------------------------------|------|---------------------|----------------------|
| **llm4decompile-1.3b-v1.5**| 🤗 [HF Link](https://huggingface.co/LLM4Binary/llm4decompile-1.3b-v1.5) | 1.3B | **27.3%** | Note 3 |
| **llm4decompile-6.7b-v1.5**| 🤗 [HF Link](https://huggingface.co/LLM4Binary/llm4decompile-6.7b-v1.5) | 6.7B | **45.4%** | Note 3 |
| **llm4decompile-1.3b-v2**| 🤗 [HF Link](https://huggingface.co/LLM4Binary/llm4decompile-1.3b-v2) | 1.3B | **46.0%** | Note 4 |
| **llm4decompile-6.7b-v2**| 🤗 [HF Link](https://huggingface.co/LLM4Binary/llm4decompile-6.7b-v2) | 6.7B | **52.7%** | Note 4 |
| **llm4decompile-9b-v2**| 🤗 [HF Link](https://huggingface.co/LLM4Binary/llm4decompile-9b-v2) | 9B | **64.9%** | Note 4 |
| **llm4decompile-22b-v2**| 🤗 [HF Link](https://huggingface.co/LLM4Binary/llm4decompile-22b-v2) | 22B | **63.6%** | Note 4 |
Nota 3: La serie V1.5 se entrena con un conjunto de datos más grande (15 000 millones de tokens) y un tamaño máximo de token de 4096, con un rendimiento notable (más de un 100% de mejora) en comparación con el modelo anterior.
Nota 4: La serie V2 se basa en **Ghidra** y se entrena con 2 000 millones de tokens para **refinar** el pseudocódigo descompilado por Ghidra. Consulte la [carpeta ghidra](https://github.com/albertan017/LLM4Decompile/tree/main/ghidra) para más detalles.
## Inicio rápido
[](https://colab.research.google.com/drive/1X5TuUKuNuksGJZz6Cc83KKI0ATBP9q7r?usp=sharing)
**Configuración:** utilice el siguiente script para instalar el entorno necesario.
```
git clone https://github.com/albertan017/LLM4Decompile.git
cd LLM4Decompile
conda create -n 'llm4decompile' python=3.9 -y
conda activate llm4decompile
pip install -r requirements.txt
```
A continuación se muestra un ejemplo de cómo usar nuestro modelo (revisado para V1.5. Para modelos anteriores, consulte la página del modelo correspondiente en HF).
Nota: **sustituya "func0" por el nombre de la función que desee descompilar**.
**Preprocesamiento:** compile el código C a binario y desensamble el binario en instrucciones de ensamblador.
```python
import subprocess
import os
func_name = 'func0'
OPT = ["O0", "O1", "O2", "O3"]
fileName = 'samples/sample' #'path/to/file'
for opt_state in OPT:
output_file = fileName +'_' + opt_state
input_file = fileName+'.c'
compile_command = f'gcc -o {output_file}.o {input_file} -{opt_state} -lm'#compile the code with GCC on Linux
subprocess.run(compile_command, shell=True, check=True)
compile_command = f'objdump -d {output_file}.o > {output_file}.s'#disassemble the binary file into assembly instructions
subprocess.run(compile_command, shell=True, check=True)
input_asm = ''
with open(output_file+'.s') as f:#asm file
asm= f.read()
if '<'+func_name+'>:' not in asm: #IMPORTANT replace func0 with the function name
raise ValueError("compile fails")
asm = '<'+func_name+'>:' + asm.split('<'+func_name+'>:')[-1].split('\n\n')[0] #IMPORTANT replace func0 with the function name
asm_clean = ""
asm_sp = asm.split("\n")
for tmp in asm_sp:
if len(tmp.split("\t"))<3 and '00' in tmp:
continue
idx = min(
len(tmp.split("\t")) - 1, 2
)
tmp_asm = "\t".join(tmp.split("\t")[idx:]) # remove the binary code
tmp_asm = tmp_asm.split("#")[0].strip() # remove the comments
asm_clean += tmp_asm + "\n"
input_asm = asm_clean.strip()
before = f"# This is the assembly code:\n"#prompt
after = "\n# What is the source code?\n"#prompt
input_asm_prompt = before+input_asm.strip()+after
with open(fileName +'_' + opt_state +'.asm','w',encoding='utf-8') as f:
f.write(input_asm_prompt)
```
Las instrucciones de ensamblador deben tener el formato:
<FUNCTION_NAME>:\nOPERATIONS\nOPERATIONS\n
Las instrucciones de ensamblador típicas pueden tener este aspecto:
```
<func0>:
endbr64
lea (%rdi,%rsi,1),%eax
retq
```
**Descompilación:** use LLM4Decompile para traducir las instrucciones de ensamblador a C:
```python
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
model_path = 'LLM4Binary/llm4decompile-6.7b-v1.5' # V1.5 Model
tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForCausalLM.from_pretrained(model_path,torch_dtype=torch.bfloat16).cuda()
with open(fileName +'_' + OPT[0] +'.asm','r') as f:#optimization level O0
asm_func = f.read()
inputs = tokenizer(asm_func, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model.generate(**inputs, max_new_tokens=2048)### max length to 4096, max new tokens should be below the range
c_func_decompile = tokenizer.decode(outputs[0][len(inputs[0]):-1])
with open(fileName +'.c','r') as f:#original file
func = f.read()
print(f'original function:\n{func}')# Note we only decompile one function, where the original file may contain multiple functions
print(f'decompiled function:\n{c_func_decompile}')
```
### Configuración de Docker
```
# build docker
docker build -t llm4decompile .
# run docker with GPU
docker run --gpus all -it --name llm4decompile llm4decompile /bin/bash
# run demo.py (choose a model suitable for your resources before running)
cd ghidra
python demo.py
```
## HumanEval-Decompile
Los datos se almacenan en ``llm4decompile/decompile-eval/decompile-eval-executable-gcc-obj.json``, en formato de lista JSON. Hay 164*4 muestras (O0, O1, O2, O3), cada una con cinco claves:
* ``task_id``: indica el ID del problema.
* ``type``: la fase de optimización, es uno de [O0, O1, O2, O3].
* ``c_func``: solución en C para el problema HumanEval.
* ``c_test``: aserciones de prueba en C.
* ``input_asm_prompt``: instrucciones de ensamblador con prompts; se pueden obtener como en nuestro [ejemplo de preprocesamiento](https://github.com/albertan017/LLM4Decompile?tab=readme-ov-file#quick-start).
Consulte los [scripts de evaluación](https://github.com/albertan017/LLM4Decompile/tree/main/evaluation).
## En curso
* Conjunto de datos de entrenamiento más grande con el proceso de limpieza. (hecho: 2024.05.13)
* Soporte para lenguajes/plataformas y configuraciones populares.
* Soporte para binarios ejecutables. (hecho: 2024.05.13)
* Integración con herramientas de descompilación (p. ej., Ghidra, Rizin)
## Licencia
Este repositorio de código está bajo la licencia MIT y la licencia DeepSeek.
## Citación
```
@misc{tan2024llm4decompile,
title={LLM4Decompile: Decompiling Binary Code with Large Language Models},
author={Hanzhuo Tan and Qi Luo and Jing Li and Yuqun Zhang},
year={2024},
eprint={2403.05286},
archivePrefix={arXiv},
primaryClass={cs.PL}
}
```
## Historial de estrellas
[](https://star-history.com/#albertan017/LLM4Decompile&Timeline)