Ingeniería inversa: descompilación de código binario con grandes modelos de lenguaje
Updates
[2025-10-04]: Publicación de SK²Decompile: descompilación binaria de dos fases basada en LLM, del esqueleto a la piel. Fase 1, Recuperación de estructura (Esqueleto): transforma código binario/pseudocódigo en representaciones intermedias ofuscadas 🤗 Enlace HF. Fase 2, Nombrado de identificadores (Piel): genera código fuente legible con identificadores significativos 🤗 Enlace HF.
[2025-05-20]: Publicación de decompile-bench, que contiene dos millones de pares de funciones binario-fuente para entrenamiento y 70 000 pares de funciones para evaluación. Consulte la carpeta decompile-bench para más detalles.
[2024-10-17]: Publicación de decompile-ghidra-100k, un subconjunto de 100 000 muestras de entrenamiento (25 000 por nivel de optimización). Proporcionamos un script de entrenamiento que se ejecuta en aproximadamente 3,5 horas en una GPU A100 de 40 GB. Alcanza una tasa de reejecutabilidad de 0,26, con un coste total inferior a $20 para replicar rápidamente LLM4Decompile.
[2024-09-26]: Actualización de un cuaderno de Colab para demostrar el uso del modelo LLM4Decompile, incluidos ejemplos de los modelos LLM4Decompile-End y LLM4Decompile-Ref.
[2024-09-23]: Publicación de LLM4Decompile-9B-v2, ajustado a partir de Yi-Coder-9B, que alcanzó una tasa de reejecutabilidad de 0.6494 en el benchmark Decompile.
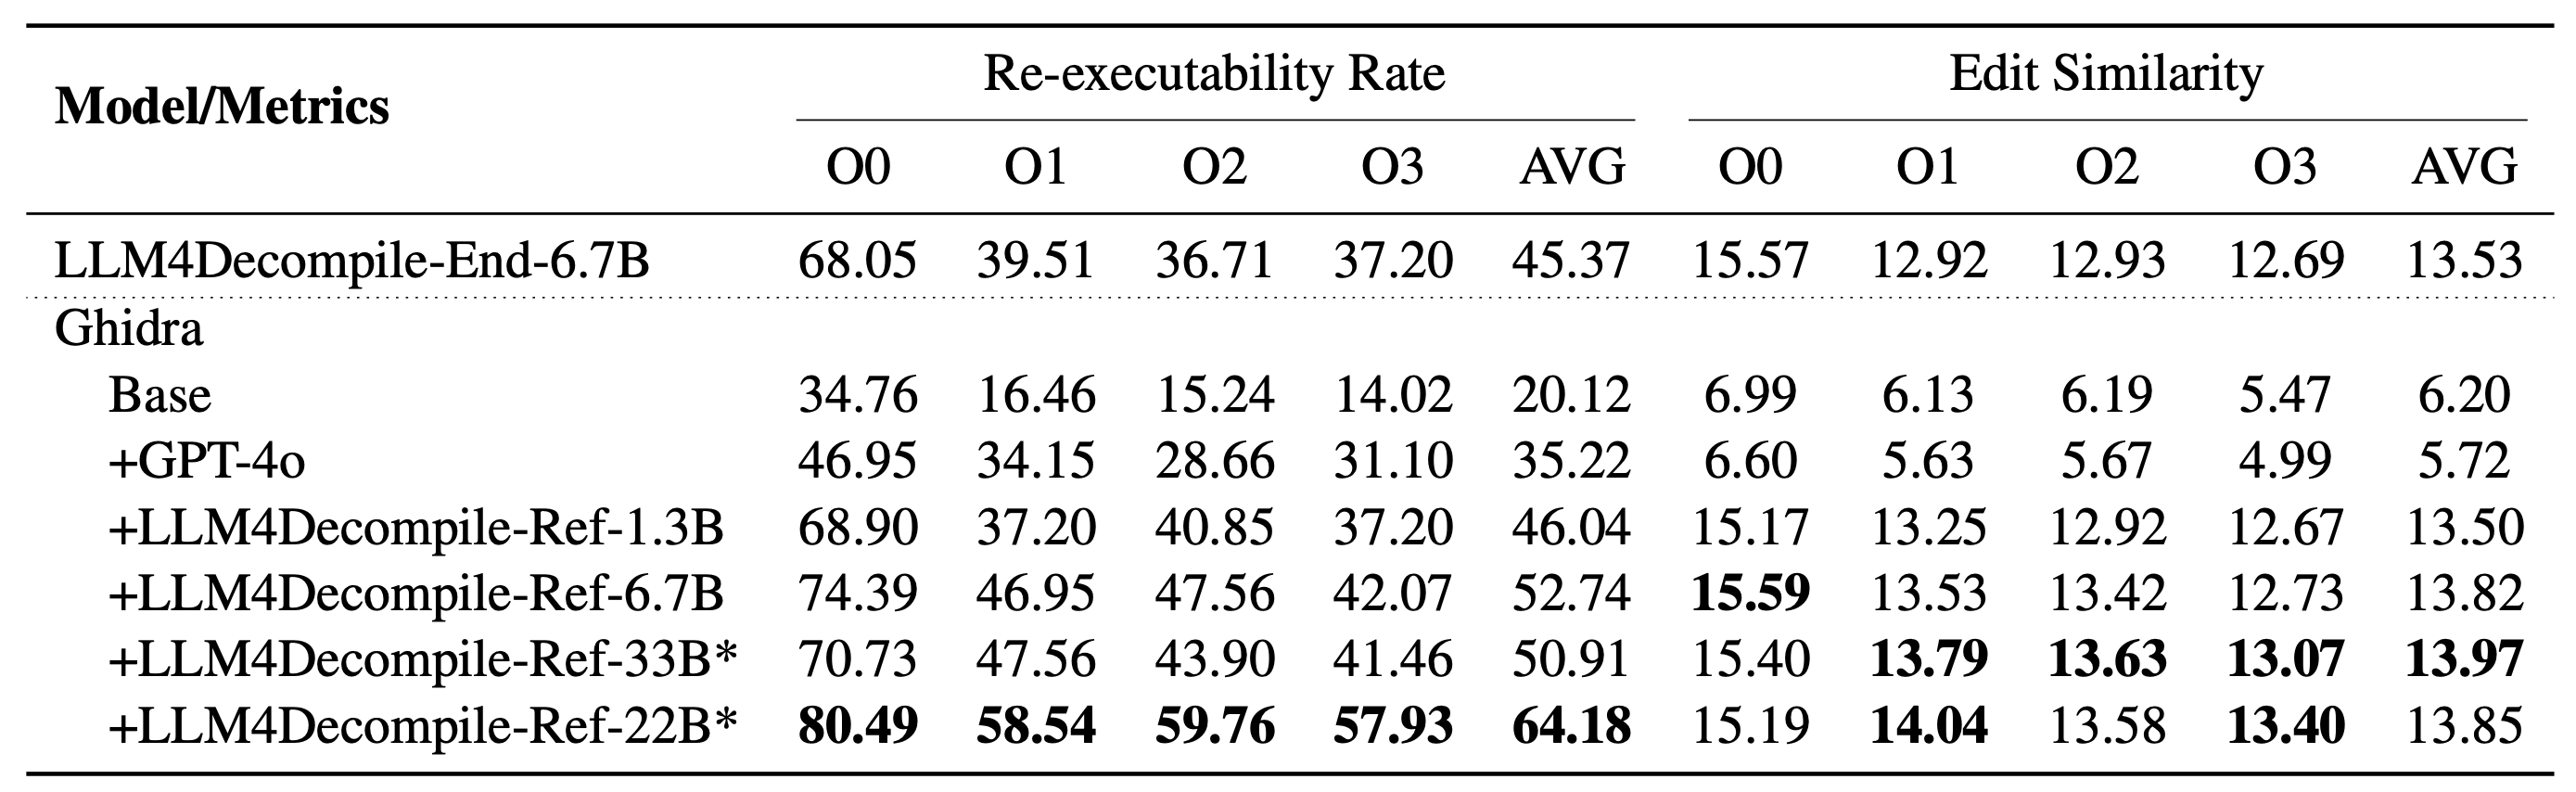
[2024-06-19]: Publicación de la serie V2 (LLM4Decompile-Ref). V2 (1.3B-22B), basada en Ghidra, se entrena con 2 000 millones de tokens para refinar el pseudocódigo descompilado por Ghidra. La versión 22B-V2 supera a la 6.7B-V1.5 en un 40,1% adicional. Consulte la carpeta ghidra para más detalles.
[2024-05-13]: Publicación de la serie V1.5 (LLM4Decompile-End, descompila el binario directamente mediante LLM). V1.5 se entrena con un conjunto de datos más grande (15 000 millones de tokens) y una longitud máxima de token de 4096, con un rendimiento notable (más de un 100% de mejora) en comparación con el modelo anterior.
[2024-03-16]: Adición del modelo llm4decompile-6.7b-uo, entrenado sin conocimiento previo de los niveles de optimización (O0~O3), con una reejecutabilidad media en torno a 0,219, el mejor rendimiento de nuestros modelos.
Acerca de
LLM4Decompile es el primer modelo de lenguaje grande de código abierto dedicado a la descompilación. Su versión actual permite descompilar binarios Linux x86_64, desde los niveles de optimización O0 a O3 de GCC, a código fuente C legible. Nuestro equipo está comprometido con ampliar las capacidades de esta herramienta, con esfuerzos en curso para incorporar una gama más amplia de arquitecturas y configuraciones.
LLM4Decompile-End se centra en descompilar el binario directamente. LLM4Decompile-Ref refina el pseudocódigo descompilado por Ghidra.
Evaluación
Marco
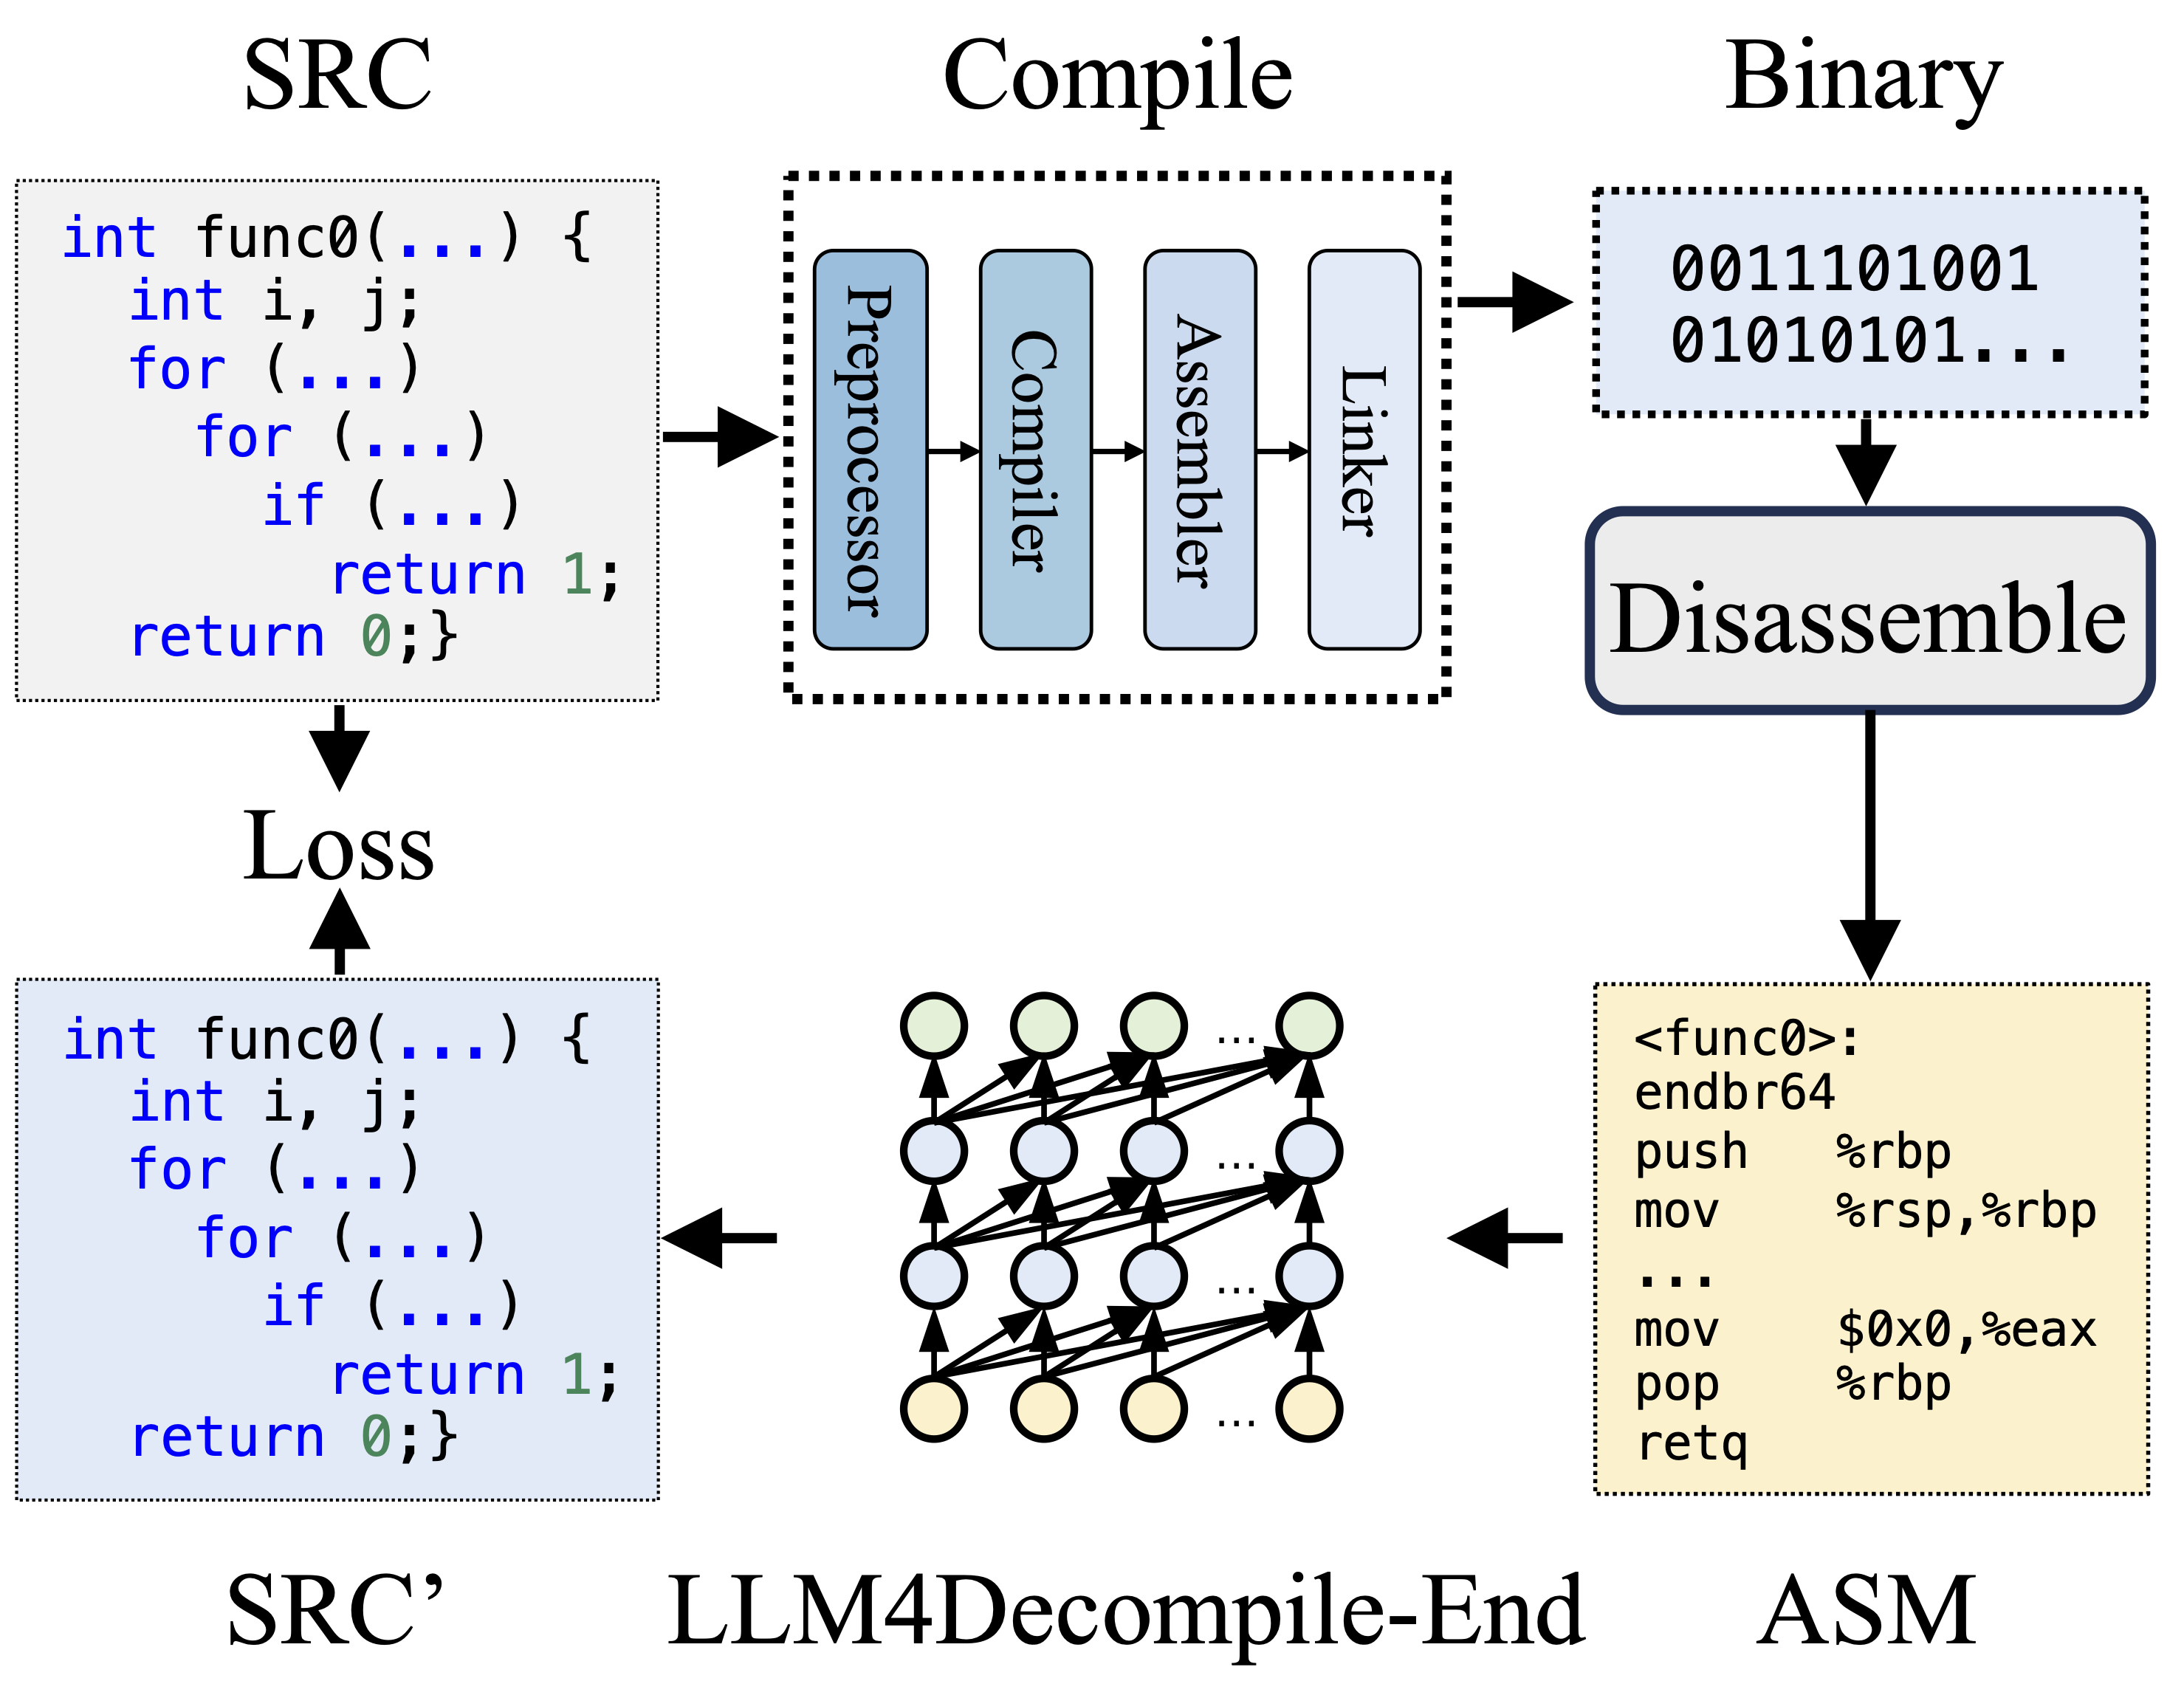
Durante la compilación, el preprocesador procesa el código fuente (SRC) para eliminar comentarios y expandir macros o includes. A continuación, el código limpio se envía al compilador, que lo convierte en código ensamblador (ASM). El ensamblador transforma este ASM en código binario (0s y 1s). El enlazador finaliza el proceso enlazando las llamadas a funciones para crear un archivo ejecutable. La descompilación, por otro lado, consiste en convertir el código binario de nuevo en un archivo fuente. Los LLM, al estar entrenados con texto, no pueden procesar datos binarios directamente. Por lo tanto, los binarios deben desensamblarse primero con Objdump a lenguaje ensamblador (ASM). Cabe señalar que el binario y el ASM desensamblado son equivalentes, pueden interconvertirse y, por tanto, nos referimos a ellos de forma intercambiable. Finalmente, la pérdida se calcula entre el código descompilado y el código fuente para guiar el entrenamiento. Para evaluar la calidad del código descompilado (SRC'), se comprueba su funcionalidad mediante aserciones de prueba (reejecutabilidad).
Métricas
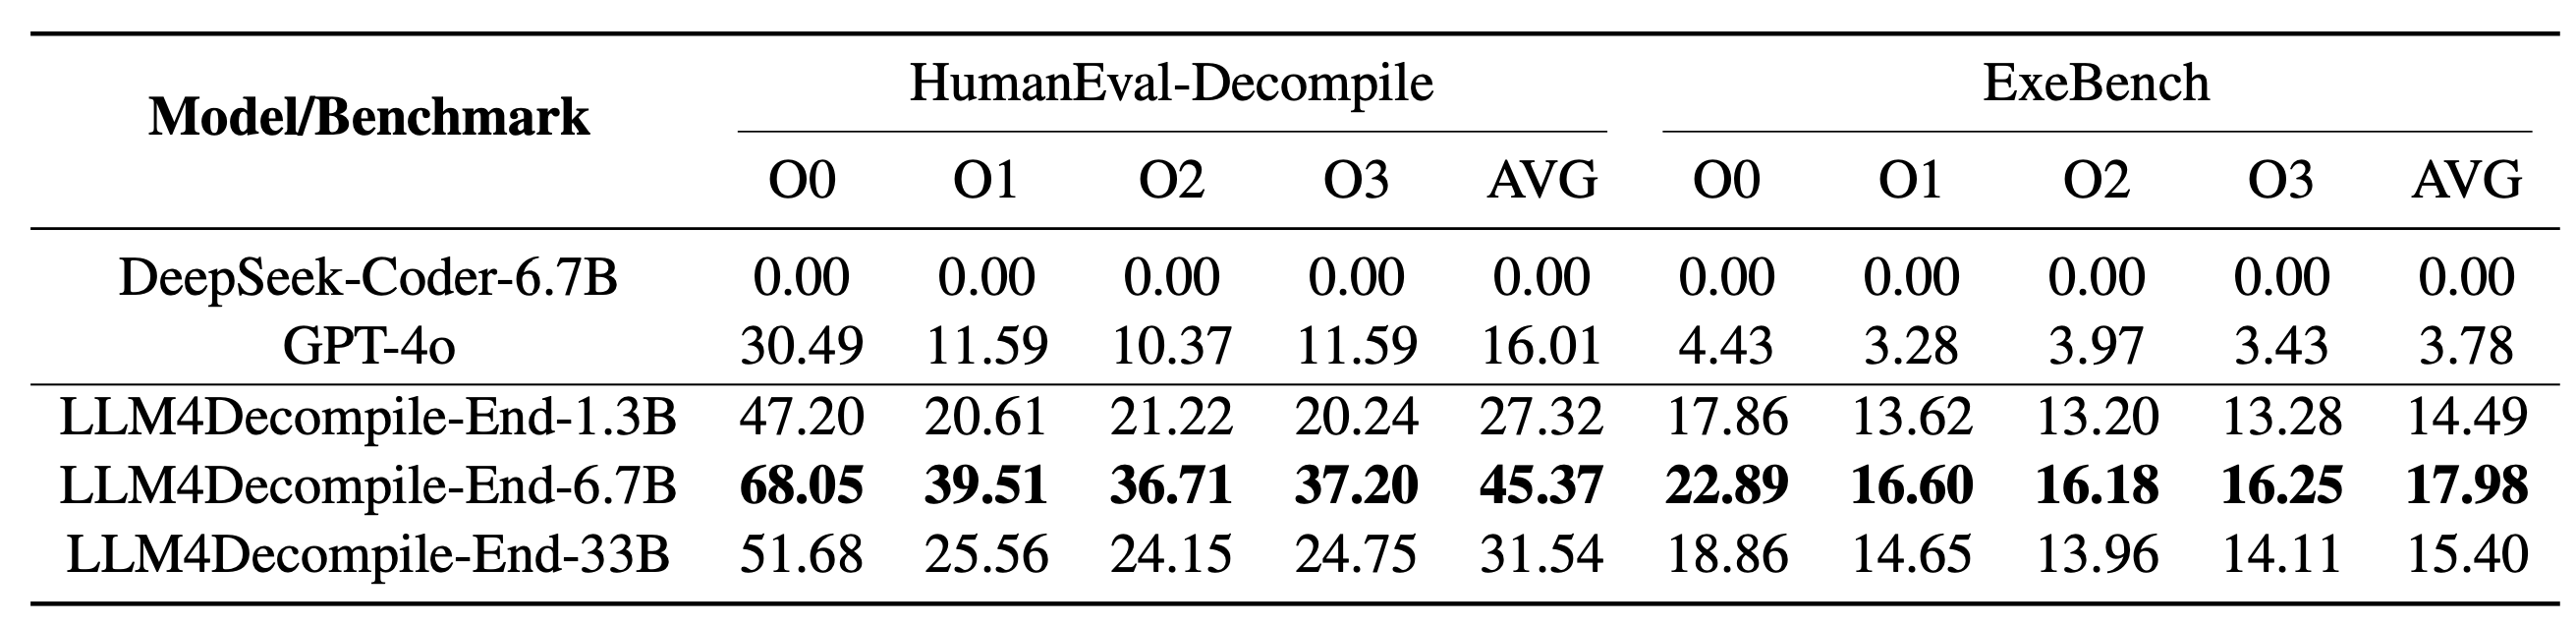
Reejecutabilidad evalúa si el código descompilado puede ejecutarse correctamente y superar todos los casos de prueba predefinidos.
Benchmarks
HumanEval-Decompile: una colección de 164 funciones C que dependen exclusivamente de bibliotecas C estándar.
ExeBench: una colección de 2621 funciones extraídas de proyectos reales, cada una de las cuales utiliza funciones, estructuras y macros definidas por el usuario.
Resultados
Modelos
Nuestro LLM4Decompile incluye modelos con tamaños de entre 1300 millones y 33 000 millones de parámetros, y hemos puesto estos modelos a disposición en Hugging Face.

 albertan017/llm4decompile