

katana v1.7.0
Un framework de crawling y spidering de próxima generación.
Un framework de rastreo y spidering de nueva generación


Características • Instalación • Uso • Alcance • Configuración • Filtros • Únete a Discord
Características
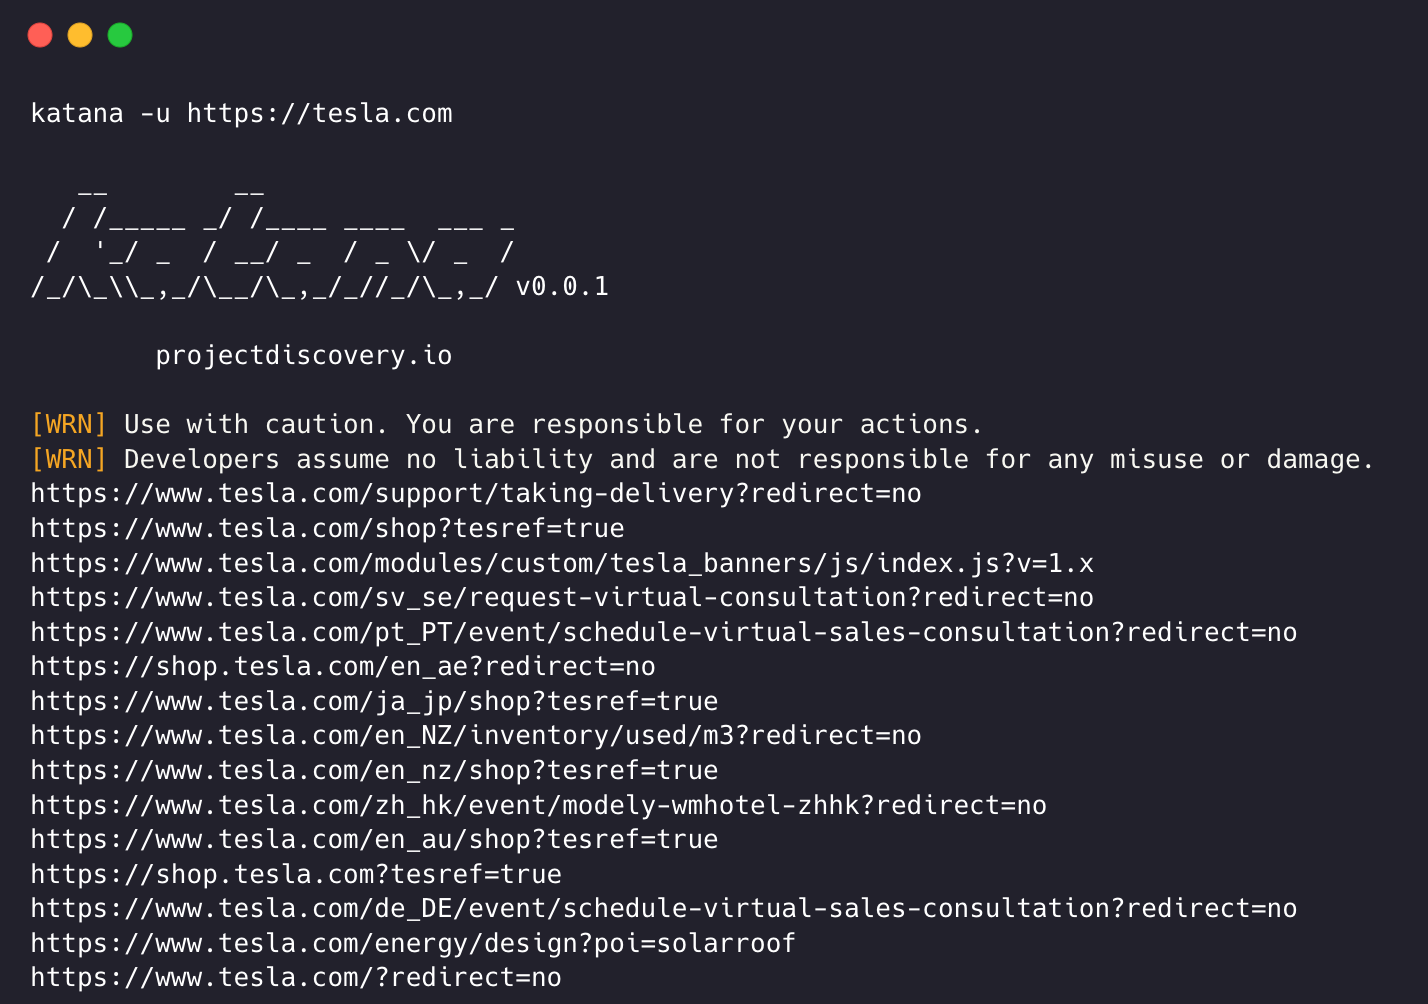
- Rastreo web rápido y totalmente configurable
- Modo Standard y Headless
- Análisis / rastreo de JavaScript
- Relleno automático de formularios personalizable
- Control de alcance - Campo preconfigurado / Regex
- Base de conocimiento - Clasificación de tipo de página / formulario mediante ML (modelo descargado automáticamente)
- Salida personalizable - Campos preconfigurados
- ENTRADA - STDIN, URL y LIST
- SALIDA - STDOUT, FILE y JSON
Instalación
katana requiere Go 1.26+ para instalarse correctamente. Si encuentras algún problema de instalación, recomendamos intentarlo con la última versión disponible de Go, ya que la versión mínima requerida puede haber cambiado. Ejecuta el comando a continuación o descarga un binario precompilado desde la página de releases.```console CGO_ENABLED=1 go install github.com/projectdiscovery/katana/cmd/katana@latest
**Más opciones para instalar / ejecutar katana-**

<details>
  <summary>Docker</summary>

> Para instalar / actualizar docker a la última etiqueta -```sh
docker pull projectdiscovery/katana:latest
Para ejecutar katana en modo estándar usando docker -```sh docker run projectdiscovery/katana:latest -u https://tesla.com
> Para ejecutar katana en modo headless usando docker -```sh
docker run projectdiscovery/katana:latest -u https://tesla.com -system-chrome -headless
Ubuntu
Se recomienda instalar los siguientes requisitos previos -```sh sudo apt update sudo apt install zip curl wget git snapd sudo snap refresh sudo snap install golang --classic
sudo install -d -m 0755 /etc/apt/keyrings
curl -fsSL https://dl.google.com/linux/linux_signing_key.pub
| sudo gpg --dearmor -o /etc/apt/keyrings/google-chrome.gpg
echo "deb [arch=amd64 signed-by=/etc/apt/keyrings/google-chrome.gpg]
http://dl.google.com/linux/chrome/deb/ stable main"
| sudo tee /etc/apt/sources.list.d/google-chrome.list > /dev/null
sudo apt update sudo apt install google-chrome-stable
> instalar katana -```sh
go install github.com/projectdiscovery/katana/cmd/katana@latest
Uso```console
katana -h
Esto mostrará la ayuda de la herramienta. Aquí están todos los modificadores que admite.```console
Katana is a fast crawler focused on execution in automation
pipelines offering both headless and non-headless crawling.

Usage:
  ./katana [flags]

Flags:
INPUT:
   -u, -list string[]     target url / list to crawl
   -resume string         resume scan using resume.cfg
   -e, -exclude string[]  exclude host matching specified filter ('cdn', 'private-ips', cidr, ip, regex)

CONFIGURATION:
   -r, -resolvers string[]       list of custom resolver (file or comma separated)
   -d, -depth int                maximum depth to crawl (default 3)
   -jc, -js-crawl                enable endpoint parsing / crawling in javascript file
   -jsl, -jsluice                enable jsluice parsing in javascript file (memory intensive)
   -ct, -crawl-duration value    maximum duration to crawl the target for (s, m, h, d) (default s)
   -kf, -known-files string      enable crawling of known files (all,robotstxt,sitemapxml), a minimum depth of 3 is required to ensure all known files are properly crawled.
   -mrs, -max-response-size int  maximum response size to read (default 4194304)
   -timeout int                  time to wait for request in seconds (default 10)
   -aff, -automatic-form-fill    enable automatic form filling (experimental)
   -fx, -form-extraction         extract form, input, textarea & select elements in jsonl output
   -retry int                    number of times to retry the request (default 1)
   -proxy string                 http/socks5 proxy to use
   -td, -tech-detect             enable technology detection
   -H, -headers string[]         custom header/cookie to include in all http request in header:value format (file)
   -config string                path to the katana configuration file
   -fc, -form-config string      path to custom form configuration file
   -flc, -field-config string    path to custom field configuration file
   -s, -strategy string          Visit strategy (depth-first, breadth-first) (default "depth-first")
   -iqp, -ignore-query-params    Ignore crawling same path with different query-param values
   -fsu, -filter-similar         filter crawling of similar looking URLs (e.g., /users/123 and /users/456)
   -fst, -filter-similar-threshold int  number of distinct values before a path position is treated as parameter (default 10)
   -tlsi, -tls-impersonate       enable experimental client hello (ja3) tls randomization
   -dr, -disable-redirects       disable following redirects (default false)
   -pcs, -page-content-similar   enable page content similarity filtering (simhash|tfidf|bm25)
   -pcsm, -page-content-similar-mode string  similarity mode: simhash, tfidf, or bm25 (default simhash)
   -pcsd, -page-content-similar-distance int  simhash max hamming distance (default 3)
   -pcst, -page-content-similar-threshold float  tfidf/bm25 min score 0-1 (default 0.85)
   -pcsn, -page-content-similar-budget int  pages to fully process per similarity cluster (default 1)
   -sdd, -similarity-deduplication  alias for -pcs
   -kb, -knowledge-base          enable knowledge base classification
   -kb-secrets                   enable secrets extractor in the knowledge base
   -kb-validate-secrets          validate detected secrets against their provider (sends live API calls)
   -kb-endpoints                 enable endpoints extractor (classifies REST/GraphQL/SOAP/XHR requests)
   -mdp, -max-domain-pages int   maximum number of pages to crawl per domain (default unlimited)

DEBUG:
   -health-check, -hc        run diagnostic check up
   -elog, -error-log string  file to write sent requests error log
   -pprof-server             enable pprof server