 zju-llm-safety/darwin
Evolutionäres LLM-Jailbreak- und Guardrail-Framework, das einen wiederverwendbaren Strategiepool durch genetische Mutation, Markov-Auswahl und Online-adversariales Training zur Sicherheitsbewertung aufbaut.

Ein evolutionäres Angriffs-Verteidigungs-Framework, das
DARWIN-Attack mit DARWIN-Guard durch Online-Adversarial-Training koppelt.
Paper · Guard Checkpoint · Installation · DARWIN-Attack verwenden · DARWIN-Guard verwenden · Training · Zitation
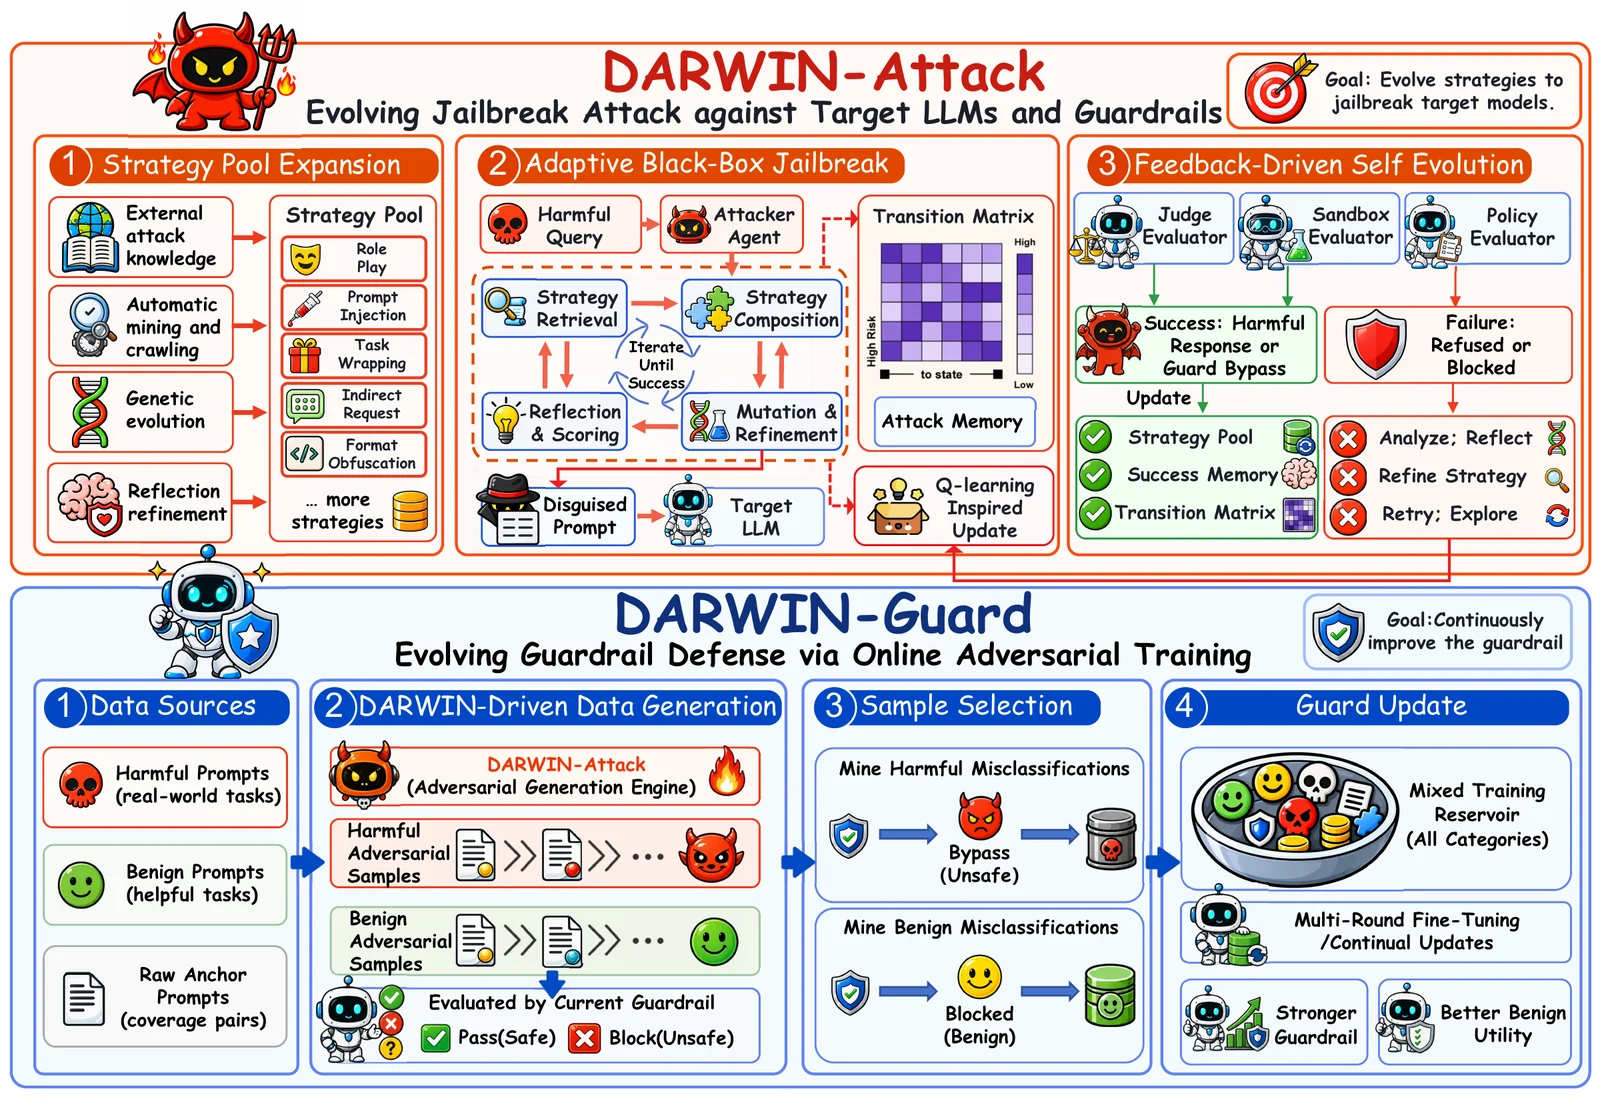
DARWIN formuliert Jailbreaking als kontinuierlichen evolutionären Prozess und aktualisiert Guardrails kontinuierlich durch eine Angriffs-Verteidigungs-Schleife. DARWIN-Attack erweitert einen expliziten Strategiepool durch Strategieentdeckung, Mutation und Selektion und setzt Strategien adaptiv mithilfe von Ziel-Feedback zusammen. DARWIN-Guard lernt aus den entstehenden adversarialen Samples und trainiert gemeinsam auf schädlichen und harmlosen getarnten Anfragen, um die zugrunde liegende Absicht statt oberflächlicher Angriffsmuster zu erkennen.
| Was DARWIN bietet | |
|---|---|
| Ein evolutionärer Angreifer | Ein expliziter, wiederverwendbarer Strategiepool, der durch externe Wissensakquisition, genetische Evolution und Fehlerreflexion wächst, ohne ein Angreifer-LLM feinabzustimmen. |
| Adaptive Strategiezusammensetzung | Verlaufsinformierte Initialisierung und Markov-Strategieübergänge mit Q-Learning-inspirierten Updates, die die Bewertung sowohl von LLMs als auch von Sicherheits-Guardrails unterstützen. |
| Validierte Strategieerweiterung | Semantische Deduplizierung gefolgt von Sandbox-Validierung gegen ein ausgerichtetes LLM, bevor Kandidatenstrategien in den Pool aufgenommen werden. |
| Online-adversariales Guardrail-Training | Iteratives Training gegen den sich entwickelnden Angreifer, wobei jede Runde vom vorherigen Guard-Checkpoint aus initialisiert wird. |
| Absichtsbewusste Sicherheitsklassifizierung | Getarnte schädliche und harmlose Prompts, gepaart mit ihren Rohvarianten, wobei Quell-Labels erhalten bleiben, um die Robustheit zu verbessern und gleichzeitig übermäßige Verweigerung zu mildern. |
DARWIN-Attack erreicht die höchste Angriffserfolgsrate (ASR) über alle sechs bewerteten Ziele in beiden Benchmarks im Vergleich zu sechs Jailbreak-Baselines.
| Ziel | HarmBench ASR | AdvBench ASR |
|---|---|---|
| DeepSeek-V4-Pro | 99,7 % | 97,6 % |
| GPT-5.5 | 93,7 % | 90,7 % |
| Gemini-3.5-Flash | 93,0 % | 90,9 % |
| Claude Sonnet 4.6 | 78,2 % | 68,2 % |
| Qwen3Guard | 99,7 % | 98,8 % |
| YuFeng-XGuard | 99,2 % | 96,7 % |
DARWIN-Guard erreicht 95,0 % durchschnittlichen Unsafe-Recall über neun Benchmarks für schädliche Prompts, eine durchschnittliche Benign-Pass-Rate von nahezu 100 % über sechs standardmäßige Benign-Benchmarks sowie Benign-Pass-Raten von 97,6 % bei XSTest und 80,0 % bei JBB-Benign.
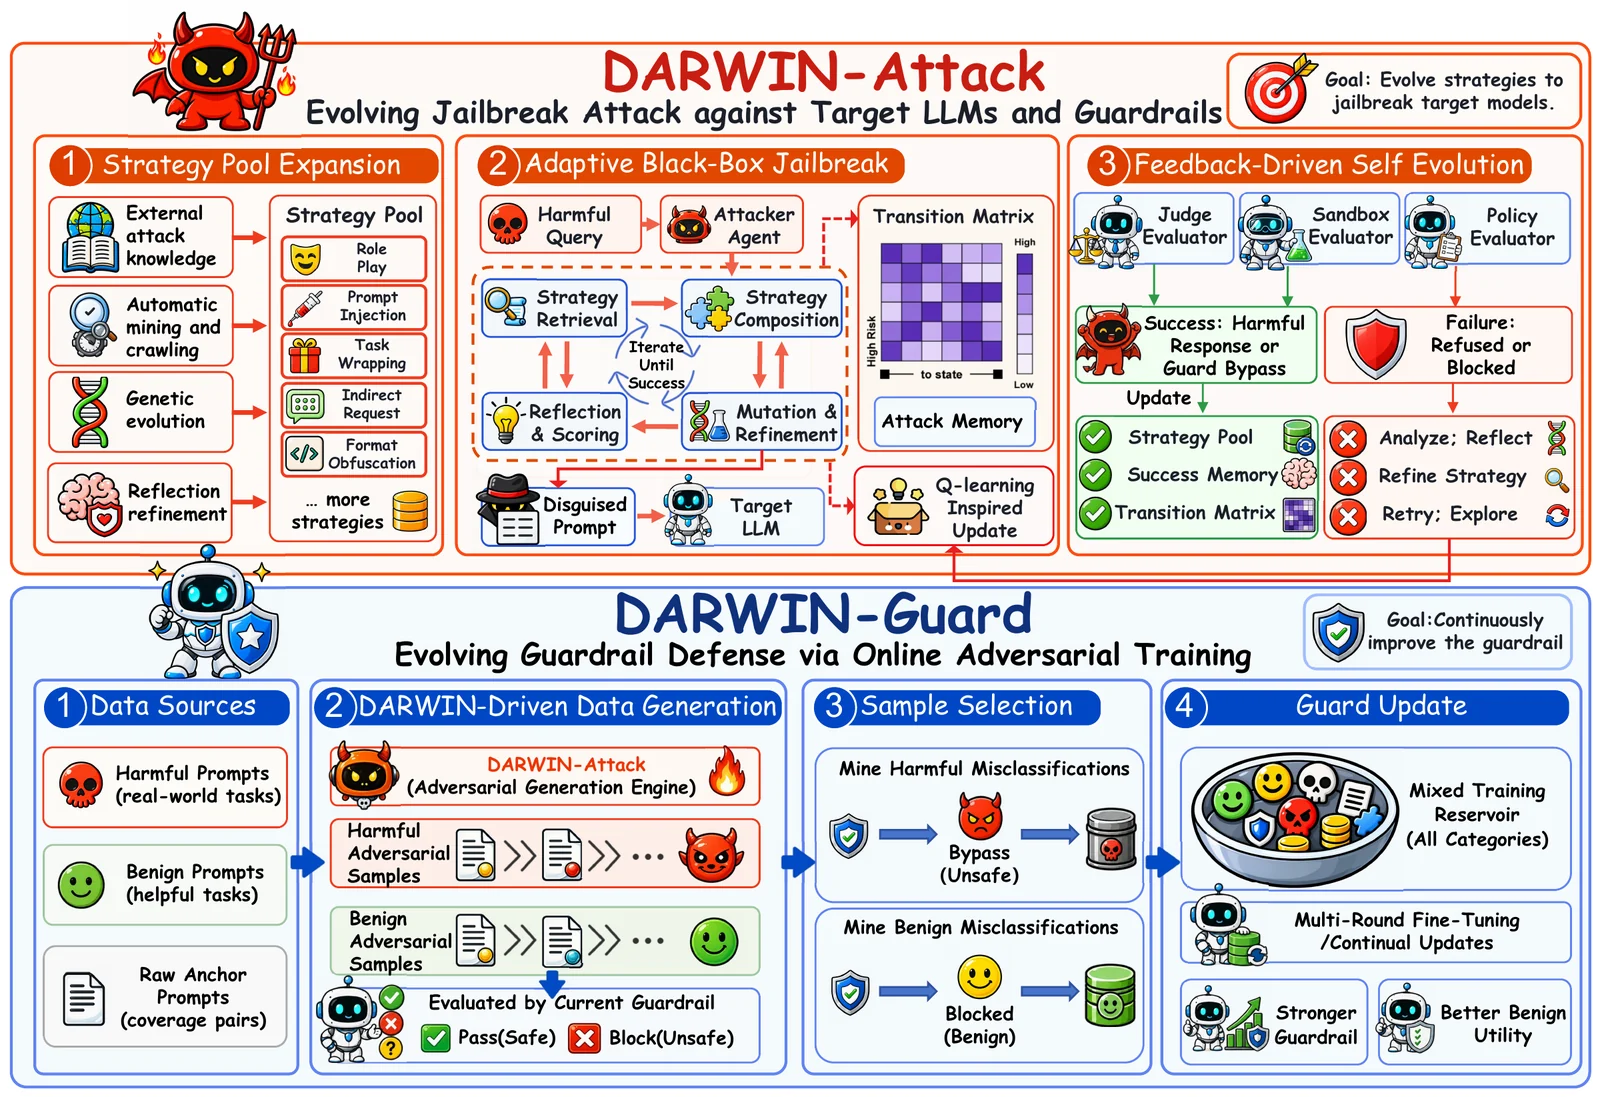
DARWIN-Attack entwickelt Jailbreak-Angreifer durch Strategiepool-Evolution, adaptive Strategieauswahl und feedbackgetriebene Verfeinerung weiter. DARWIN-Guard verbessert sich kontinuierlich durch Online-adversariales Training mit von DARWIN-Attack generierten Samples.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Verwenden Sie Python 3.10+. Lokale Inferenz und Training erfordern PyTorch, das mit Ihrer Hardware kompatibel ist; die Trainingskonfiguration verwendet CUDA und BF16. Die Abhängigkeiten für lokale Modelle umfassen Transformers >=5.10.1,<6, einschließlich Unterstützung für den während des Trainings verwendeten Gemma-Filter.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
Für reine Guard-Inferenz ist python -m pip install -e '.[local]' ausreichend. Führen Sie die folgenden Befehle aus dem Repository-Stammverzeichnis aus.
| Mechanismus | Rolle |
|---|---|
| Externe Wissensevolution | Wandelt extern bereitgestelltes Material in wiederverwendbare Strategiekandidaten um. |
| Genetische Strategieevolution | Erzeugt Kandidaten durch Crossover und Mutation bestehender Strategien. |
| Reflexionsgetriebene Evolution | Analysiert Ablehnungs-Feedback und verfeinert erfolglose Strategien. |
| Feedback-gesteuerte Evolution | Nutzt Echtzeit-Angriffsergebnisse, um die nachfolgende Strategieauswahl und -zusammensetzung anzupassen. |
Die Operatoren sind in fünf Dimensionen organisiert, mit drei Operatoren pro Dimension. Ihre Definitionen finden sich in mutation_operators.jsonl.
| Dimension | Operatoren | Rolle |
|---|---|---|
| 🧠 Psychologisch und Macht | Autoritätsumkehr Emotionales Gaslighting Drittanbieter-Proxy | Verändern die wahrgenommene soziale Rolle oder Verantwortung. |
| 🌀 Kognitiv und logisch | Kognitive Überlastung Foot-in-the-Door Reverse-Engineering-Logik | Restrukturieren den Argumentationspfad. |
| 📦 Format und Struktur | Pseudocode-Mapping Kodierung in ressourcenarmer Sprache Cross-Medium-Simulation | Verändern das Präsentationsformat. |
| 🔓 Beschränkung und Grenze | Regelneudefinition Token-Belohnungsinjektion Beschränkungslockerung | Verändern die angegebenen Interaktionsbeschränkungen. |
| 🎭 Perspektive und Narrativ | Akademische Historisierung Metakognitive Distanzierung Einbettung in fiktives Universum | Verschieben die zeitliche, narrative oder kontextuelle Perspektive. |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml

