 zju-llm-safety/ascent
Fine-Tuning-Framework, das eine First-Order-Optimal-Safety-Kalibrierung und periodische Rekalibrierung auf LLMs anwendet, wobei sicherheitskompatible Aktualisierungen beibehalten und der Nutzen nachgelagerter Aufgaben verbessert werden.

First-Order Optimal Fine-Tuning with Recalibration for Safety–Utility Co-Enhancement
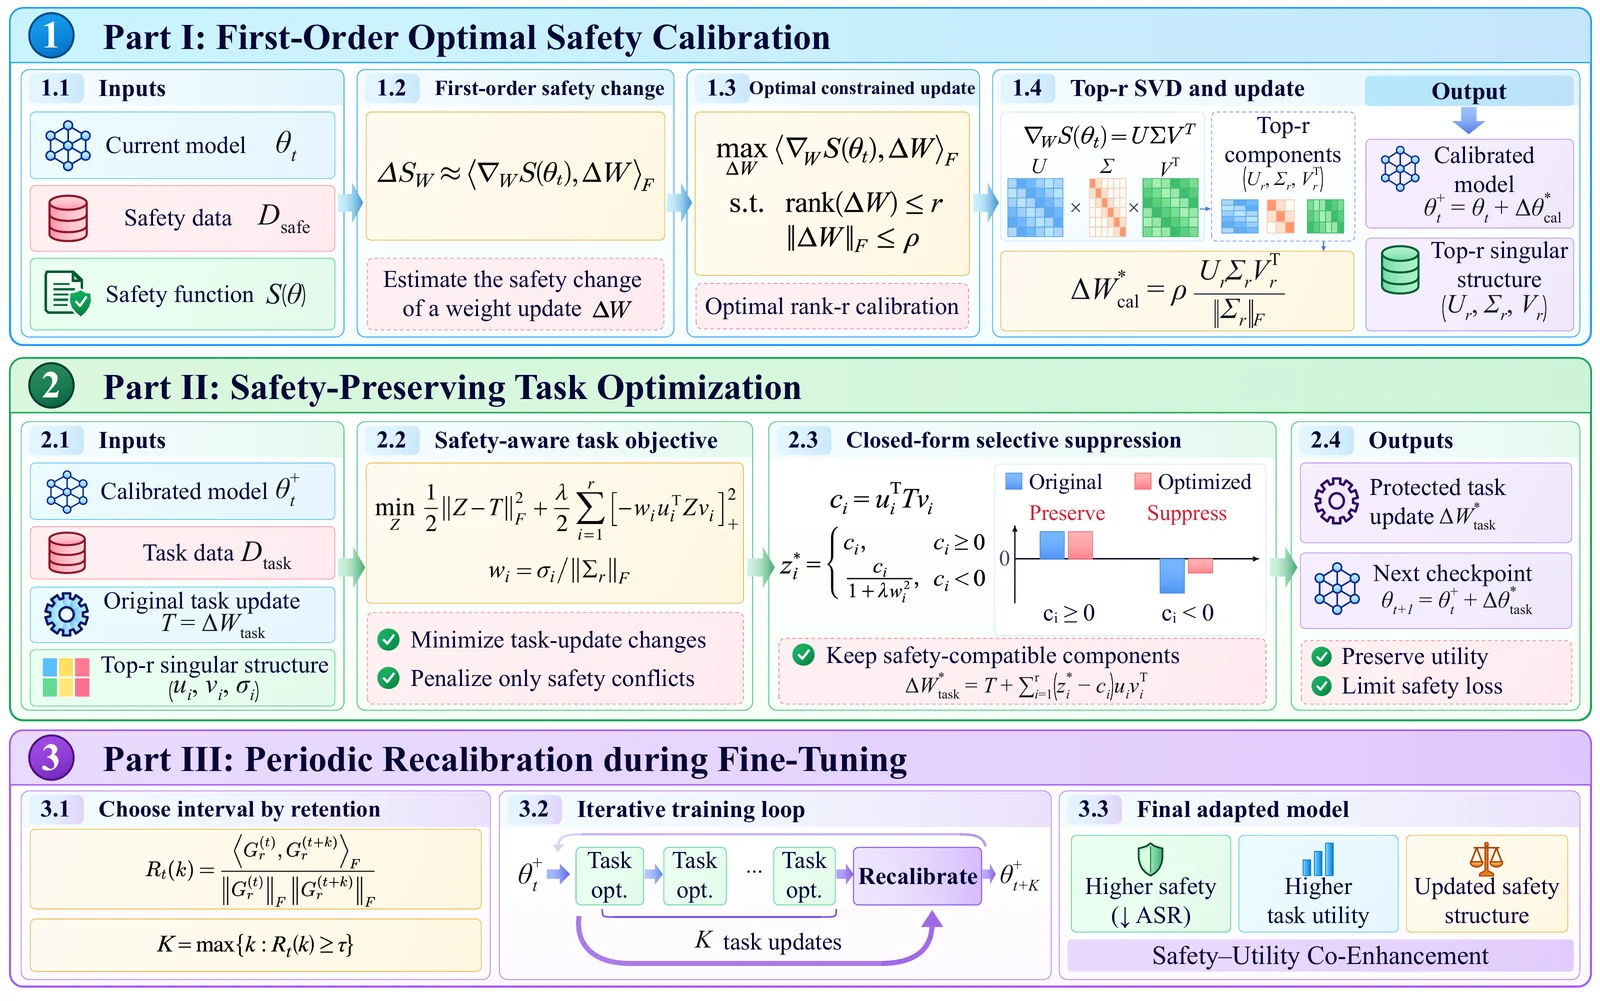
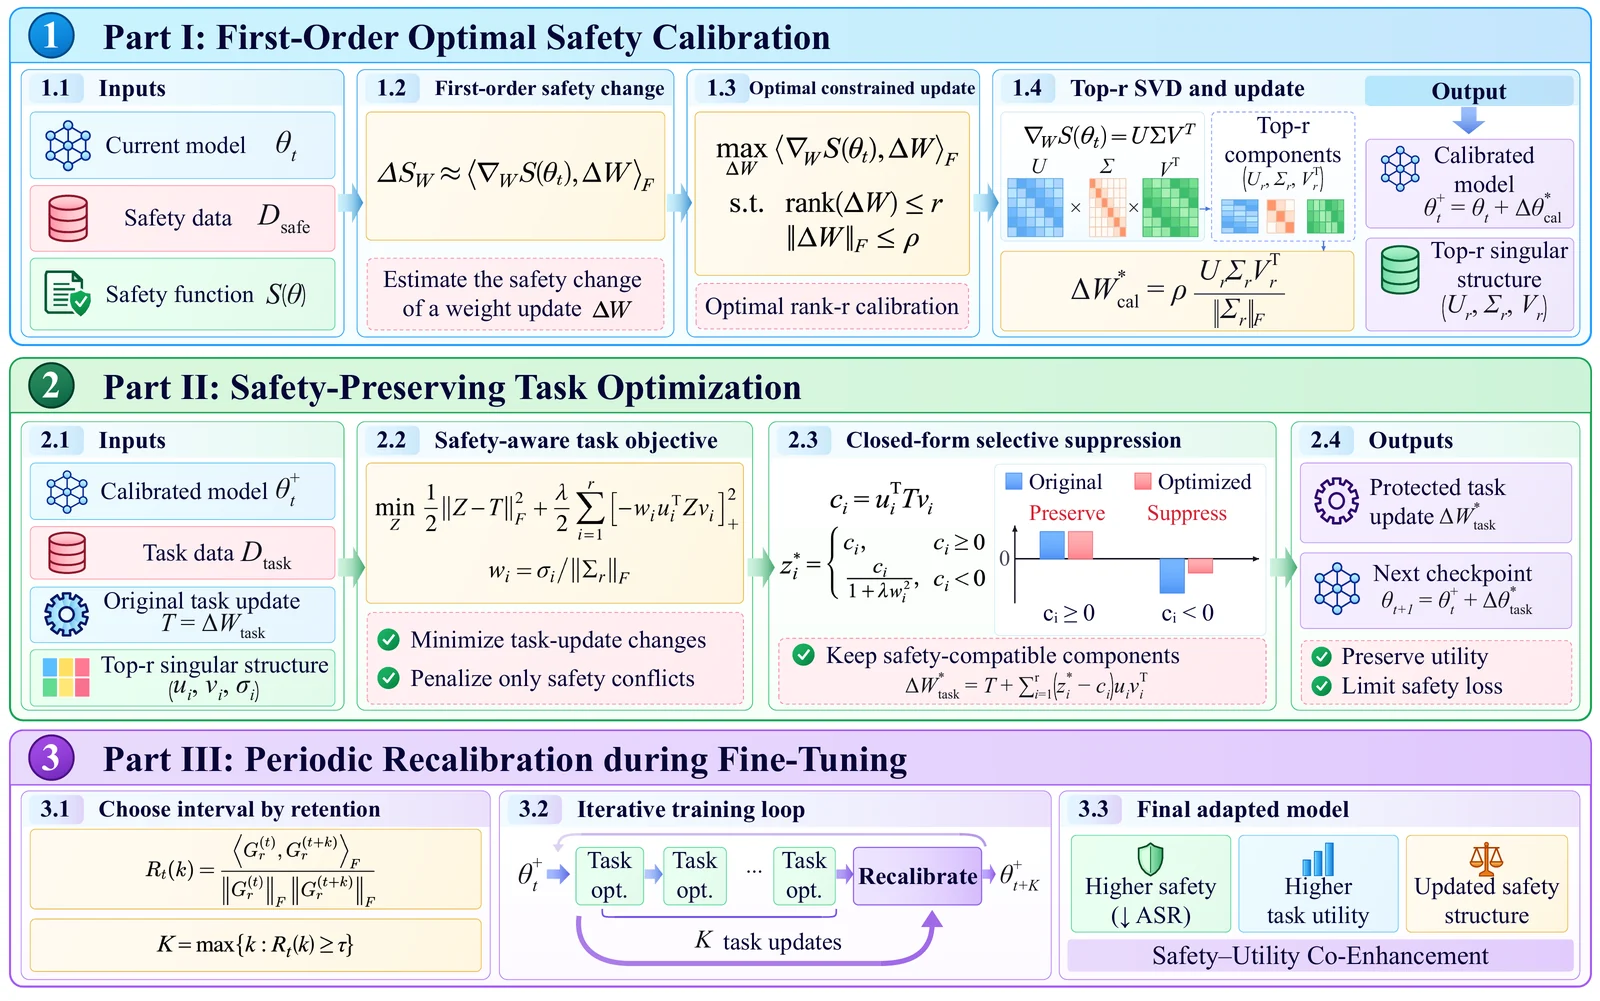
ASCENT leitet ein sicherheitskalibrierendes Update erster Ordnung sowie die zugehörige sicherheitsrelevante Struktur ab, optimiert Downstream-Task-Updates, um sicherheitskompatible Komponenten zu erhalten und sicherheitsbeeinträchtigende zu unterdrücken, und kalibriert diese Struktur während des Fine-Tunings regelmäßig neu, um Sicherheit und Downstream-Nutzen gemeinsam zu verbessern.
Methode · Schnellstart · Daten · Konfiguration · Evaluierung
config.toml festgelegt.Voraussetzungen: Python 3.12 und lokale Modell-Checkpoints. Das Training verwendet zwei CUDA-GPUs, eine für das Zielmodell und eine für Llama Guard; jedes Modell muss auf seine GPU passen.
pip install -r requirements.txt
cp config.example.toml config.toml
Fülle die leeren Werte in config.toml gemäß den Inline-Kommentaren aus und führe dann aus:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
Füge
--executehinzu, um zu trainieren, Antworten zu generieren oder Evaluierungsergebnisse zu speichern.
Wähle ein neues Ausgabeverzeichnis außerhalb des Repositorys mit Platz für Checkpoints. Das Training gibt am Ende den Pfad des final zusammengeführten Modells aus.
Stelle JSON-Arrays mit den konfigurierten Datensatzanzahlen bereit:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, mit disjunkten Train-/Test-Eingaben.| Datensatz | Erforderliche Felder |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business oder Sci/Tech |
| GSM8K | question, answer mit einer ####-Endantwort |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], vier choice_texts, answer_key: A–D |
| HarmBench | nur goal; optional id, source; keine gespeicherten Antworten |
Lege dein Modell, deine Task und deine Hyperparameter in config.toml fest. Modellladen und Matrixauswahl folgen model.key.
Verwende evaluate.py für beide Modi; die Generierung erfordert ein vollständig zusammengeführtes lokales Modell. Stelle deine eigenen Daten und externen Sicherheitsbewertungen bereit. Es sind keine Datensätze, kein Online-Judge und keine API-Konfiguration enthalten.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
Tasks: samsum, agnews, gsm8k, openbookqa. Die Metriken sind ROUGE-L für SAMSum und Genauigkeit/Exact Match für die anderen, angegeben als Prozentsätze. Um gespeicherte Antworten zu bewerten, ersetze --model-path durch --responses /path/to/responses.json.
Stelle feste Prompts als Datensätze mit id, goal und optional prompt bereit (standardmäßig goal). Halte das ursprüngliche schädliche Ziel getrennt vom Angriffs-Prompt.
Antworten generieren:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
Externe Bewertungen aggregieren:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
Bewertungen sind JSON-Datensätze { "id": "...", "score": 1 }, unter Verwendung der Antwort-IDs und Bewertungen 1–5 (null für fehlgeschlagene Beurteilungen). Bewertungen 4–5 zählen als erfolgreiche Angriffe; verwende --success-threshold 5, um nur 5 zu zählen. Fehlende oder fehlgeschlagene Beurteilungen ergeben keine finale ASR.
Für beide Modi werden Eingaben, die nach der Chat-Formatierung --max-input-tokens überschreiten, abgelehnt, nicht abgeschnitten. Setze das Limit innerhalb der Kontextkapazität des Modells und lasse Platz für generierte Tokens.
