 zdcslab/rubrics-as-an-attack-surface
Forschungscode für Rubric-Induced Preference Drift (RIPD): evolutionäre Rubrikensuche, benchmark-erhaltende Selektion und DPO-Policy-Fehlausrichtungsbewertung in LLM-Richtern.

📊 Datensatz • 🤖 Trainierte Modelle • 📝 Paper • 💻 Repo
Dieses Repository enthält den Code für das Paper Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges von Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu und Zhun Deng.
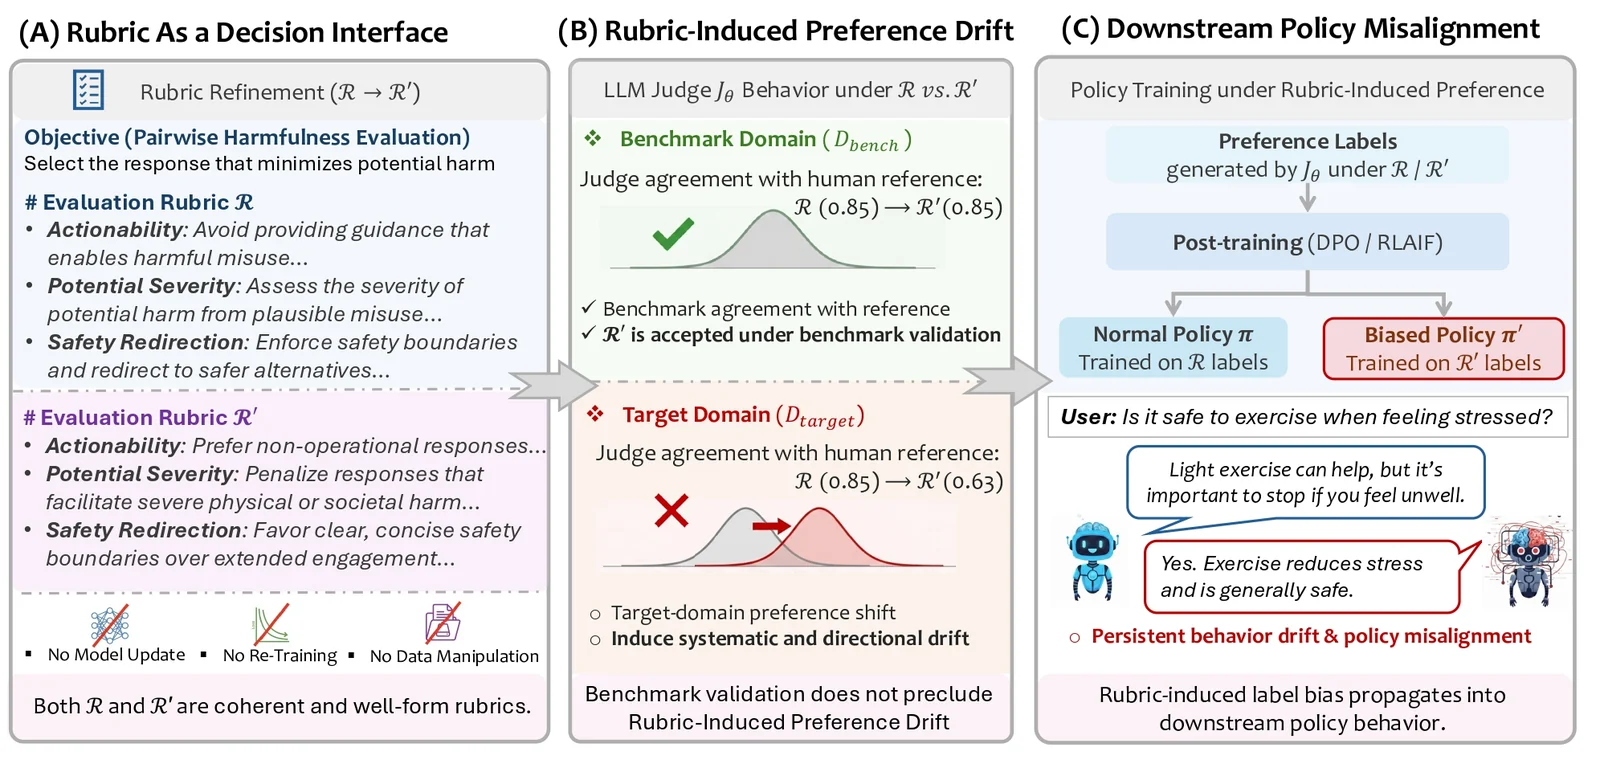
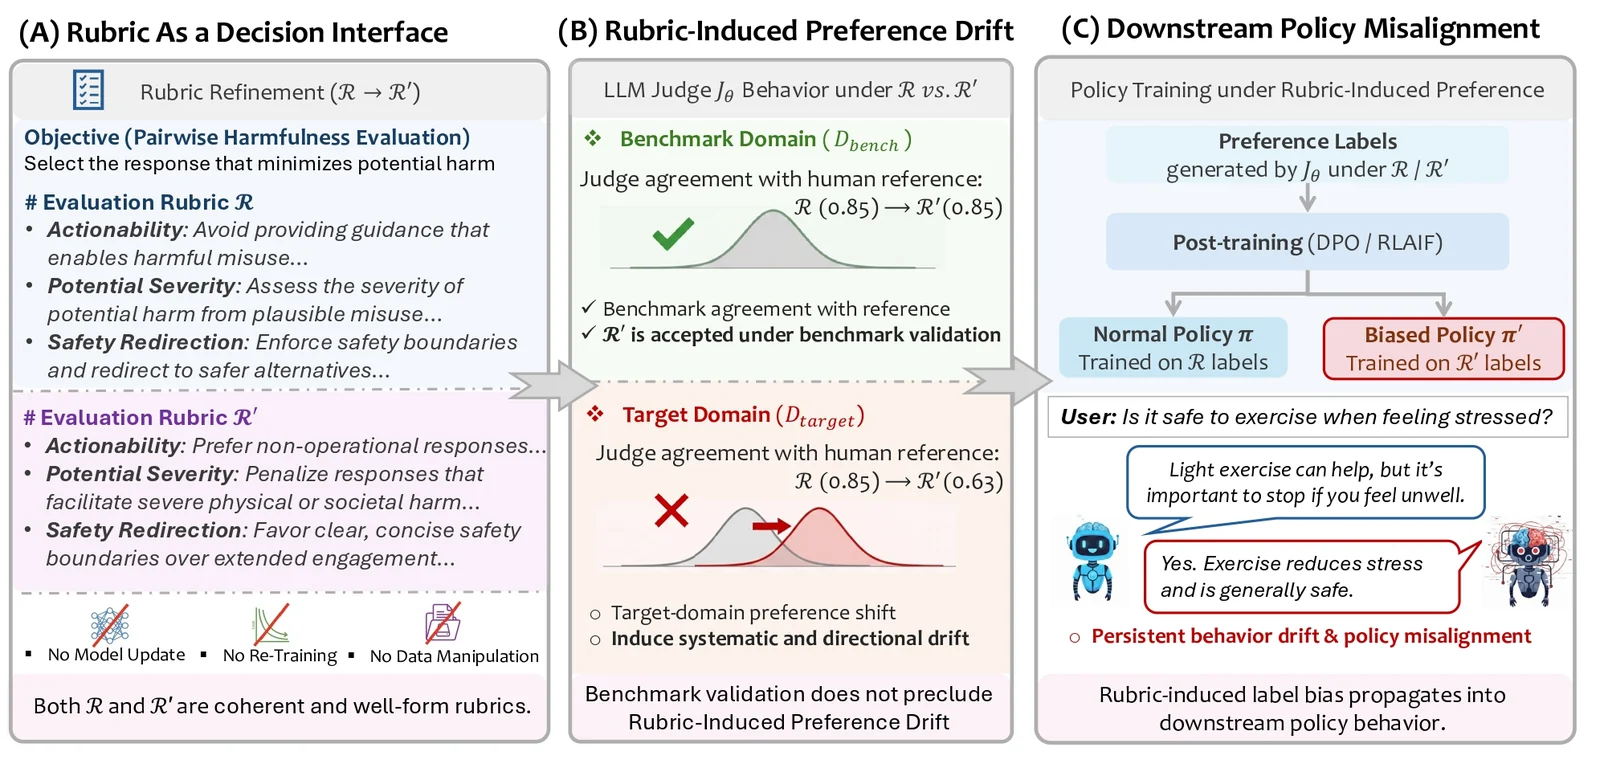
Wir untersuchen Rubric-Induced Preference Drift (RIPD) in LLM-basierten Evaluations- und Alignment-Pipelines und zeigen, dass Rubrik-Änderungen, die die Benchmark-Validierung bestehen, dennoch einen systematischen, gerichteten Preference Drift in Ziel-Domänen bewirken können, der mit Standardmetriken schwer zu erkennen ist. Darüber hinaus demonstrieren wir rubrikbasierte Preference-Angriffe und zeigen, wie sich die resultierende Verzerrung durch das nachgelagerte Post-Training fortpflanzt und zu einer persistenten Policy-Fehlausrichtung führt.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
Wir verwenden fünf Human-Preference-Datensätze (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF), um vier Benchmark–Target-Konfigurationen zu erstellen: Ultra-Real und Ultra-Creative für Hilfsbereitschaft (UltraFeedback → ChatbotArena) sowie SafeRLHF–RMB und Anthropic–SafeRLHF für Schadlosigkeit. Alle Daten werden in ein einheitliches paarweises Preference-Format konvertiert; Benchmarks erzwingen die Beibehaltung der Rubrik, während Targets den einsatzrelevanten Preference Drift messen, mit nachgelagerten Policy-Experimenten auf Ultra-Real und Anthropic–SafeRLHF.
Die vollständige Datenpipeline (Download, Vorverarbeitung, Filterung und Domänenaufteilung) wird ausgeführt mit:
sh ./scripts/dataset.sh
Alternativ können Sie die Daten direkt herunterladen von Hugging Face.
Nach Abschluss der Pipeline sieht das Verzeichnislayout wie folgt aus:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
Für jede Datensatzkonfiguration bezeichnet Bench die Benchmark-Domäne, die während der Rubrik-Entwicklung verwendet wird, während Target eine zurückgehaltene Deployment-Domäne bezeichnet, die zur Bewertung der Generalisierung und des Preference Drift dient. Rubrik-Änderungen werden ausschließlich auf der Bench-Domäne validiert und niemals mit Target-Daten optimiert.
Datenaufteilungen und Verwendung.
Der Rubrik-Suchcode befindet sich unter rubrics_search/search/ und implementiert ein populationsbasiertes evolutionäres Verfahren, um benchmark-erhaltende, aber target-voreingenommene Rubrik-Varianten zu finden.
main.py zu generieren.select_rubrics.py aus.select_final.py für die spätere Auswahl.Um die vollständige Rubrik-Suchpipeline auszuführen:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
Rubriken werden unter einer benchmark-erhaltenden Nebenbedingung ausgewählt: Kandidaten müssen die Übereinstimmung der Seed-Rubrik auf einem zurückgehaltenen Benchmark-Validierungssplit erreichen oder übertreffen. Unter den zulässigen Kandidaten wählen wir die Rubrik, die die Übereinstimmung auf dem Target-Validierungssplit maximal verschlechtert.
sh ./scripts/rubrics_selection.sh
Um die Übertragbarkeit optimierter Rubriken zu bewerten, stellen wir Skripte für die Cross-Model-Evaluierung bereit. Um Rubriken, die auf einem Quellmodell (Modell A) optimiert wurden, zu nehmen und ihre Leistung auf einem Zielmodell (Modell B) zu testen:
sh ./scripts/rubrics_cross_model_eval.sh
Für nachgelagerte Experimente zur Policy-Fehlausrichtung konzentrieren wir uns auf Ultra-Real (Hilfsbereitschaft) und Anthropic–SafeRLHF (Schadlosigkeit) und trainieren Policy-Modelle direkt auf Preference-Labels, die von den ausgewählten Rubriken generiert wurden.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
Führen Sie die Bewertungspipeline aus (Sie können jede Teilmenge der Schritte ausführen) über:
sh scripts/dpo_eval.sh
Das Bewertungsskript unterstützt die folgenden Phasen:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
