 xoreaxeaxeax/skitter-creek-bath-salts
Alles auf der CPU mit DRAM-Scrambling freischalten

Alles freischalten auf der CPU mit DRAM-Scrambling — PSP, C6, Microcode, SMM und alles andere, was die Spezifikationen ausgelassen haben.
&x == &x.
Normalerweise.
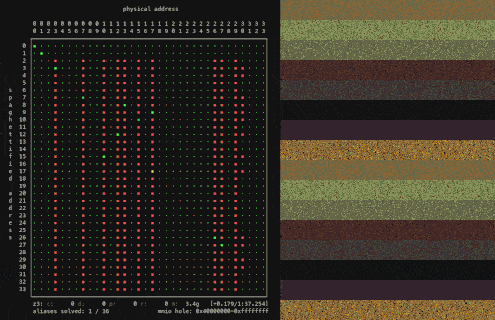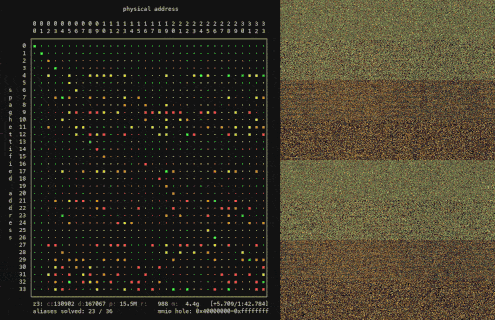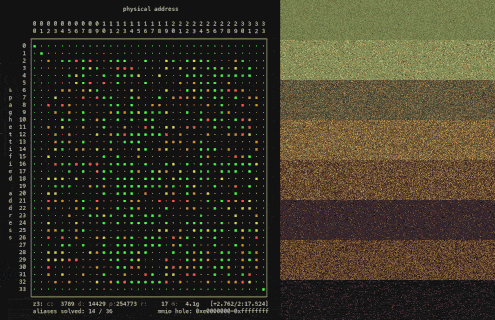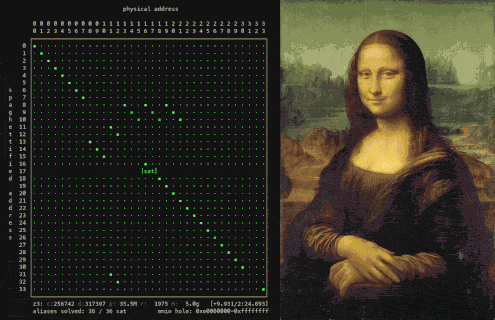
Stupse den DRAM-Controller an, und eine Adresse kann dazu gebracht werden,
überall im Speicher zu landen, wo du willst. skitter-creek-bath-salts
modifiziert die untersten Schichten der Speicherhierarchie, um die physischen
DRAM-Adressübersetzungen neu zu verdrahten. Dies verwürfelt den
Plattformspeicher und legt geschützte Bereiche des DRAM offen — Carveouts, die
sogar für den Kernel unsichtbar sind. Wenn die Adressübersetzungen brechen,
brechen auch die darauf aufbauenden Sicherheitsprimitive, und wir schalten
alles frei.
Entwickelt und getestet auf AMD Family 16h CPUs, der letzten Generation,
deren Datenblätter die Übersetzungsregister des DRAM-Controllers dokumentieren —
und zeigen, dass sie nicht gesperrt werden können. 17h und darüber lassen diese
Informationen einfach weg. Die Odyssee von *p ist über
Generationen und Architekturen hinweg ähnlich, und die zugrunde liegenden
Transformationen erstrecken sich sogar auf ARM, RISC-V und darüber hinaus;
skitter-creek-bath-salts zeigt uns nur, wie man beginnt.
*pEs ist ein weiter Weg nach unten.
Speicher ist auf Schichten der Abstraktion aufgebaut, die so tief sind, dass sie
fast absurd werden. Wenn dein Code *p dereferenziert, scheint er auf den DRAM
bei p zuzugreifen. Tut er aber nicht — p ist eine virtuelle Adresse, und
bevor auch nur ein einziges Bit des DRAM berührt wird, muss sie den Spießrutenlauf
unten überstehen:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
Dieses Projekt arbeitet auf den tiefsten Ebenen der `*p`-Pipeline, der MCT/DCT-Schicht
— wo eine physische Adresse aus dem Data Fabric/Interconnect in den Speicher-
controller eintritt und ein letztes Mal in die rohen DRAM-Koordinaten umgeschrieben wird, die
an das DIMM ausgegeben werden.

---

## DRAM verstricken

> Physische Adressen sind wirklich eher ein Vorschlag.```nasm
xor dword [0xf80c2094], 0x00400000
Das ist der Exploit. Alles davon.
