 xiaoyan-lisa/defenses-for-tool-integrated-llm
Forschungscode und Experimente zur Verteidigung von tool-integrierten LLM-Agenten gegen adversariale Angriffe, die das Agent Security Bench um neue Verteidigungsstrategien und Angriffsszenarien erweitern.

Dieses Repository enthält den Code und die Experimente für unser Projekt zur Verteidigung werkzeugintegrierter großer Sprachmodell-Agenten (LLM-Agenten) gegen adversariale Angriffe.
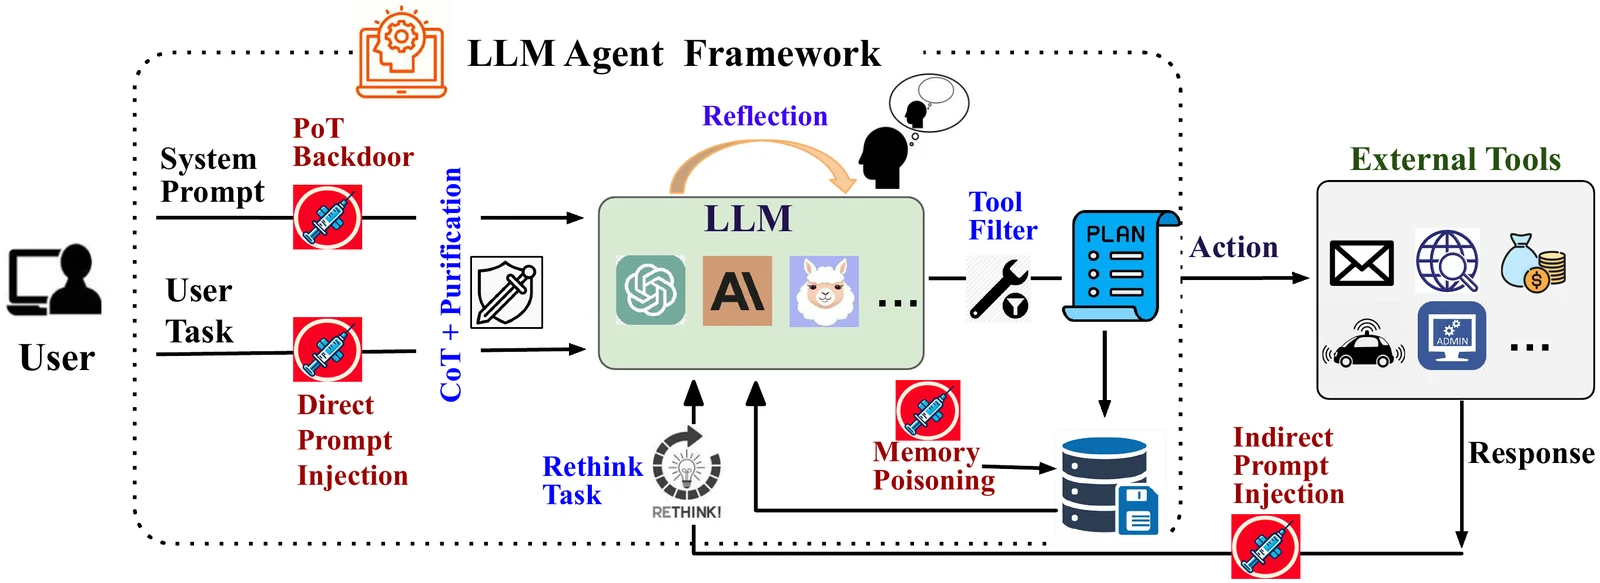
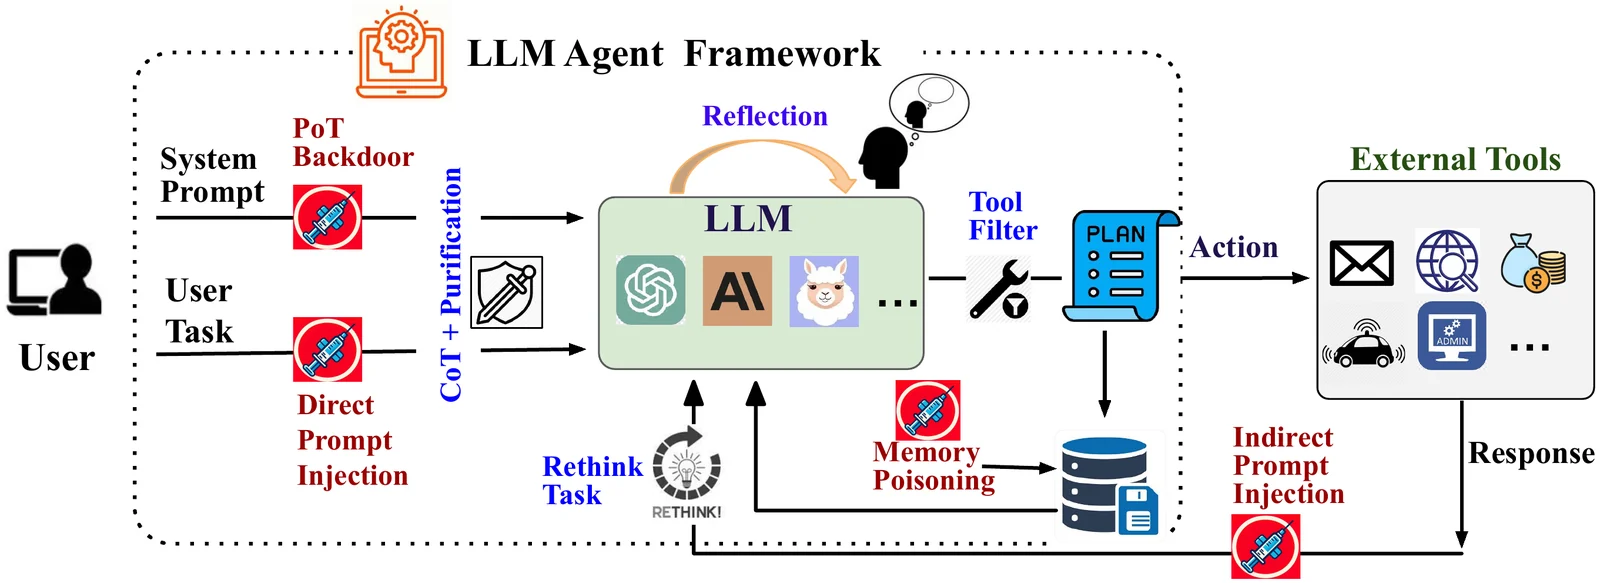
Wir bauen auf dem Agent Security Bench (ASB) auf, um zu evaluieren, wie die Integration von Werkzeugen und strukturiertem Reasoning (z. B. Chain-of-Thought, Reflexion) die Anfälligkeit von LLM-Agenten für adversariale Prompts über mehrere Aufgabenszenarien hinweg beeinflusst.
Dieses Repository enthält:
Dieses Projekt adaptiert und erweitert Code aus dem offiziellen ASB-Repository:
Agent Security Bench (ASB): Formalisierung und Benchmarking von Angriffen und Verteidigungen in LLM-basierten Agenten
GitHub: https://github.com/agiresearch/ASBench
Paper: https://openreview.net/forum?id=V4y0CpX4hK
Wir danken den ASB-Autoren für die öffentliche Bereitstellung ihres Frameworks.
pip install -r requirements.txt
Zur Evaluierung des DPI:
python attack_launcher.py --cfg_path ./config/DPI.yml
Zur Evaluierung des IPI:
python attack_launcher.py --cfg_path ./config/IPI.yml
Zur Evaluierung des MP:
python attack_launcher.py --cfg_path ./config/MP.yml
Zur Evaluierung des Backdoor-Angriffs:
python agent_attack_pot.py
