 ucsb-mlsec/vulnllm-r
Spezialisiertes Reasoning-LLM zur Erkennung von Schwachstellen im Quellcode in C/C++ und Python, mit Datensatzerstellung, SFT/DPO-Training und Skripten zur Reproduktion der Ergebnisse.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
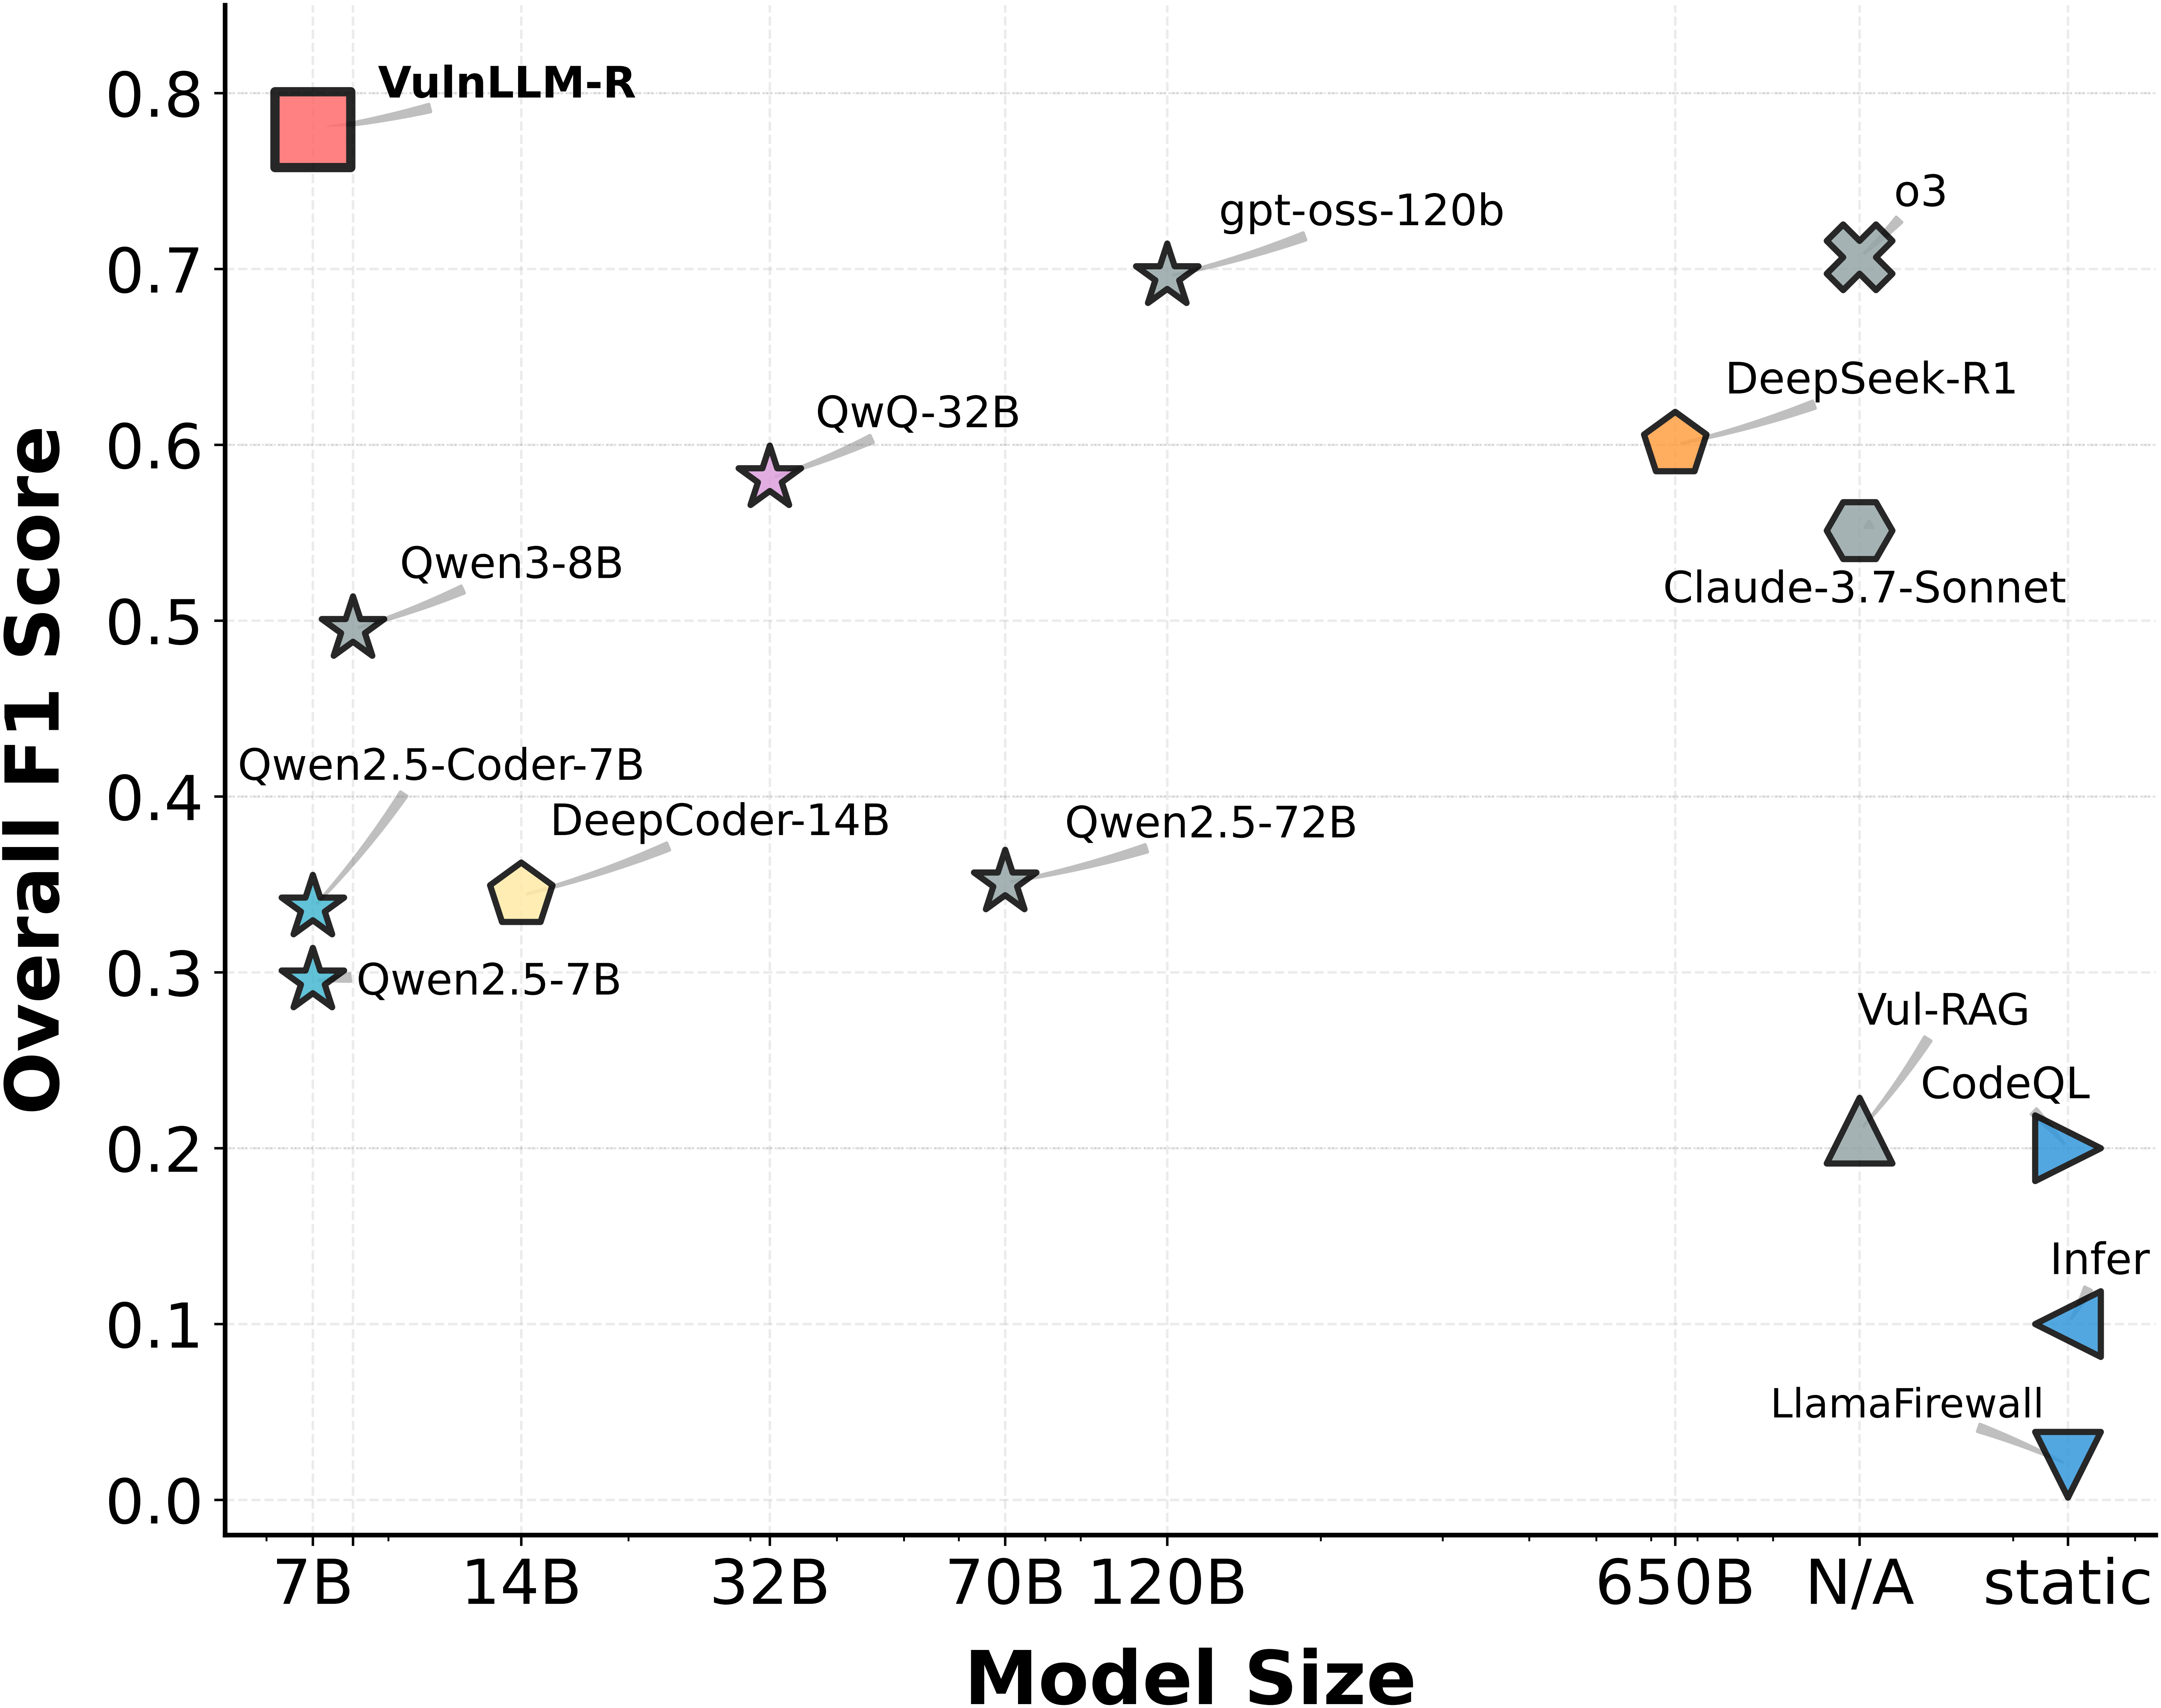
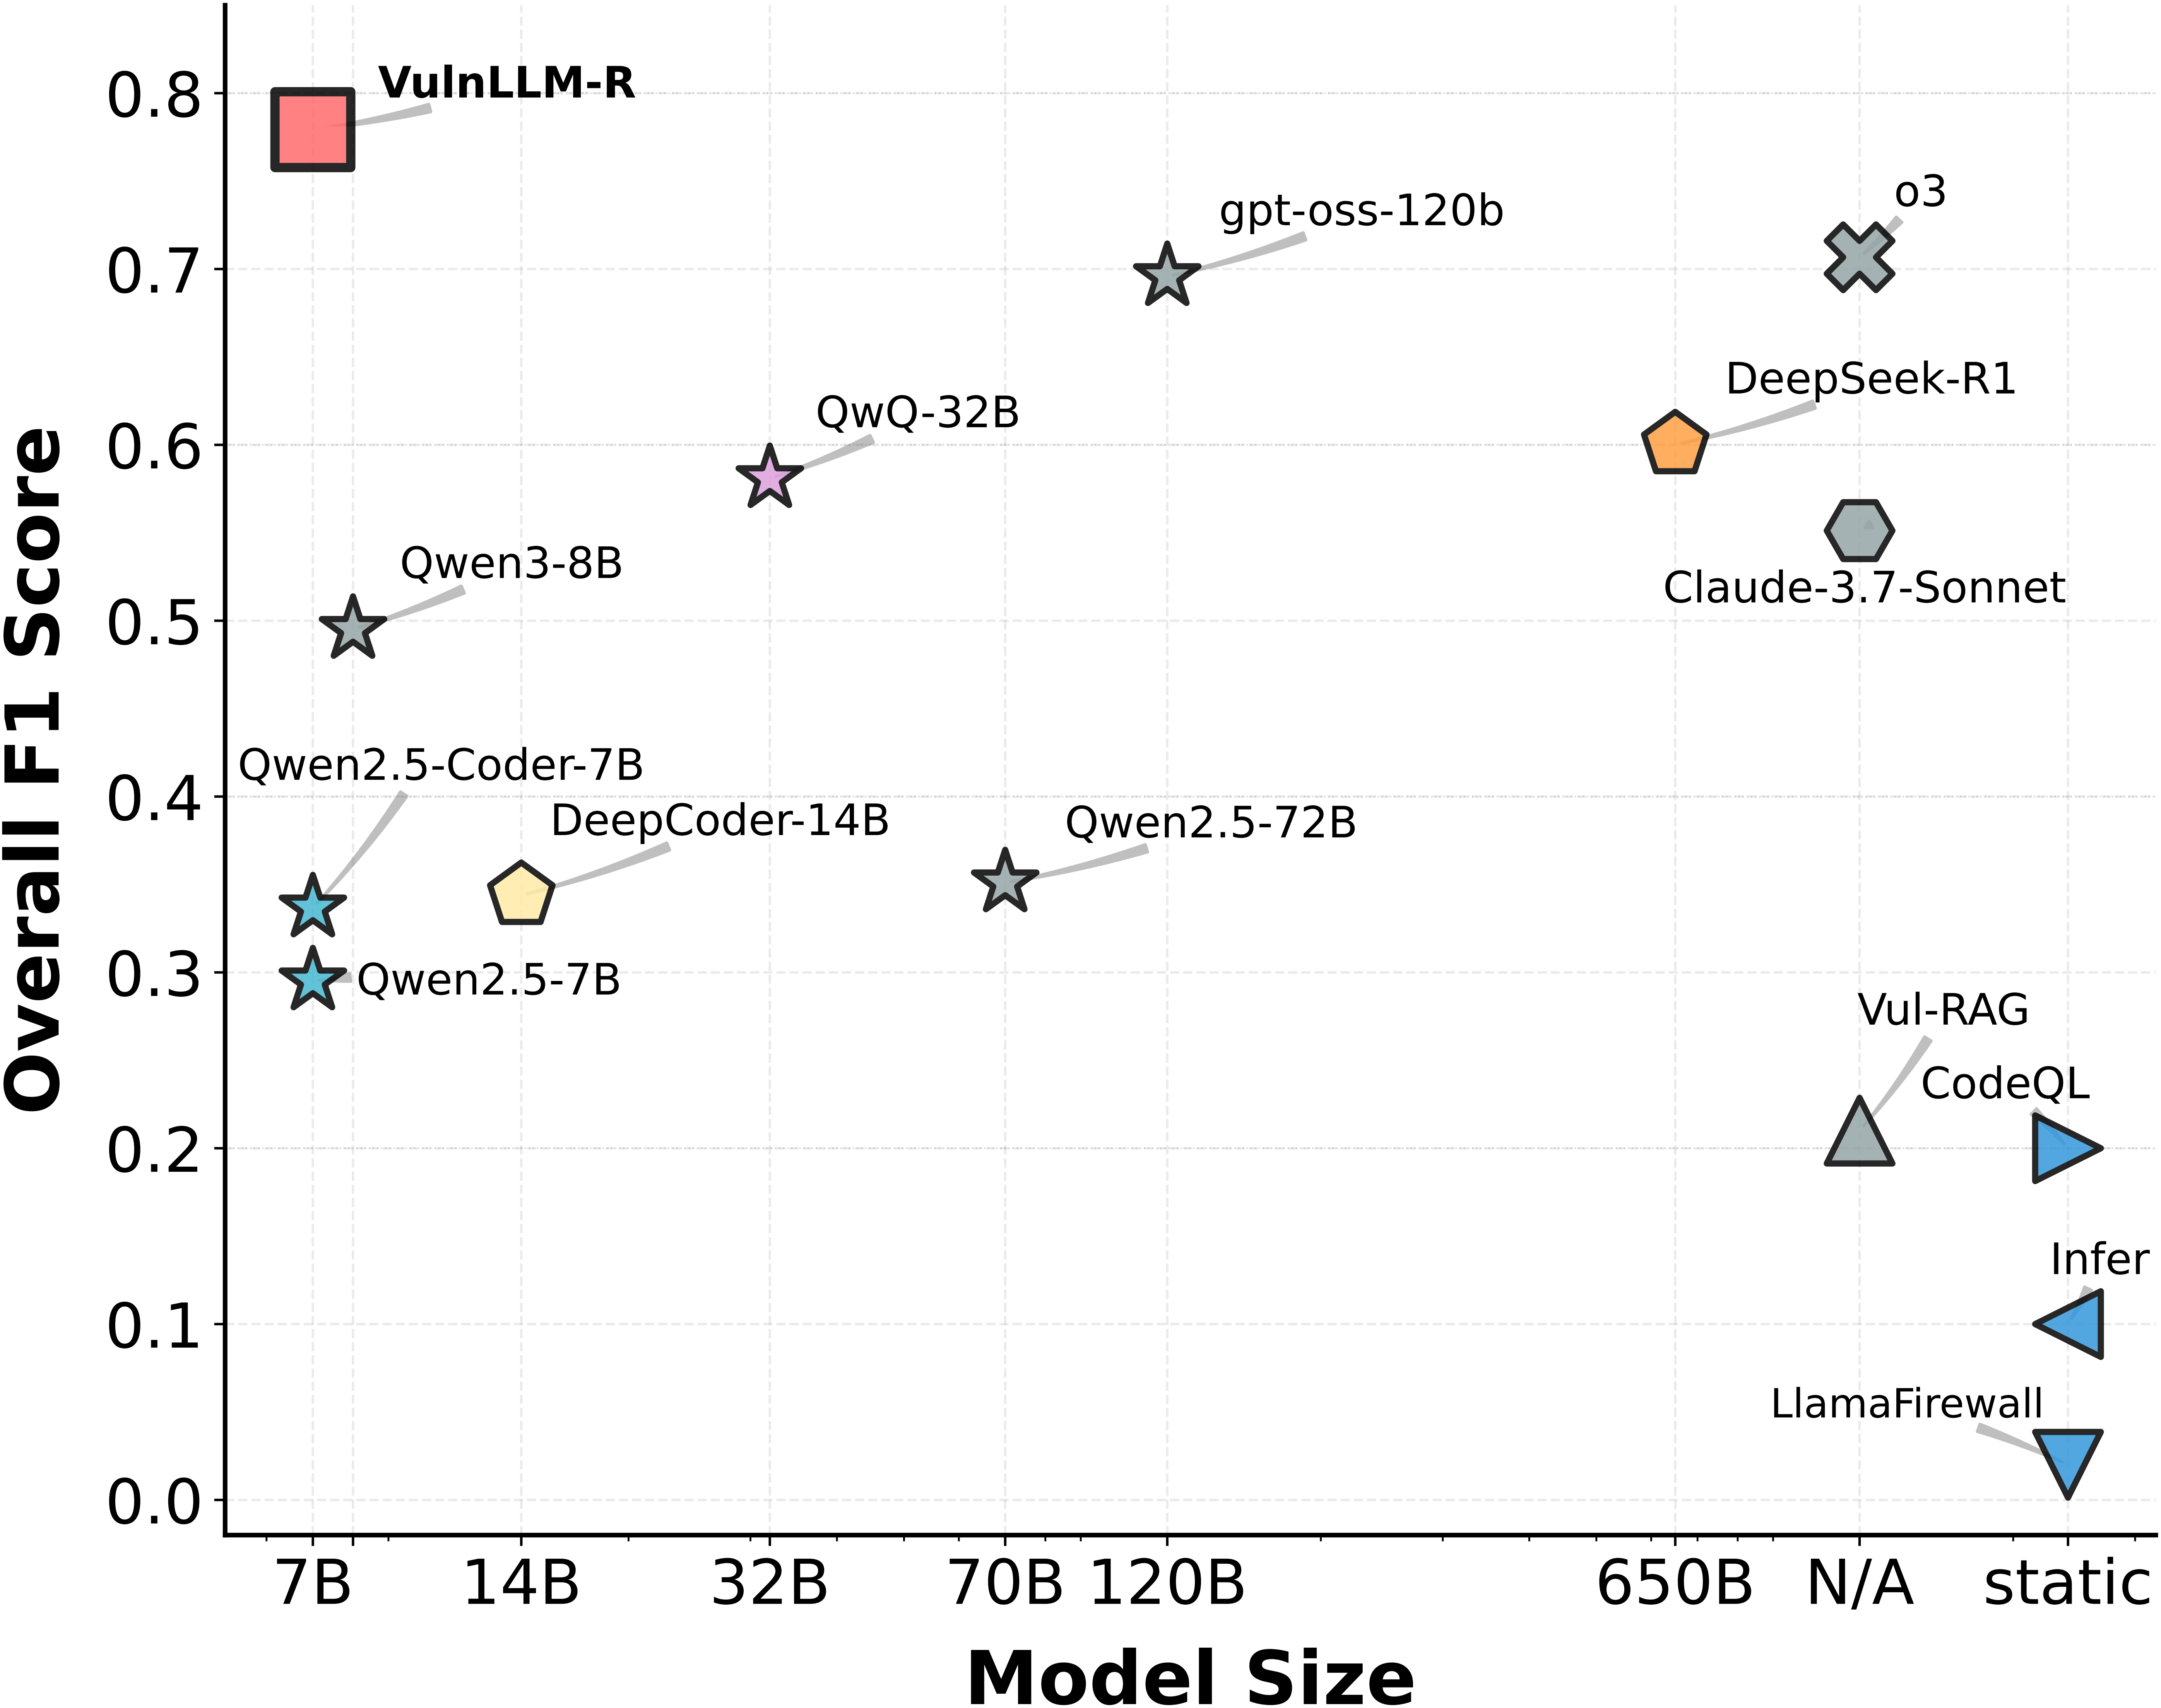
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
Wir stellen außerdem die reduzierte Reasoning-Version der destillierten Datensätze bereit:
Führen Sie die vorhandenen Datensätze zur Erkennung von Schwachstellen auf Funktionsebene zusammen: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4] und Arvo [5]. Von diesen Datensätzen enthält PrimeVul die komplexesten Funktionen. Wir erstellen zwei Trainingssätze: clean (ohne PrimeVul) und noisy (mit PrimeVul), sodass wir mit relativ einfachen Datensätzen trainieren und auf dem komplexen PrimeVul-Datensatz testen können. Beachten Sie, dass die Benennung des Trainingssatzes mit PrimeVul als noisy nicht bedeutet, dass der Datensatz verrauscht ist. Es ist ein relativ willkürlicher Name, den wir am Anfang verwendet haben.
vulscan/data_process/data_utils eine Reihe von Skripten
zum Verarbeiten und Zusammenführen der Datensätze.
raw_to_us.py: Führt die Rohdaten in unseren Datensatz zusammen und entfernt redundante Datencheck_cwe_correct.py: Berechnet die Genauigkeit für jede CWE-Kategoriegenerate_arvo_raw_data.py: Erzeugt strukturierte Rohdaten aus dem Arvo-Datensatzarvo_to_us.py: Formatiert strukturierte Arvo-Rohdaten in unser Datensatzformat umsplit_good_bad_for_juliet.py: Extrahiert Daten aus dem rohen Juliet-1.3-Datensatz und konvertiert sie in das
erforderliche Format, das Teil unseres C-Clean-Datensatzes istadd_sven_to_clean_dataset.py: Extrahiert Daten aus dem Sven-Datensatz, die Teil unseres C-Clean-Datensatzes sindsync_large_small.py: Synchronisiert die Änderungen von noisy_dataset/large_train/c nach
noisy_dataset/small_train/cremove_testing_from_training.py: Fügt jedem Datenelement das human-Tag hinzu, was bedeutet, dass der Punkt von
einem Menschen verifiziert und als Testdaten verwendet wurde
-data_utils.py: Fügt das Feld related_cwe zum Datensatz hinzu.datasets/clean_dataset: die Trainingsdaten ohne PrimeVul
datasets/clean_dataset/python enthält die Daten von SVEN und SecCodePLTdatasets/clean_dataset/c enthält die Daten von Juliet und SVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train: Enthält die Trainingsdaten von PrimeVul und SVEN mit ausgewählten CWEs (
wir verwenden die PrimeVul-Daten in diesem Datensatz als Training)datasets/noisy_dataset/large_train: Enthält die Trainingsdaten von PrimeVul, SVEN und SecCodePLT mit
mehr CWEs (Dieser Datensatz kann später zum Trainieren größerer Modelle verwendet werden)datasets/noisy_dataset/test: Ein kleiner, von Menschen verifizierter Testdatensatz aus PrimeVuldatasets/test
datasets/test/test_clean: Die Testdaten von SVEN, SecCodePLT und Juliet; mit OOD-CWEs, die nicht Teil des
Trainingssatzes sinddatasets/test/test_primevul_pair: Die ursprünglichen PrimeVul-Testdatenvulscan/data_process/data_utils/get_cwe_stat.py ausführen, um das Histogramm des Datensatzes zu erhalten