 thunlp/openattack
Ein Open-Source-Paket für textuellen Adversarial-Angriff.


Dokumentation • Funktionen & Anwendungen • Anwendungsbeispiele • Angriffsmodelle • Toolkit-Design
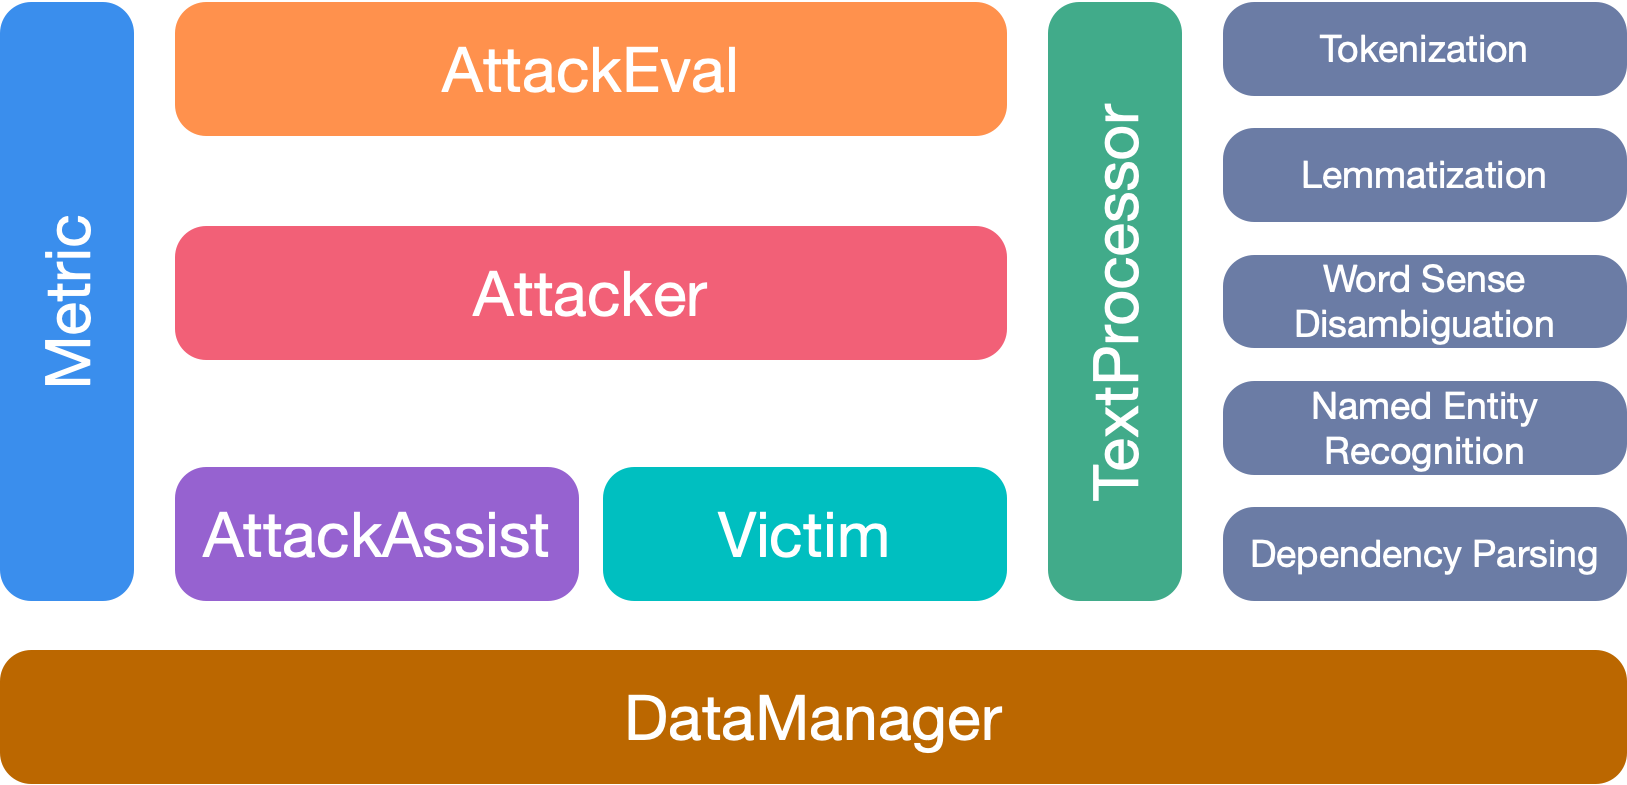
OpenAttack ist ein quelloffenes, auf Python basierendes Toolkit für textuelle adversarial Angriffe, das den gesamten Prozess textueller adversarialer Angriffe abdeckt, einschließlich Textvorverarbeitung, Zugriff auf das Opfermodell, Generierung adversarialer Beispiele und Evaluierung.
⭐️ Unterstützung aller Angriffsarten. OpenAttack unterstützt alle Arten von Angriffen, einschließlich Satz-/Wort-/Zeichenebene-Perturbationen sowie gradienten-/score-/entscheidungsbasierte/blinde Angriffsmodelle;
⭐️ Mehrsprachigkeit. OpenAttack unterstützt jetzt Englisch und Chinesisch. Sein erweiterbares Design ermöglicht eine schnelle Unterstützung weiterer Sprachen;
⭐️ Parallelverarbeitung. OpenAttack bietet Unterstützung für die Ausführung von Angriffsmodellen in mehreren Prozessen, um die Angriffseffizienz zu verbessern;
⭐️ Kompatibilität mit 🤗 Hugging Face. OpenAttack ist vollständig in die Bibliotheken 🤗 Transformers und Datasets integriert;
⭐️ Große Erweiterbarkeit. Sie können problemlos ein angepasstes Opfermodell auf einem beliebigen angepassten Datensatz angreifen oder ein angepasstes Angriffsmodell entwickeln und evaluieren.
✅ Bereitstellung verschiedener praktischer Baselines für Angriffsmodelle;
✅ Umfassende Evaluierung von Angriffsmodellen mit seinen gründlichen Evaluierungsmetriken;
✅ Unterstützung bei der schnellen Entwicklung neuer Angriffsmodelle mithilfe seiner gemeinsamen Angriffskomponenten;
✅ Bewertung der Robustheit eines maschinellen Lernmodells gegenüber verschiedenen adversarialen Angriffen;
✅ Durchführung von adversarialem Training, um die Robustheit eines maschinellen Lernmodells zu verbessern, indem die Trainingsdaten mit generierten adversarialen Beispielen angereichert werden.
pip (empfohlen)```bashpip install OpenAttack
#### 2. Dieses Repository klonen```bash
git clone https://github.com/thunlp/OpenAttack.git
cd OpenAttack
python setup.py install
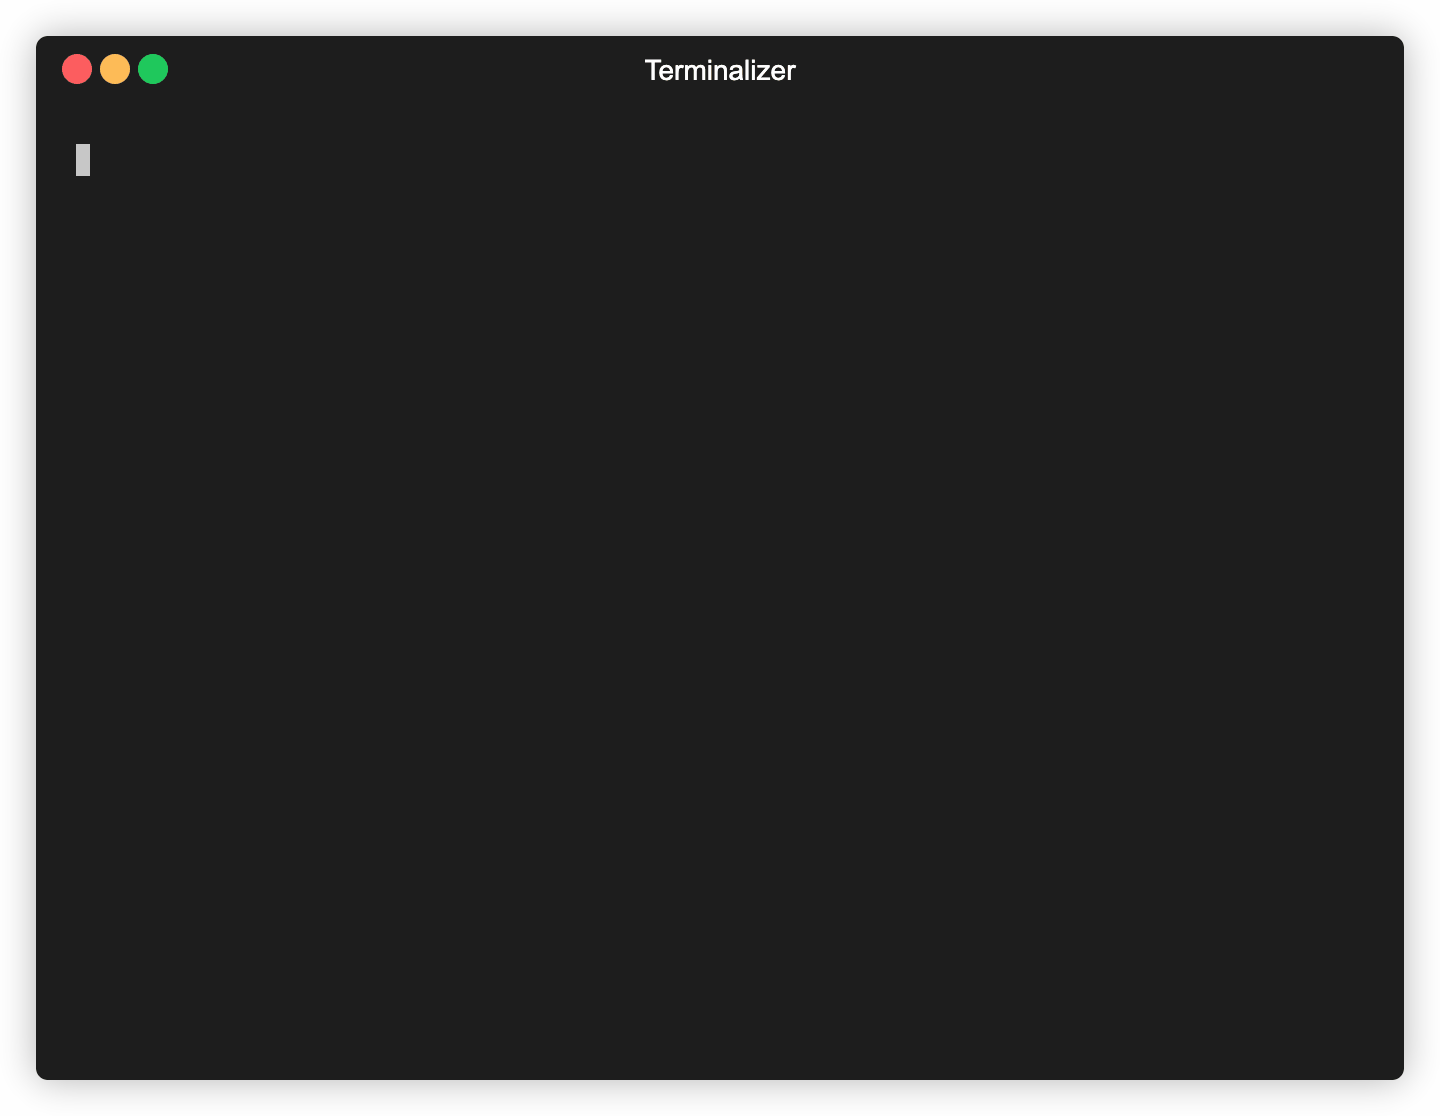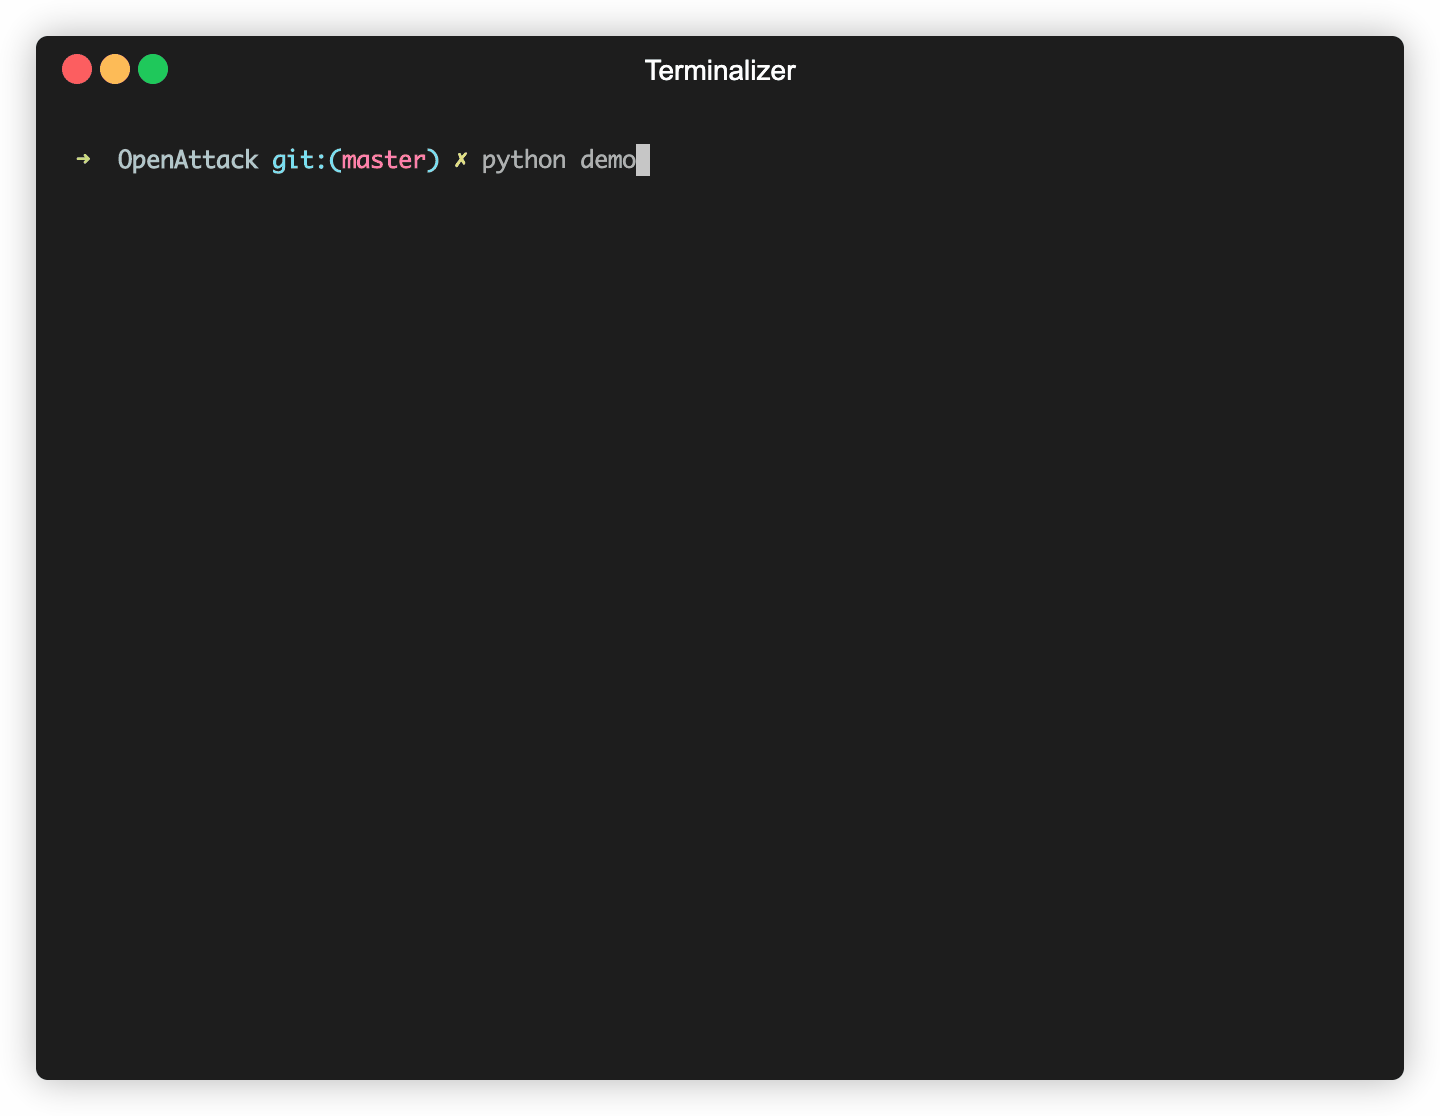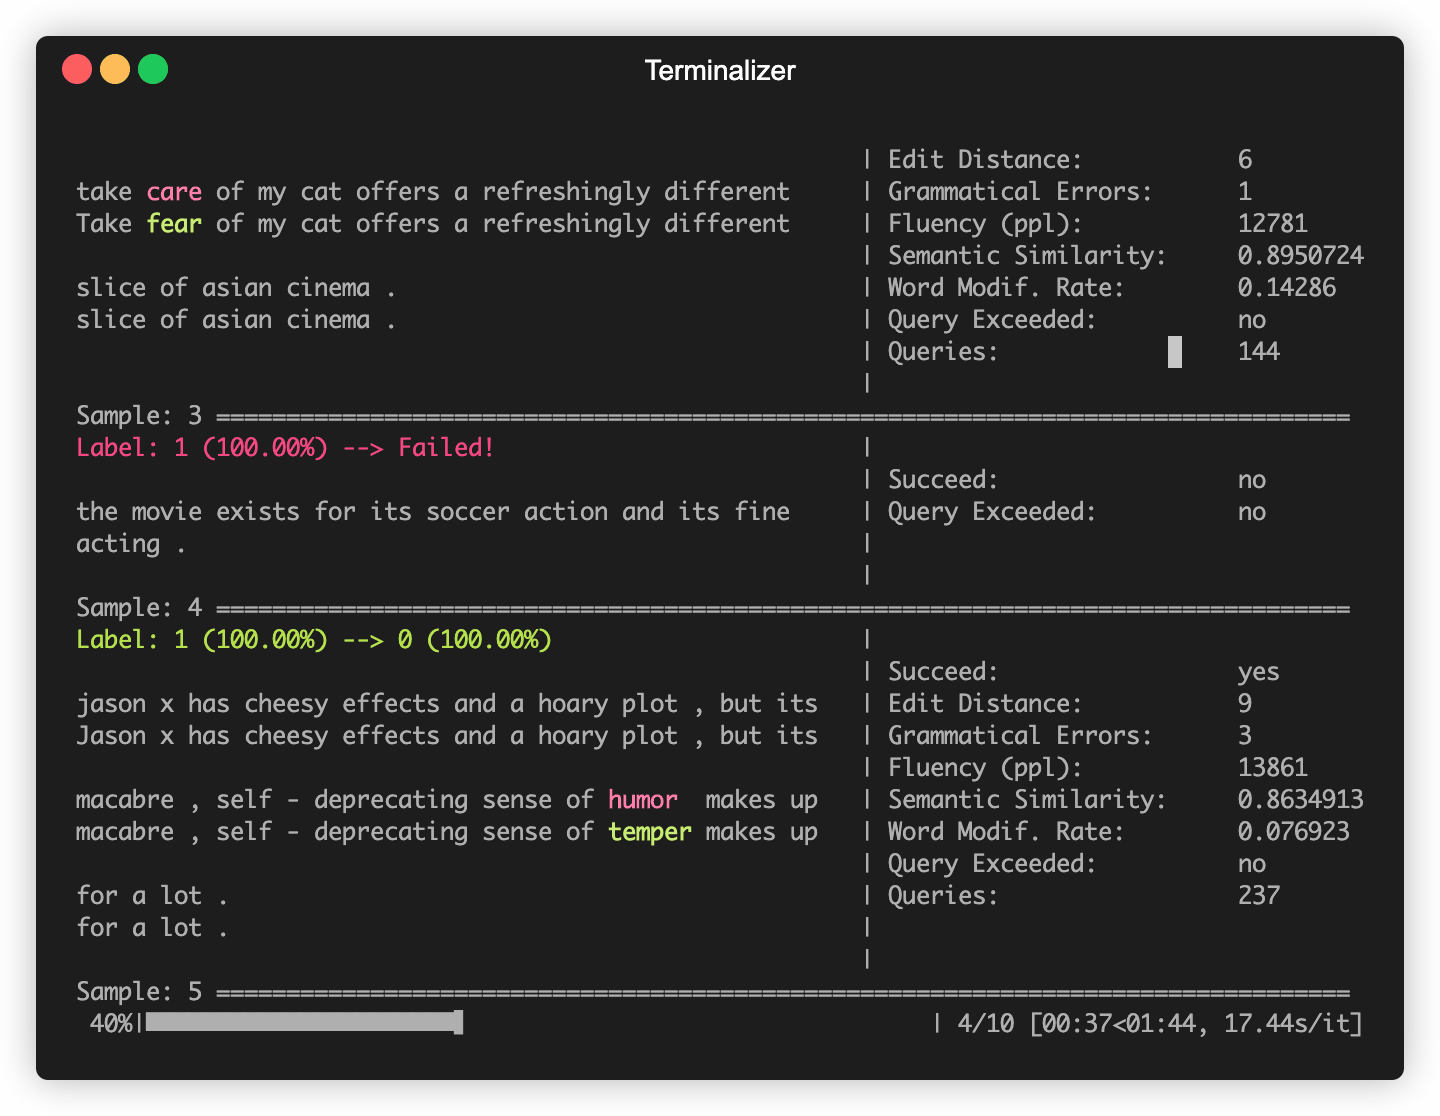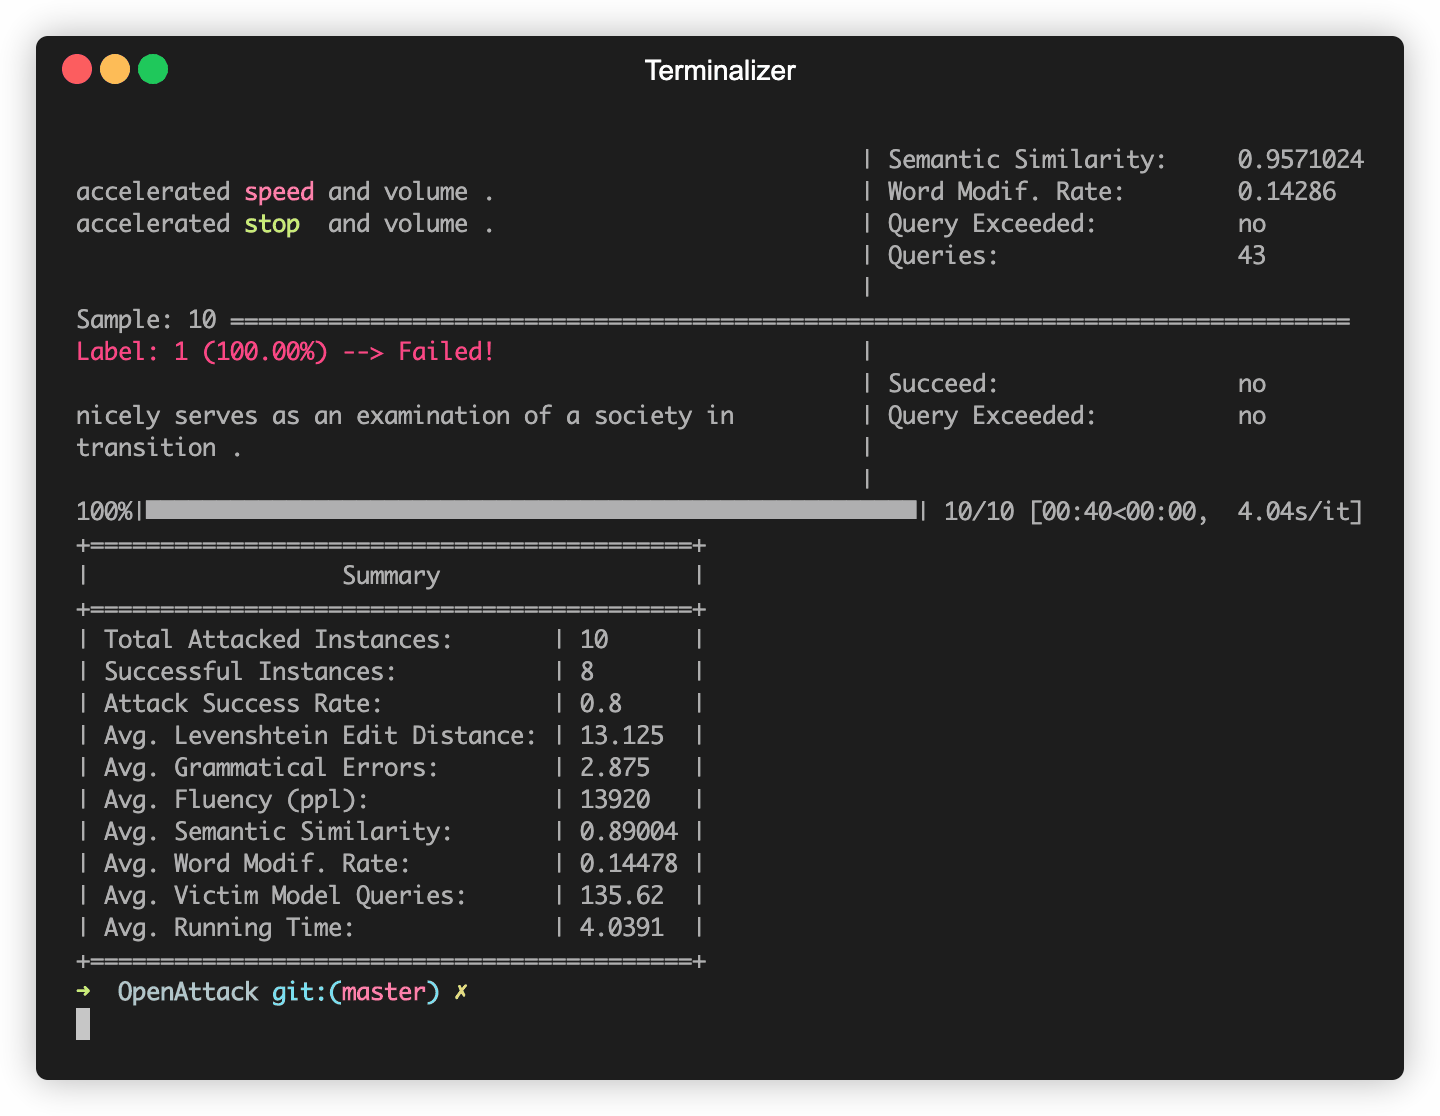
Nach der Installation können Sie versuchen, demo.py auszuführen, um zu prüfen, ob OpenAttack gut funktioniert:```
python demo.py
## Verwendungsbeispiele
#### Angriff auf integrierte Opfermodelle
OpenAttack enthält einige häufig verwendete NLP-Modelle wie BERT ([Devlin et al. 2018](https://arxiv.org/abs/1810.04805)) und RoBERTa ([Liu et al. 2019](https://arxiv.org/abs/1907.11692)), die auf gängigen Datensätzen (wie [SST-2](https://nlp.stanford.edu/sentiment/treebank.html)) feinabgestimmt wurden. Sie können mühelos gegnerische Angriffe gegen diese integrierten Opfermodelle durchführen.
Das folgende Codebeispiel zeigt, wie man PWWS, ein auf einem gierigen Algorithmus basierendes Angriffsmodell ([Ren et al., 2019](https://www.aclweb.org/anthology/P19-1103.pdf)), verwenden kann, um BERT auf dem SST-2-Datensatz anzugreifen (der vollständige ausführbare Code befindet sich [hier](https://github.com/thunlp/openattack/blob/master/examples/workflow.py)).
```python
def attack_eval(...):
...
``````python
import OpenAttack as oa
import datasets # use the Hugging Face's datasets library
# change the SST dataset into 2-class
def dataset_mapping(x):
return {
"x": x["sentence"],
"y": 1 if x["label"] > 0.5 else 0,
}
# choose a trained victim classification model
victim = oa.DataManager.loadVictim("BERT.SST")
# choose 20 examples from SST-2 as the evaluation data
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()
# prepare for attacking
attack_eval = OpenAttack.AttackEval(attacker, victim)
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
Das folgende Code-Snippet zeigt, wie man PWWS verwendet, um ein angepasstes Stimmungsanalysemodell (ein mit NLTK erstelltes statistisches Modell) auf SST-2 anzugreifen (der vollständige ausführbare Code ist hier).
class MyClassifier(oa.Classifier): def init(self): # nltk.sentiment.vader.SentimentIntensityAnalyzer is a traditional sentiment classification model. nltk.download('vader_lexicon') self.model = SentimentIntensityAnalyzer()
def get_pred(self, input_):
    return self.get_prob(input_).argmax(axis=1)

# access to the classification probability scores with respect input sentences
def get_prob(self, input_):
    ret = []
    for sent in input_:
        # SentimentIntensityAnalyzer calculates scores of “neg” and “pos” for each instance
        res = self.model.polarity_scores(sent)

        # we use 𝑠𝑜𝑐𝑟𝑒_𝑝𝑜𝑠 / (𝑠𝑐𝑜𝑟𝑒_𝑛𝑒𝑔 + 𝑠𝑐𝑜𝑟𝑒_𝑝𝑜𝑠) to represent the probability of positive sentiment
        # Adding 10^−6 is a trick to avoid dividing by zero.
        prob = (res["pos"] + 1e-6) / (res["neg"] + res["pos"] + 2e-6)

        ret.append(np.array([1 - prob, prob]))

    # The get_prob method finally returns a np.ndarray of shape (len(input_), 2). See Classifier for detail.
    return np.array(ret)
def dataset_mapping(x): return { "x": x["sentence"], "y": 1 if x["label"] > 0.5 else 0, }
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
victim = MyClassifier()
attacker = oa.attackers.PWWSAttacker()
attack_eval = oa.AttackEval(attacker, victim)
attack_eval.eval(dataset, visualize=True)
</details>
