 suraj-ranganath/stealthrl
StealthRL: RL-Framework zum adversarialen Umschreiben von KI-Text, um die Robustheit von Detektoren zu testen.

Paper (arXiv)
Demo
Modell (Hugging Face)
Benchmark-Datensatz (Hugging Face)
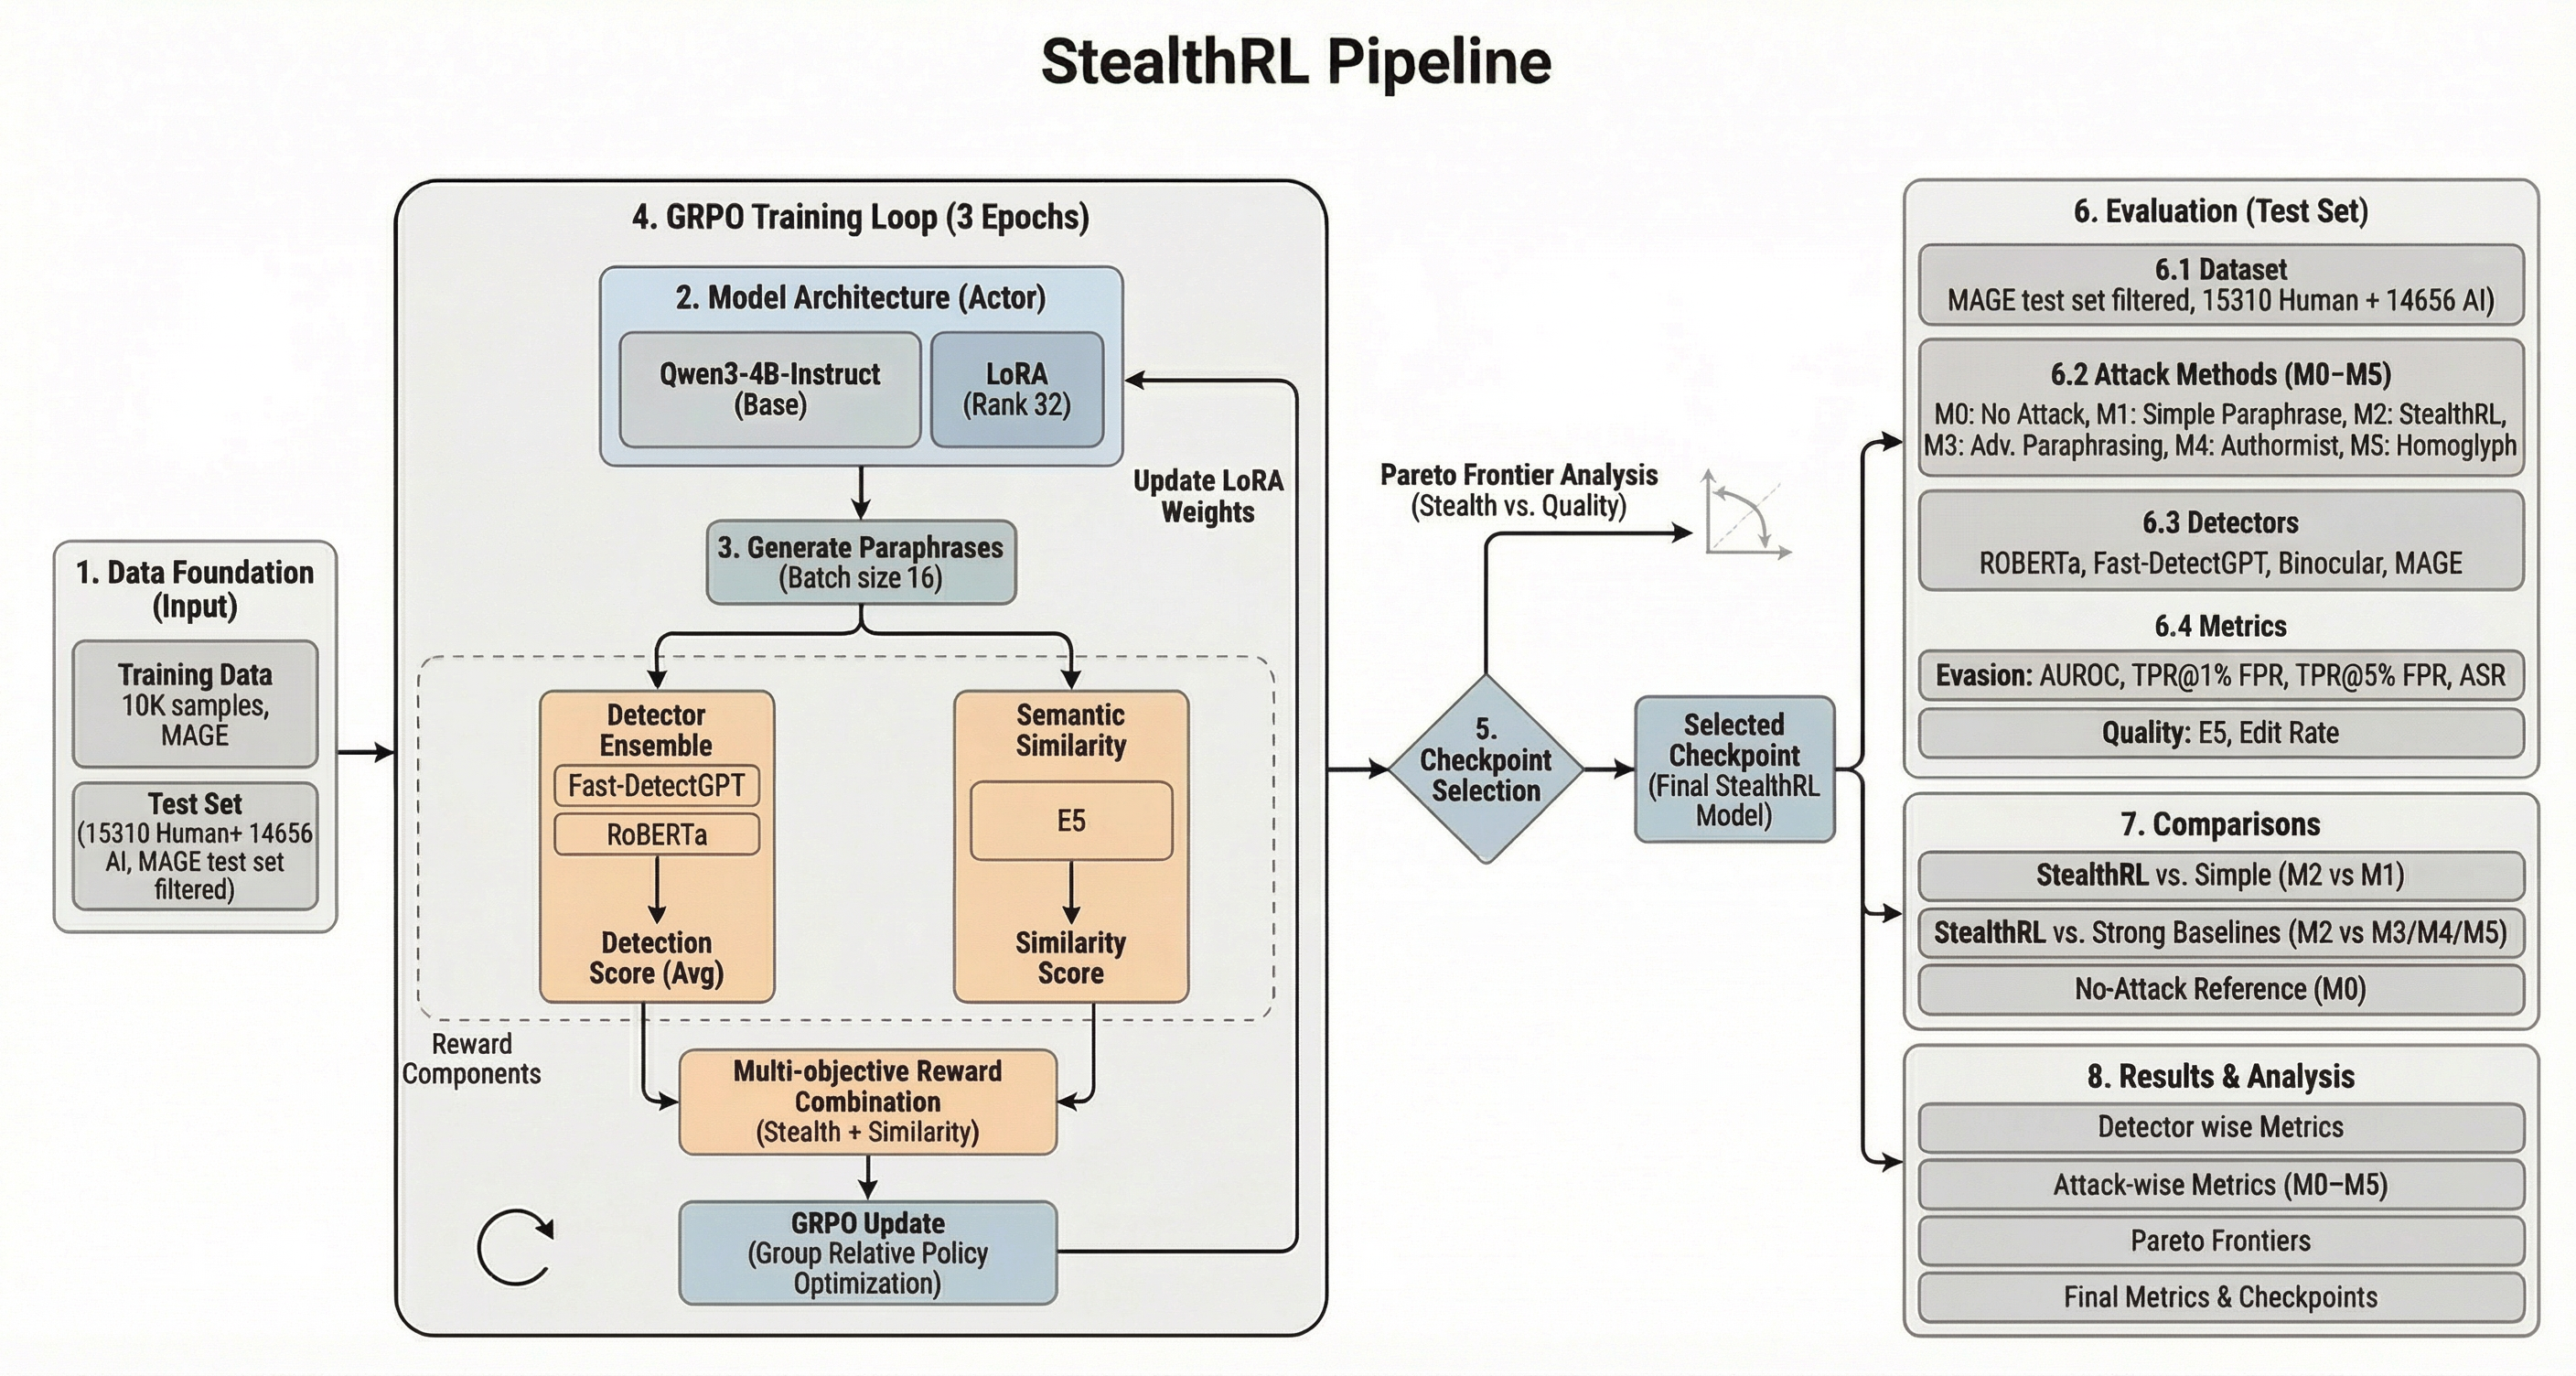
KI-Text-Detektoren werden zunehmend in sicherheitskritischen Umgebungen eingesetzt, doch ihre Robustheit gegenüber bedeutungserhaltendem adversarialem Umschreiben bleibt ungewiss. Wir stellen StealthRL vor, ein Reinforcement-Learning-Framework zum Stresstesten von KI-Text-Detektoren mit adaptiven Paraphrase-Angriffen. StealthRL trainiert eine Paraphrase-Policy gegen ein Detektor-Ensemble, während der semantische Gehalt erhalten bleibt, und bewertet anschließend die Übertragung auf nicht im Training verwendete Detektorfamilien. Im vollständigen gefilterten MAGE-Testpool (15.310 menschliche / 14.656 KI-Stichproben) reduziert StealthRL die mittlere AUROC von 0,79 auf 0,43 und erreicht einen mittleren TPR@1%FPR von 0,024 über RoBERTa, Fast-DetectGPT, Binoculars und MAGE. Der Angriff überträgt sich auf zwei Detektoren, die nicht im Training verwendet wurden, und legt dabei gemeinsame Schwachstellen offen statt eines einzelnen Detektorversagens. Wir analysieren darüber hinaus die Score-Verteilungen der Detektoren und bewerten die Qualität mit E5, BERTScore und LLM-basierten Likert-Bewertungen. Unsere Ergebnisse zeigen, dass aktuelle KI-Text-Detektoren unter realistischem Paraphrasierungsdruck fragil bleiben, und liefern ein reproduzierbares Protokoll für die Bewertung adversarialer Robustheit.
Dieses Repository ist die Forschungs- und Engineering-Codebasis hinter StealthRL. Es enthält:
Das Repository soll ein nützlicher Ausgangspunkt für Forschende sein, die Folgendes möchten:
stealthrl/: Trainingscode, Detektor-Wrapper, Belohnungen, Datenwerkzeuge und das ursprüngliche StealthBench-Paketeval/: Evaluations-Harness in Forschungsqualität für die Paper-Ergebnissescripts/: ausführbare Einstiegspunkte für Training, Evaluierung, Orchestrierung, Plotten und Dienstprogrammeconfigs/: YAML-Konfigurationen für Training, Evaluierung und Ablationenfigures/: Pipeline-Diagramme und statische Ressourcentests/: Integrations- und Plausibilitätstestsanalysis/: Ad-hoc-Analysehelfer und Einmal-Werkzeugepython -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
Je nachdem, welche Teile des Projekts Sie ausführen möchten, benötigen Sie möglicherweise auch:
pip install tinker
pip install openai
pip install vllm
Hinweise:
tinker wird für den cloudbasierten StealthRL-Checkpoint-Inferenzpfad benötigt, der von M2 verwendet wird.openai wird nur für den Qualitätsbewertungsschritt mit GPT/Likert benötigt.vllm wird für schnelle lokale Generierung in den Paper-Baselines empfohlen.Typische Umgebungsvariablen, die vom Repository verwendet werden:
export HF_HOME=$HOME/.cache/huggingface
export TRANSFORMERS_CACHE=$HF_HOME
export OPENAI_API_KEY=...
export TINKER_API_KEY=...
Für die mehrstufige Paper-Evaluationspipeline haben wir eine Env-Datei sowie ein Checkpoint-Deskriptor-JSON verwendet. Die öffentlichen Skripte ermöglichen es Ihnen, beide Pfade explizit zu überschreiben:
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_eval.py --quick
python scripts/run_stealthbench.py --config configs/stealthbench.yaml
Dies lädt nun die konfigurierten Textdateien, führt die konfigurierten Detektoren aus, speichert CSV-Ausgaben und erzeugt Vergleichsplots. Der alte Nur-TODO-Stub wurde entfernt.
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_public \
  --gpus 0 1 2 3
Das Repository enthält eine auf FastAPI basierende Demo-Website unter demo/. Sie bietet eine ausgereifte statische Benutzeroberfläche und stellt POST /api/paraphrase mit API-Key-Unterstützung sowie einem öffentlichen Kontingent von 20 Anfragen pro Tag für nicht authentifizierte Benutzer bereit.
pip install -r demo/requirements.txt
uvicorn demo.stealthrl_demo.app:app --reload --port 8080
Standardmäßig läuft die Demo im kostenlosen mock-Modus für UI-Tests. Um den echten StealthRL-Sampler zu verwenden, setzen Sie STEALTHRL_DEMO_INFERENCE_BACKEND=tinker, STEALTHRL_DEMO_CHECKPOINT_JSON und TINKER_API_KEY. Hinweise zu API-Key, Kontingent, Docker und AWS-Bereitstellung finden Sie in demo/README.md.
Das Paper berichtet Ergebnisse über den vollständigen gefilterten MAGE-Evaluationspool:
Die Evaluationspipeline in Forschungsqualität ist im Modul eval/ sowie in den mehrstufigen Skripten unter scripts/ implementiert.
Bereiten Sie Anmeldedaten und Checkpoint-Metadaten vor.
Erstellen Sie eine Env-Datei mit OPENAI_API_KEY und TINKER_API_KEY sowie ein Checkpoint-JSON, das den Pfad des StealthRL-Tinker-Samplers beschreibt.
Führen Sie den Preflight aus.
python scripts/preflight_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_repro \
  --gpus 0 1 2 3
Prüfen Sie die erzeugten Methodenausgaben, Detektor-Scores, Metriken und Plots im gewählten Run-Verzeichnis.
Wenn Sie nur die GPT-basierte Qualitätsbewertung auf zwischengespeicherten Ausgaben erneut ausführen müssen:
python scripts/run_gpt_quality_only.py \
  --run-root outputs/eval_runs/full_mage_repro \
  --env-file ~/.config/stealthrl/eval.env
python scripts/compute_bertscore_for_run.py \
  --run-dir outputs/eval_runs/full_mage_repro/assembled \
  --device cuda:0 \
  --batch-size 16 \
  --chunk-size 512
