
 suhanmen/sew
Bettet keybasierte, stilbasierte Wasserzeichen in LLM-generiertem Python-, Java- und C++-Code ein und erkennt sie mittels CST-Rewriting, wobei die funktionale Korrektheit erhalten bleibt und Code-Editing-Angriffen widerstanden wird.



| Feature | Token-level watermarks (KGW, SWEET, Unigram, STONE, STA-1) | Post-hoc watermarks (ACW, SrcMarker, RoSeMary) | ✨ SEW |
|---|---|---|---|
| Access | Decoding-time (biases token selection) | Post-hoc (rewrites finished code) | Post-hoc (rewrites finished code, model-agnostic) |
| Functional correctness | Changes the program (detectability–correctness trade-off) | Can break programs (Java/C++ pass@1 ≈ 12% for neural rewriting) | Preserved (pass@1 equal to unwatermarked code) |
| Predictability | — | Recurring patterns (recovered from 10 watermarked programs) | Key- and context-dependent (choices vary with each program's structure) |
| Detection (TPR@FPR5%) | 14–60% | 31–98% | ⚡ 98.7–99.5% |
Die Wasserzeichensetzung von LLM-generiertem Code unterstützt die Nachverfolgung der Herkunft. Wasserzeichen, die die Token-Auswahl während der Generierung verändern, tauschen Erkennbarkeit gegen funktionale Korrektheit ein und erfordern die Kontrolle über das generierende Modell. Post-hoc-Methoden versehen stattdessen fertiggestellten Code mit vordefinierten Transformationen oder trainierten neuronalen Modellen mit einem Wasserzeichen, doch ihre wiederkehrenden Muster machen das Wasserzeichen über Programme hinweg vorhersagbar, und Muster, die bereits in nicht gewassertem Code häufig vorkommen, werden als Wasserzeichen-Evidenz gezählt, was zu Fehlerkennungen führt. SEW stellt die Frage: Kann der Code-Stil eines bereits generierten Programms ein Wasserzeichen tragen, das konstruktionsbedingt korrekt, schwer vorherzusagen und gegenüber von Menschen geschriebenem Code kalibriert ist?
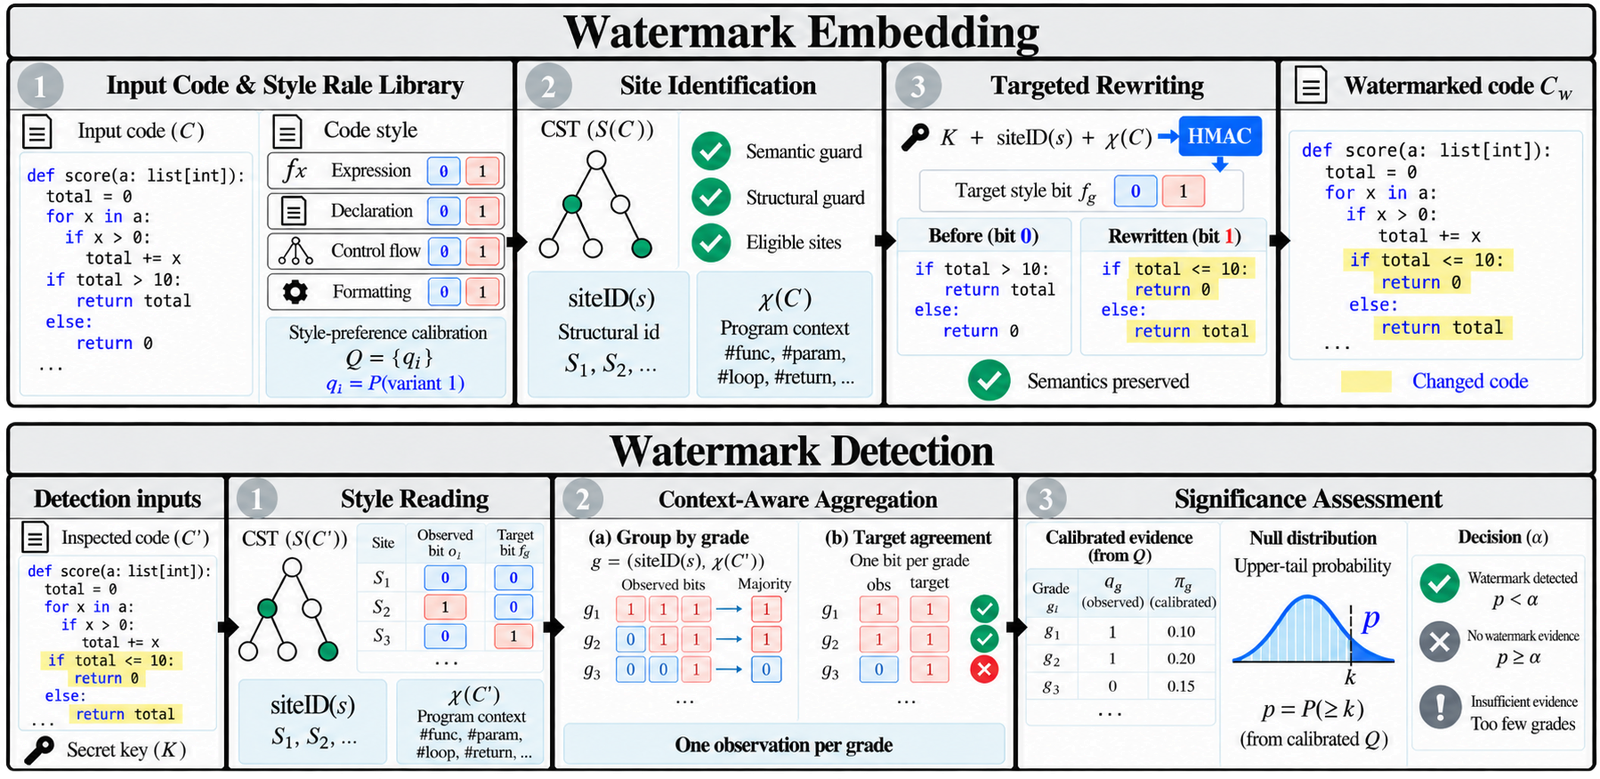
SEW (Style-Encoded Watermarking) bettet Wasserzeichen in bereits generierten Code ein und erkennt sie dort durch drei Komponenten:
x += 1 / x = x + 1, range(n) / range(0, n), if (c) s; / if (c) { s; }), werden auf dem Concrete Syntax Tree (CST) abgeglichen. Welche Variante eine Stelle annimmt, wird durch einen geheimen Schlüssel und den strukturellen Kontext der Stelle entschieden.Die Erkennung benötigt nur den verdächtigen Code und den Schlüssel — nicht das generierende Modell, den Originalcode oder irgendeine Aufzeichnung der Einbettung.
✅ Modellagnostisch und konstruktionsbedingt korrekt — SEW schreibt nur Stilstellen um, an denen beide Varianten dieselbe Semantik haben, sodass es auf der Ausgabe jedes Modells funktioniert und pass@1 gleich dem des nicht gewasserten Codes hält.
✅ Kalibrierte Evidenz — Ein Poisson-Binomial-Test mit Stilwahrscheinlichkeiten, die aus von Menschen geschriebenem Code (LeetCode-Lösungen, disjunkt zu den Evaluationsdaten) geschätzt wurden, hält Fehlerkennungen auf menschlichem Code gering.
✅ Robust und schwer zu inferieren — SEW behält seine Erkennung unter Formatierung, Linting, Kommentarentfernung und Variablenumbenennung bei, und ein Angreifer, der gewasserte Programme beobachtet, kann seine Stilentscheidungen nicht so zurückgewinnen, wie er die der Post-hoc-Baselines zurückgewinnt.
Hauptergebnis — Erkennung auf CodeContests (TPR@FPR5% / AUROC, %), gemittelt über drei LLMs (Qwen3.5-9B, gemma-4-12B-it, gpt-oss-20b).
| Type | Method | Python | Java | C++ |
|---|---|---|---|---|
| Token-level | KGW | 48.33 / 80.56 | 43.30 / 72.31 | 59.31 / 84.54 |
| SWEET | 59.92 / 85.18 | 41.19 / 76.56 | 60.01 / 87.24 | |
| Unigram | 57.45 / 88.97 | 36.54 / 71.37 | 47.05 / 71.13 | |
| STONE | 28.09 / 62.33 | 14.38 / 62.95 | 23.65 / 64.79 | |
| STA-1 | 35.26 / 66.26 | 20.93 / 61.48 | 44.71 / 73.72 | |
| Post-hoc | ACW | 90.10 / 95.05 | – | – |
| SrcMarker | 90.21 / 97.86 | 71.52 / 93.58 | 69.88 / 81.55 | |
| RoSeMary | 97.86 / 97.32 | 31.00 / 95.46 | 81.26 / 89.44 | |
| SEW | 99.49 / 99.64 | 98.70 / 98.99 | 99.22 / 99.38 |
Funktionale Korrektheit (pass@1 des gewasserten Codes, %; nicht gewasserter Code: 57.63 / 52.05 / 53.74).
| Method | Python | Java | C++ |
|---|---|---|---|
| ACW | 56.00 | – | – |
| SrcMarker | 56.78 | 11.87 | 11.82 |
| RoSeMary | 56.39 | 11.71 | 11.52 |
| SEW | 57.63 | 52.05 | 53.74 |
Robustheit gegenüber Code-Bearbeitungsangriffen (TPR@FPR5%, %, gemittelt über drei LLMs und drei Sprachen; ACW: nur Python).






