 seekbytes/ipa
GUI-Analysator für die eingehende Untersuchung von PDF-Dateien. Erkennt schädliche Payloads, versteht Objektbeziehungen und extrahiert wichtige Informationen für die Bedrohungsanalyse.

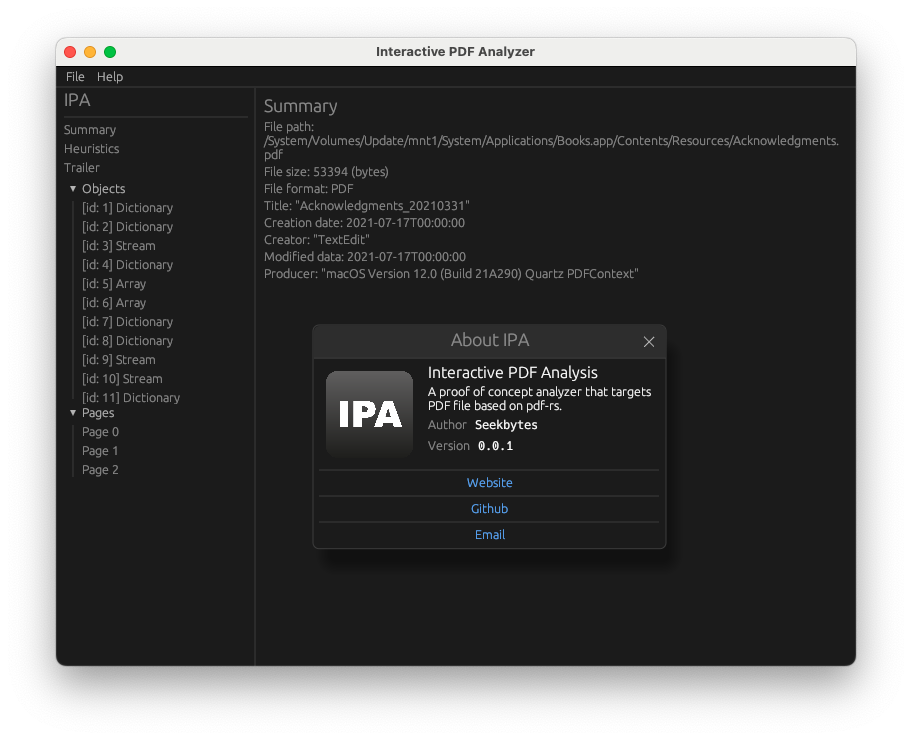
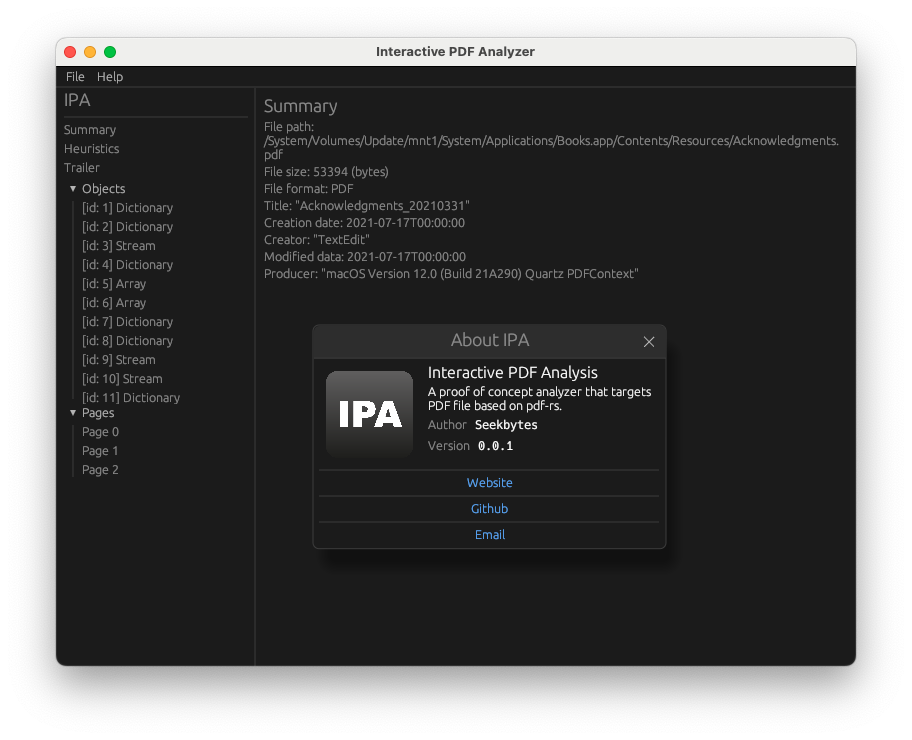
Interaktive PDF-Analyse (auch IPA genannt) ermöglicht es jedem Forscher, die inneren Details einer beliebigen PDF-Datei zu erkunden. PDF-Dateien können verwendet werden, um schädliche Payloads zu transportieren, die Schwachstellen ausnutzen und Probleme von PDF-Viewern verursachen, oder sie können in Phishing-Kampagnen als Social-Engineering-Artefakte eingesetzt werden. Das Ziel dieser Software ist es, jedem Analysten zu ermöglichen, selbst tief in die PDF-Datei einzudringen. Über IPA können Sie wichtige Payloads aus PDF-Dateien extrahieren, die Beziehungen zwischen Objekten verstehen und Elemente ableiten, die für die Triage von schädlichen oder nicht vertrauenswürdigen Payloads hilfreich sein können.
Die Hauptinspiration geht auf die fantastischen Leute hinter Zynamics und ihr hervorragendes Produkt namens PDF dissector zurück.
Als ich mit dem Reverse Engineering von Malware begann, bestand das wichtigste verfügbare Werkzeug zur Analyse schädlicher Payloads aus den hervorragenden Tools von Didier Stevens. Diese hatten sich zum De-facto-Standard entwickelt, doch eines der Hauptprobleme bestand darin, dass sie von der Kommandozeile aus verwendet werden mussten, wobei man sich eine sehr große Kombination von Flags merken und die Nummern der verschiedenen Objekte angeben musste. Obwohl Analysten und Entwickler täglich mit allen möglichen Kommandozeilen-Tools umgehen müssen, bedeutet das nicht, dass wir kein neues grafisches Werkzeug zur Dateiinspektion erstellen können.
Tatsächlich beschäftigen sich Teile der statischen Analyse und des Reverse Engineering auch damit, wie die wichtigsten Informationen aus Sicht der Benutzererfahrung für den Analysten dargestellt werden können. Die Tools von Didier Stevens sowie peepdf sind bereits etabliert und gut eingeführt. Der Analyst könnte jedoch etwas Grafisches gebrauchen, um die Beziehungen zwischen den verschiedenen Objekten zu verstehen, zu erkennen, auf welche Seiten sie verweisen und welche Objekttypen (Bilder, Schriftarten, Farben, Metadaten) vorliegen, Stream-Inhalte auf einfache Weise zu exportieren und den Inhalt von Dictionaries in Tabellenform zu sehen.
Die Hauptinspirationsquelle ist das von Zynamics entwickelte Tool namens PDF-dissector: Das hervorragende Feedback einiger ehemaliger Nutzer und die ständigen Anfragen, es als Open Source zu veröffentlichen, haben mich dazu bewogen, ein paar Tage in die Erstellung dieses Tools zu investieren.
Das Tool kann mit Rust und cargo kompiliert werden. Außer Rust und den heruntergeladenen Crates sind keine Abhängigkeiten erforderlich.
git clone https://github.com/seekbytes/IPA
cd IPA

## compile with debug symbols, the binary is inside ./target/debug/IPA
cargo b

## compile in release mode, the binary is inside ./target/release IPA
cargo b --release
IPA hat derzeit die folgenden Einschränkungen:
Letztendlich kann das Tool noch deutlich verbessert werden, und ich wette, einige Leute werden bemerken, wie schlecht mein Code ist. Wenn Sie einer von ihnen sind, lassen Sie mich bitte über mögliche Verbesserungen, bessere Muster und jegliche Vorschläge wissen.
Wenn Sie Probleme, Verbesserungen haben oder mir einfach nur schreiben möchten, senden Sie eine E-Mail an [email protected].
