 rodricios/wxpath
wxpath - deklaratives Web-Crawling mit XPath; eine Webabfragesprache (WQL)


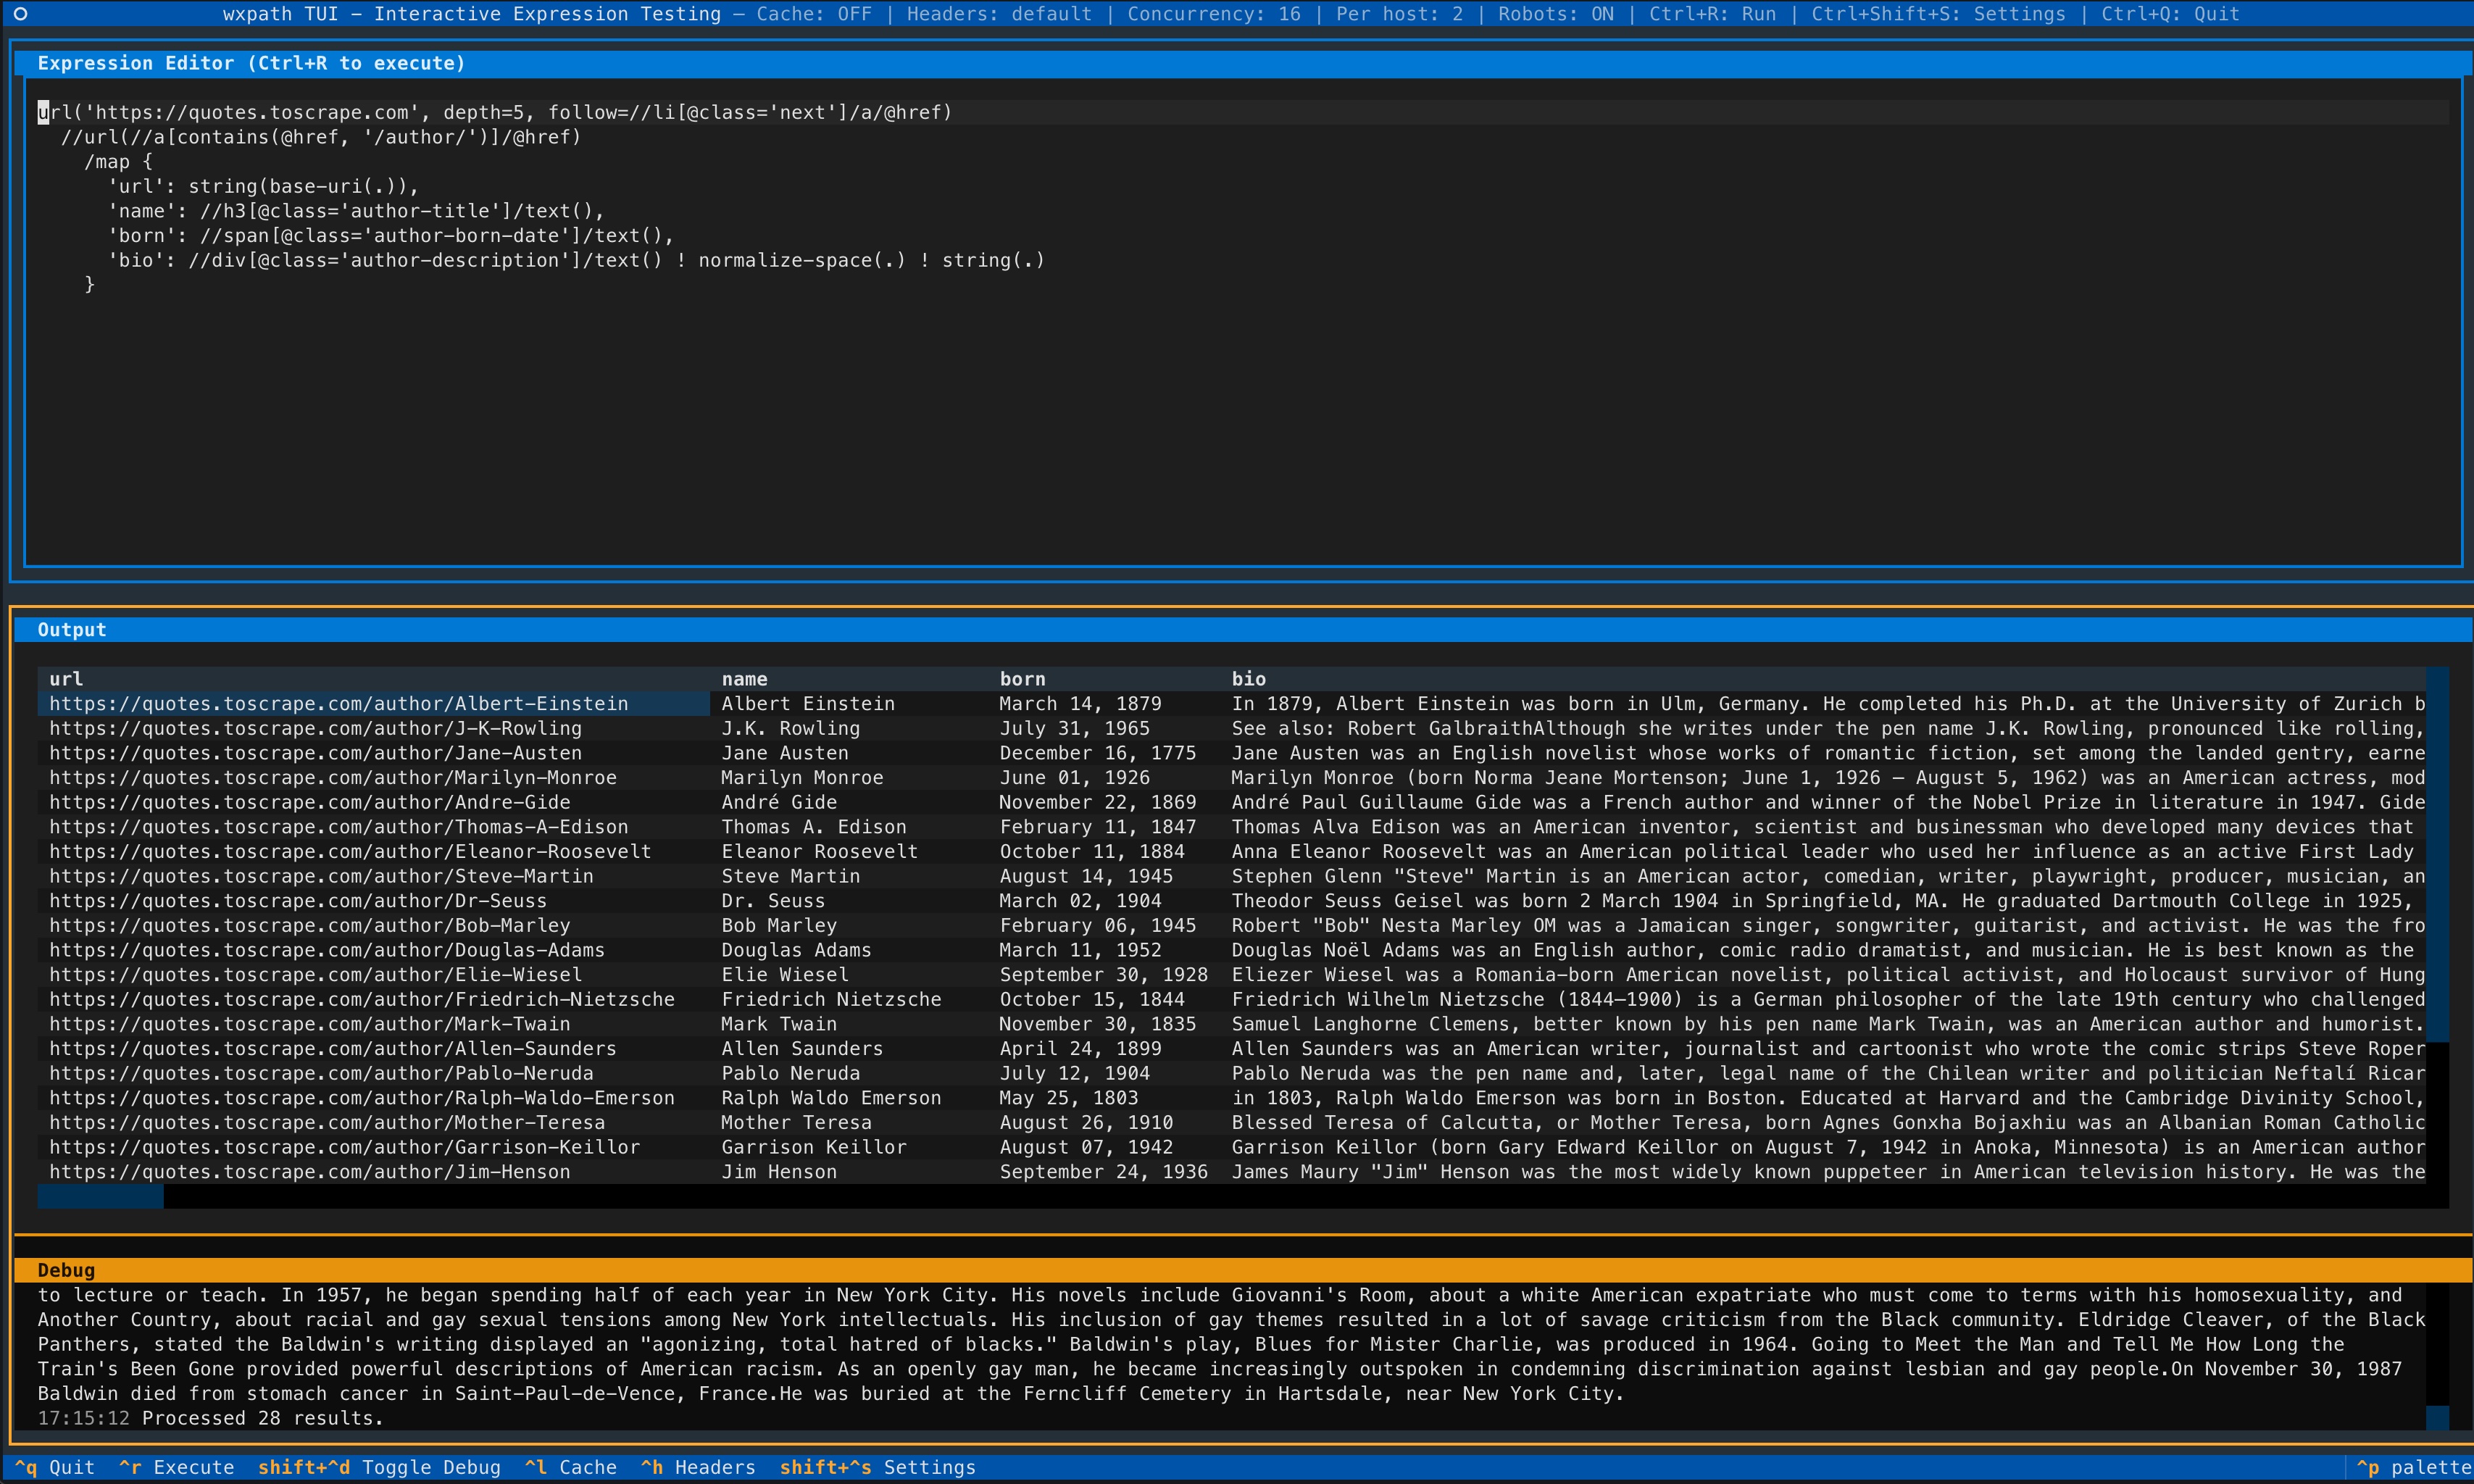
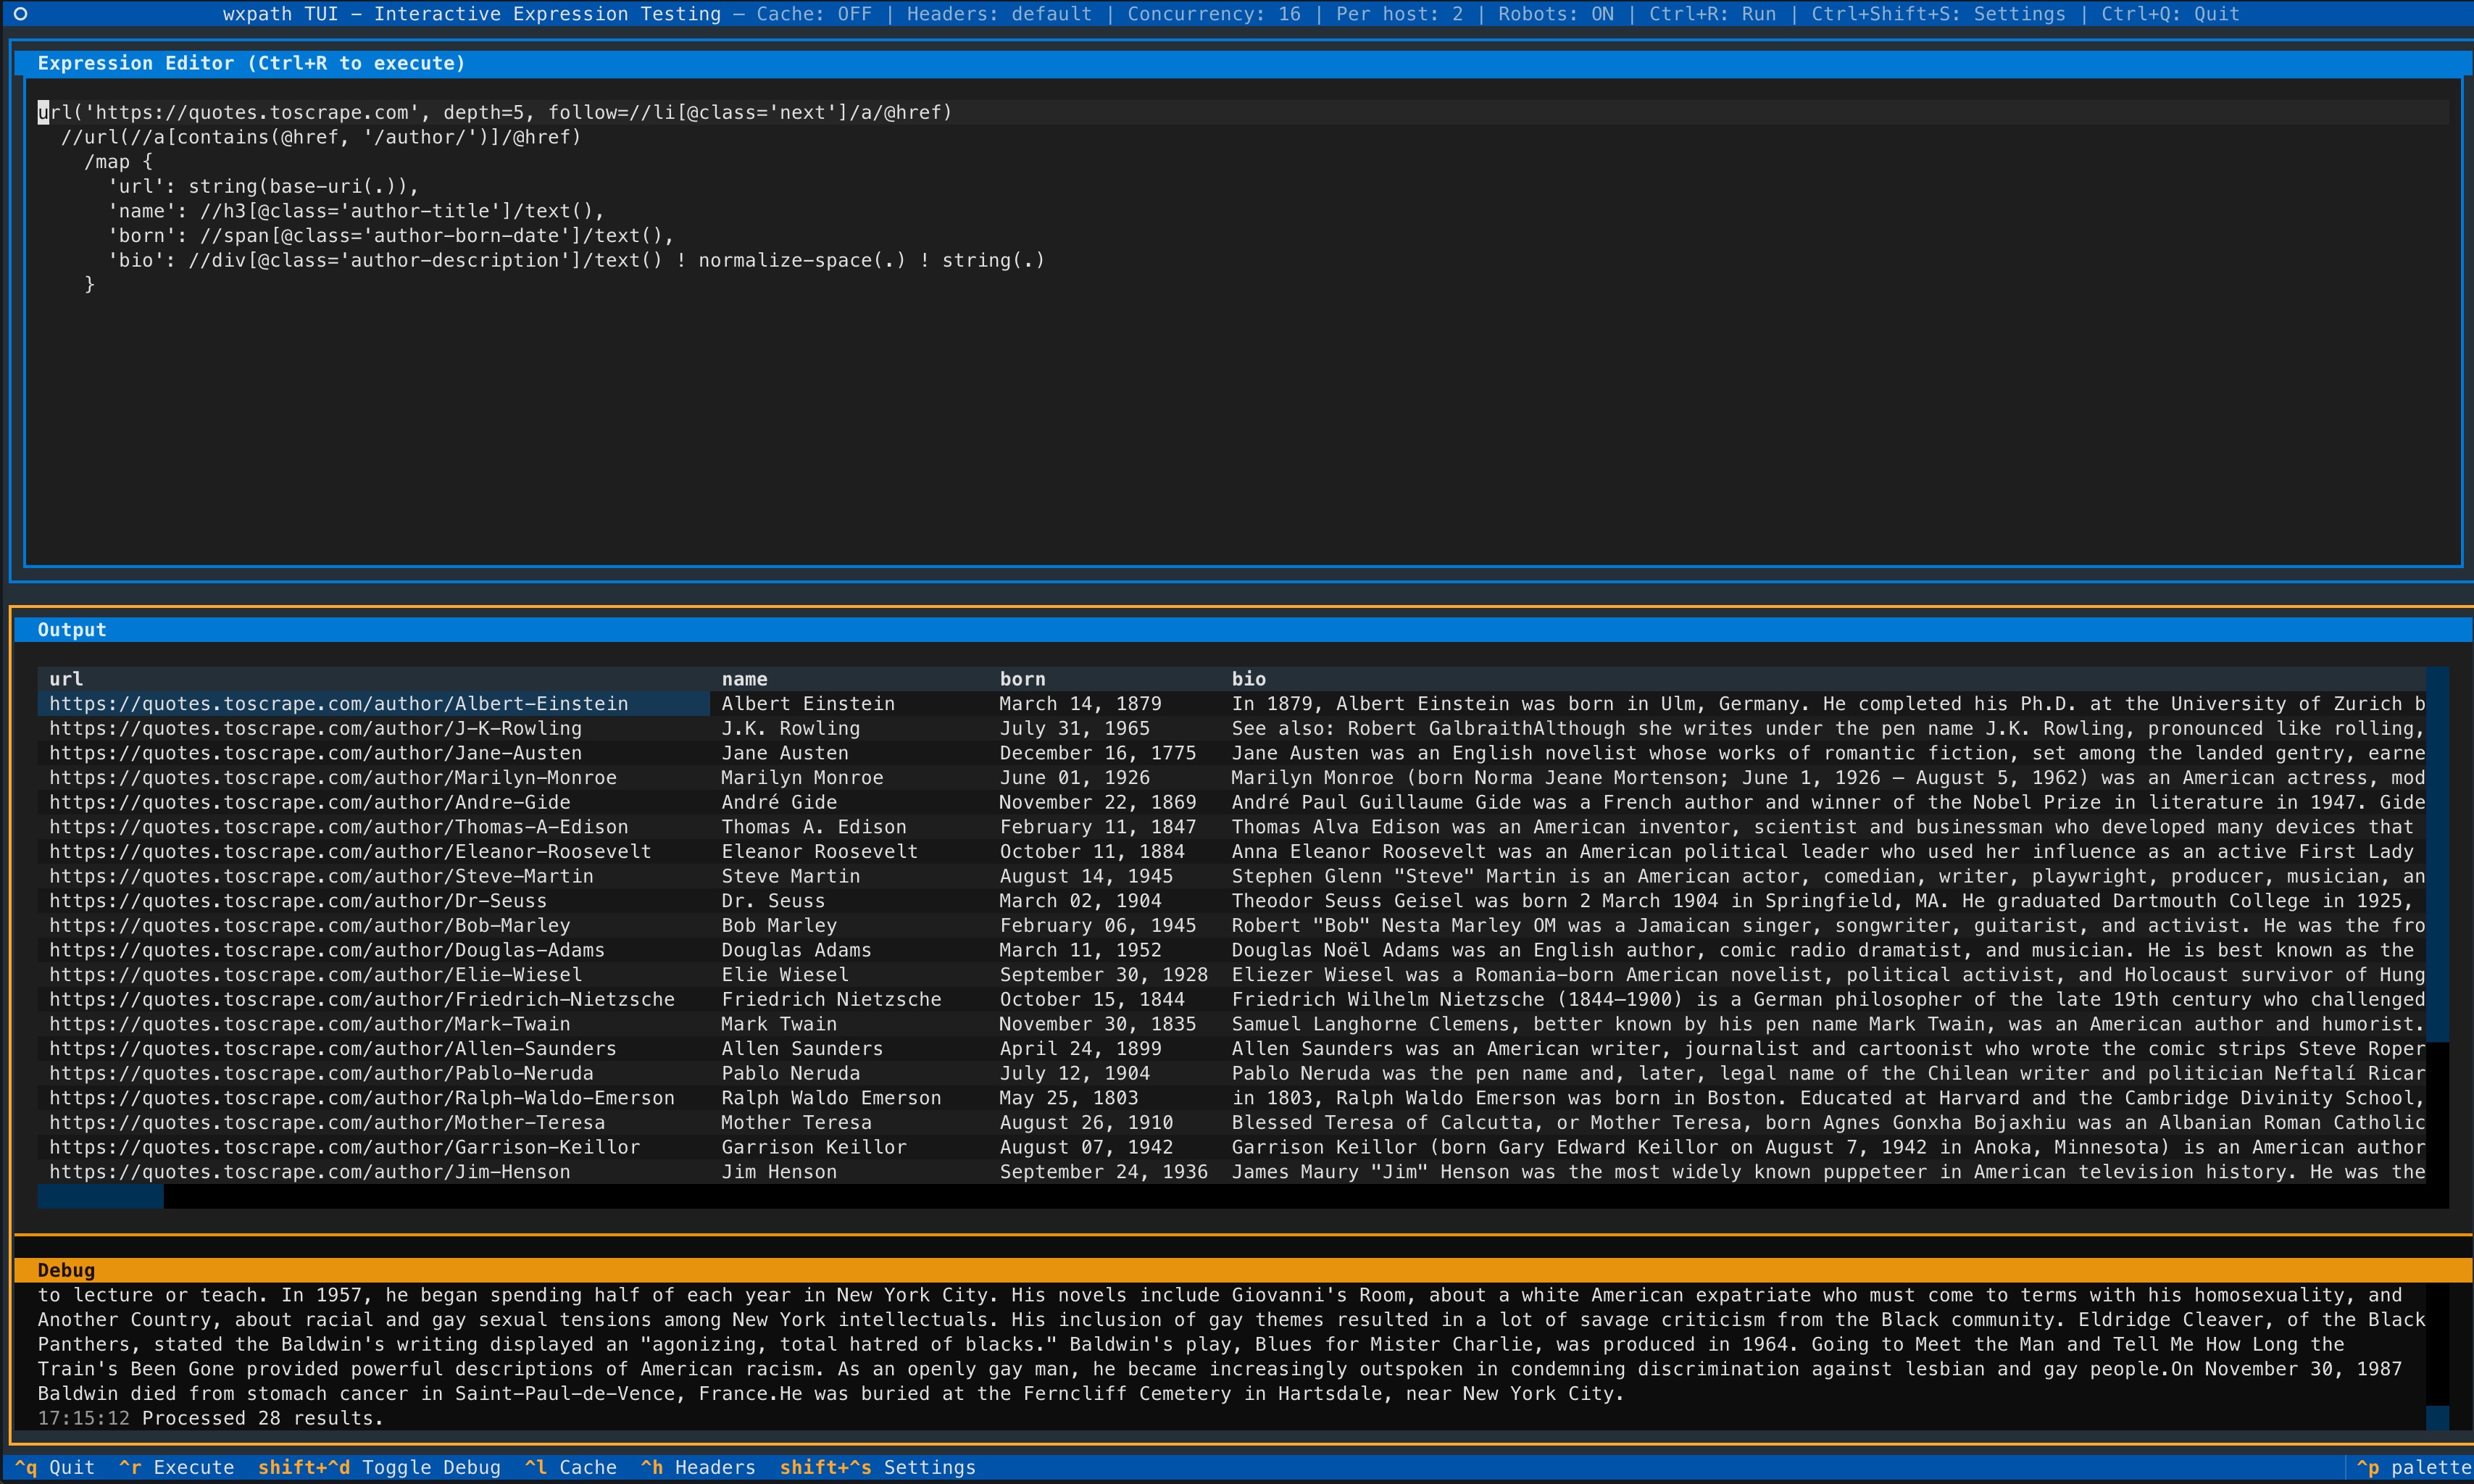
NEU: TUI – Interaktive Terminal-Oberfläche (angetrieben von Textual) zum Testen von wxpath-Ausdrücken und Exportieren von Daten.
Erfordert Python 3.10+.
pip install wxpath
# Für TUI-Unterstützung:
pip install "wxpath[tui]"
# TUI sofort via uv starten:
uvx --from "wxpath[tui]" wxpath-tui
wxpath ist ein deklarativer Web-Crawler, bei dem die Traversierung direkt in XPath ausgedrückt wird. Anstatt imperative Crawl-Schleifen zu schreiben, ermöglicht wxpath dir in einem einzigen Ausdruck zu beschreiben, was verfolgt und was extrahiert werden soll. wxpath führt diesen Ausdruck nebenläufig, breitenstufen-ähnlich aus und streamt die Ergebnisse, sobald sie entdeckt werden.
Dieser Ausdruck ruft eine Seite ab, extrahiert Links und streamt sie nebenläufig – keine Crawl-Schleife erforderlich:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
Durch die Einführung des url(...)-Operators und der ///-Syntax ist die wxpath-Engine in der Lage, rekursive (oder paginierte) Web-Crawling- und Extraktionsdurchläufe durchzuführen:
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
Die meisten Web-Scraper zwingen dich, zuerst die Crawl-Steuerung zu schreiben und dann die Extraktion.
wxpath vereint diese beiden Schritte in einem:
Extrahiere saubere, strukturierte JSON-Hierarchien direkt aus dem Graphen – füttere deine LLMs mit Signal, nicht mit Rauschen. Siehe LangChain-Integration für weitere Details.
wxpath ist deterministisch (lies: nicht von LLMs angetrieben). Während wir keine Garantie für die Netzwerkstabilität geben können, können wir die Traversierung garantieren.
Die Dokumentation ist jetzt hier verfügbar.
url(...) und ///url(...) erklärtimport wxpath
from wxpath.settings import CRAWLER_SETTINGS
# Benutzerdefinierte Header für Höflichkeit; für einige Seiten notwendig (z.B. Wikipedia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# Crawlen, Felder extrahieren, einen Wissensgraphen aufbauen
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
Hinweis: Einige Seiten (einschließlich Wikipedia) können Anfragen ohne passende Header blockieren.
Siehe Fortgeschritten: Engine- & Crawler-Konfiguration zum Setzen eines benutzerdefinierten User-Agent.
Der obige Ausdruck führt Folgendes aus:
https://en.wikipedia.org/wiki/Expression_language.<main>, die mit /wiki/ beginnen und keinen Doppelpunkt (:) enthalten.url(...) und ///url(...) erklärturl(...) ist ein benutzerdefinierter Operator, der den Inhalt der benutzer-spezifizierten oder intern generierten URL abruft und als lxml.html.HtmlElement für die weitere XPath-Verarbeitung zurückgibt.///url(...) zeigt ein tiefes Crawlen an. Es teilt der Laufzeit-Engine mit, den Links bis zur angegebenen max_depth weiter zu folgen. Im Gegensatz zu wiederholten url()-Springen ermöglicht es einem einzelnen Ausdruck, eine tiefere Grapherkundung zu beschreiben. WARNUNG: Mit Vorsicht und Einschränkungen (via max_depth oder XPath-Prädikaten) verwenden, um eine Traversierungsexplosion zu vermeiden.Siehe DESIGN.md für Details zum Sprachdesign. Dort siehst du die Kernkonzepte und das Design der Sprache von Grund auf.
wxpath wertet einen Ausdruck als Liste von Traversierungs- und Extraktionsschritten (intern als Segments bezeichnet) aus.
url(...) erzeugt Crawl-Aufgaben entweder statisch (über eine feste URL) oder dynamisch (über eine URL, die aus dem XPath-Ausdruck stammt). URLs werden global, auf Best-Effort-Basis dedupliziert – nicht pro Tiefe.
XPath-Segmente arbeiten auf abgerufenen Dokumenten (die über die unmittelbar vorhergehenden url(...)-Operationen abgerufen wurden).
///url(...) zeigt das tiefe Crawlen an – es verläuft breitenstufen-ähnlich bis zu max_depth.
Ergebnisse werden ausgegeben, sobald sie bereit sind.
wxpath ist asyncio/aiohttp-first und bietet eine asynchrone API zum Crawlen und Extrahieren von Daten.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpath bietet auch eine Sync-API für asyncio, die es dir ermöglicht, mehrere Seiten nebenläufig zu crawlen und dabei die Einfachheit von synchronem Code beizubehalten. Dies ist besonders nützlich für Crawls in strikt synchronen Ausführungsumgebungen (d. h. nicht innerhalb einer asyncio-Event-Schleife), bei denen die Leistung eine Rolle spielt.
from wxpath import wxpath_async_blocking_iter
