 renatus-cartesius/reconswarm
Erweitern Sie Ihr Recon mit Cloud-Power

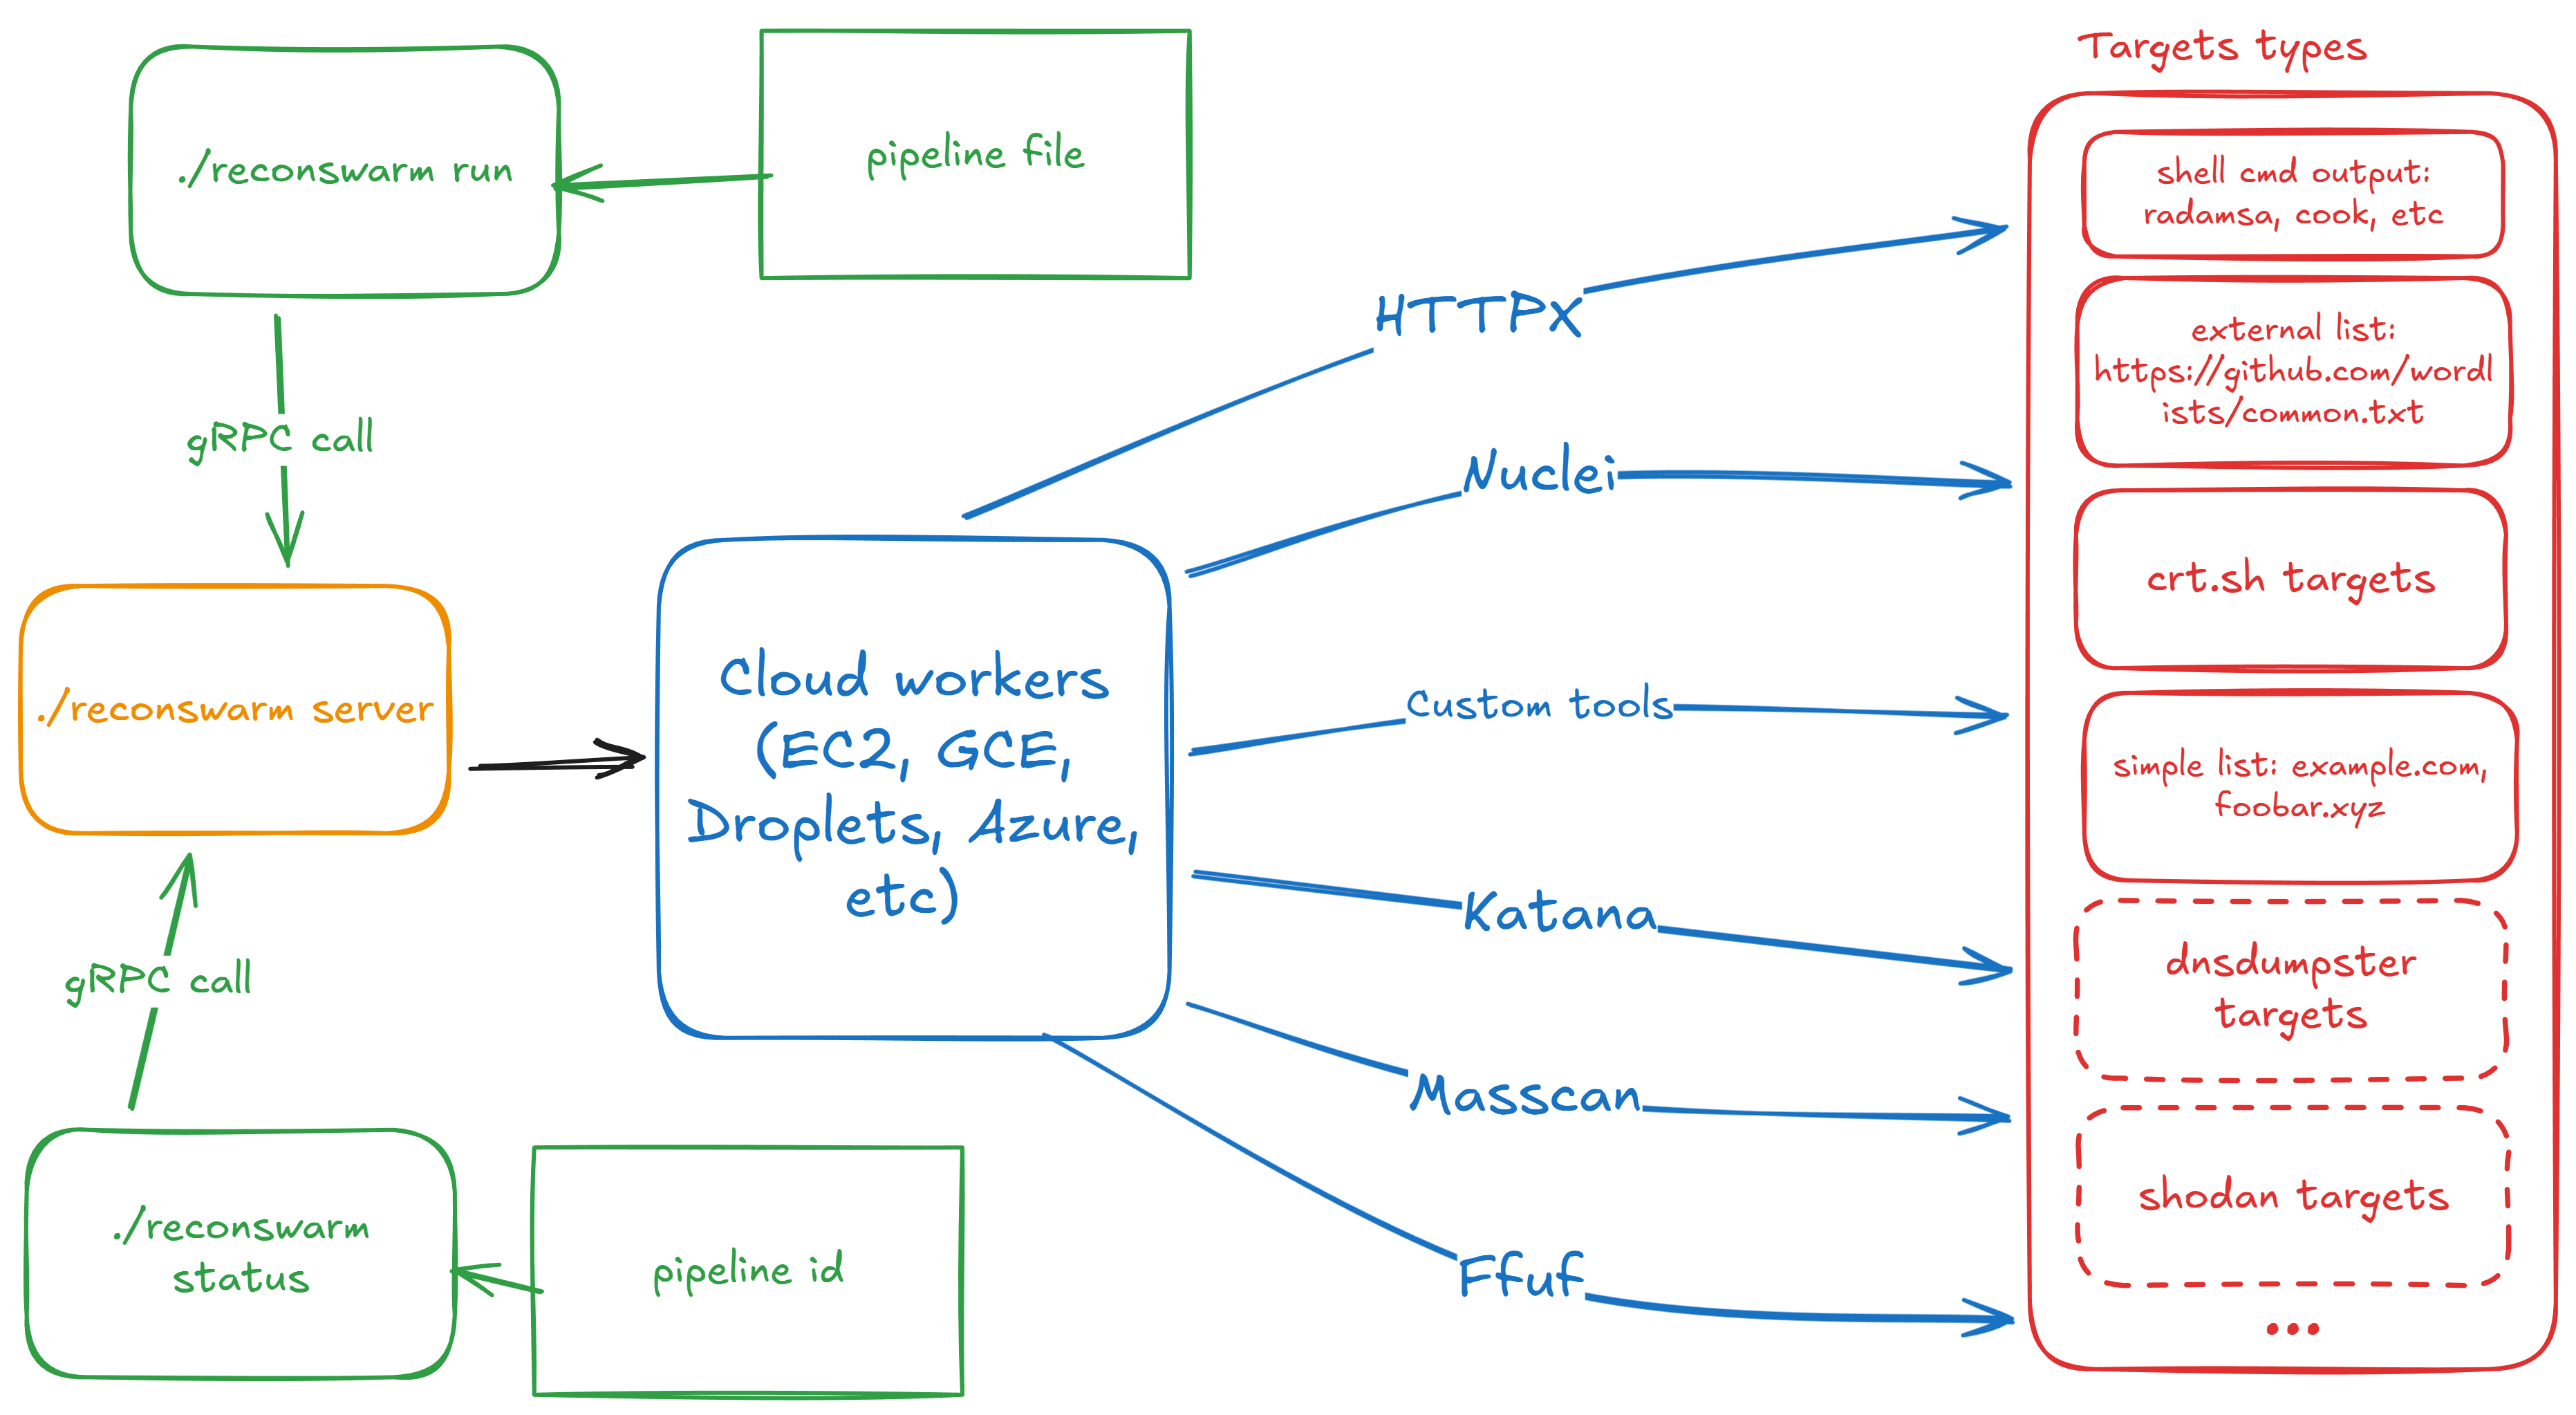
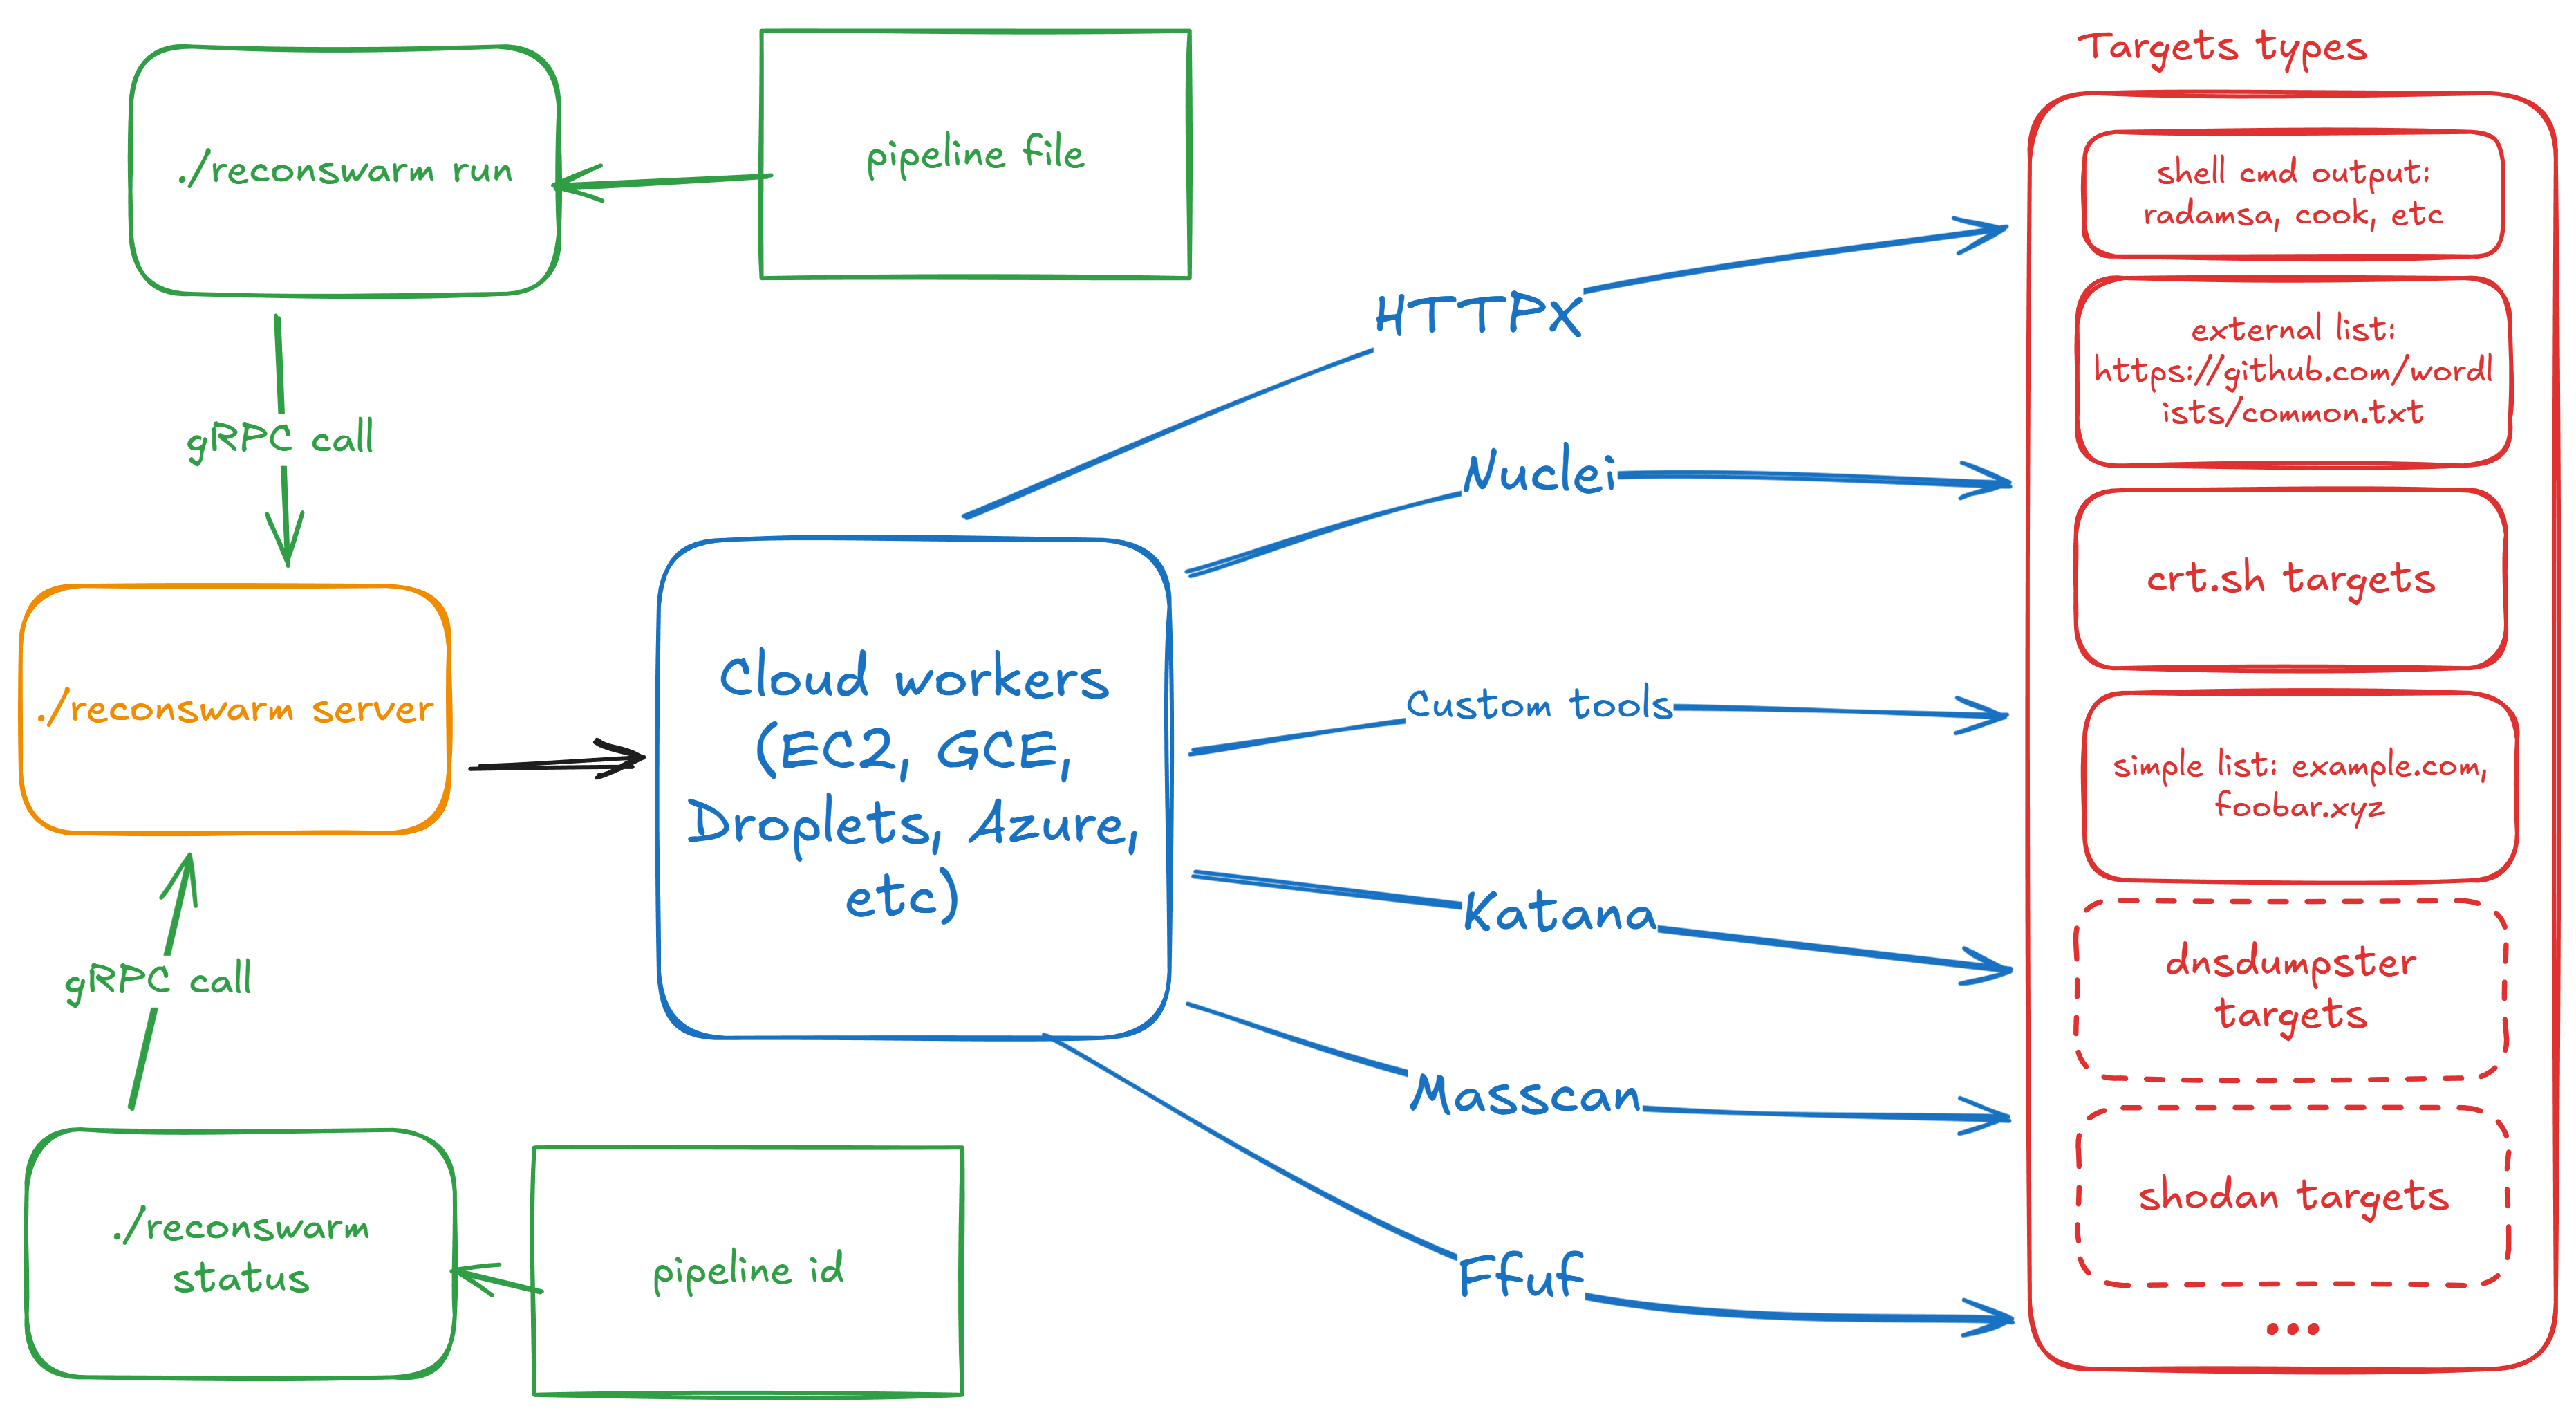
ReconSwarm ist ein modulares Reconnaissance-Automatisierungs-Framework für verteilte Sicherheitstests. Es stellt Cloud-Infrastruktur bereit, führt parallele Reconnaissance-Pipelines aus und sammelt Ergebnisse mit minimalem Konfigurationsaufwand.
ReconSwarm eignet sich für Bug-Bounty-Jäger, Penetrationstester, DevSecOps-Ingenieure und Sicherheitsforscher, die skalierbare, automatisierte Reconnaissance-Workflows ohne manuelles Infrastrukturmanagement benötigen.
ReconSwarm folgt einer modularen Architektur mit klarer Trennung der Zuständigkeiten zwischen Cloud-Bereitstellung, Fernsteuerung von Systemen, Pipeline-Ausführung und Konfigurationsmanagement.
ReconSwarm verwendet ein diskriminiertes Union-Muster für Cloud-Provisioner. Das Feld provisioner.type bestimmt, welche Anbieterkonfiguration aktiv ist:
provisioner:
  type: yandex_cloud  # Discriminator field
  yandex_cloud:       # Active when type: yandex_cloud
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    # ... provider-specific settings
Zusätzliche Cloud-Anbieter können durch Implementierung des Provisioner-Interfaces und Hinzufügen eines neuen Typs zur Factory integriert werden.
Stufen sind erweiterbare Komponenten, die Operationen auf Worker-VMs ausführen:
Alle Stufenfelder unterstützen die Vorlagenrendering. Neue Stufentypen können hinzugefügt werden, um die Funktionalität zu erweitern.
Der ReconSwarm-Server ist vollständig zustandslos – der gesamte Zustand wird in etcd persistiert:
Diese Architektur ermöglicht:
| Fähigkeit | Beschreibung |
|---|---|
| Horizontale Skalierung | Mehrere Serverinstanzen hinter einem Load Balancer ausführen |
| Neustarts ohne Ausfallzeit | Server neu starten, ohne Pipeline-Zustand zu verlieren |
| Absturzwiederherstellung | Neue Serverinstanz setzt dort fort, wo die vorherige aufgehört hat |
| Zustandsüberprüfung | etcd direkt zur Fehlerbehebung und Überwachung abfragen |
Hochverfügbarkeits-Setup:
                    ┌─────────────┐
                    │   Client    │
                    └──────┬──────┘
                           │
                    ┌──────▼──────┐
                    │Load Balancer│
                    └──────┬──────┘
              ┌────────────┼────────────┐
              │            │            │
       ┌──────▼──────┐ ┌───▼───┐ ┌──────▼──────┐
       │  Server 1   │ │Server2│ │  Server 3   │
       └──────┬──────┘ └───┬───┘ └──────┬──────┘
              │            │            │
              └────────────┼────────────┘
                           │
                    ┌──────▼──────┐
                    │ etcd cluster│
                    └─────────────┘
Alle Server nutzen denselben etcd-Cluster und können jede Anfrage bearbeiten. Wenn ein Server mitten in einer Pipeline abstürzt, kann ein anderer Server nach dem Auslesen des Zustands aus etcd die Ausführung fortsetzen.
Hinweis: Die aktuelle Implementierung führt Pipelines nach dem Laden aus etcd im Arbeitsspeicher aus. Eine vollständige Absturzwiederherstellung mit Pipeline-Fortsetzung ist für zukünftige Versionen geplant.
git clone <repository>
cd reconswarm
go mod download
task build
ReconSwarm trennt die Serverkonfiguration von der Pipelinekonfiguration:
| Konfigurationstyp | Datei | Beschreibung |
|---|---|---|
| Server | reconswarm.yaml | Cloud-Anbieter, etcd, Worker-Pool-Einstellungen |
| Pipeline | Separate YAML-Datei | Ziele und Stufen, über das Flag -f übergeben |
Die Serverkonfiguration wird in reconswarm.yaml gespeichert (konfigurierbar über die Umgebungsvariable CONFIG_PATH). Alle Zeichenfolgenwerte unterstützen die Umgebungsvariablen-Expansion mit ${VAR} oder $VAR-Syntax.
# Server settings
server:
  port: 50051

# Etcd connection for state management
etcd:
  endpoints:
    - "localhost:2379"
  dial_timeout: 5  # seconds
  username: ""     # optional, supports ${ETCD_USER}
  password: ""     # optional, supports ${ETCD_PASSWORD}

# Cloud provisioner (discriminated union)
provisioner:
  type: yandex_cloud  # Provider selector

  # Yandex Cloud configuration (active when type: yandex_cloud)
  yandex_cloud:
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    default_zone: "ru-central1-b"
    default_image: "fd8b1cmhmncn7lt4tqn4"
    default_username: "root"
    default_cores: 2
    default_memory: 2      # GB
    default_disk_size: 20  # GB

# Worker pool settings
workers:
  max_workers: 5
  setup_commands:
    - "apt update"
    - "apt install -y docker.io"
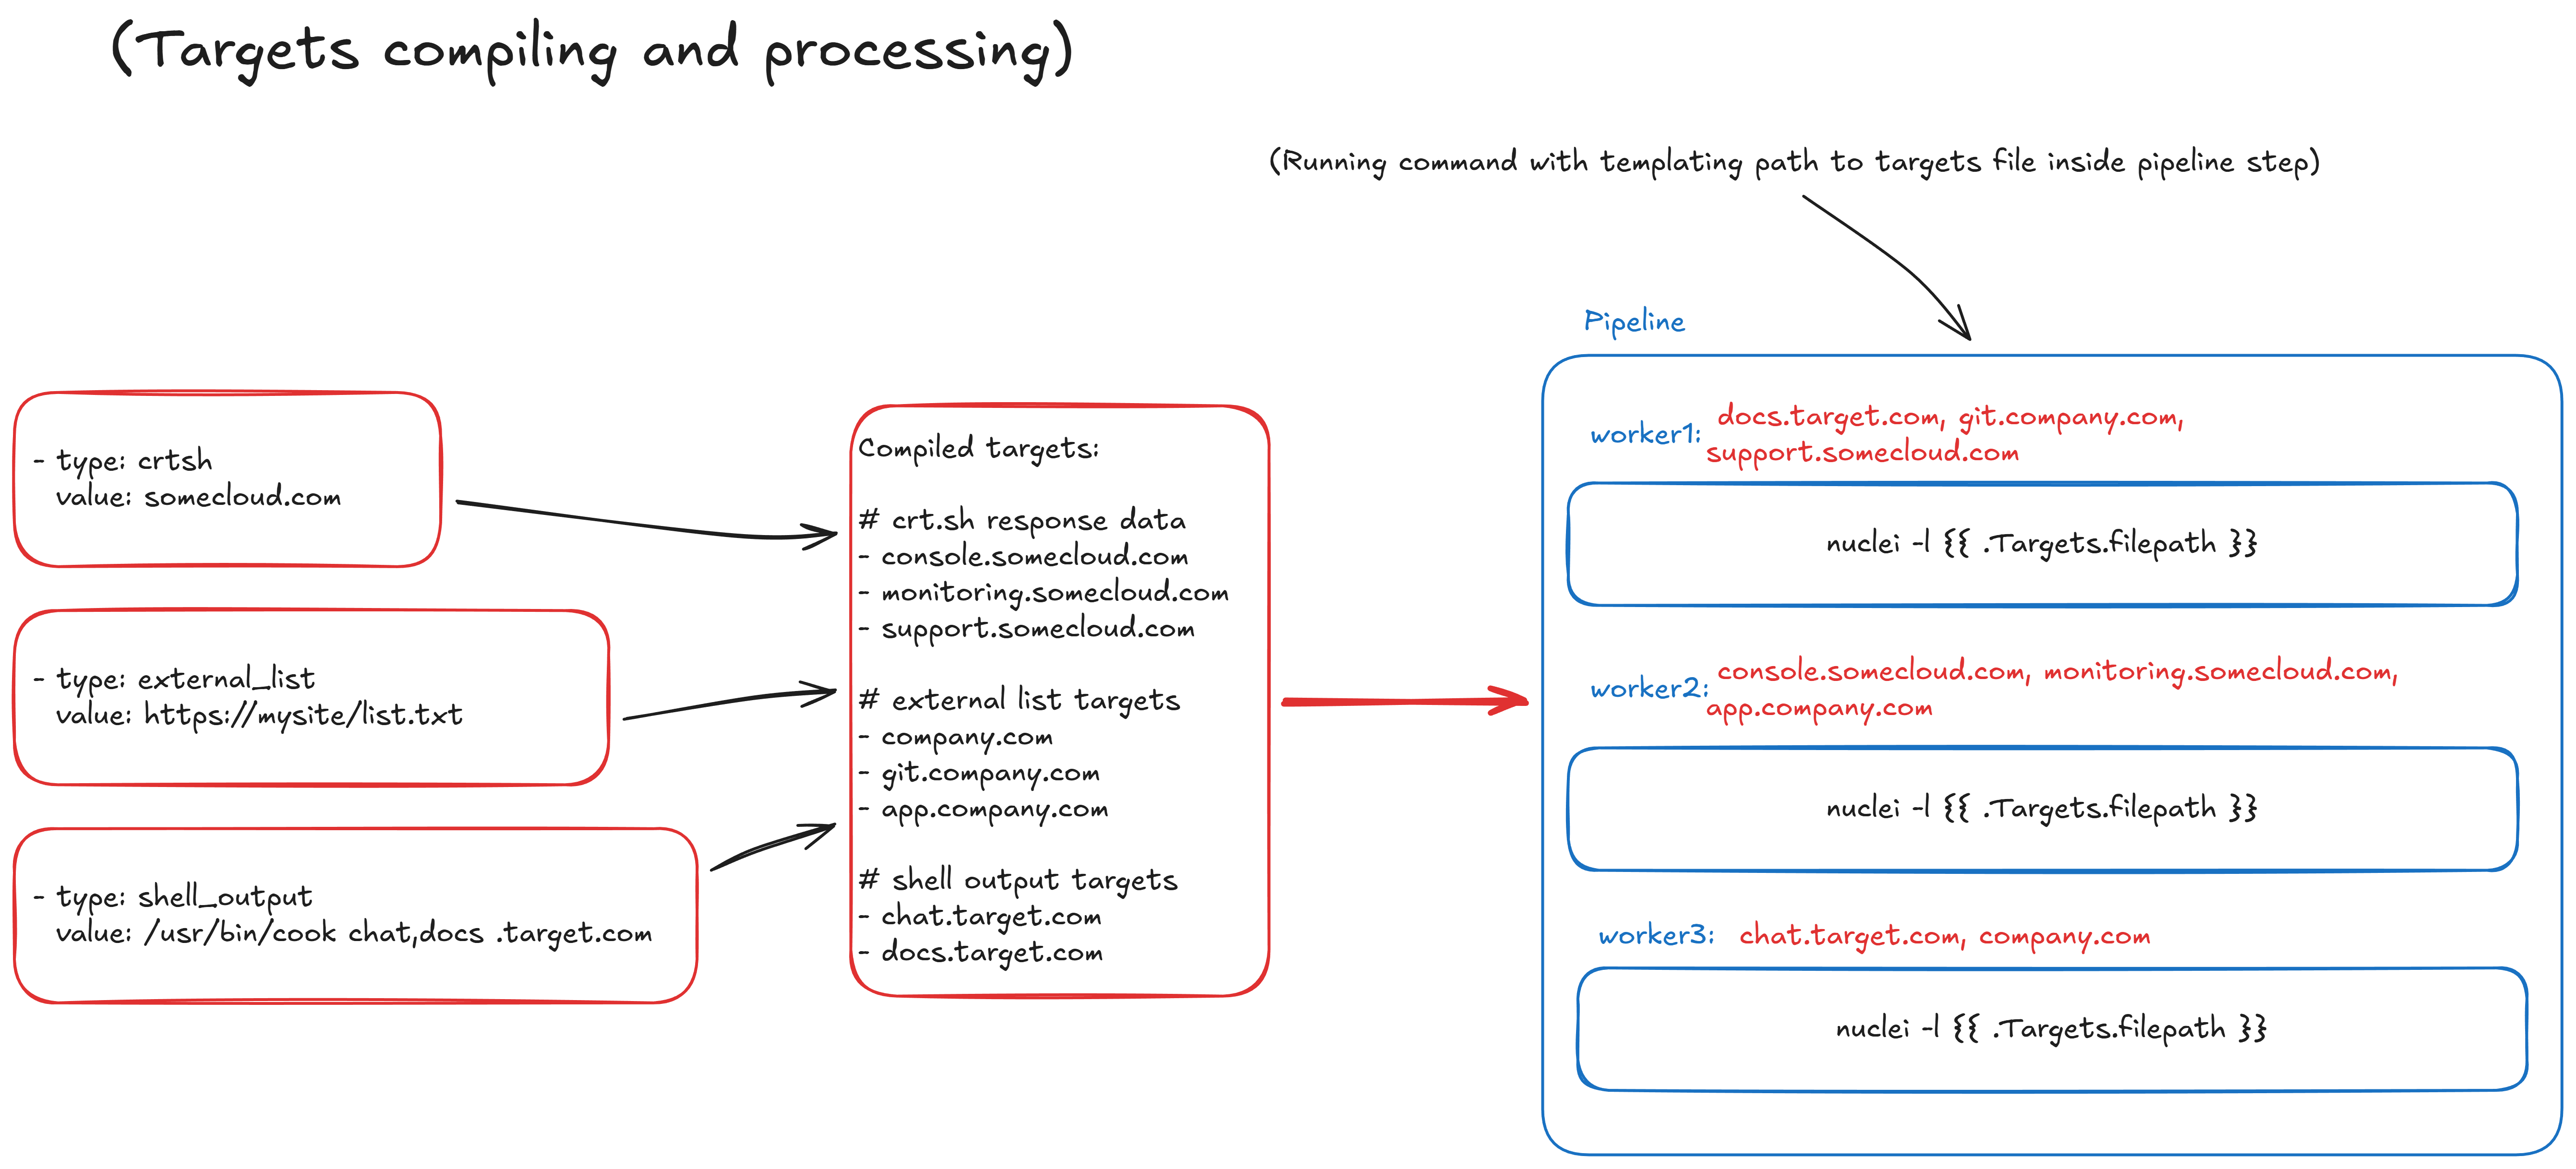
Die Pipeline-Konfiguration wird in einer separaten YAML-Datei gespeichert und über das Flag -f übergeben. Es werden sowohl das umschlossene als auch das nicht umschlossene Format unterstützt:
Umschlossenes Format (empfohlen):
# pipeline.yaml
pipeline:
  targets:
    - value: "example.com"
      type: crtsh
    - value: ["sub1.example.com", "sub2.example.com"]
      type: list
  stages:
    - name: "Run scanner"
      type: exec
      steps:
        - "nmap -sC -sV -iL {{.Targets.filepath}} -oN /opt/recon/scan.txt"
    - name: "Collect results"
      type: sync
      src: "/opt/recon/scan.txt"
      dest: "./results/{{.Worker.Name}}.txt"
Nicht umschlossenes Format (ebenfalls unterstützt):
# pipeline.yaml
targets:
  - value: "example.com"
    type: crtsh
stages:
  - name: "Run scanner"
    type: exec
    steps:
      - "nmap -iL {{.Targets.filepath}} -oN /opt/recon/scan.txt"
