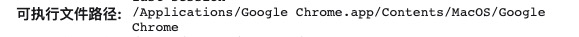
 qianlitp/crawlergo
Ein leistungsstarker Browser-Crawler für Web-Schwachstellenscanner


Ein leistungsstarker Browser-Crawler für Web-Schwachstellenscanner
Englisches Dokument | 中文文档
crawlergo ist ein Browser-Crawler, der den chrome headless-Modus zur URL-Sammlung nutzt. Er hakt an wichtigen Positionen der gesamten Webseite während der DOM-Rendering-Phase ein, füllt und sendet automatisch Formulare, löst intelligent JS-Ereignisse aus und sammelt so viele Einstiegspunkte wie möglich, die die Website preisgibt. Das integrierte URL-Deduplizierungsmodul filtert eine große Anzahl von Pseudo-Statik-URLs heraus, behält dennoch eine hohe Verarbeitungsgeschwindigkeit für große Websites und liefert schließlich eine hochwertige Sammlung von Anforderungsergebnissen.
crawlergo unterstützt derzeit die folgenden Funktionen:
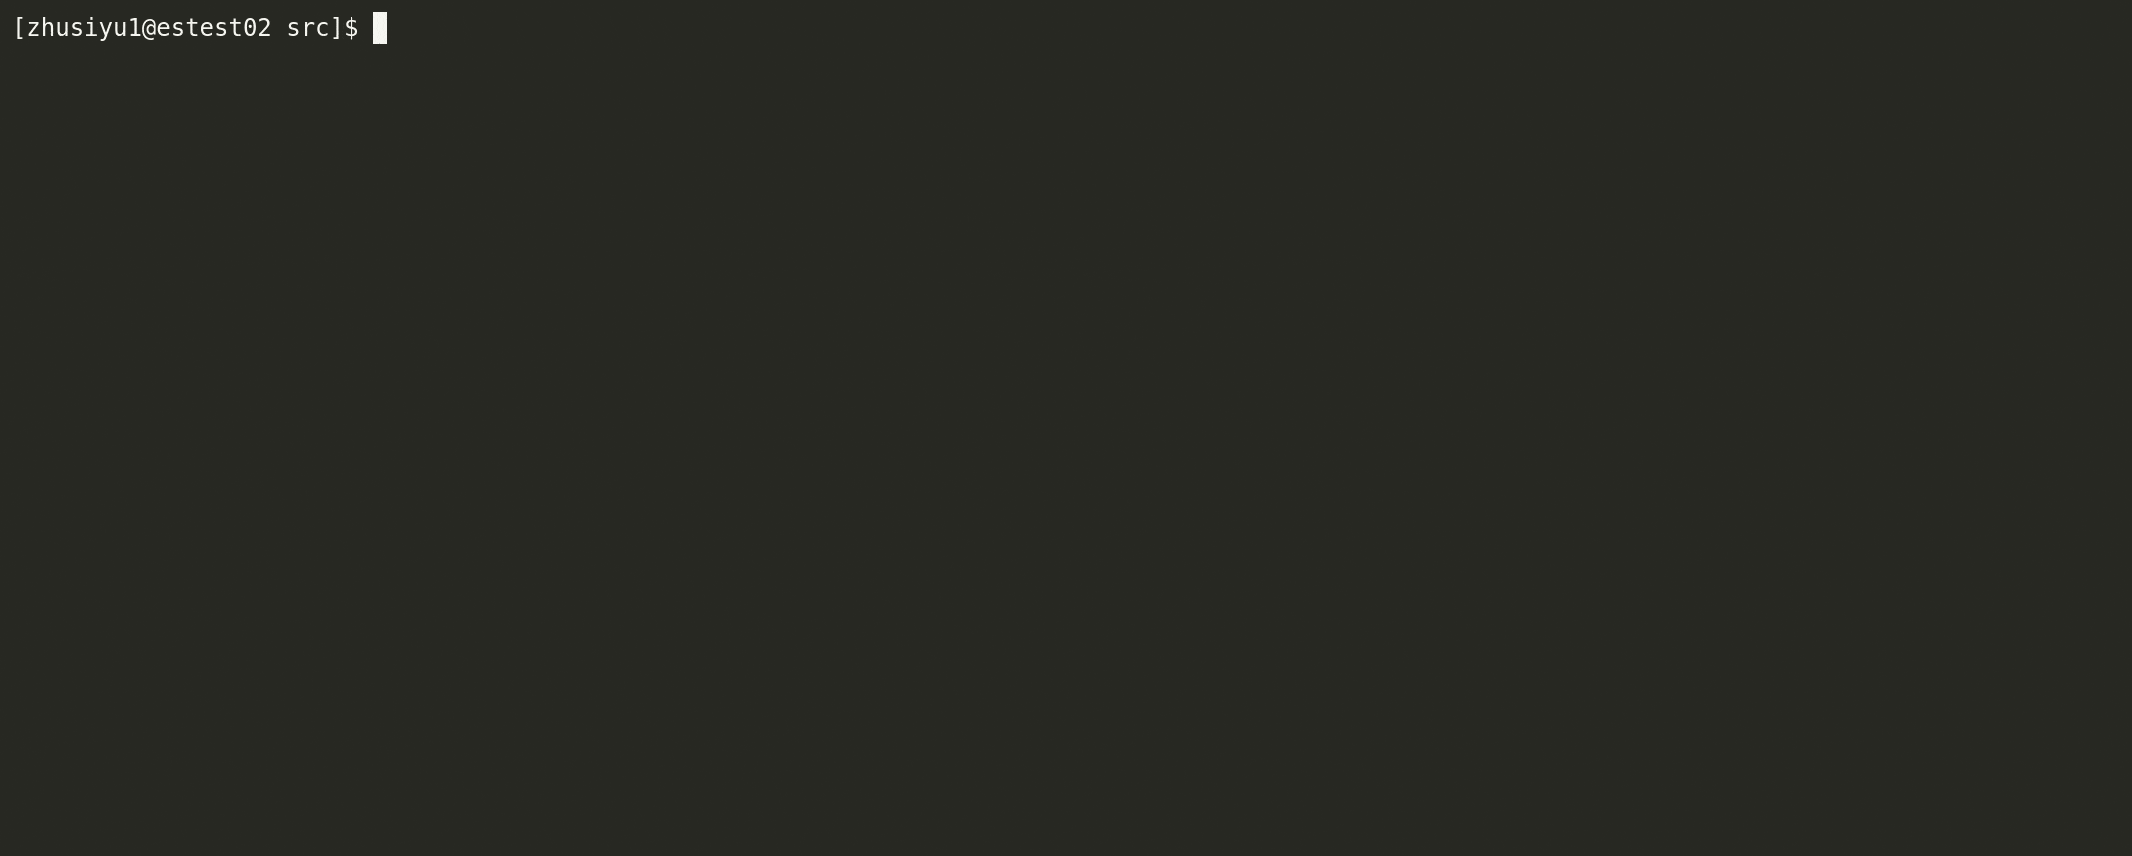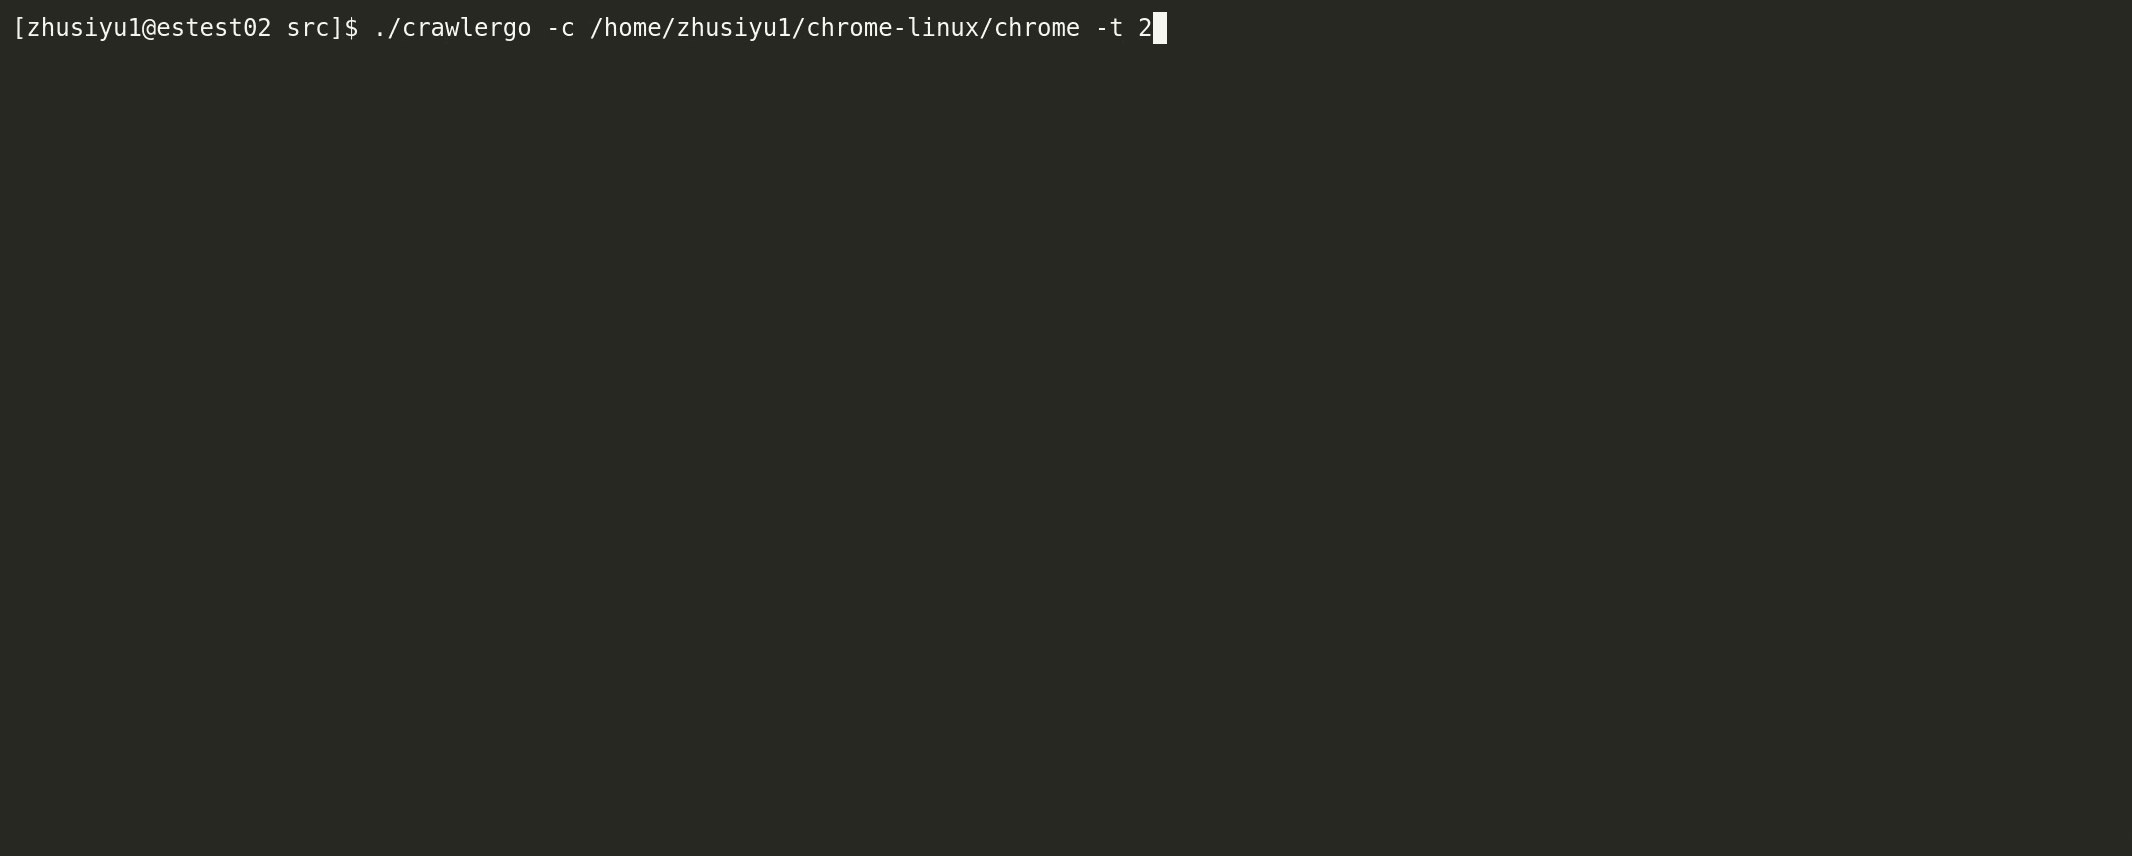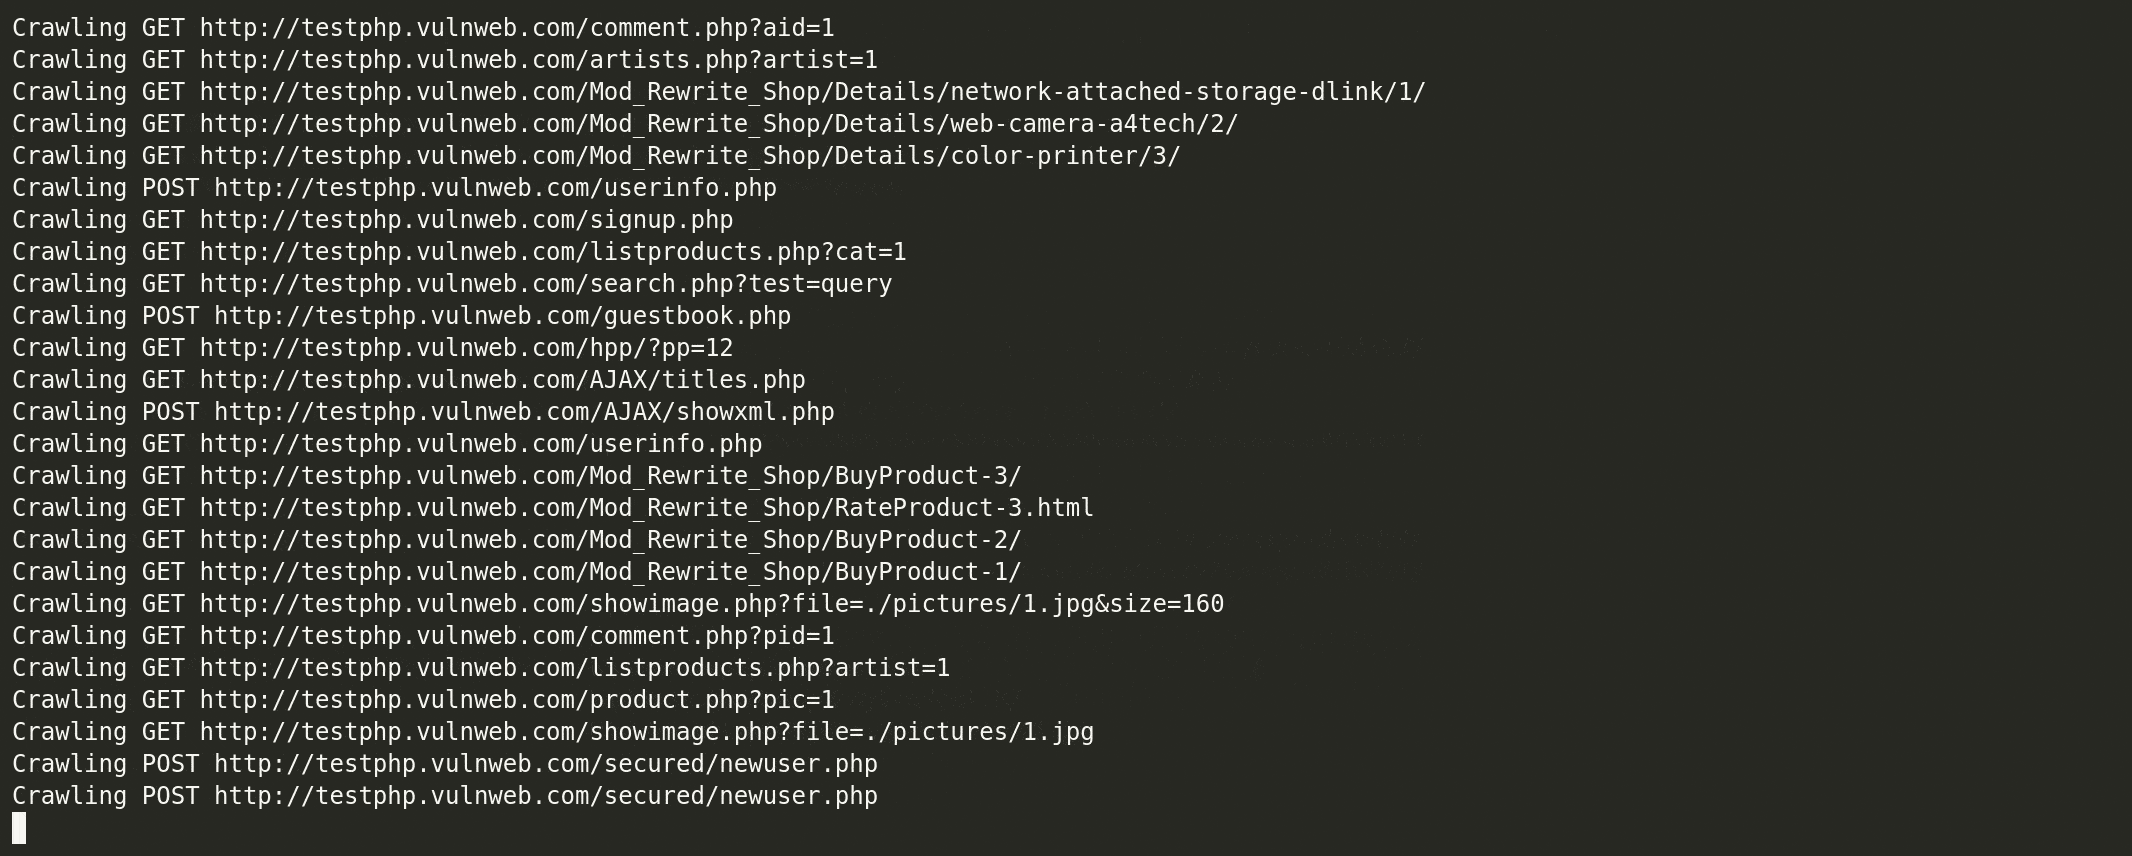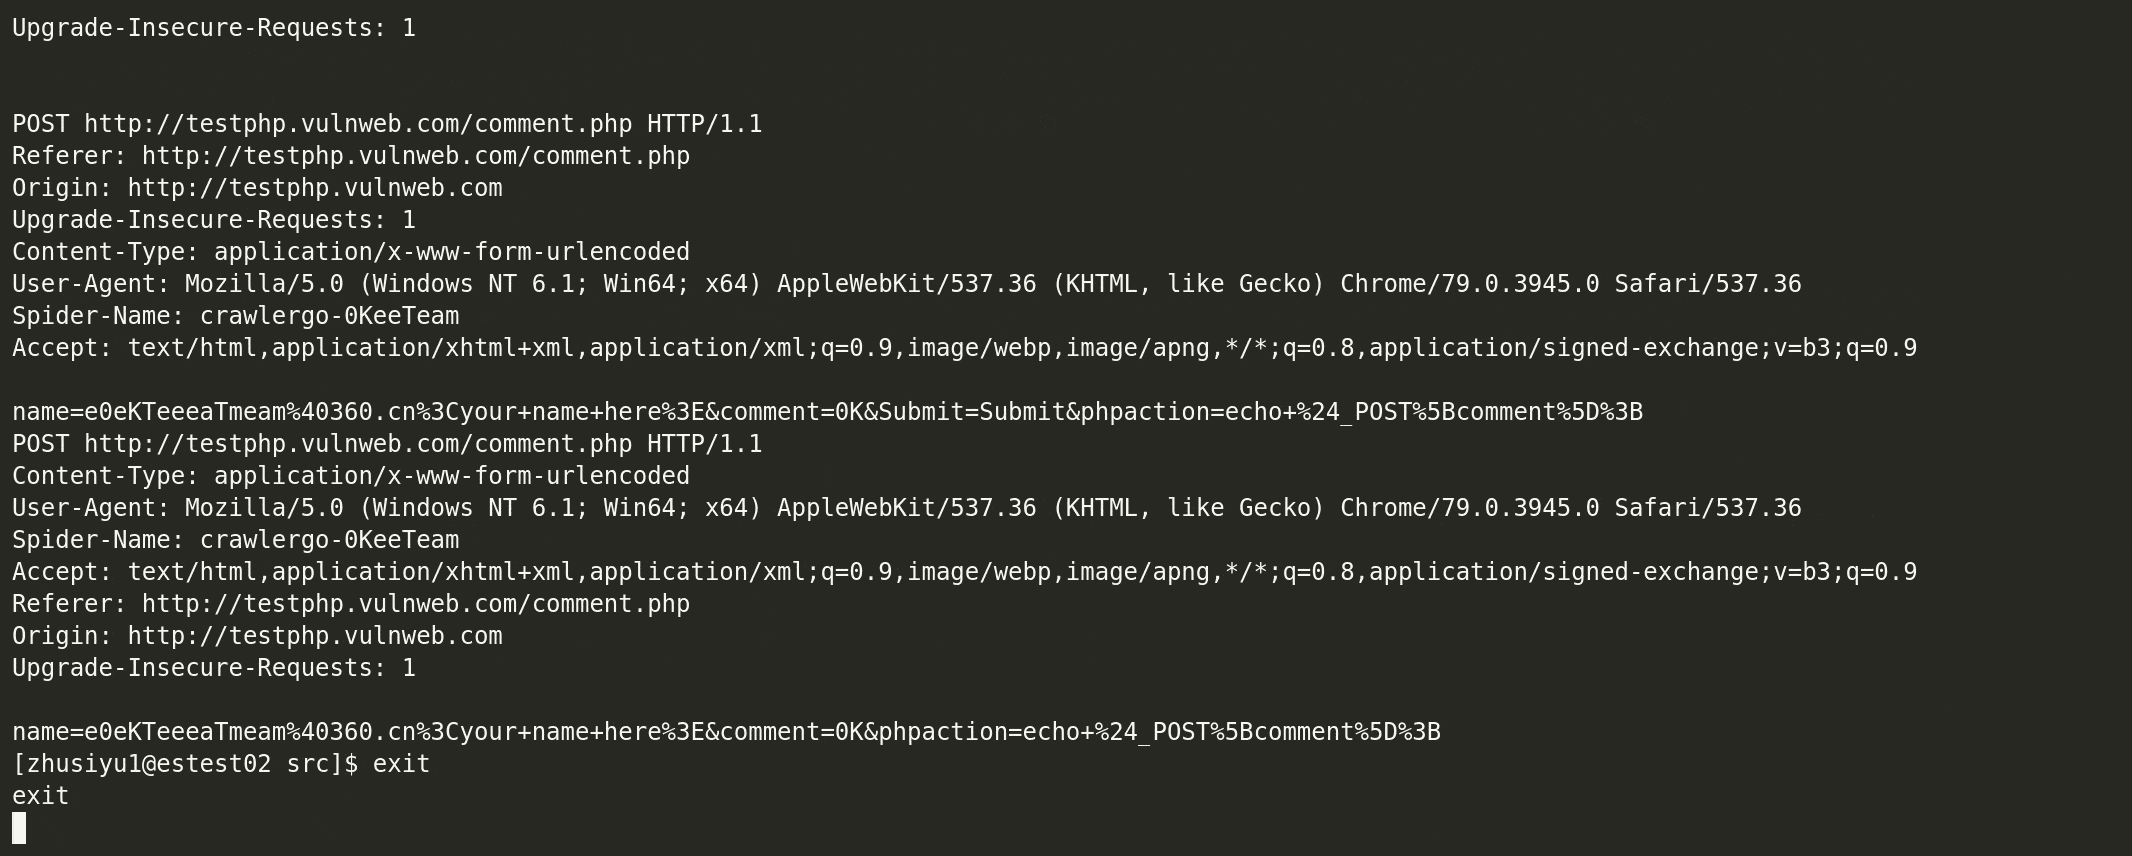
Bitte lesen und bestätigen Sie vor der Installation und Nutzung sorgfältig den Haftungsausschluss.
Build
make build
make build_all
Wenn Sie ein Linux-System verwenden und Chrome fehlende Abhängigkeiten meldet, lesen Sie bitte den Abschnitt zur Fehlerbehebung unten.
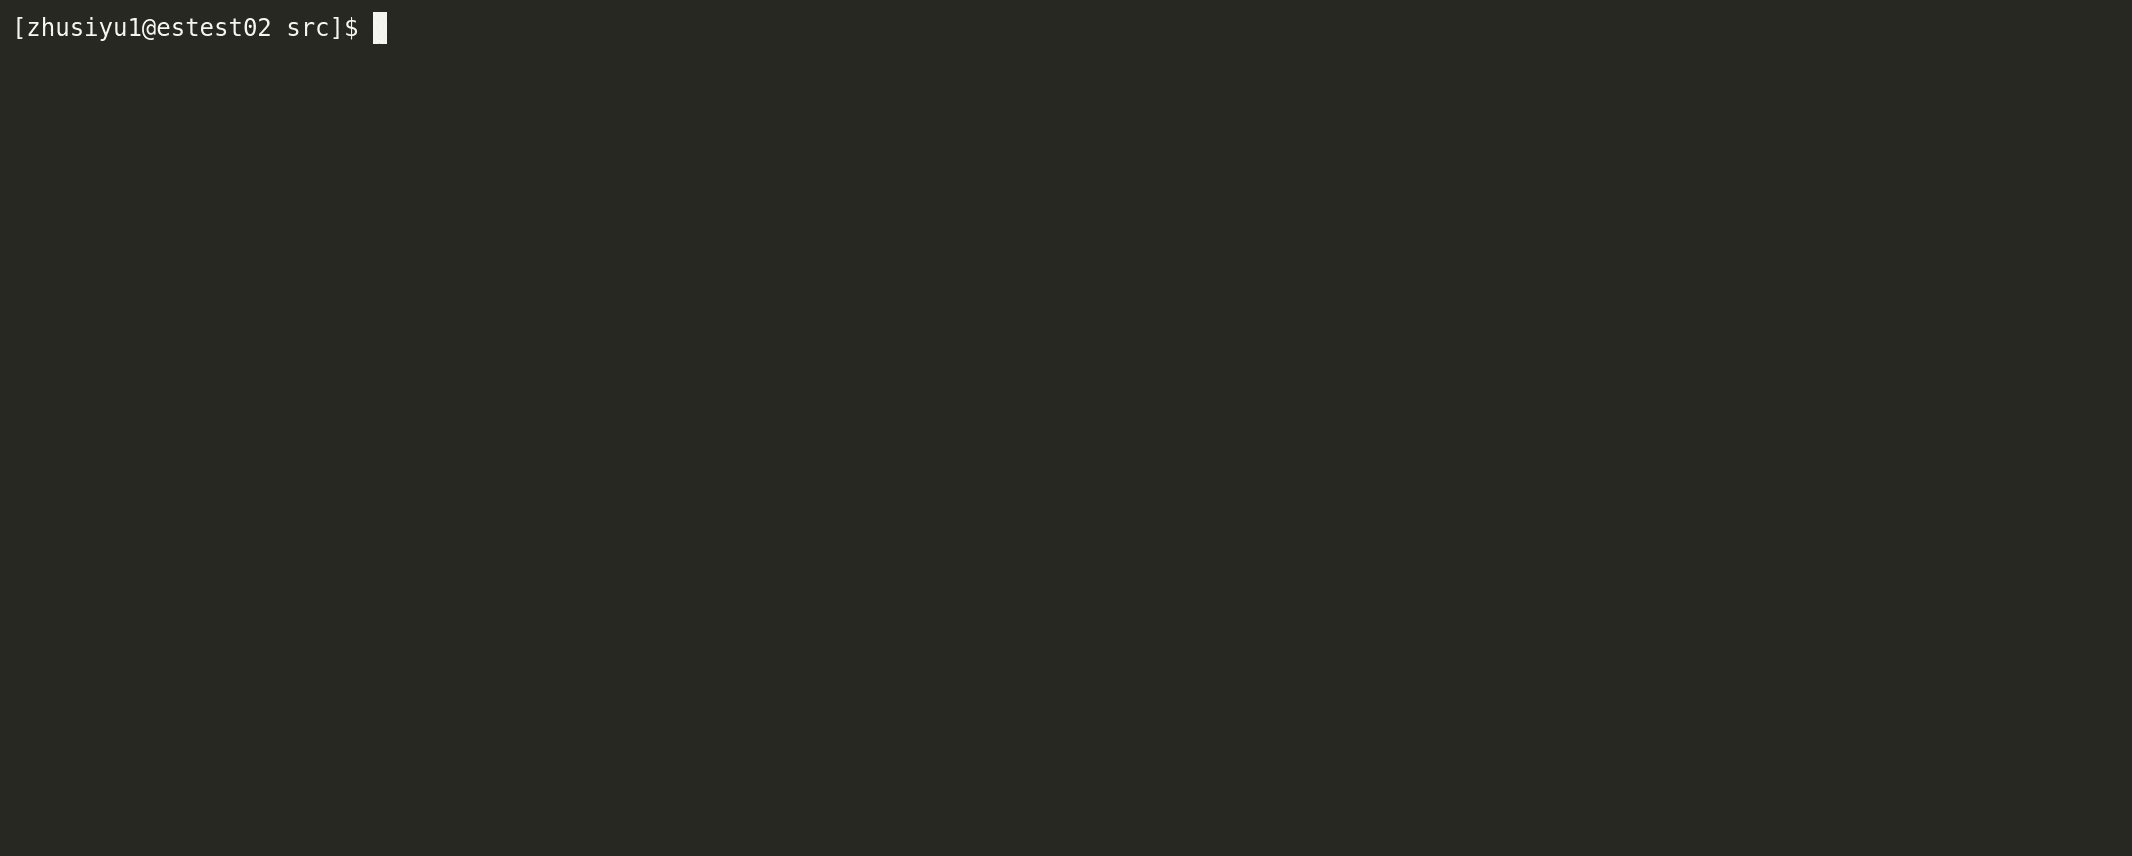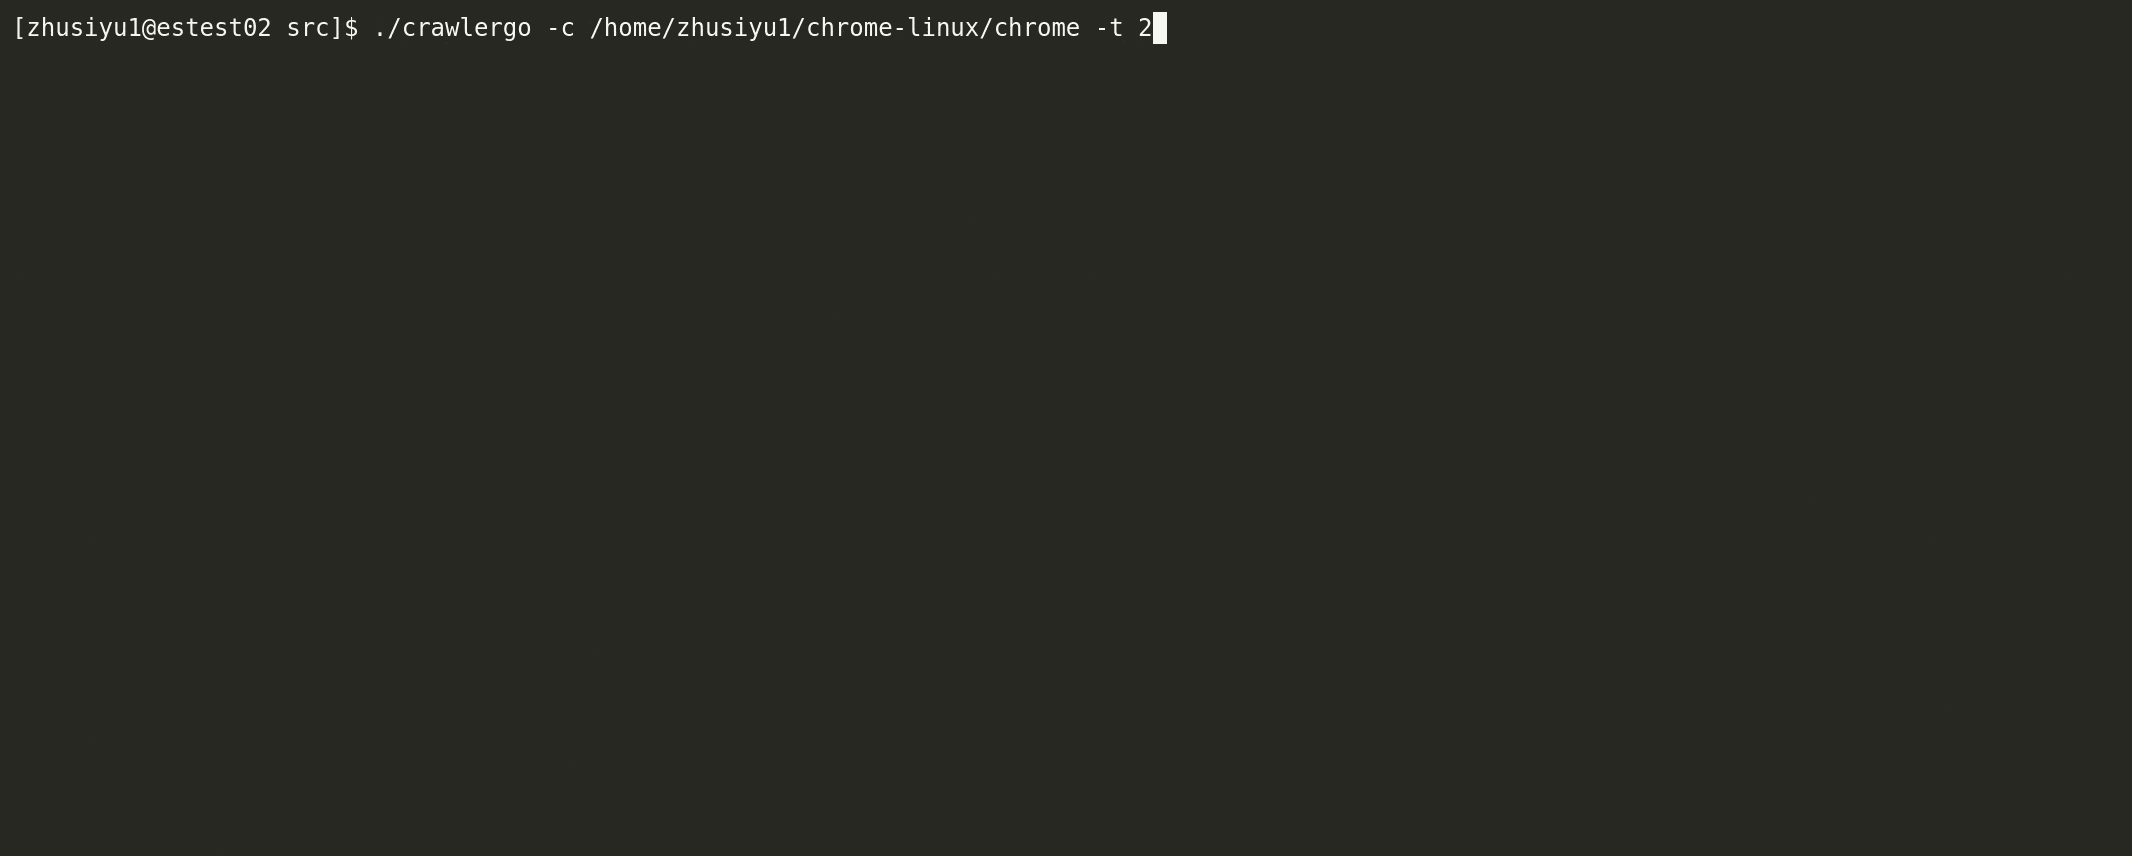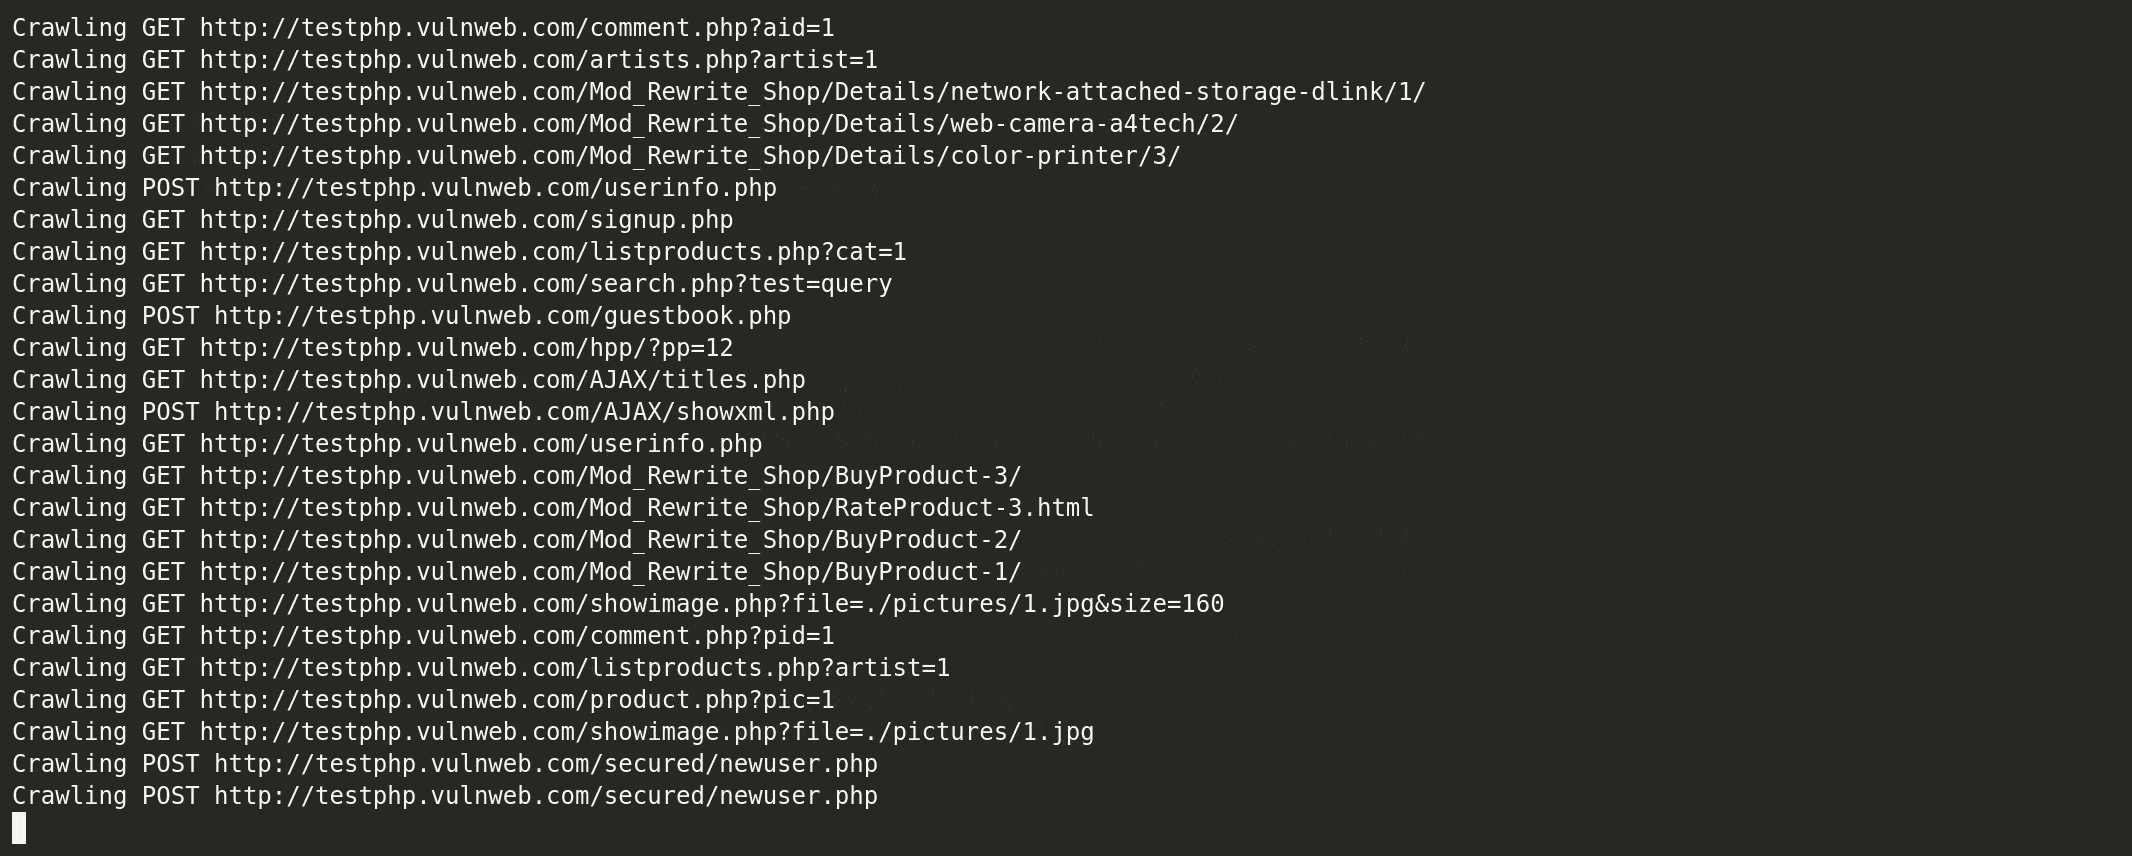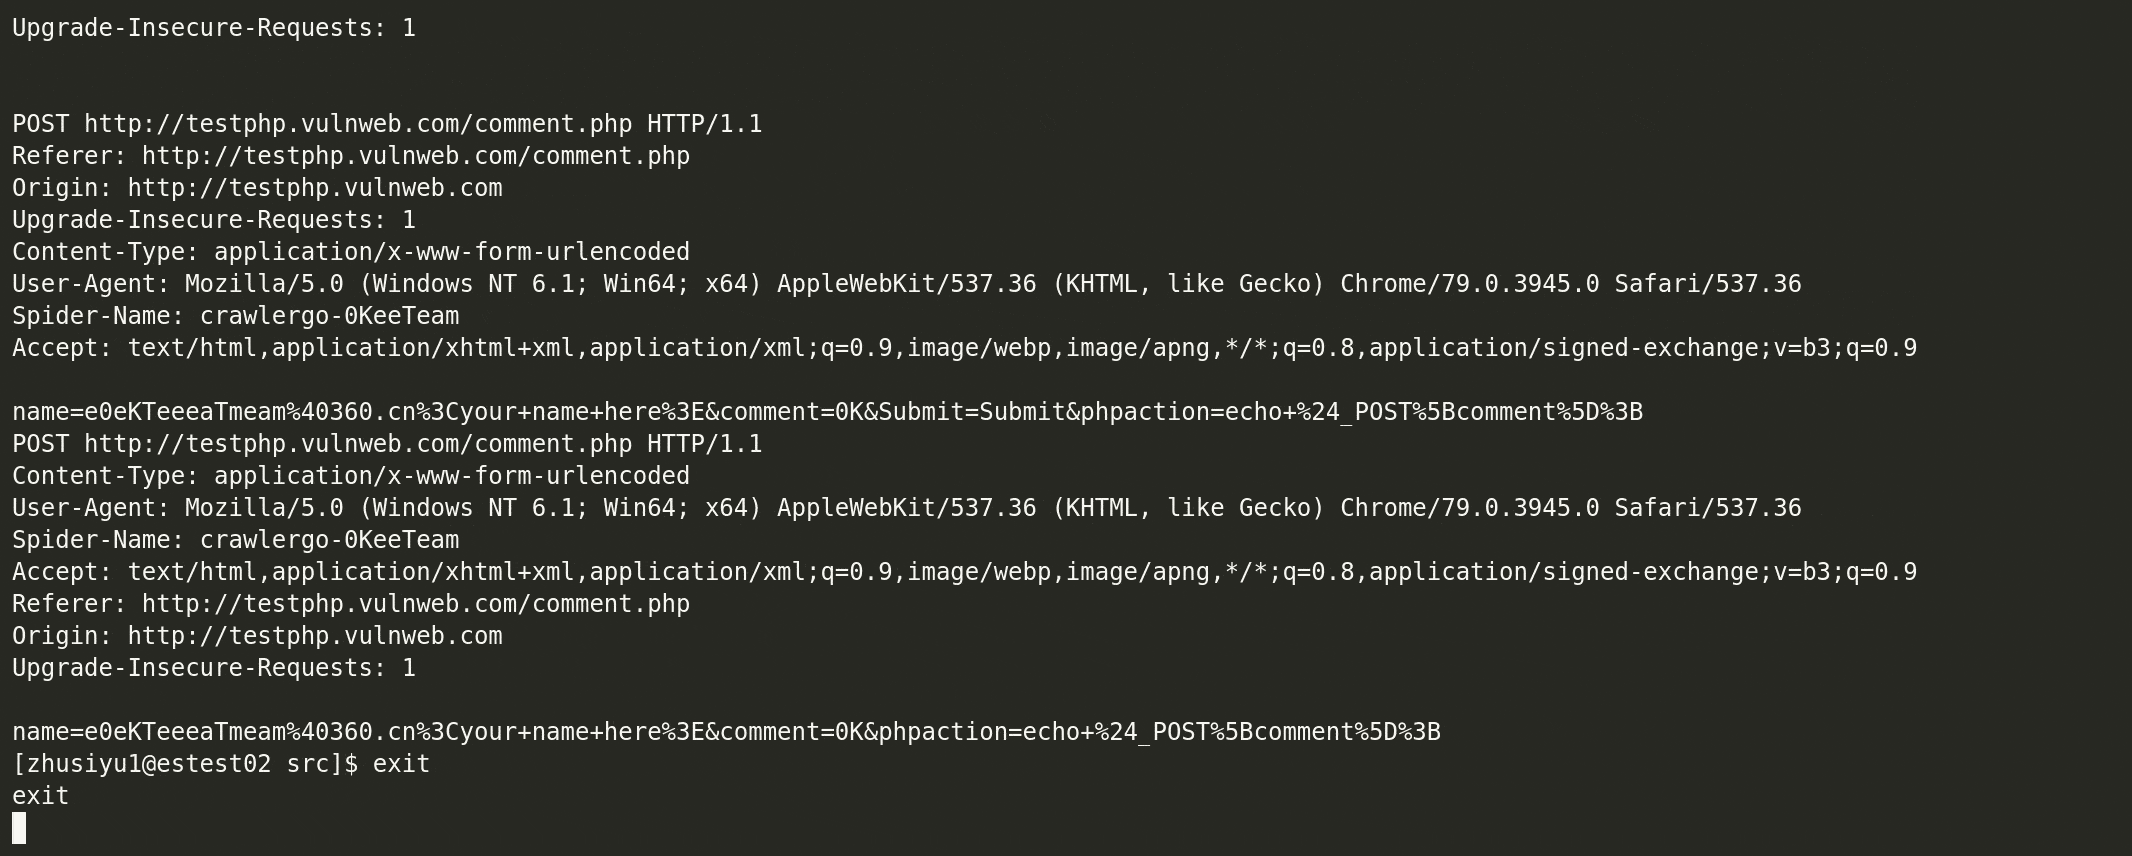
Angenommen, Ihr Chromium-Installationsverzeichnis ist /tmp/chromium/, stellen Sie 10 gleichzeitig geöffnete Tabs ein und crawlen Sie testphp.vulnweb.com:
bin/crawlergo -c /tmp/chromium/chrome -t 10 http://testphp.vulnweb.com/
Sie können dies auch problemlos mit Docker nutzen:
git clone https://github.com/Qianlitp/crawlergo
docker build . -t crawlergo
docker run crawlergo http://testphp.vulnweb.com/
bin/crawlergo -c /tmp/chromium/chrome -t 10 --request-proxy socks5://127.0.0.1:7891 http://testphp.vulnweb.com/
Standardmäßig gibt crawlergo die Ergebnisse direkt auf dem Bildschirm aus. Als nächstes setzen wir den Ausgabemodus auf json, und der Beispielcode zum Aufruf mit Python sieht wie folgt aus:
#!/usr/bin/python3
# coding: utf-8

import simplejson
import subprocess


def main():
    target = "http://testphp.vulnweb.com/"
    cmd = ["bin/crawlergo", "-c", "/tmp/chromium/chrome", "-o", "json", target]
    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    output, error = rsp.communicate()
	#  "--[Mission Complete]--"  is the end-of-task separator string
    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])
    req_list = result["req_list"]
    print(req_list[0])


if __name__ == '__main__':
    main()
Wenn der Ausgabemodus auf json gesetzt ist, enthält das zurückgegebene Ergebnis nach der JSON-Deserialisierung vier Teile:
all_req_list : Alle während dieser Crawl-Aufgabe gefundenen Anfragen, einschließlich aller Ressourcentypen von anderen Domains.req_list : Gibt die aktuellen Domain-Ergebnisse dieser Crawl-Aufgabe zurück, pseudo-statisch dedupliziert, ohne statische Ressourcen-Links. Es ist eine Teilmenge von all_req_list.all_domain_list : Liste aller gefundenen Domains.sub_domain_list : Liste der gefundenen Subdomains.crawlergo gibt die vollständigen Anfragen und URLs zurück, die auf verschiedene Weise genutzt werden können:
In Verbindung mit anderen passiven Web-Schwachstellenscannern
Starten Sie zuerst einen passiven Scanner und setzen Sie die Abhöradresse auf: http://127.0.0.1:1234/
Gehen Sie als nächstes davon aus, dass crawlergo sich auf demselben Rechner wie der Scanner befindet, starten Sie crawlergo und setzen Sie den Parameter:
--push-to-proxy http://127.0.0.1:1234/
Host-Binding (nicht verfügbar für höhere Chrome-Versionen) (Beispiel)
Benutzerdefinierte Cookies (Beispiel)
Regelmäßige Bereinigung der von crawlergo erzeugten Zombie-Prozesse (Beispiel), beigetragen von @ring04h
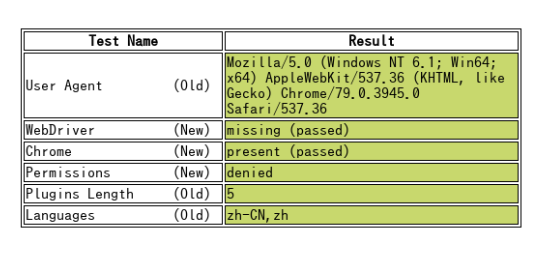
crawlergo kann standardmäßig die Headless-Modus-Erkennung umgehen.
https://intoli.com/blog/not-possible-to-block-chrome-headless/chrome-headless-test.html
'Fetch.enable' wurde nicht gefunden
Fetch ist eine Funktion, die von neueren Chrome-Versionen unterstützt wird. Wenn dieser Fehler auftritt, ist Ihre Version zu niedrig. Bitte aktualisieren Sie die Chrome-Version.
Chrom läuft mit fehlenden Abhängigkeiten wie xxx.so
// Ubuntu
apt-get install -yq --no-install-recommends \
     libasound2 libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 \
     libexpat1 libfontconfig1 libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 \
     libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 libgbm1 \
     libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 libxrender1 libxss1 libxtst6 libnss3

// CentOS 7
sudo yum install pango.x86_64 libXcomposite.x86_64 libXcursor.x86_64 libXdamage.x86_64 libXext.x86_64 libXi.x86_64 \
     libXtst.x86_64 cups-libs.x86_64 libXScrnSaver.x86_64 libXrandr.x86_64 GConf2.x86_64 alsa-lib.x86_64 atk.x86_64 gtk3.x86_64 \
     ipa-gothic-fonts xorg-x11-fonts-100dpi xorg-x11-fonts-75dpi xorg-x11-utils xorg-x11-fonts-cyrillic xorg-x11-fonts-Type1 xorg-x11-fonts-misc -y

sudo yum update nss -y
Ausführung meldet Navigation timeout / Browser nicht gefunden / korrekter Browser-Ausführungspfad unbekannt
Stellen Sie sicher, dass der Ausführungspfad des Browsers korrekt konfiguriert ist. Geben Sie in der Adressleiste chrome://version ein und finden Sie den Pfad zur ausführbaren Datei: