

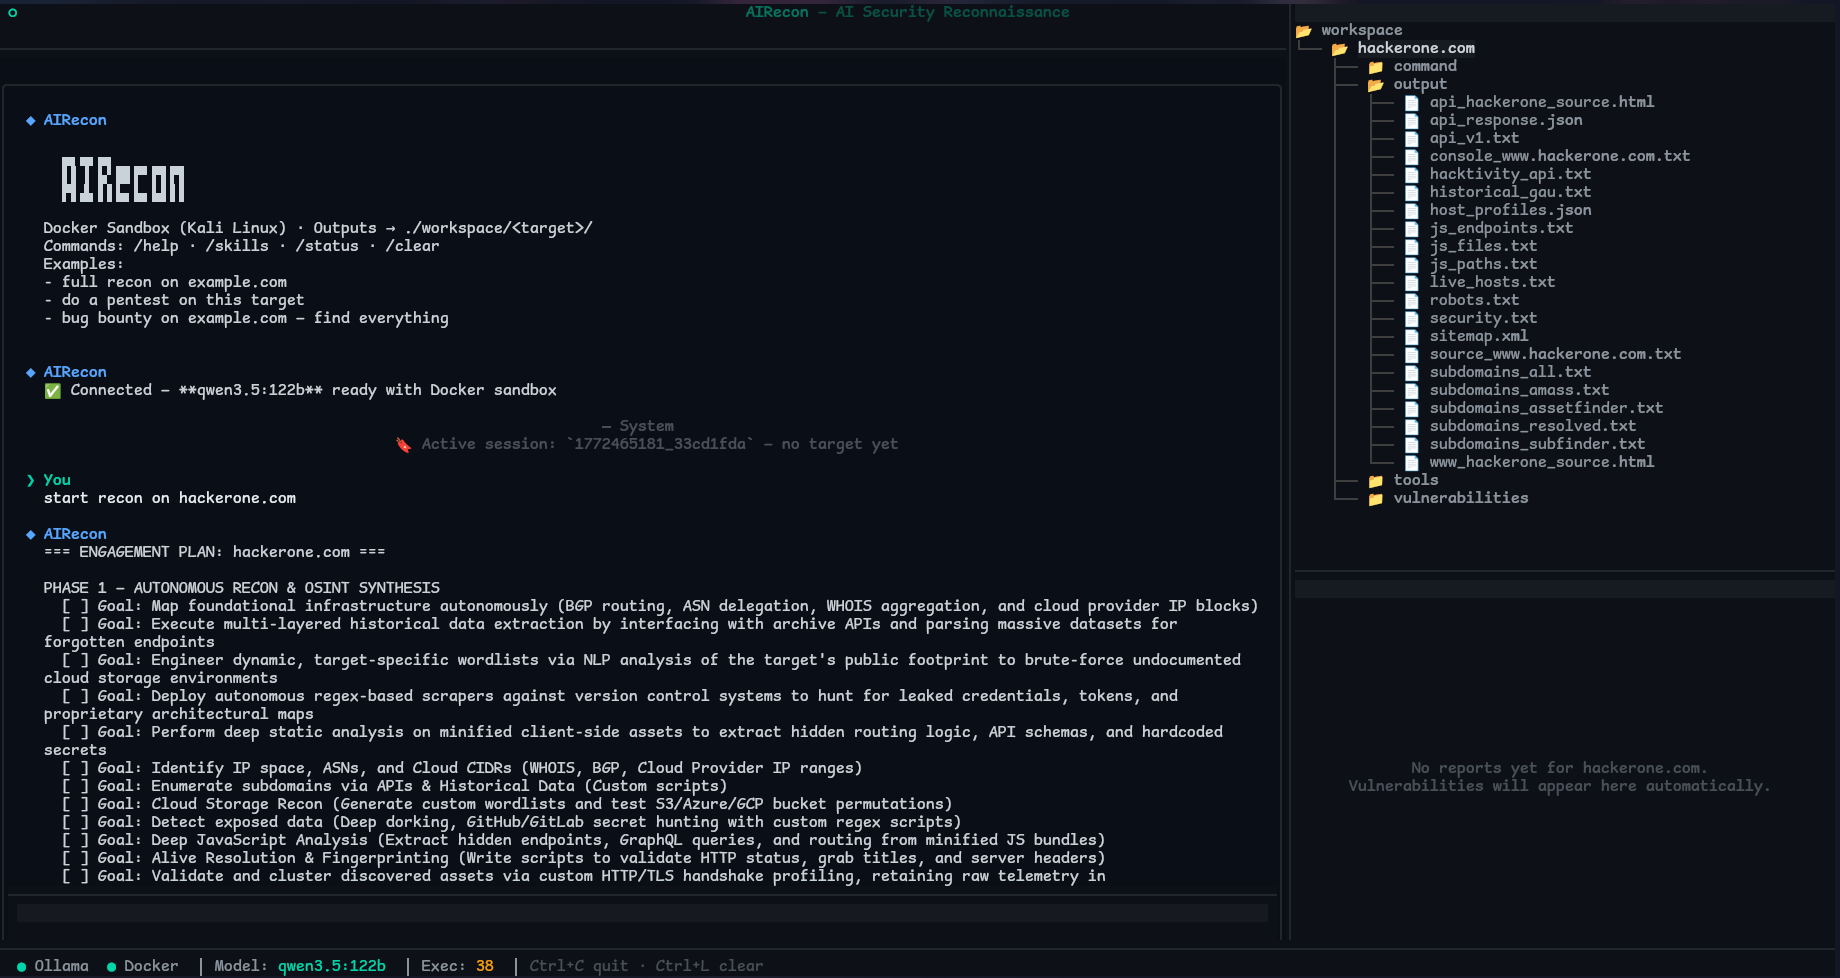
AIRecon ist ein autonomer Cybersecurity-Agent, der ein selbst gehostetes Large Language Model (Ollama) mit einer Kali-Linux-Docker-Sandbox und einer Textual-TUI kombiniert. Er wurde entwickelt, um Sicherheitsbewertungen, Penetrationstests und Bug-Bounty-Aufklärung zu automatisieren — ganz ohne API-Schlüssel oder Cloud-Abhängigkeit.


AIRecon ist ein autonomer Penetration-Testing-Agent, der jedes OpenAI-kompatible LLM-Gateway (LiteLLM / vLLM / einen gehosteten Endpunkt – oder ein lokales Gateway, das ein lokales Ollama proxyt) mit einer Kali Linux Docker-Sandbox, einer nativen Caido-Proxy-Integration, einer strukturierten RECON → ANALYSIS → EXPLOIT → REPORT-Pipeline und einer Echtzeit-Textual-TUI ansteuert.
Von Grund auf Backend-agnostisch. Richte AIRecon auf ein lokales Gateway (LiteLLM / vLLM oder ein Gateway, das ein lokales Ollama proxyt) für einen vollständig offline / privaten Betrieb aus, oder auf einen gehosteten OpenAI/Anthropic/Gemini-kompatiblen Endpunkt für maximale Reasoning-Qualität. Die Reasoning-Unterstützung wird zur Laufzeit automatisch erkannt – kein Hardcoding pro Modell.
Swiftproxy bietet über 90 Mio. saubere Residential-IPs in mehr als 220 Standorten, unterstützt HTTP(S)/SOCKS5, IP-Rotation, Sticky Sessions und präzises Geo-Targeting. Es hilft KI-gestützten Recherche- und Reconnaissance-Workflows, zuverlässig von verschiedenen Standorten aus auf Websites zuzugreifen, und eignet sich damit für Web-Recherche, Datenerfassung, Scraping und standortbasierten Zugriff.
Kostenlose Tests sind verfügbar, mit 10 % Rabatt bei Verwendung des Codes PROXY90.
AIRecon kommuniziert mit einem einzigen OpenAI-kompatiblen Gateway, sodass du den Kompromiss selbst wählst – betreibe ein lokales Modell für Datenschutz und null API-Kosten oder ein gehostetes Modell für höchste Reasoning-Qualität. Derselbe Agent, dieselbe Pipeline, dieselbe Sandbox und dasselbe Tooling funktionieren in beiden Fällen.
| Funktion | AIRecon |
|---|---|
| Backend | Jedes OpenAI-kompatible Gateway (LiteLLM / vLLM / gehostet) |
| Vollständig offline / keine API-Schlüssel | Ja – bei Verwendung eines lokalen Gateways (vLLM oder ein Gateway → lokales Ollama) |
| Reasoning-Erkennung | Automatisch zur Laufzeit (kein Hardcoding von Modellnamen) |
| Caido-Integration | Nativ |
| Scope-Guard + Audit-Log | Ja – Ziele außerhalb des Geltungsbereichs werden abgelehnt, jeder Befehl wird protokolliert |
| Lernen nur aus verifizierten Ergebnissen | Ja – das Gehirn baut auf bewiesenen Erkenntnissen auf, nicht auf Rauschen |
| Sitzungswiederaufnahme (Chat + Tool-Aufrufe) | Ja |
| Lokale Wissensdatenbank | ~1,09 Mio. Datensätze (optional) |
§FUZZ§), findings, scope, sitemap, intercept.dataset_search autonom auf, bevor es unbekannte Techniken versucht — und verankert seine Entscheidungen in realen indexierten Daten.RECON → ANALYSIS → EXPLOIT → REPORT
Jede Phase hat spezifische Ziele, empfohlene Tools und automatische Übergangskriterien. Die Phasendurchsetzung ist weich — der Agent wird geleitet, aber nie blockiert. Checkpoints laufen alle 5 (Phasen-Evaluierung), 10 (Selbst-Evaluierung) und 15 (Kontextkomprimierung) Iterationen.
AIRecon fine-tuned das LLM nicht. Sein „Lernen" ist lokale, strukturierte Telemetrie, die die Tool-Auswahl leitet und das Wiederholen fehlgeschlagener Pfade vermeidet.
Lokale Persistenz (alles auf der Festplatte, keine Cloud):
~/.airecon/memory/airecon.db, die Sitzungen, Findings, Muster, Ziel-Intelligence, Tool-Nutzung, Modellleistung, Skill-Nutzung und Attack-Chain-Entdeckungen speichert.~/.airecon/learning/global_learning.json (Tool-Leistungsstatistiken, Strategiemuster, Beobachtungsprotokoll, destillierte Erkenntnisse).~/.airecon/memory/by_target/, wenn persistiert, die Endpunkte, Schwachstellen, WAF-Bypasses, sensible Parameter und Auth-Endpunkte enthalten.workspace/<target>/payload_memory.json gespeichert werden, wenn die Sitzungspersistenz läuft.Wie es das Verhalten beeinflusst:
tech_correlations-Datensatz — so werden Datensätze ab Iteration 1 als Gehirn genutzt.intelligence_memory_recall_interval Iterationen (Standard 4) werden gelernte Muster / Kaltstart-Wissen basierend auf erkannter Technologie erneut injiziert; die Korrelation läuft alle intelligence_correlation_interval (Standard 6).intelligence_learn_only_verified, standardmäßig aktiv).intelligence_adaptive_min_observations (Standard 2) Beobachtungen.
