
 nvidia-nemo/guardrails
Programmierbare Guardrails für LLM-Chat-Apps: Eingabe-/Ausgabe-Regeln durchsetzen, Jailbreaks und Prompt-Injections blockieren, Halluzinationen erkennen und sensible Daten maskieren.

# NVIDIA NeMo Guardrails Bibliothek
[](https://opensource.org/licenses/Apache-2.0)
[](https://pypi.org/project/nemoguardrails)
[](https://pypi.org/project/nemoguardrails)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/pr-tests.yml)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/full-tests.yml)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/full-tests.yml)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/lint.yml)
[](https://docs.nvidia.com/nemo/guardrails)
[](https://pepy.tech/project/nemoguardrails)
[](https://pepy.tech/project/nemoguardrails)
[Dokumentation](https://docs.nvidia.com/nemo/guardrails/latest/about-nemo-guardrails-library/overview) · [Schnellstart](#quickstart) · [Anwendungsfälle](#what-you-can-build) · [Integrationen](#choose-your-integration) · [Guardrail-Katalog](#guardrail-catalog) · [Beispiele](https://github.com/nvidia-nemo/guardrails/blob/develop/examples) · [Community](#community-usage) · [Sicherheit](https://github.com/nvidia-nemo/guardrails/blob/develop/SECURITY.md) · [Releases](https://github.com/NVIDIA-NeMo/Guardrails/releases) · [Changelog](https://github.com/nvidia-nemo/guardrails/blob/develop/CHANGELOG.md)
NeMo Guardrails ist eine Open-Source-Bibliothek zur Anwendung programmierbarer Sicherheits- und Schutzmaßnahmen auf LLM- und agentische Anwendungen. Agenten führen Befehle aus, rufen APIs auf, fragen Ihre Daten ab und lesen das Web. Konversationelle Anwendungen wenden Eingabe- und Ausgabeprüfungen an; Retrieval-Augmented-Generation-(RAG-)Systeme filtern abgerufene Inhalte und prüfen Antworten gegen Belege.
Sie verwenden die NeMo Guardrails Bibliothek, um in einer Policy zu deklarieren, was jeder Agent tun darf, und kombinieren dabei lokale Regeln mit geringer Latenz mit modellgestützten Prüfungen auf Jailbreaks, eingeschleuste Anweisungen und unsichere Tool-Aufrufe. Ihre Anwendung oder Ihr Agent-Harness führt diese Prüfungen aus und nutzt deren Ergebnisse, um zu entscheiden, ob fortgefahren wird.
```bash
pip install nemoguardrails
```
Erfordert Python 3.11–3.13. Siehe [Installationsanleitung](https://docs.nvidia.com/nemo/guardrails/latest/get-started/installation-guide) für optionale Pakete und die Einrichtung.
> [!NOTE]
> Version 0.25.0 macht `LLMRails` veraltet, die Entfernung ist frühestens für 0.27.0 geplant. Verwenden Sie `Guardrails` für neue Integrationen und folgen Sie dem [Migrationsleitfaden](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/migration/0.25.mdx).
## Was Sie erstellen können
- **KI-Agenten und Coding-Assistenten:** Prüfen Sie vorgeschlagene Tool-Aufrufe und zurückgegebene Ergebnisse mit [Tool-Rails](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-calling.mdx) oder verbinden Sie einen Agenten über den [Hooks-Server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/index.mdx).
- **Konversationsanwendungen:** Wenden Sie [Ein- und Ausgabeprüfungen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx) an.
- **Retrieval-Augmented Generation (RAG):** [Erkennen oder maskieren Sie sensible Daten in abgerufenen Inhalten](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/pii-detection.mdx) und [prüfen Sie, ob Antworten durch Belege gestützt sind](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/fact-checking.mdx).
## So funktioniert es
Verwenden Sie die NVIDIA NeMo Guardrails-Bibliothek, um Ihre Richtlinie in Konfigurationsdateien zu definieren, die die zu verwendenden Rails, Modelle und Prompts festlegen.
Führen Sie die Bibliothek in Ihrer Python-Anwendung aus oder stellen Sie sie als Server bereit.
Wählen Sie den Prüfmodus oder den Proxy-Modus, je nachdem, wie Ihre Anwendung Modellanfragen verwaltet.
### Prüfmodus
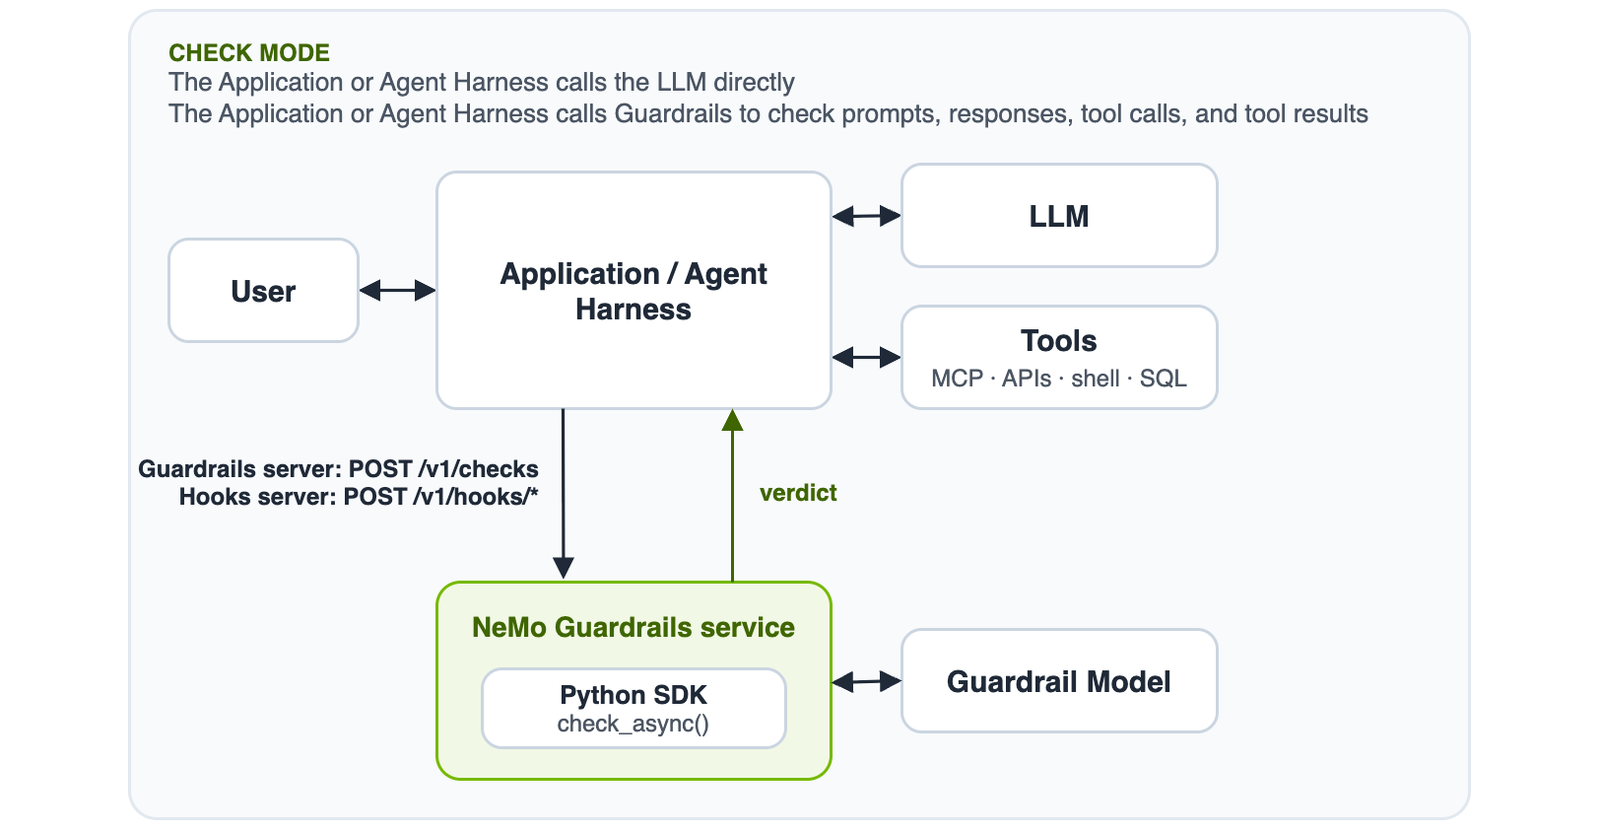
Ihre Anwendung oder Agent-Harness ruft das LLM auf und führt Tools direkt aus.
An jedem Punkt, der eine Richtlinienentscheidung erfordert, senden Sie den relevanten Prompt, die Modellantwort, den Tool-Aufruf oder das Tool-Ergebnis zur Prüfung an die Bibliothek.
Verwenden Sie das Ergebnis, um blockierte oder geänderte Inhalte zu behandeln, bevor Sie ein Tool ausführen, eine Antwort zurückgeben oder ein Tool-Ergebnis an das Modell übergeben.
Verwenden Sie [`check_async()`](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx) in Python, `POST /v1/checks` auf dem Guardrails-Server oder den [Hooks-Server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/index.mdx) für Coding-Agenten.
Für Tool-Prüfungen mit `check_async()` verwenden Sie die IORails-Engine und geben Sie `RailType.TOOL_CALL` oder `RailType.TOOL_RESULT` in `rail_types` an.
Prüfen Sie Tool-Aufrufe vor der Ausführung und Tool-Ergebnisse nach der Ausführung.
### Proxy-Modus
Leiten Sie Modellanfragen durch die Bibliothek, um die konfigurierten Eingabe- und Ausgabe-Rails anzuwenden.
Eingabe-Rails können eine Anfrage blockieren, bevor sie das Anwendungs-LLM erreicht.
Bei nicht gestreamten Anfragen prüfen Ausgabe-Rails die Antwort, bevor die Bibliothek sie zurückgibt.
Blockierte Inhalte erzeugen je nach Integration und Konfiguration eine Ablehnung oder einen Fehler.
Verwenden Sie `generate_async()` oder `stream_async()` in Python oder `POST /v1/chat/completions` auf dem Guardrails-Server.
Ihre Anwendung führt Tools aus; unterstützte Integrationen können Tool-Aufrufe in Modellantworten und Tool-Ergebnisse in nachfolgenden Anfragen prüfen.
Der [Gateway-Server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-proxy/providers-and-streaming.mdx) unterstützt ebenfalls `POST /v1/chat/completions` und `POST /v1/responses`, aber seine integrierten Profile unterstützen keine Tool-Inhalte.
Jede Gateway-Anfrage an `/v1/responses` muss `"store": false` enthalten.
Wenn die Ausgabestreamung für `stream_async()` aktiviert ist, liefert die Standardeinstellung `stream_first: true` Chunks, bevor sie geprüft werden.
Um jeden Chunk vor der Auslieferung zu prüfen, setzen Sie `rails.output.streaming.stream_first: false`.
Konfigurationsdetails finden Sie unter [Output-Rail-Streaming](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/yaml-schema/streaming/output-rail-streaming.mdx).
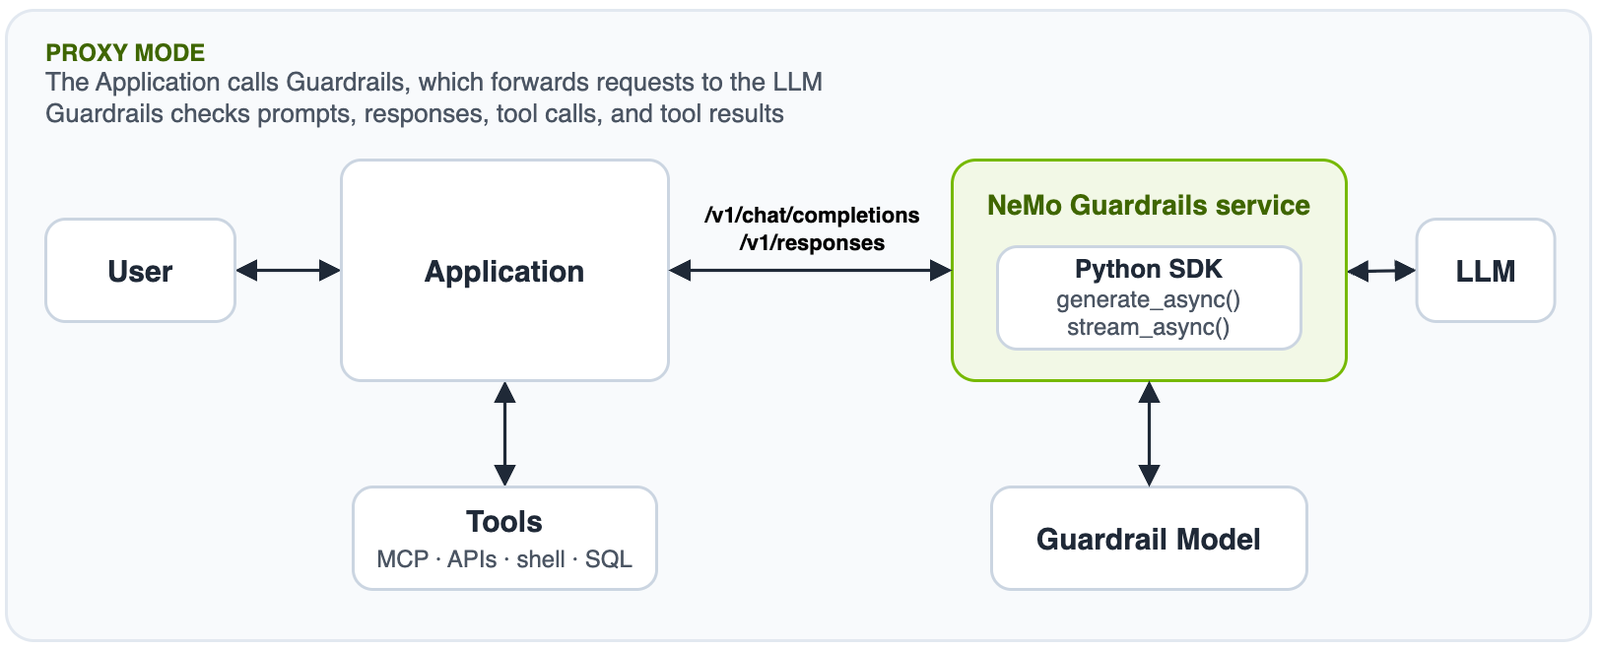
Die Latenz hängt von den konfigurierten Regeln, Modellen und Diensten ab.
Die Rail-Unterstützung variiert je nach Engine und Integration.
Siehe [Rail-Engine-Unterstützung](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/reference/rail-engine-support.mdx), [Konfiguration](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/configuration-reference.mdx) und [Wählen Sie Ihre Integration](#choose-your-integration).
## Warum NeMo Guardrails
- **Steuern Sie, was Agenten tun.** Validieren Sie Tool-Namen und Argument-Schemas vor der Ausführung. Prüfen Sie Tool-Ergebnisse und wenden Sie richtlinien pro Tool an, bevor Sie sie an das Modell zurückgeben.
- **Behalten Sie Ihr Modell und Ihre Agenten-Schleife.** Verwenden Sie [Prüfungen ohne Generierung durch das Hauptmodell](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx), um Guardrails zu einer bestehenden Anwendung hinzuzufügen. Modellgestützte Prüfungen rufen weiterhin ihr konfiguriertes Modell oder ihren konfigurierten Dienst auf.
- **Stellen Sie die benötigte Richtlinie zusammen.** Kombinieren Sie lokale [Regex](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/community/regex.mdx)- und [CEL](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/cel.mdx)-Regeln mit Sicherheitsmodellen und Prüfungen von Drittanbietern.
- **Binden Sie Ihre Laufzeitumgebung an.** Wählen Sie eine [Integration](#choose-your-integration) für Ihre Anwendung, Ihren gemeinsam genutzten Dienst oder Ihren Coding-Agenten.
- **Offen und von Ihnen ausführbar.** Die Bibliothek ist unter Apache 2.0 lizenziert. Wählen Sie [unterstützte Modellanbieter](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/about/supported-llms.mdx) und führen Sie Prüfungen mit lokalen Detektoren oder gehosteten Inferenz-Endpunkten aus.
## Schnellstart
Prüfen Sie eine vorgeschlagene Rückerstattung eines Support-Agenten gegen ein Limit von 500 $, ohne ein Modell oder einen API-Schlüssel.
Installieren Sie für dieses Beispiel das optionale CEL-Extra:
```bash
pip install "nemoguardrails[cel]"
```
Das Beispiel validiert das Argumentschema des Tools und blockiert Aufrufe über dem Limit. Erweitern Sie es und speichern Sie es als `check_refund.py`:
<details>
<summary>Vollständiges Python-Beispiel</summary>
```python
import asyncio
import json
from nemoguardrails import Guardrails, RailsConfig
from nemoguardrails.rails.llm.options import RailStatus, RailType
config = RailsConfig.from_content(yaml_content="""
models: []
rails:
tool_call:
flows: [tool call validation]
per_tool:
issue_refund: [cel check tool call]
config:
cel:
tool_call:
issue_refund:
expressions: ["args.amount > 500"]
""")
TOOLS = [{
"type": "function",
"function": {
"name": "issue_refund",
"parameters": {
"type": "object",
"properties": {"amount": {"type": "number", "minimum": 0}},
"required": ["amount"],
"additionalProperties": False,
},
},
}]
async def main():
async with Guardrails(config, require_iorails=True) as rails:
for amount in (50, 5000):
call = {
"role": "assistant",
"tool_calls": [{
"id": "call_1",
"type": "function",
"function": {
"name": "issue_refund",
"arguments": json.dumps({"amount": amount}),
},
}],
}
result = await rails.check_async(
[call], rail_types=[RailType.TOOL_CALL], tools=TOOLS
)
print(f"${amount}: {result.status.value}")
if result.status == RailStatus.PASSED:
print("Ready for the application to execute")
else:
print(f"Rail: {result.rail}")
print(f"Reason: {result.reason}")
asyncio.run(main())
```
</details>
Führen Sie es aus dem Verzeichnis aus, in dem Sie die Datei gespeichert haben:
```bash
python check_refund.py
```
Expected output:
```text
$50: passed
Ready for the application to execute
$5000: blocked
Rail: cel check tool call
Reason: cel check tool call
```
Das Beispiel führt keine Rückerstattungen durch. Ihre Anwendung führt ein Tool erst aus, nachdem seine Prüfungen bestanden wurden.
Weitere Konfigurations- und Fehlerbehandlungsbeispiele finden Sie unter [Tool-Aufruf](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-calling.mdx) und [Nachrichten prüfen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx).
## Wählen Sie Ihre Integration
Binden Sie NeMo Guardrails dort ein, wo Ihre Anwendung oder Ihr Agent seine Prüfungen durchsetzen kann.
| Was bauen Sie? | Wie verbinden |
| --- | --- |
| **Ein gemeinsamer Guardrails-Dienst** für mehrere Anwendungen oder Teams | Verwenden Sie die [Checks API](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-fastapi-server/overview.mdx) (`/v1/checks`), um Urteile anzufordern, während jede Anwendung ihr Modell und ihre Ausführungsschleife verwaltet. |
| **Eine Guardrails-Schicht** für bestehende Modell-APIs | Verwenden Sie den [Gateway-Server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-gateway/quickstart.mdx), um unterstützte Anfragen und Antworten zu prüfen und dabei die Anbieterformate beizubehalten. |
| **Ein Coding-Assistent oder Agent-Harness** | Verwenden Sie [native Hooks](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/run-hooks-server.mdx) oder [NeMo Relay](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/nemo-relay-plugin.mdx), um Tool-Aufrufe vor der Ausführung zu prüfen. |
| **Eine Agent-Plattform, Framework-Integration oder benutzerdefinierte Schleife** | Betten Sie das [Python SDK](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx) ein, rufen Sie die [Checks API](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-fastapi-server/overview.mdx) auf oder verwenden Sie eine unterstützte [Framework-Integration](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/integration/langchain/langgraph-integration.mdx). |
## Guardrail-Katalog
Wählen Sie Prüfungen für Ihre Richtlinie und Ihren Workflow:
| Prüfung | Zweck |
| --- | --- |
| [Inhaltssicherheit](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/content-safety.mdx) | Eingaben und Ausgaben gegen Sicherheitsrichtlinien prüfen. |
| [Themenkontrolle](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/topic-control.mdx) | Eingaben gegen konfigurierte thematische Richtlinien prüfen. |
| [Jailbreak-Erkennung](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/jailbreak-protection.mdx) | Jailbreak-Versuche mit konfigurierten Heuristiken oder Klassifikatoren erkennen. |
| [Injection-Erkennung](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/agentic-security.mdx) | Modellausgaben auf Code-, SQL-, Template- und Cross-Site-Scripting-Muster prüfen. |
| [Sensible Daten und PII](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/pii-detection.mdx) | Sensible Daten in Eingaben, Ausgaben und abgerufenen Inhalten erkennen oder maskieren. |
| [Faktenprüfung](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/fact-checking.mdx) und [Halluzinationsprüfungen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/fact-checking.mdx#hallucination-detection) | Antworten gegen Belege prüfen oder Modellantworten auf Konsistenz vergleichen. |
| [Validierung von Tool-Aufrufen und Tool-Ergebnissen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-calling.mdx) | Deklarierte Tools, Argument-Schemas sowie die Verknüpfung und Struktur von Tool-Ergebnissen validieren. |
| [Tool-Sicherheitsprüfungen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-safety-check.mdx) | Tool-Aufrufe und -Ergebnisse gegen tool-spezifische Sicherheitsanweisungen bewerten. |
| [Regex](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/community/regex.mdx) und [CEL](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/cel.mdx) | Deterministische Muster- und Ausdrucksregeln anwenden. |
| [LLM-Selbstprüfungen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/self-check.mdx) | Konfigurierte LLM-Prompts für Eingabemoderation, Ausgabemoderation oder Faktenprüfung verwenden. |
| [Spracherkennung](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/language-detector.mdx) | Eingaben auf konfigurierte Sprachen beschränken. |
| [Drittanbieter-Integrationen](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/third-party.mdx) | Verwaltete Sicherheits- und Moderationsdienste anbinden. |
NVIDIA Nemotron Safety-Modelle umfassen [Nemotron 3.5 Content Safety](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/configs/nemotron-3.5-content-safety), [Nemotron Content Safety Reasoning 4B](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/getting-started/tutorials/nemotron-content-safety-reasoning-deployment.mdx) und [Llama 3.1 Nemotron Safety Guard 8B V3](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/getting-started/tutorials/nemotron-safety-guard-deployment.mdx). Folgen Sie den verlinkten Beispielen und Anleitungen für die modellspezifische Einrichtung.
Verwenden Sie die [Evaluierungstools](https://docs.nvidia.com/nemo/guardrails/latest/evaluation/evaluate-guardrails), um Ihre Richtlinien zu bewerten, und [garak](https://github.com/NVIDIA/garak), um LLM-Anwendungen auf Schwachstellen zu scannen. Ein Beispiel finden Sie im [Leitfaden zur Schwachstellensuche](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/evaluation/llm-vulnerability-scanning.mdx).
## Benchmarking der Guardrails-Leistung
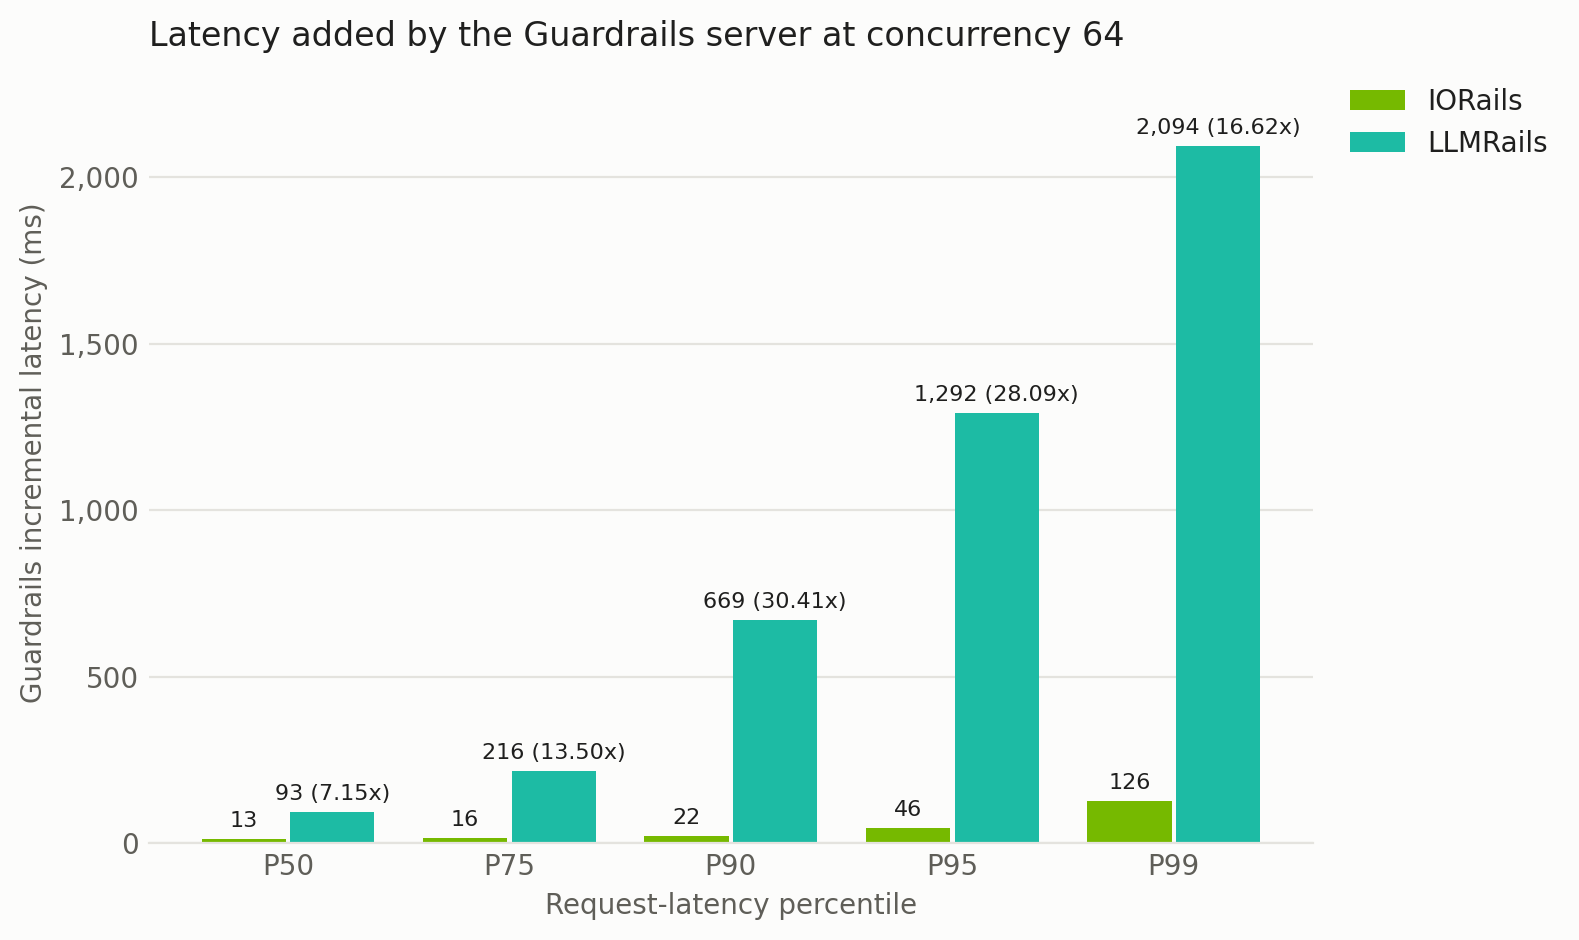
Die folgenden Zahlen zeigen die Latenz, die der Guardrails-API-Server jeder Anfrage hinzufügt, gemessen auf einem 14-Zoll-MacBook Pro mit einem Apple M4 (10 Kerne, 24 GB).
Der Server führt die Konfiguration [`content_safety_local`](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/configs/content_safety_local) aus, die jede Anfrage mit einem Input-Rail und einem Output-Rail prüft.
Mock-LLMs ersetzen das Hauptmodell und das Content-Safety-Modell durch feste Latenzen, sodass jede Anfrage 5.000 ms für Modellaufrufe aufwendet: 500 ms für jede Content-Safety-Prüfung und 4.000 ms für das Hauptmodell.
AIPerf sendet 180 Sekunden lang nicht-streamende Anfragen auf jeder Parallelitätsstufe, mit Prompts von etwa 100 Input-Tokens.
Das folgende Diagramm zeigt die zusätzliche Latenz bei Parallelität 64, wobei jedes LLMRails-Label auch sein Vielfaches des IORails-Werts angibt.
| Parallelität | IORails p50 (ms) | IORails p90 (ms) | IORails p99 (ms) | LLMRails p50 (ms) | LLMRails p90 (ms) | LLMRails p99 (ms) |
| ---: | ---: | ---: | ---: | ---: | ---: | ---: |
| 1 | 11 | 13 | 30 | 39 | 40 | 53 |
| 2 | 13 | 15 | 20 | 62 | 70 | 104 |
| 4 | 13 | 15 | 19 | 85 | 100 | 127 |
| 8 | 13 | 19 | 68 | 136 | 179 | 208 |
| 16 | 15 | 21 | 30 | 97 | 289 | 416 |
| 32 | 13 | 19 | 106 | 88 | 274 | 860 |
| 64 | 13 | 22 | 126 | 93 | 669 | 2.094 |
| 128 | 17 | 774 | 2.880 | 430 | 1.422 | 5.182 |
Jeder Wert ist das Perzentil der Anfragelatenz abzüglich der 5.000 ms für Modellaufrufe.
Er enthält die drei HTTP-Aufrufe des Servers an die Mock-Modelle mit jeweils etwa 2,5 ms.
Um diese Zahlen zu reproduzieren, folgen Sie dem [Benchmarking-Leitfaden](https://github.com/nvidia-nemo/guardrails/blob/develop/benchmark/README.md) mit zwei Änderungen:
- Setzen Sie `benchmark_duration: 180` in der AIPerf-Konfiguration; die mitgelieferten Konfigurationen verwenden 60 Sekunden.
- Für die IORails-Spalten starten Sie den Server mit `NEMO_GUARDRAILS_IORAILS_ENGINE=true`; das Procfile im Leitfaden startet den Server ohne diese Variable, sodass der Server standardmäßig LLMRails ausführt.
Dieselben Tools können verwendet werden, um Produktions-Guardrails-Bereitstellungen mit echten Modellen statt Mock-LLMs zu benchmarken.
Für diesen Anwendungsfall sollte die Guardrails-Konfiguration auf Produktions-LLMs verweisen, und AIPerf sollte mit repräsentativen Produktionsdatensätzen ausgeführt werden.
## Community-Nutzung
Dieser anonyme Nutzungs-Snapshot umfasst die Release-Builds `0.22.0` und `0.23.0` vom 22. Mai bis 18. August 2026 mit geschätzten 665.798 verschiedenen Start-Sitzungen.
<details>
<summary>Rail-Nutzung, Feature-Nutzung und konfigurierte Rail-Anzahlen anzeigen</summary>
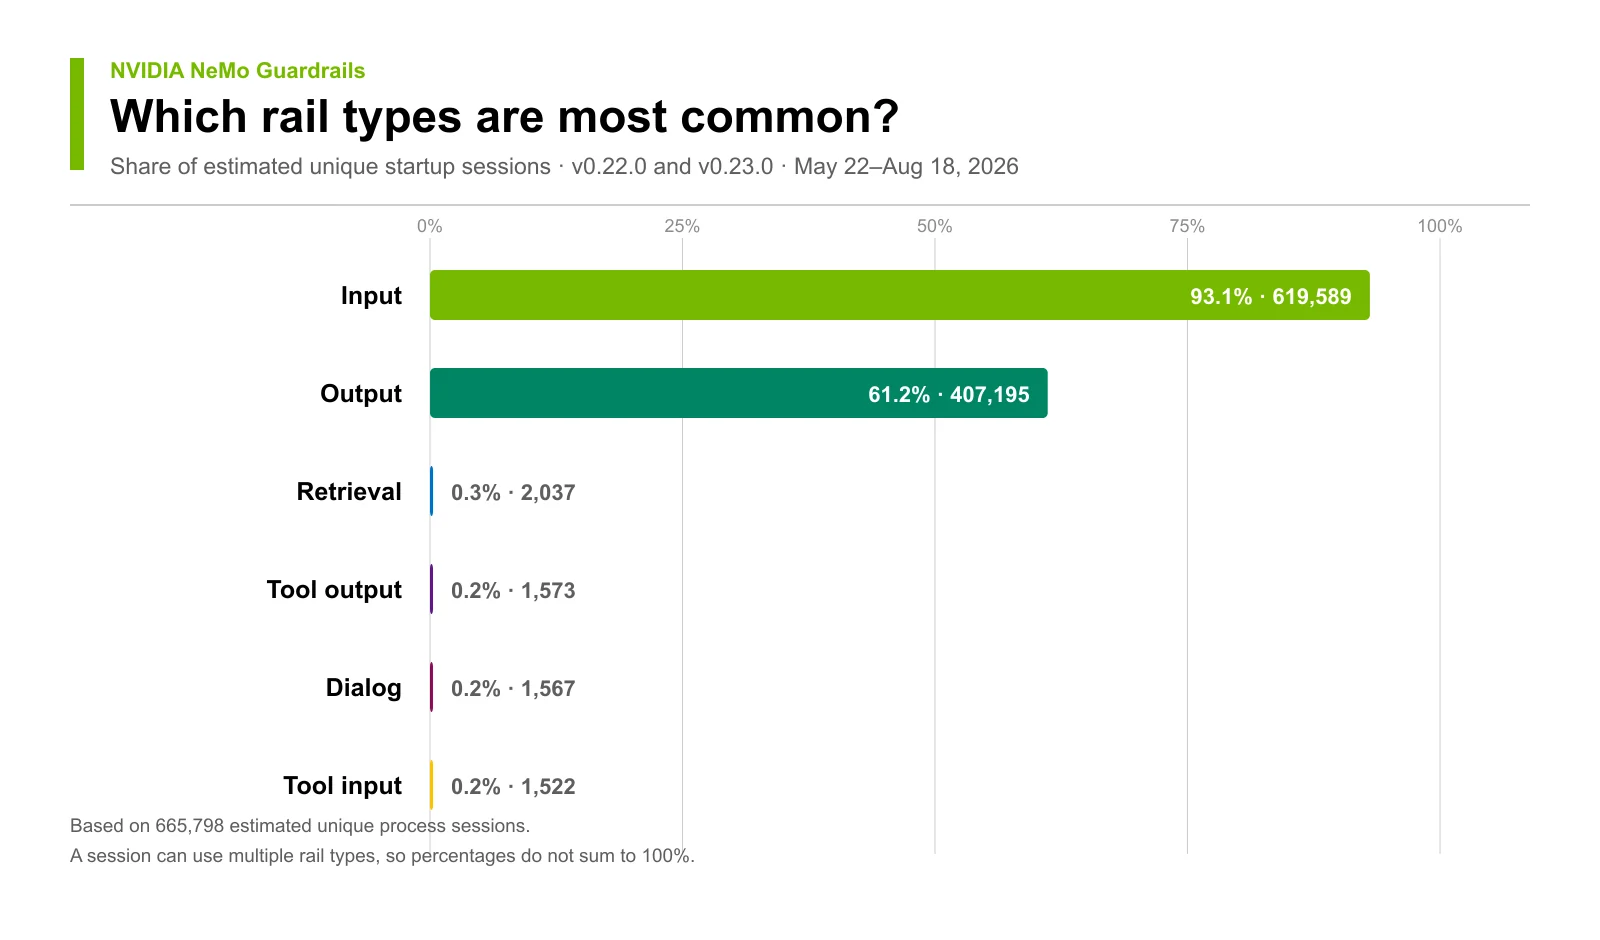
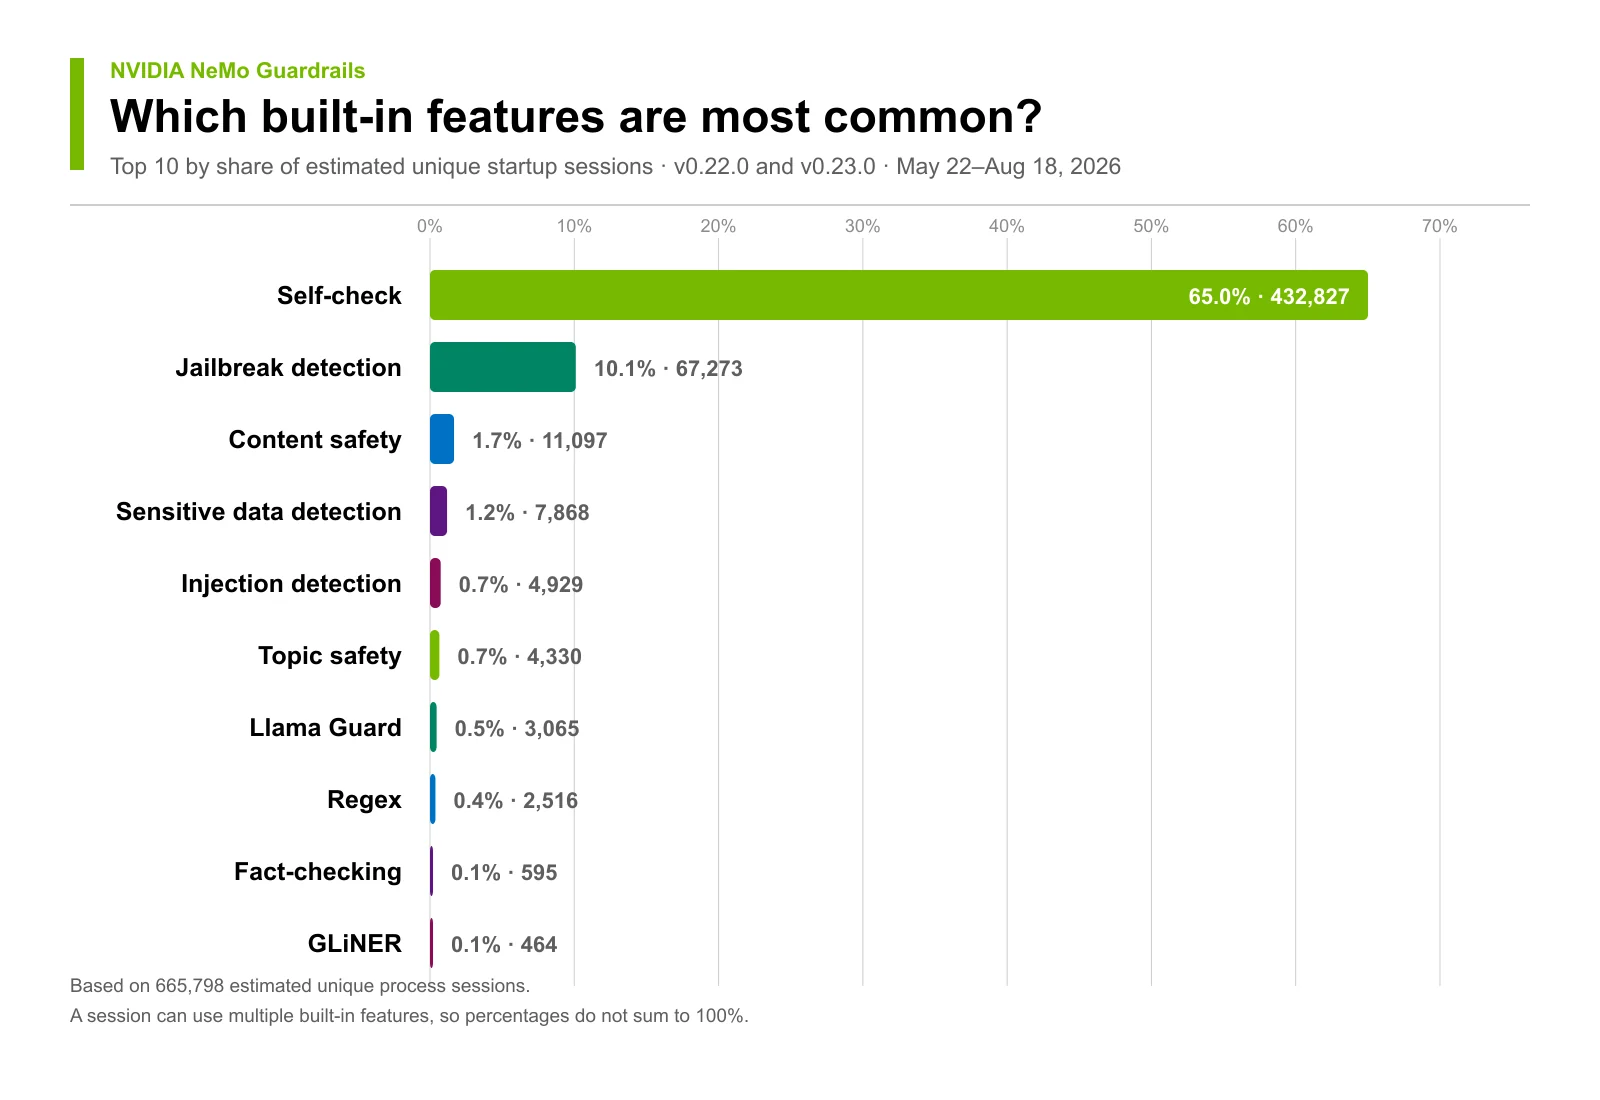
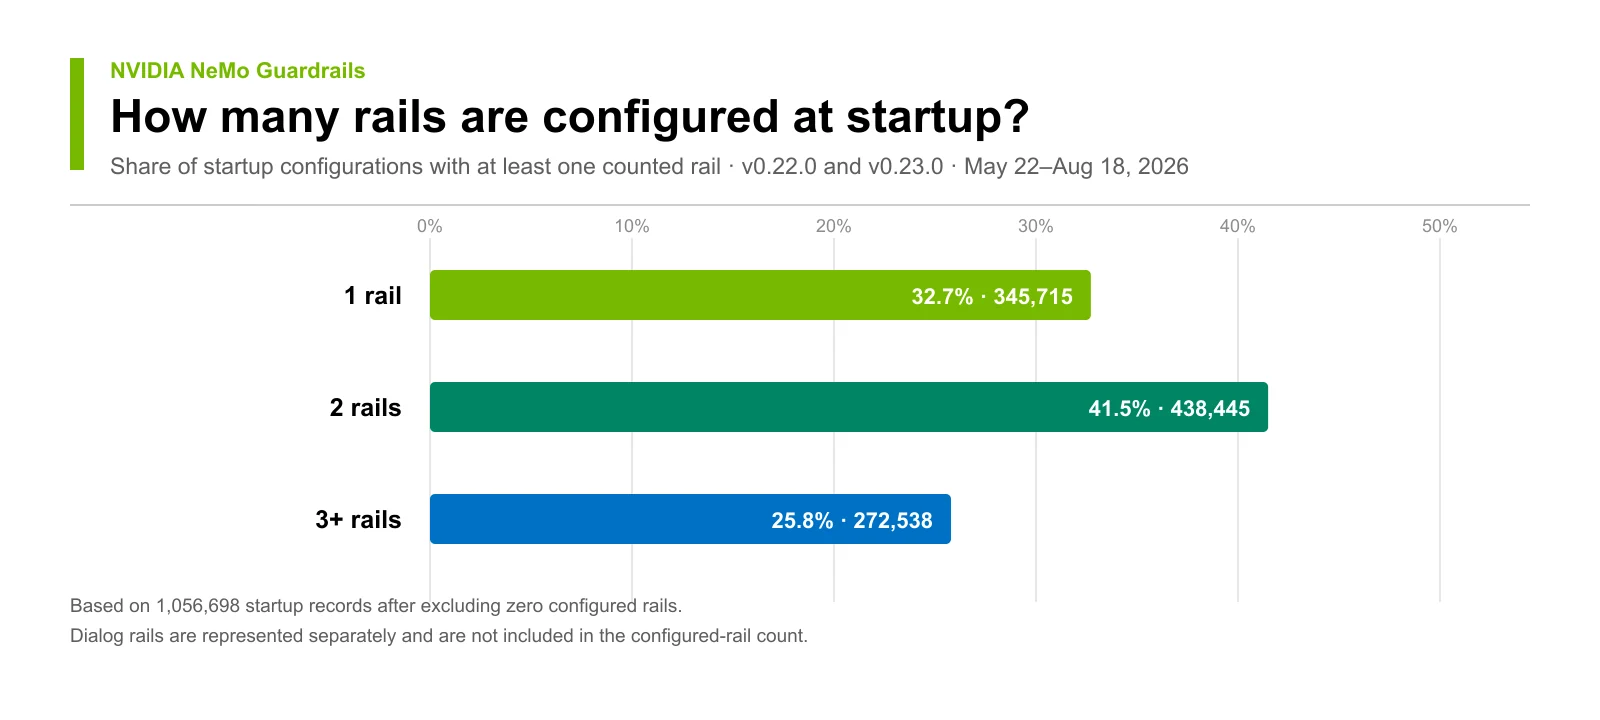
Die Sitzungszahlen sind Schätzungen, und eine Sitzung kann mehrere Rail-Typen oder Features verwenden. Definitionen und Zählgrenzen finden Sie in den [aggregierten Daten](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/_static/images/community-telemetry/0.22.0-0.23.0.json) und der [Methodik](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/_static/images/community-telemetry/README.md).
</details>
## Telemetrie und Datenschutz
Die Bibliothek sendet anonyme Nutzungstelemetrie, die Prompts, Completionen, Modellnamen, Anmeldedaten und Endpunkte ausschließt. Setzen Sie `NEMO_GUARDRAILS_NO_USAGE_STATS=1`, um sich abzumelden. Dies deaktiviert keine konfigurierten Modell- oder Guardrail-Service-Aufrufe, die Inhalte an diese Endpunkte senden können. Details und weitere Opt-out-Optionen finden Sie unter [Telemetrie und Datenschutz](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/telemetry.mdx).
Endpunkte von Drittanbietern unterliegen eigenen Bedingungen und Datenschutzpraktiken. Die Bibliothek NVIDIA NeMo Guardrails kann Inferenz-Endpunkte wie NVIDIA Build (`build.nvidia.com`) verwenden. Wenn Sie NVIDIA Build oder einen anderen Endpunkt eines Drittanbieters nutzen, gelten die Nutzungsbedingungen und Datenschutzpraktiken dieses Endpunkts unabhängig von der Bibliothek. Ein etwaiges Telemetrie-Opt-out in der Bibliothek NVIDIA NeMo Guardrails erstreckt sich nicht auf den von Ihnen gewählten Endpunkt. NVIDIA Build ist ausschließlich für Evaluierung und Tests vorgesehen und darf nicht in Produktionsumgebungen verwendet werden. Übermitteln Sie keine vertraulichen Informationen oder personenbezogenen Daten, wenn Sie NVIDIA Build verwenden.
## Mitwirken und Support
Beachten Sie [CONTRIBUTING.md](https://github.com/nvidia-nemo/guardrails/blob/develop/CONTRIBUTING.md) und [AI_POLICY.md](https://github.com/nvidia-nemo/guardrails/blob/develop/AI_POLICY.md) für die Anforderungen an Beiträge. Stellen Sie Nutzungsfragen in den [GitHub Discussions](https://github.com/NVIDIA-NeMo/Guardrails/discussions) und folgen Sie [SECURITY.md](https://github.com/nvidia-nemo/guardrails/blob/develop/SECURITY.md), um Schwachstellen zu melden.
Die Bibliothek ist unter der [Apache License, Version 2.0](https://github.com/nvidia-nemo/guardrails/blob/develop/LICENSE-Apache-2.0.txt) lizenziert. Wenn Sie sie in der Forschung verwenden, zitieren Sie das [EMNLP 2023 paper](https://aclanthology.org/2023.emnlp-demo.40).





