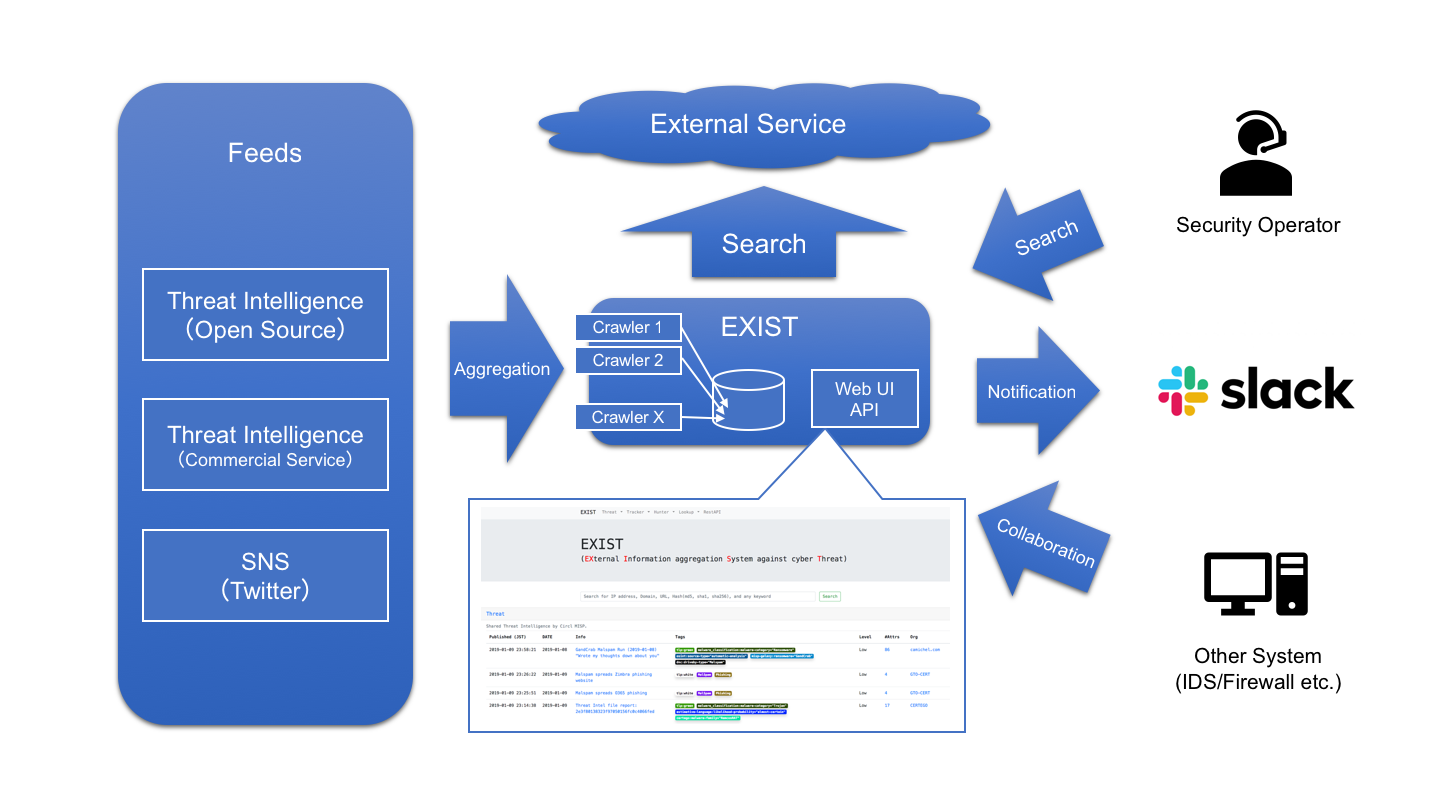

EXIST ist eine Webanwendung zur Aggregierung und Analyse von Cyber-Threat-Intelligence.
⚠️ Dieses Repository wird nicht mehr gewartet / ist archiviert. Sicherheitsprobleme werden nicht behoben.
EXIST ist eine Webanwendung zur Aggregation und Analyse von CTI (Cyber Threat Intelligence).
EXIST wurde mit folgender Software erstellt.
EXIST ist eine Webanwendung zur Aggregation von CTI, die Sicherheitsoperatoren dabei unterstützt, Vorfälle anhand verwandter Indikatoren zu untersuchen.
EXIST ruft automatisch Daten von mehreren CTI-Diensten und Twitter über deren APIs und Feeds ab. Sie können Indikatoren über die Weboberfläche und die API übergreifend durchsuchen.
Wenn Sie Server haben, die das Netzwerkverhalten von Clients protokollieren (z. B. Logs von DNS- und HTTP-Proxy-Servern usw.), können Sie die Logs analysieren, indem Sie sie mit Daten in EXIST korrelieren. Wenn Sie Programme unter Verwendung der API implementieren, realisieren Sie ein automatisiertes, CTI-gesteuertes Security Operations Center.
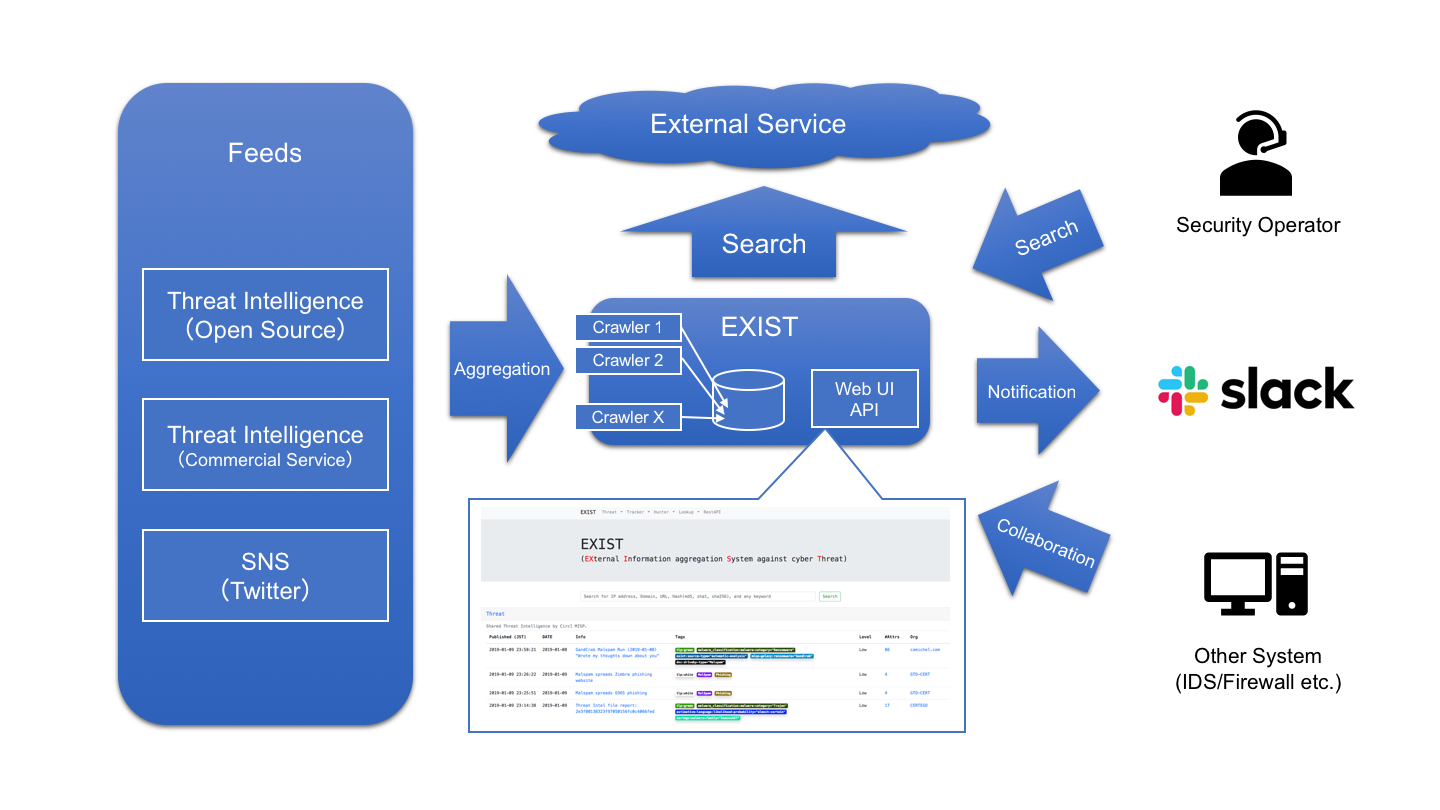
Geben Sie einfach die Domäne in das Suchformular ein.
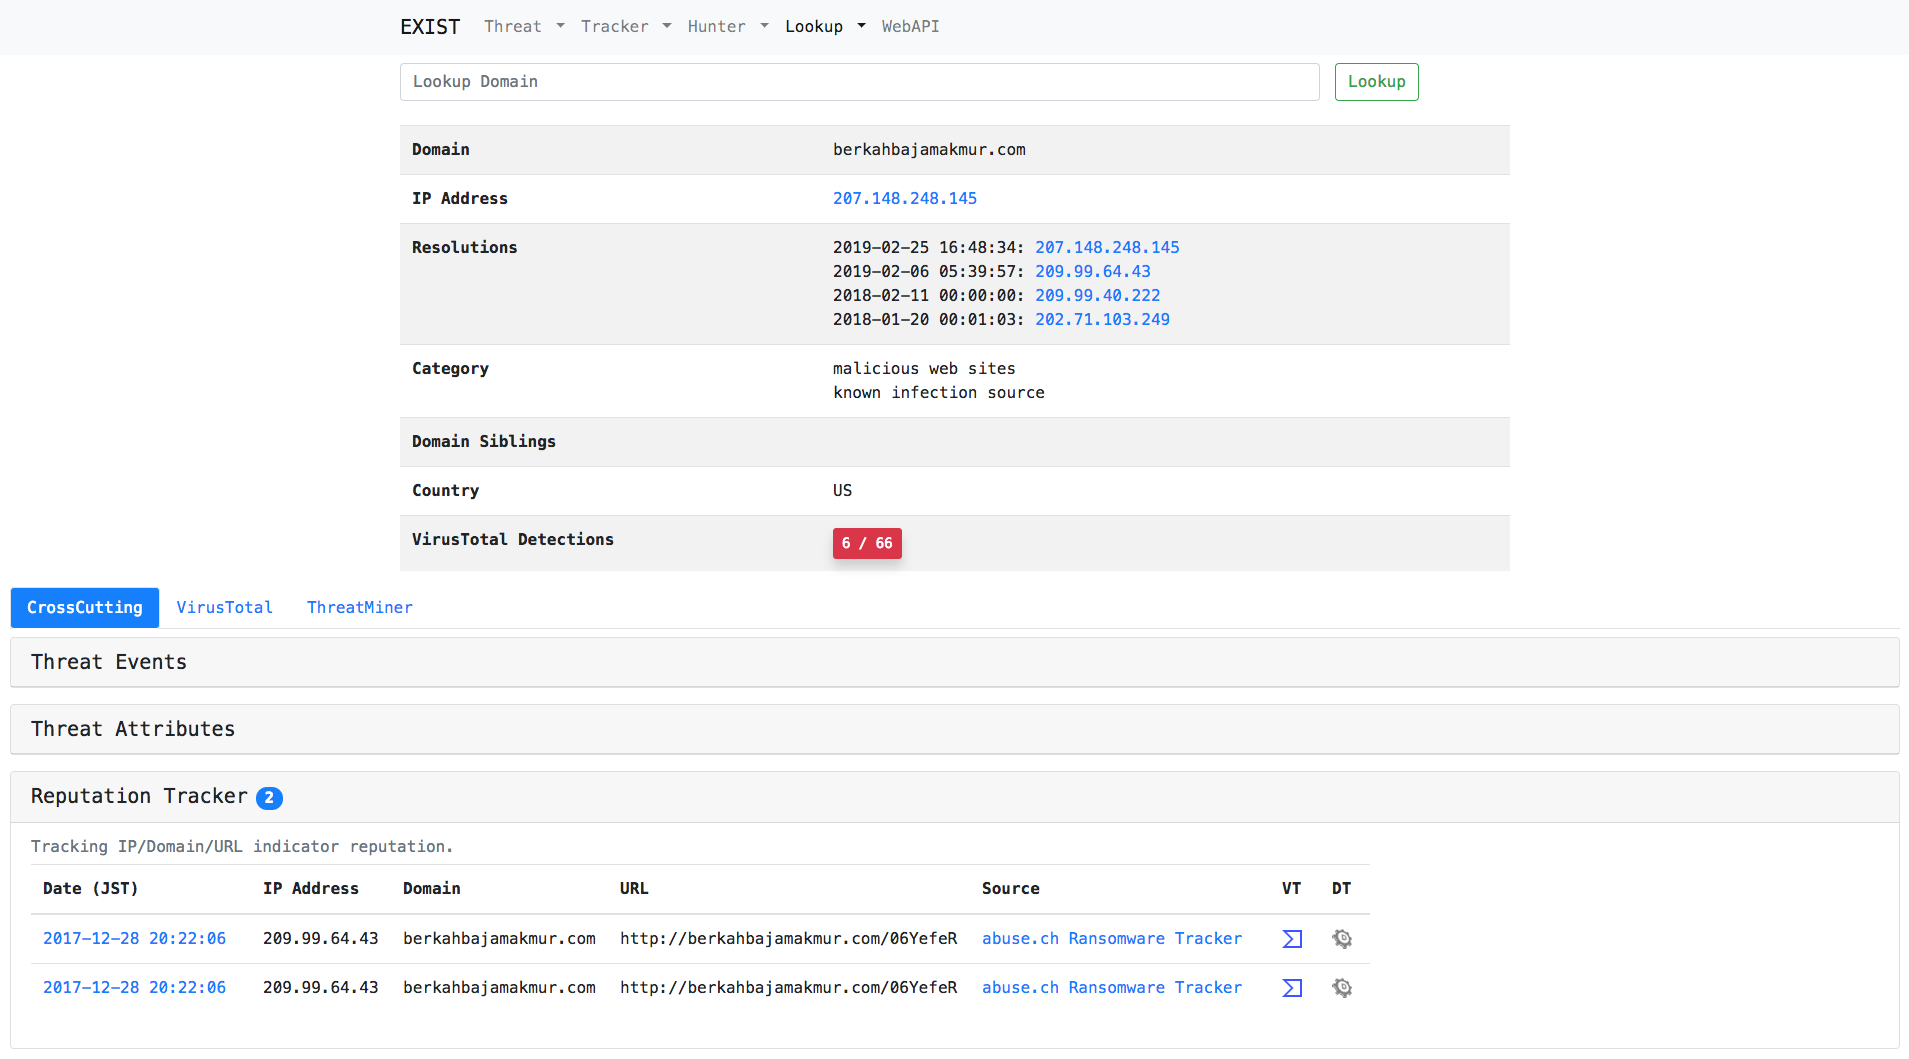
Geben Sie einfach die URL in das Suchformular ein.
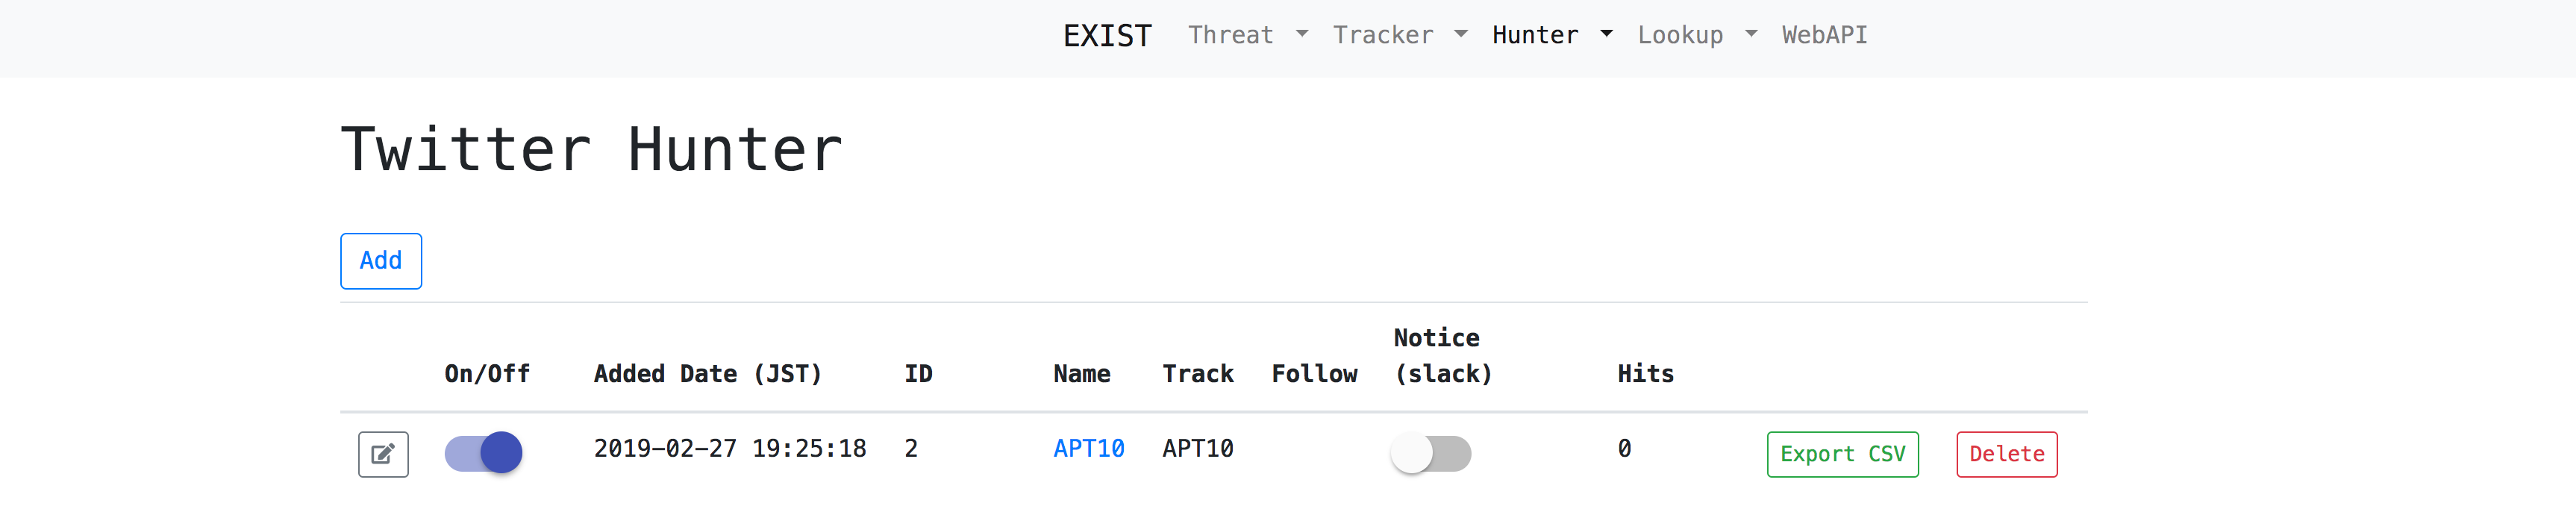
Fügen Sie einfach Schlüsselwörter im Threat Hunter oder Twitter Hunter hinzu.
Tracker sammelt automatisch Daten-Feeds von mehreren CTI-Diensten.
Hunter ermöglicht es uns, Abfragen zum Sammeln von Daten von mehreren CTI-Diensten und Twitter festzulegen.
Lookup ruft Informationen zu bestimmten Angaben (z. B. IP-Adresse, Domäne) von mehreren Internetdiensten (z. B. Whois) ab.
Ein Tool zum Annotieren von Tweets aus dem Twitter-Tracker.
Stellt Daten aus der EXIST-Datenbank über die Web-API bereit.
Im Folgenden gehe ich von einer Umgebung mit CentOS 7 oder Ubuntu 18.04 LTS aus. Bitte handeln Sie auf eigenes Risiko, wenn Sie in andere Umgebungen bereitstellen.
$ sudo pip install -r requirements.txt
$ curl -sS https://downloads.mariadb.com/MariaDB/mariadb_repo_setup | sudo bash
$ sudo yum install MariaDB-server MariaDB-client
$ sudo apt install mariadb-server mariadb-client
$ sudo systemctl start mariadb
$ sudo systemctl enable mariadb
.env in Anlehnung an .env.example und bearbeiten Sie es entsprechend Ihren DB-Einstellungen.Der geheime Schlüssel für Django muss in der .env-Datei eingetragen werden.
Führen Sie zuerst den Schlüsselgenerator aus:
$ python keygen.py
(example)> 70mm6h)()h3r&*b9xq$e52=-7($p=5983gfoyz%$d-j-gd7u5@
und schreiben Sie den geheimen Schlüssel in die .env-Datei:
...
# EXIST Application Settings
EXIST_SECRET_KEY="70mm6h)()h3r&*b9xq$e52=-7($p=5983gfoyz%$d-j-gd7u5@"
...
$ python manage.py makemigrations exploit reputation threat threat_hunter twitter twitter_hunter news news_hunter vuln
$ python manage.py migrate
Der Reputation Tracker verwendet Redis als Backend des Celery-Cache-Servers.
$ sudo yum install redis
$ sudo systemctl start redis
$ sudo systemctl enable redis
$ sudo apt install redis-server
$ sudo systemctl start redis-server
$ sudo systemctl enable redis-server
Der Reputation Tracker verwendet Celery als asynchrone Aufgaben-Warteschlange.
# Name of nodes to start
# here we have a single node
CELERYD_NODES="w1"
# or we could have three nodes:
#CELERYD_NODES="w1 w2 w3"

# Absolute or relative path to the 'celery' command:
CELERY_BIN="/path/to/your/celery"

# App instance to use
# comment out this line if you don't use an app
CELERY_APP="intelligence"
# or fully qualified:
#CELERY_APP="proj.tasks:app"

# How to call manage.py
CELERYD_MULTI="multi"

# Extra command-line arguments to the worker
CELERYD_OPTS="--time-limit=300 --concurrency=8"

# - %n will be replaced with the first part of the nodename.
# - %I will be replaced with the current child process index
# and is important when using the prefork pool to avoid race conditions.
CELERYD_PID_FILE="/var/run/celery/%n.pid"
CELERYD_LOG_FILE="/var/log/celery/%n%I.log"
CELERYD_LOG_LEVEL="INFO"
/etc/systemd/system/celery.service. Außerdem müssen Sie Ihren Celery-Konfigurationspfad in EnvironmentFile angeben.[Unit]
Description=Celery Service
After=network.target
[Service]
Type=forking
User=YOUR_USER
Group=YOUR_GROUP
EnvironmentFile=/etc/sysconfig/celery
WorkingDirectory=/path/to/your/exist
ExecStart=/bin/sh -c '${CELERY_BIN} multi start ${CELERYD_NODES} \
-A ${CELERY_APP} --pidfile=${CELERYD_PID_FILE} \
--logfile=${CELERYD_LOG_FILE} --loglevel=${CELERYD_LOG_LEVEL} ${CELERYD_OPTS}'
ExecStop=/bin/sh -c '${CELERY_BIN} multi stopwait ${CELERYD_NODES} \
--pidfile=${CELERYD_PID_FILE}'
ExecReload=/bin/sh -c '${CELERY_BIN} multi restart ${CELERYD_NODES} \
-A ${CELERY_APP} --pidfile=${CELERYD_PID_FILE} \
--logfile=${CELERYD_LOG_FILE} --loglevel=${CELERYD_LOG_LEVEL} ${CELERYD_OPTS}'
[Install]
WantedBy=multi-user.target
$ sudo mkdir /var/log/celery; sudo chown YOUR_USER:YOUR_GROUP /var/log/celery
$ sudo mkdir /var/run/celery; sudo chown YOUR_USER:YOUR_GROUP /var/run/celery
#Type  Path               Mode  UID        GID         Age  Argument
d      /var/run/celery    0755  YOUR_USER  YOUR_GROUP  -
$ sudo systemctl start celery.service
$ sudo systemctl enable celery.service
$ python manage.py runserver 0.0.0.0:8000
Hinweis: Ich empfehle, Nginx und uWSGI zu verwenden, wenn Sie in einer Produktionsumgebung arbeiten.
Skripte zum Einfügen von Feeds in die Datenbank befinden sich unter scripts/insert2db/*/insert2db.py.

