

AttackGen ist ein Cybersicherheits-Tool für Incident-Response-Tests, das die Leistungsfähigkeit großer Sprachmodelle und des umfassenden MITRE ATT&CK-Frameworks nutzt. Das Tool generiert maßgeschneiderte Incident-Response-Szenarien auf der Grundlage von vom Benutzer ausgewählten Bedrohungsakteur-Gruppen und den Details Ihrer Organisation.
# AttackGen AttackGen ist ein Testtool für die Reaktion auf Cybersicherheitsvorfälle, das die Leistungsfähigkeit großer Sprachmodelle sowie die umfassenden Frameworks MITRE ATT&CK und ATLAS nutzt. Das Tool generiert maßgeschneiderte Szenarien für die Reaktion auf Vorfälle basierend auf vom Benutzer ausgewählten Bedrohungsakteursgruppen, KI-Angriffsfallstudien und den Details Ihrer Organisation. ## Inhaltsverzeichnis - [Repository mit einem Stern markieren](#star-the-repo) - [Funktionen](#features) - [Releases](#releases) - [Anforderungen](#requirements) - [Installation](#installation) - [LangSmith-Einrichtung](#langsmith-setup) - [Daten-Einrichtung](#data-setup) - [AttackGen ausführen](#running-attackgen) - [MCP-Server](#mcp-server) - [Agent Skills](#agent-skills) - [Verwendung](#usage) - [Bewährte Sicherheitspraktiken](#security-best-practices) - [Mitwirken](#contributing) - [Lizenz](#licence) ## Repository mit einem Stern markieren Wenn Sie AttackGen nützlich finden, ziehen Sie bitte in Betracht, das Repository auf GitHub mit einem Stern zu markieren. Dies hilft mehr Menschen, das Tool zu entdecken. Ihre Unterstützung wird sehr geschätzt! ⭐ ## Funktionen - Erzeugt einzigartige Incident-Response-Szenarien basierend auf ausgewählten Bedrohungsakteursgruppen oder ATLAS-Fallstudien. - Ermöglicht die Angabe der Größe und Branche Ihrer Organisation für ein maßgeschneidertes Szenario. - Unterstützt die Frameworks MITRE ATT&CK Enterprise, ICS (Industrial Control Systems) und ATLAS (Adversarial Threat Landscape for AI Systems). - Zeigt eine detaillierte Liste der Techniken an, die von der ausgewählten Bedrohungsakteursgruppe oder Fallstudie verwendet werden. - Erstellen Sie benutzerdefinierte Szenarien basierend auf einer Auswahl von ATT&CK- oder ATLAS-Techniken. - Verwenden Sie Szenariovorlagen, um schnell benutzerdefinierte Szenarien basierend auf gängigen Arten von Cyber-Vorfällen zu generieren, einschließlich KI/ML-spezifischer Angriffsmuster. - Generieren Sie **AI Insider Threat Scenarios** – Incident-Response-Übungen, in denen ein im Inneren Ihrer Organisation eingesetzter Frontier-KI-Agent sich wie eine Insider-Bedrohung verhält, basierend auf dem Bedrohungsmodell aus [*Actions Speak Louder Than Tokens: An Insider Threat Model for Frontier AI Agents*](https://ai-insider-threat.matt-adams.co.uk). Die Szenarien werden durch den Deployment-Archetyp des Agenten (Autonomiegrad), die Bedrohungskategorie, STRIDE-Bedrohungen und einen optionalen Freitext-Szenarioseed geprägt. - AttackGen Assistant – eine Chat-Oberfläche zum Aktualisieren und/oder Stellen von Fragen zu generierten Szenarien, mit einem direkten Weg zurück zu der Seite, von der das Szenario stammt. - Geführte Einrichtung: Jede Seite zeigt dieselbe **Setup**-Seitenleiste, listet jede ausstehende Anforderung in einer einzigen Bereitschaftsübersicht auf und hält **Generate** deaktiviert, bis der Workflow bereit ist. - Ergebnisse bleiben für die Sitzung erhalten: Jede Szenarioseite behält ihr eigenes letztes Ergebnis, ihre erfassten Eingaben und ihre Downloads über erneute Ausführungen und Navigation hinweg, und nur ein explizites **Regenerate** oder **Clear result** ersetzt oder entfernt es. - Lange Szenarien verfügen über eine kompakte Zusammenfassung und Abschnittsnavigation, einschließlich Verknüpfungen zu den Injects, Erfolgskriterien, Metriken, Artefakten und Rules of Engagement, anhand derer ein Moderator die Übung durchführt. - Erfassen Sie Benutzerfeedback zur Qualität der generierten Szenarien. - Detection & Response-Begleiter: Für die Techniken des Szenarios listet AttackGen die passenden ATT&CK-Erkennungsstrategien, Analysen, Protokollquellen und Gegenmaßnahmen auf, die als separate `_detection.md`-Datei heruntergeladen werden können. - ATT&CK-Navigator-Layer-Download für Threat-Group- und Custom-Szenarien, sodass Sie die Techniken des Szenarios im [ATT&CK Navigator](https://mitre-attack.github.io/attack-navigator/) anzeigen können. - Optionale Umschalter auf den Seiten Threat Group und Custom: **AI-enhanced adversary** formuliert dieselbe Kill Chain als KI-beschleunigt neu, und **Purple-team narrative** fügt einen schrittweisen Durchgang aus Verteidigersicht hinzu, der aus den bereitgestellten Erkennungen und Gegenmaßnahmen aufgebaut wird. - Herunterladbare Szenarien im Markdown-Format, plus der Erkennungsbericht und der Navigator-Layer. - MCP-Server (`attackgen-mcp`), der Kill Chains, Erkennungsberichte, Navigator-Layer und Szenariogenerierung für agentische Clients bereitstellt, plus der `attackgen-tabletop` Agent Skill, um diese Ausgabe in eine moderatorbereite Tabletop-Übung zu verwandeln. - Verwenden Sie die OpenAI API, Anthropic API (Claude-Modelle), Google AI API, Mistral API, Groq API oder einen beliebigen benutzerdefinierten OpenAI-kompatiblen Endpunkt (Ollama, LM Studio, Azure OpenAI, OpenRouter usw.), um Incident-Response-Szenarien zu generieren. Alle Anbieter werden über [LiteLLM](https://github.com/BerriAI/litellm) hinter einem einzigen internen Wrapper geleitet, sodass das Hinzufügen eines neuen Modells eine einzeilige Änderung ist. - Verfügbar als Docker-Container-Image für einfache Bereitstellung. - Optionale Integration mit [LangSmith](https://docs.smith.langchain.com/) für leistungsstarkes Debugging, Testen und Überwachen der Modellleistung. - Sichere Verwaltung von Anmeldedaten mithilfe einer .env-Datei für API-Schlüssel und Geheimnisse. 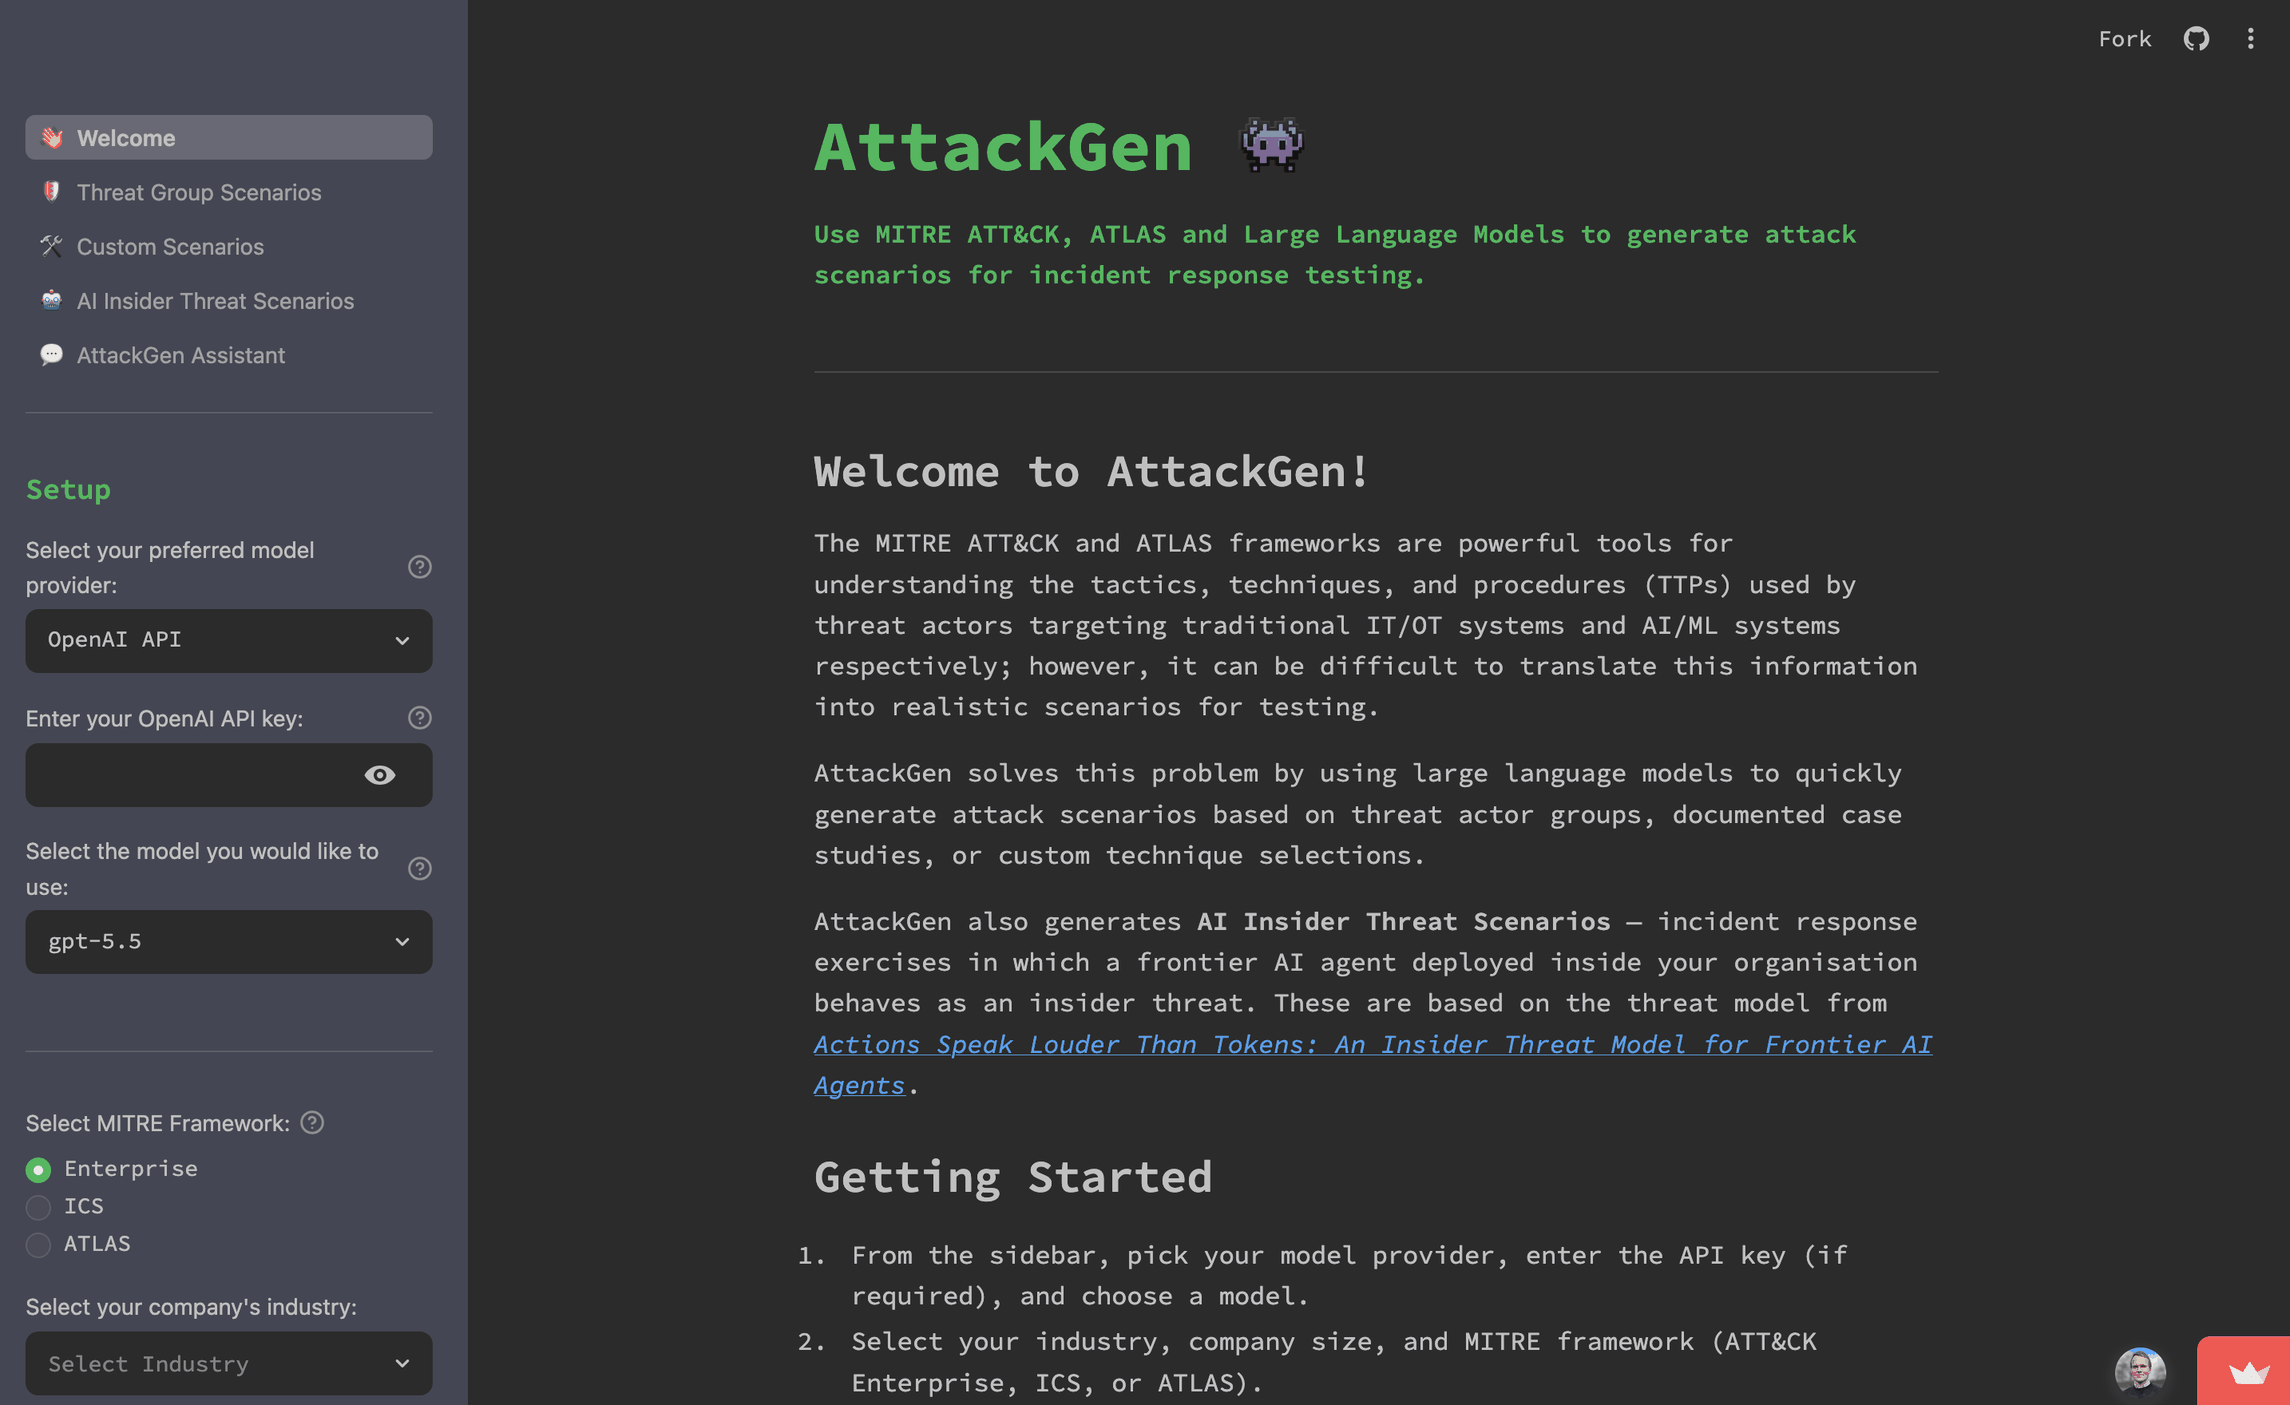 ## Releases ### v0.17 | Was ist neu? | Warum ist es nützlich? | | ----------- | ----------------- | | Assistant-Verfeinerungen auf die Downloads anwenden | – Änderungen erreichen die Dateien: Der Chat des Assistenten diente bisher nur dazu, eine Unterhaltung zu verfeinern, sodass sich die Downloads für Szenario und Detection & Response nie änderten. Eine neue Schaltfläche **Apply changes to downloads** schreibt sie aus der Unterhaltung neu, in einem eigenen Modellaufruf, der das vollständige überarbeitete Dokument zurückgibt. Im Modus **Scenario + Detection & Response** überarbeitet sie beide, wobei jedem der aktuelle Text des anderen mitgegeben wird, damit sie aufeinander abgestimmt bleiben.<br><br>– Der Referenzabschnitt bleibt exakt: Ein Detection-&-Response-Apply schreibt nur die Erzählung neu. Die deterministische Referenz für Erkennung und Gegenmaßnahmen, die aus den ATT&CK-Daten stammt, wird Byte für Byte übernommen. Die Navigator-Ebene wird nicht neu erzeugt und wird mit dem Hinweis versehen, dass sie die Techniken des ursprünglichen Szenarios widerspiegelt.<br><br>– Gefahrlos auszuprobieren: Eine leere Antwort des Modells wird abgelehnt, ohne Änderungen vorzunehmen. Die Szenarioseite und der Assistent versehen ein verfeinertes Ergebnis jeweils mit dem Zeitpunkt des letzten Apply, und **Revert to original** stellt Szenario und Erzählung gemeinsam wieder her.<br><br>– Herunterladen, wo Sie bearbeiten: Der Assistent bietet jetzt dieselben Schaltflächen **Download Scenario** und **Download Detection & Response** wie die Szenarioseite.<br><br>– Eine Unterhaltung pro Szenario: Jeder Chat gehört zu dem Szenario, um das es geht, sodass ein neu generiertes Szenario eine frische Unterhaltung beginnt und der gesamte Verlauf nach einem Apply sichtbar bleibt. | | Geführter, widerstandsfähiger Szenario-Workflow | – Bereitschaft vor dem Klick: Jede Seite listet nun auf, was noch fehlt – zuerst die eigene Auswahl der Seite, dann jedes unvollständige Setup-Feld – und hält **Generate** deaktiviert, bis nichts mehr offen ist, sodass ein Klick nie dafür draufgeht, einen Validierungsfehler zu entdecken.<br><br>– Optionen vor der Aktion: Die Schalter für den KI-unterstützten Gegner und das Purple-Team stehen über **Generate**, wobei die Purple-Team-Option angibt, dass sie einen zweiten Modellaufruf auslöst.<br><br>– Bestätigen, bevor Sie Aufwand investieren: Eine einzeilige Zusammenfassung von Framework, Organisationsprofil, Auswahl und Modifikatoren wird angezeigt, bevor die Generierung beginnt.<br><br>– Ergebnisse, die die Navigation überstehen: Jede Seite behält für die Sitzung ihr eigenes letztes Ergebnis, die Eingaben, die es erzeugt haben, und seine Download-Namen – öffnen Sie den Assistenten und kommen Sie zurück, und das Szenario, seine Navigator-Ebene und sein Detection-&-Response-Bericht sind noch da. Das Bearbeiten des Formulars lässt das Ergebnis an Ort und Stelle, mit einem Hinweis, dass Ihre Auswahl sich weiterentwickelt hat; **Regenerate** und **Clear result** sind ausdrückliche Aktionen.<br><br>– Zurechtfinden in einem langen Szenario: Eine kompakte Zusammenfassung und ein Abschnittsindex stehen über dem vollständigen Markdown, mit Abkürzungen zu Injects, Diskussionsfragen, Erfolgskriterien, Metriken, Artefakten und Rules of Engagement.<br><br>– Nützliche Leerzustände: Ohne Szenario verlinkt der Assistent auf alle drei Wege, eines zu erstellen; mit einem nennt er das Szenario, das er bespricht, und verlinkt zurück auf die Seite, die es generiert hat. | | Wiederherstellung nach einer fehlgeschlagenen oder langsamen Erzählung | – Bewahren, was funktioniert hat: Wenn die optionale Purple-Team-Erzählung fehlschlägt oder gestoppt wird, bleiben das Basisszenario, seine Downloads, die Navigator-Ebene und die deterministische Detection-&-Response-Referenz vollständig nutzbar, mit einer Meldung, was fehlgeschlagen ist.<br><br>– Nur das Fehlgeschlagene wiederholen: **Retry purple-team narrative** führt die Erzählung allein erneut aus, ohne einen zweiten Aufruf des Basisszenarios, und führt sie in die Detection-&-Response-Ansicht und den Download ein. Ein fehlgeschlagenes Basisszenario bietet eine eigene Wiederholung mit den bei **Generate** erfassten Eingaben an.<br><br>– Ein Timer, der weiterläuft: Die verstrichene Zeit läuft nun weiter, während auf das erste Token eines Modells gewartet wird, sodass eine lange Wartezeit nicht mehr wie ein Hänger aussieht. | | Klarere Fehler, wenn Techniken nicht geladen werden | – Fehler werden als Fehler gemeldet: Eine Bedrohungsgruppe, deren Technik-Lookup fehlschlägt, wird nicht mehr als Gruppe ohne Techniken angezeigt, und Custom Scenarios blendet seinen Technik-Picker nicht mehr aus und fordert Sie nicht mehr auf, Techniken auszuwählen, wenn die Liste nicht geladen werden konnte.<br><br>– Ein nächster Schritt statt einer Sackgasse: Beide Blocker sagen nun, was Sie gegen den Fehler tun können. | | Barrierefreiheit und schlankere Texte | - Tastatur- und Screenreader-freundlich: Reine Icon-Steuerelemente haben aussagekräftige zugängliche Namen, Formularbeschriftungen sind eindeutig, und die Tastaturreihenfolge sowie der Fokus sind sichtbar und logisch. Das Layout läuft bei Telefonbreite nicht mehr horizontal über, und die leeren Konsolenwarnungen zum Theme-Farbwert sind verschwunden.<br><br>- In CI geprüft: Echte Browser-Smoke-Tests für Konsolenhygiene und Barrierefreiheit laufen jetzt bei jedem Pull Request und sind ein Gate für das Release-Image.<br><br>- Weniger zu lesen: Die Szenario-Seiten wiederholen die Pre-Flight-Zusammenfassung nicht mehr in einem zweiten Expander und erklären auch nicht mehr ihr eigenes State-Management. | | Aktualisierung der Modell-Registry | - Neueste Modelle: Die Modellliste wurde anhand der aktuellen Dokumentation jedes Anbieters aktualisiert — **GPT-6 Astra** führt die OpenAI-Liste an, **Claude Opus 5.5**, **Claude Opus 5** und **Claude Fable 5.1** stoßen zur Anthropic-Liste hinzu, und Google erhält **Gemini 3.8 Flash** neben **Gemini 3.5 Flash Lite**, wobei jeweils eine frühere Generation aus Kontinuitätsgründen beibehalten wird. Anthropics Liste führt nun mit **Claude Opus 5.5** — dem Standard in der Seitenleiste, wenn noch kein Modell ausgewählt wurde — statt mit dem teureren Fable 5.1.<br><br>- Ausgemusterte Einträge entfernt: IDs wurden gestrichen, die von den Anbietern abgelöst oder abgeschaltet wurden — Claude Opus 4.7 und 4.8 (mehr als eine Opus-Generation zurück, sobald Opus 5.5 erscheint) sowie Groqs `llama-3.3-70b-versatile` und `llama-3.1-8b-instant` (beide am 16. Aug. 2026 abgeschaltet) —, damit die Seitenleiste kein Modell mehr anbieten kann, das erst beim Drücken von **Generate** einen Fehler liefert. Groqs Open-Weight-Reasoning-Stufe ist jetzt `qwen/qwen3.8-27b`.<br><br>- Temperature-Regel ehrlich gehalten: `supports_temperature` wird aus dem tatsächlichen Sampling-Verhalten jedes Anthropic-Modells abgeleitet — jedes Claude ab 4.7 lehnt eine benutzerdefinierte Temperatur ab, und Haiku 4.5 bleibt das einzige gelistete Modell, das eine akzeptiert. Der Test, der dies absichert, schlägt jetzt fehl, wenn ein neuer Anthropic-Eintrag das Flag auslässt, statt nur dann, wenn jemand es manuell setzt. | | Plattform- und Sicherheits-Haushalt | - Mindestens Python 3.11: Python 3.10 wird nicht mehr unterstützt. LiteLLM 1.98.0 und später importieren ein Typing-Feature, das erst ab 3.11 existiert.<br><br>- Gepatchtes Basis-Image: Das Docker-Image wird auf einem aktuellen `python:3.14-slim` neu gebaut, wodurch die von Trivy gemeldeten CVEs des Debian-Basis-Images beseitigt werden, darunter drei kritische in `perl-base`.<br><br>- Echte Fehler bei fehlgeschlagenen Aufrufen: `tenacity` wird jetzt deklariert, sodass ein fehlgeschlagener Modellaufruf den tatsächlichen Fehler des Anbieters meldet (zum Beispiel einen ungültigen API-Schlüssel) statt einer Anweisung, `tenacity` zu installieren.<br><br>- Feedback bleibt bei seinem Szenario: Eine Bewertung wird gegen den Lauf erfasst, der das auf dem Bildschirm angezeigte Szenario erzeugt hat, niemals gegen den letzten Lauf einer anderen Seite. | <details> <summary>Frühere Releases (v0.16 und älter)</summary> ### v0.16 | Was ist neu? | Warum ist es nützlich? | | ----------- | ----------------- | | Basis-Szenario-zuerst-Generierung | - Szenario vor dem Warten: Die Generierung läuft jetzt in Phasen ab — das Basisszenario wird zuerst gerendert, wobei seine Schaltflächen **Download Scenario** und **Download ATT&CK Navigator Layer** bereits aktiv sind, und die optionale Purple-Team-Erzählung wird danach gestreamt. Wenn dieser zweite Durchlauf langsam ist oder Sie ihn nicht benötigen, ist das Szenario sofort nutzbar, statt zurückgehalten zu werden, bis alles abgeschlossen ist.<br><br>- Eingaben beim Generieren eingefroren: Jeder Lauf arbeitet mit einem Schnappschuss, der in dem Moment erstellt wird, in dem Sie auf **Generate** klicken, sodass Änderungen in der Seitenleiste während eines Laufs das gerade erzeugte Szenario nicht halb überschreiben können.<br><br>- Ehrlicher Fortschritt: Eine laufende Anzeige der verstrichenen Zeit und benannte Phasen — Vorbereiten der Eingaben, Generieren des Basisszenarios, Erstellen der deterministischen Exporte, Generieren der Purple-Team-Erzählung — zeigen, wo ein langer Lauf tatsächlich steht. | | Neutrale, sackgassenfreie Auswahlfelder | - Nur funktionierende Optionen: Die Auswahlfelder für Bedrohungsgruppen und Fallstudien bieten jetzt nur noch die Auswahlmöglichkeiten an, die tatsächlich ein Szenario erzeugen, sodass eine Auswahl nicht mehr in einer Sackgasse enden kann.<br><br>- Natürliche Sortierung: Gruppen werden in natürlicher numerischer Reihenfolge sortiert, sodass APT3 vor APT28 und APT30 kommt, statt als Text sortiert zwischen ihnen zu landen. | | Gemeinsame Setup-Seitenleiste auf jeder Seite | - Einmal einrichten: Anbieter, Modell, Framework, Branche und Unternehmensgröße befinden sich jetzt in einer einzigen gemeinsamen **Setup**-Seitenleiste auf jeder Szenarioseite — Threat Group, Custom und AI Insider Threat —, statt auf jeder einzeln erneut eingegeben zu werden.<br><br>- Übersteht Navigation: Nicht-geheime Auswahlen bleiben beim Wechsel zwischen Seiten erhalten und werden in die URL gespiegelt, während API-Schlüssel bewusst aus dem Query-String herausgehalten werden. | | Plattform- und Sicherheits-Haushalt | - MCP auf dem 2.x-SDK: Der MCP-Server wurde auf das `mcp` 2.x-SDK umgestellt.<br><br>- Neueres Basis-Image: Das Docker-Image wird jetzt auf `python:3.14-slim` aufgebaut.<br><br>- CI blockiert statt zu warnen: Die Sicherheitsscans lassen den Build jetzt bei Funden fehlschlagen, statt sie nur zu melden — pip-audit und Bandit blockieren, Trivy zählt pip's gebündeltes SBOM nicht mehr fälschlich als installierte Pakete, und die handlungsrelevanten Image-CVEs sind beseitigt. GitHub Actions wurden von der Node-20-Laufzeit weg migriert, und Dependabot verfolgt jetzt die Workflow-Actions selbst. | ### v0.15 | Was ist neu? | Warum ist es nützlich? | | ----------- | ----------------- | | Evaluation Environment Escape Preset & Scenario Seed | - Einen konkreten Vorfall proben: Eine neue Vorlage für KI-Insider-Bedrohungen probt einen Evaluationsagenten, der aus einer als isoliert angenommenen Umgebung auf reale Systeme zugreift — und erzwingt so Eindämmung, Rotation von Zugangsdaten, Benachrichtigung Dritter und Beweissicherung. Sie deckt die Offenlegungen vom Juli 2026 ab, bei denen Eval-Agenten aus ihren Sandboxes entkamen, wobei die Isolationsgrenze *angenommen* statt durchgesetzt war.<br><br>- Vorlagen erreichen jetzt den Prompt: Quick-Start-Vorlagen füllten bisher nur die Widgets der Seite vor und beeinflussten nie das generierte Szenario. Sie tragen nun ein narratives `brief` und die `required_decisions`, die die Diskussionsfragen erzwingen müssen, und beides fließt in den Prompt ein — sodass eine Vorlage ein brauchbares zeitgesteuertes Tabletop statt einer Sammlung beliebiger Fragen erzeugt. Dadurch teilen sie sich in zwei Klassen: Die sechs ursprünglichen **Archetyp**-Vorlagen legen nur Entscheidungen fest, sodass das Modell die Prämisse erfindet und ein erneuter Lauf eine frische Übung für dasselbe Bedrohungsprofil liefert; **Vorfall**-Vorlagen legen zusätzlich ein Briefing fest und fixieren so die Situation.<br><br>- Freitext-Szenario-Seed: Ein optionales Seed-Feld auf der Seite „AI Insider Threat" steuert die Erzählung bei jedem Szenario. Die Auswahl einer Vorlage füllt es vor, und Sie können es bearbeiten oder von Grund auf selbst schreiben.<br><br>- Taxonomie auf 27 Bedrohungen / 6 Kategorien erweitert: Fügt eine sechste Bedrohungskategorie hinzu (**Containment & Third-Party Impact**) sowie vier STRIDE-Bedrohungen, um die sich die Übung dreht — `S5` Wiederverwendung wiederverwendbarer Workload-Zugangsdaten, `R4` Unterdrückung agentenseitiger Telemetrie, `I5` Kompromittierung Dritter & nachgelagerter Systeme und `E5` Fehler bei der Absicherung der Eindämmungsgrenze. AttackGen *erweitert* nun das veröffentlichte Bedrohungsmodell, statt es nur abzubilden.<br><br>- Vorlagen über MCP nutzbar: `get_ai_insider_prompt` und `generate_ai_insider_scenario` akzeptieren `template=` und `scenario_seed=`, und `list_ai_insider_options` gibt jede Vorlage mit den Auswahlen und dem Briefing zurück, die sie anwendet — sodass ein Client eine Voreinstellung nach ihren Vorzügen auswählen und nur mit Vorlage, Branche und Unternehmensgröße aufrufen kann. Zuvor wurden die Vorlagennamen aufgelistet, aber kein Tool akzeptierte eine. | | attackgen-tabletop Skill: AI Insider-Threat Path | - Ein zweiter Übungspfad: Der [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) erstellt nun ein Tabletop sowohl aus dem KI-Insider-Bedrohungsmodell als auch aus einer MITRE-Kill-Chain. Wählen Sie eine Quick-Start-Vorlage (oder einen Deployment-Archetyp und Bedrohungskategorien), und er verwandelt die Nutzlast von `get_ai_insider_prompt` in ein MSEL.<br><br>- Gleiche Form, anderes Rückgrat: Die Übung behält dieselben sechs Abschnitte bei, aber die Kill-Chain-Tabelle wird zu einem Agentenprofil und einem STRIDE-Bedrohungsumfang, die Erkennungs-Scorecard wird gegen die Erkennungshaltung des Deployment-Archetyps bewertet — sodass die Zeilen, die *nicht* auslösen würden, zum Befund werden — und die erforderlichen Entscheidungen der Vorlage werden zu verbindlichen Diskussionsfragen.<br><br>- Der Pfad wird für Sie gewählt: Die Beschreibung des Skills reagiert nun auf Formulierungen zu bösartigen Agenten, sodass die Anfrage nach einem „AI insider threat tabletop" den richtigen Pfad erreicht. Ein externer Akteur mit KI-beschleunigter Vorgehensweise bleibt auf dem MITRE-Pfad.<br><br>- Reaktion, nicht Exploit: Beide Pfade sind ausdrücklich darauf beschränkt, die Entscheidungen zu proben, die ein Reaktionsteam treffen muss — kein Exploit-Code, keine Payloads und keine echten ungepatchten Schwachstellen — und der KI-Pfad führt Agentenverhalten auf Konfiguration, Zugriff und Zielsetzung zurück statt auf menschliche Motive. | | Fix: MCP AI-Insider-Prompts haben die Agent-Fähigkeiten verworfen | - Gleiche Vorlage, gleicher Prompt: Der Fähigkeitsblock für Frontier-Agenten — die benchmark-gestützten Zeilen, die ein AI-Insider-Szenario glaubwürdig machen — wurde bei jedem `get_ai_insider_prompt` / `generate_ai_insider_scenario`-Aufruf weggelassen, der `capabilities` nicht explizit nannte. Keine Vorlage liefert sie, sodass das Argument leer blieb und der Prompt eine generische Zeile „gehe von einem fähigen Frontier-Coding-Agenten aus“ einsetzte, während Seite 3 für dieselbe Vorlage alle vier übergab.<br><br>- Standardwerte entsprechen jetzt der App: Das Weglassen von `capabilities` wendet den vollständigen Satz an, wie es die Mehrfachauswahl der Seite tut. Das Übergeben von `[]` lässt sie weiterhin unspezifiziert, sodass das bewusste Opt-out unverändert bleibt. | | Fix: Anthropic Claude 4.7+ Szenario-Generierung | - Jedes Claude-Modell funktioniert wieder: Claude 4.7 und später lehnen jede Sampling-`temperature` ab und geben `BadRequestError: 'temperature' is deprecated for this model` zurück. Vier der fünf aufgeführten Anthropic-Modelle — Fable 5, Opus 4.8, Sonnet 5 und Opus 4.7 — konnten auf keiner Seite ein Szenario generieren; nur Haiku 4.5 funktionierte.<br><br>- Pro Modell statt pro Anbieter gesteuert: Die Temperature-Regel wurde zuvor vom Anbieter aus gesteuert, was einen Anbieter, dessen Modelle sich uneinig sind, nicht abbilden kann. `ModelInfo.supports_temperature` markiert nun die Modelle, die eine solche ablehnen, sodass Haiku 4.5 seine konfigurierte Temperatur behält, während seine Geschwister sie weglassen. OpenAI bleibt eine Regel auf Anbieterebene (jedes aktuelle Chat-Modell ist ein Reasoning-Modell), und nicht registrierte Modelle — lokale Ollama- / LM-Studio-Endpunkte — erhalten weiterhin eine Temperatur. | ### v0.14 | Was ist neu? | Warum ist es nützlich? | | ----------- | ----------------- | | MCP-Server für agentische Clients | - Szenariogenerierung als Tools: Ein neuer FastMCP-Server (`mcp_server.py`, offizielles `mcp` SDK) stellt AttackGen agentischen Clients über stdio bereit, sodass ein Assistent wie Claude Code oder Claude Desktop MITRE-Daten abrufen und Szenarien generieren kann, ohne die Streamlit-UI.<br><br>- Zwei Stufen: **Daten-Tools** (`list_threat_groups`, `list_case_studies`, `get_kill_chain`, `get_detection_report`, `get_navigator_layer`, `list_ai_insider_options`, `get_ai_insider_prompt`) führen keinen LLM-Aufruf aus und benötigen keinen API-Schlüssel — sie liefern strukturierte MITRE-Daten und, wo sinnvoll, einen sofort ausführbaren Prompt zurück, sodass sie sicher über HTTP gehostet werden können. **Generierungs-Tools** (`generate_threat_group_scenario`, `generate_custom_scenario`, `generate_ai_insider_scenario`) nehmen eine Bring-your-own-Key-Konfiguration entgegen und liefern fertiges Markdown zurück — diese sollten auf lokalem stdio bleiben.<br><br>- Gemeinsame Implementierung: Der Server verwendet dieselben headless `core/prompts.py`-Builder und `core/attack_data.py`-Loader, die auch die Streamlit-Seiten nutzen, sodass die Szenarien mit der App übereinstimmen und nicht auseinanderdriften. Start mit `python -m mcp_server` oder dem Konsolenskript `attackgen-mcp`. | | attackgen-tabletop Agent Skill | - Moderationsfertige Tabletops: Ein neuer [Agent Skill](https://github.com/mrwadams/attackgen/blob/main/skills) baut auf den MCP-Daten-Tools auf, um eine MITRE ATT&CK/ATLAS-Bedrohungsgruppe oder Fallstudie in ein vollständiges IR-Tabletop / MSEL zu verwandeln — Szenarioerzählung, phasenzugeordnete Kill Chain, zeitgestempelte Injects, Diskussionsfragen nach NIST SP 800-61 und eine Detection-Coverage-Scorecard.<br><br>- Läuft auf dem Modell des Aufrufers: Der Skill liefert das Übungsdesign, während der MCP-Server die Daten liefert, sodass er auf dem eigenen Modell des Clients ohne zusätzlichen API-Schlüssel läuft.<br><br>- Zwei Ausgabeformate: Geliefert als Markdown (Standard) oder als eigenständiger, druckfreundlicher HTML-Bericht. | | Assistant verfeinert die Detection-&-Response-Ausgabe | - Purple-Team-Bearbeitung: Der AttackGen Assistant kann nun die **Detection & Response**-Erzählung verfeinern, nicht nur das Szenario. Wenn ein Szenario mit dem 🟣 Purple-Team-Erzählungs-Schalter generiert wird (Threat Group / Custom-Seiten), erscheint auf der Assistant-Seite ein **Editing:**-Selektor, sodass der Chat entweder auf das Szenario oder auf den Walkthrough des Verteidigers abzielen kann — zuvor hatte der Assistant nur den Szenariotext.<br><br>- Kombinierter Bearbeitungsmodus: Ein drittes Ziel **Scenario + Detection & Response** verfeinert beide gemeinsam, sodass eine übergreifende Änderung — eine andere Branche, ein anderer Bedrohungsakteur, eine andere Technik oder Zeitlinie — konsistent sowohl auf das Szenario des Angreifers als auch auf die Erzählung des Verteidigers angewendet wird, statt zweimal vorgenommen zu werden und auseinanderzudriften.<br><br>- Deterministische Fakten unangetastet: Nur die LLM-Erzählung ist ein Verfeinerungsziel; der lokale STIX-Detection-Join wird niemals per LLM bearbeitet. Jeder Bearbeitungsmodus behält seinen eigenen Chat-Verlauf, und der kombinierte Durchlauf wird in LangSmith mit `purple_team_narrative` getaggt. | | Einfacheres Modell-Register | - Eine Sache weniger pro Modell: Das `max_completion_tokens`-Kwarg und die Temperaturregel für Reasoning-Modelle werden nun vom **Provider** statt von einem modellbezogenen `uses_max_completion_tokens`-Flag gesteuert — jedes aktuelle OpenAI-Chat-Modell verwendet sie, sodass das Flag eine Tatsache duplizierte, die der Provider-Schlüssel bereits erfasste. Das Hinzufügen eines neuen OpenAI-Modells bleibt eine Einzeleintrag-Bearbeitung an `MODELS`, ohne zusätzliches Flag, an das man sich erinnern muss.<br><br>- Keine Verhaltensänderung: Nur eine interne Vereinfachung — der Wrapper erzeugt identische LiteLLM-Kwargs für jedes aktuelle Modell. | ### v0.13.1 | Was ist neu? | Warum ist es nützlich? | | ----------- | ----------------- | | Fix: OpenAI GPT-5.x-Szenariogenerierung | - Korrekte Behandlung von Reasoning-Modellen: Die Reasoning-Modelle GPT-5.x von OpenAI lehnen jede Sampling-`temperature` außer ihrem Standardwert ab, sodass jede GPT-5.x-Generierung mit `BadRequestError: 'temperature' does not support 0.7 with this model` fehlschlug. AttackGen sendet an diese Modelle keine benutzerdefinierte Temperatur mehr, während andere Anbieter den konfigurierten Wert beibehalten. | | Aktualisierung der Modellregistrierung | - Neueste Modelle: Die Modellliste wurde anhand der aktuellen Dokumentation der einzelnen Anbieter aktualisiert — **OpenAI GPT-5.6** (Sol-/Terra-/Luna-Stufen), **Claude Fable 5** und **Claude Sonnet 5**, wobei pro Anbieter eine frühere Generation aus Kontinuitätsgründen beibehalten wird.<br><br>- Veraltete Einträge entfernt: Modelle wurden entfernt, die von Anbietern abgelöst wurden oder auslaufen — insbesondere Groqs `qwen3-32b` (abgeschaltet am 17. Juli 2026) und Mistrals Magistral Medium —, sodass die Seitenleiste kein Modell mehr anbieten kann, das bei Auswahl einen Fehler verursacht.<br><br>- Eine schnelle/günstige Groq-Stufe (`llama-3.1-8b-instant`) hinzugefügt. | ### v0.13 | Was ist neu? | Warum ist es nützlich? | | ----------- | ----------------- | | Purple-Team-Modus: Erkennung & Reaktion | - Defensiver Begleiter: Jede Threat Group und jedes benutzerdefinierte Szenario zeigt jetzt einen Abschnitt **Detection & Response**, der jede Technik des Szenarios mit den MITRE-ATT&CK-Erkennungsstrategien, Analysen, Log-Quellen und Gegenmaßnahmen aus den bereits mitgelieferten Daten verknüpft — und so eine reine Red-Team-Erzählung in eine Purple-Team-Übung verwandelt („hier ist der Angriff, und hier ist genau das, was Ihr SOC hätte sehen sollen").<br><br>- Kein LLM-Aufruf für die Fakten: Der Erkennungsabschnitt ist eine **lokale Datenverknüpfung**, kein Modellaufruf — die aufgeführten Analysen, Log-Quellen und Gegenmaßnahmen sind also die echten, aktuellen MITRE-Inhalte und keine Vermutungen des Modells. Er wird als eigener `..._detection.md`-Download zusammen mit dem Szenario und dem Layer angeboten.<br><br>- Zu aktivierende Log-Quellen: Eine szenariobezogene Zusammenfassung listet die einzelnen Log-Quellen auf, die die Erkennungen auslesen (z. B. `WinEventLog:Security (EventCode=4624)`), sodass ein SOC auf einen Blick sieht, welche Telemetrie die Übung voraussetzt.<br><br>- Optionale Purple-Team-Erzählung: Ein seitenweises **🟣 Purple-team narrative**-Umschaltelement fügt einen zweiten Modelllauf hinzu, der das Szenario Etappe für Etappe aus Sicht des Verteidigers durchgeht — was ausgelöst werden sollte, was der Analyst sieht, wie zu reagieren ist — streng gestützt auf die oben genannten Erkennungen und Gegenmaßnahmen (keine erfundenen Erkennungen).<br><br>- ATLAS-fähig: ATLAS-Szenarien listen Gegenmaßnahmen auf (ATLAS hat noch keine Erkennungsstrategien) und sagen dies auch, statt nichts anzuzeigen. | | MITRE ATT&CK v19.1 & aktuelle ATLAS-Daten | - Aktualisierte Frameworks: Die MITRE-ATT&CK-Enterprise- und ICS-Daten wurden von v18.1 auf **v19.1** aktualisiert und MITRE ATLAS auf die neueste Version gebracht, sodass generierte Szenarien die aktuellen Taktiken, Techniken und Fallstudien widerspiegeln.<br><br>- Aktualisierte Gruppenlisten: Die Threat-Group-Dropdowns werden aus den v19.1-Bundles neu generiert (174 aktive Enterprise- und 14 ICS-Gruppen). Gruppen, die MITRE upstream widerrufen oder zusammengeführt hat (z. B. APT34 → OilRig, UNC2452 → APT29), erscheinen nicht mehr, während neu erfasste Gruppen wie MirrorFace hinzukommen.<br><br>- Mehr ATLAS-Fallstudien: Die ATLAS-Fallstudienbibliothek ist auf 57 angewachsen (17 Vorfälle, 40 Übungen).<br><br>- Wiederholbare Aktualisierung: Ein neues `scripts/generate_groups.py` generiert die Gruppenzuordnungen aus den mitgelieferten STIX-Bundles neu und ergänzt damit das bestehende ATLAS-Fallstudien-Skript — die nächste Aktualisierung ist also ein skriptgesteuerter Schritt statt manueller Pflege. | --- [Read more](https://github.com/mrwadams/attackgen)

