AV Chaos Monkey
Verteilte Chaos-Engineering-Plattform zum Lasttest von Videokonferenzsystemen. Simuliert 1500+ WebRTC-Teilnehmer mit H.264/Opus-Streams und injiziert Netzwerk-Chaos-Spitzen, um die Systemresilienz unter verschlechterten Bedingungen zu validieren.
Architektur
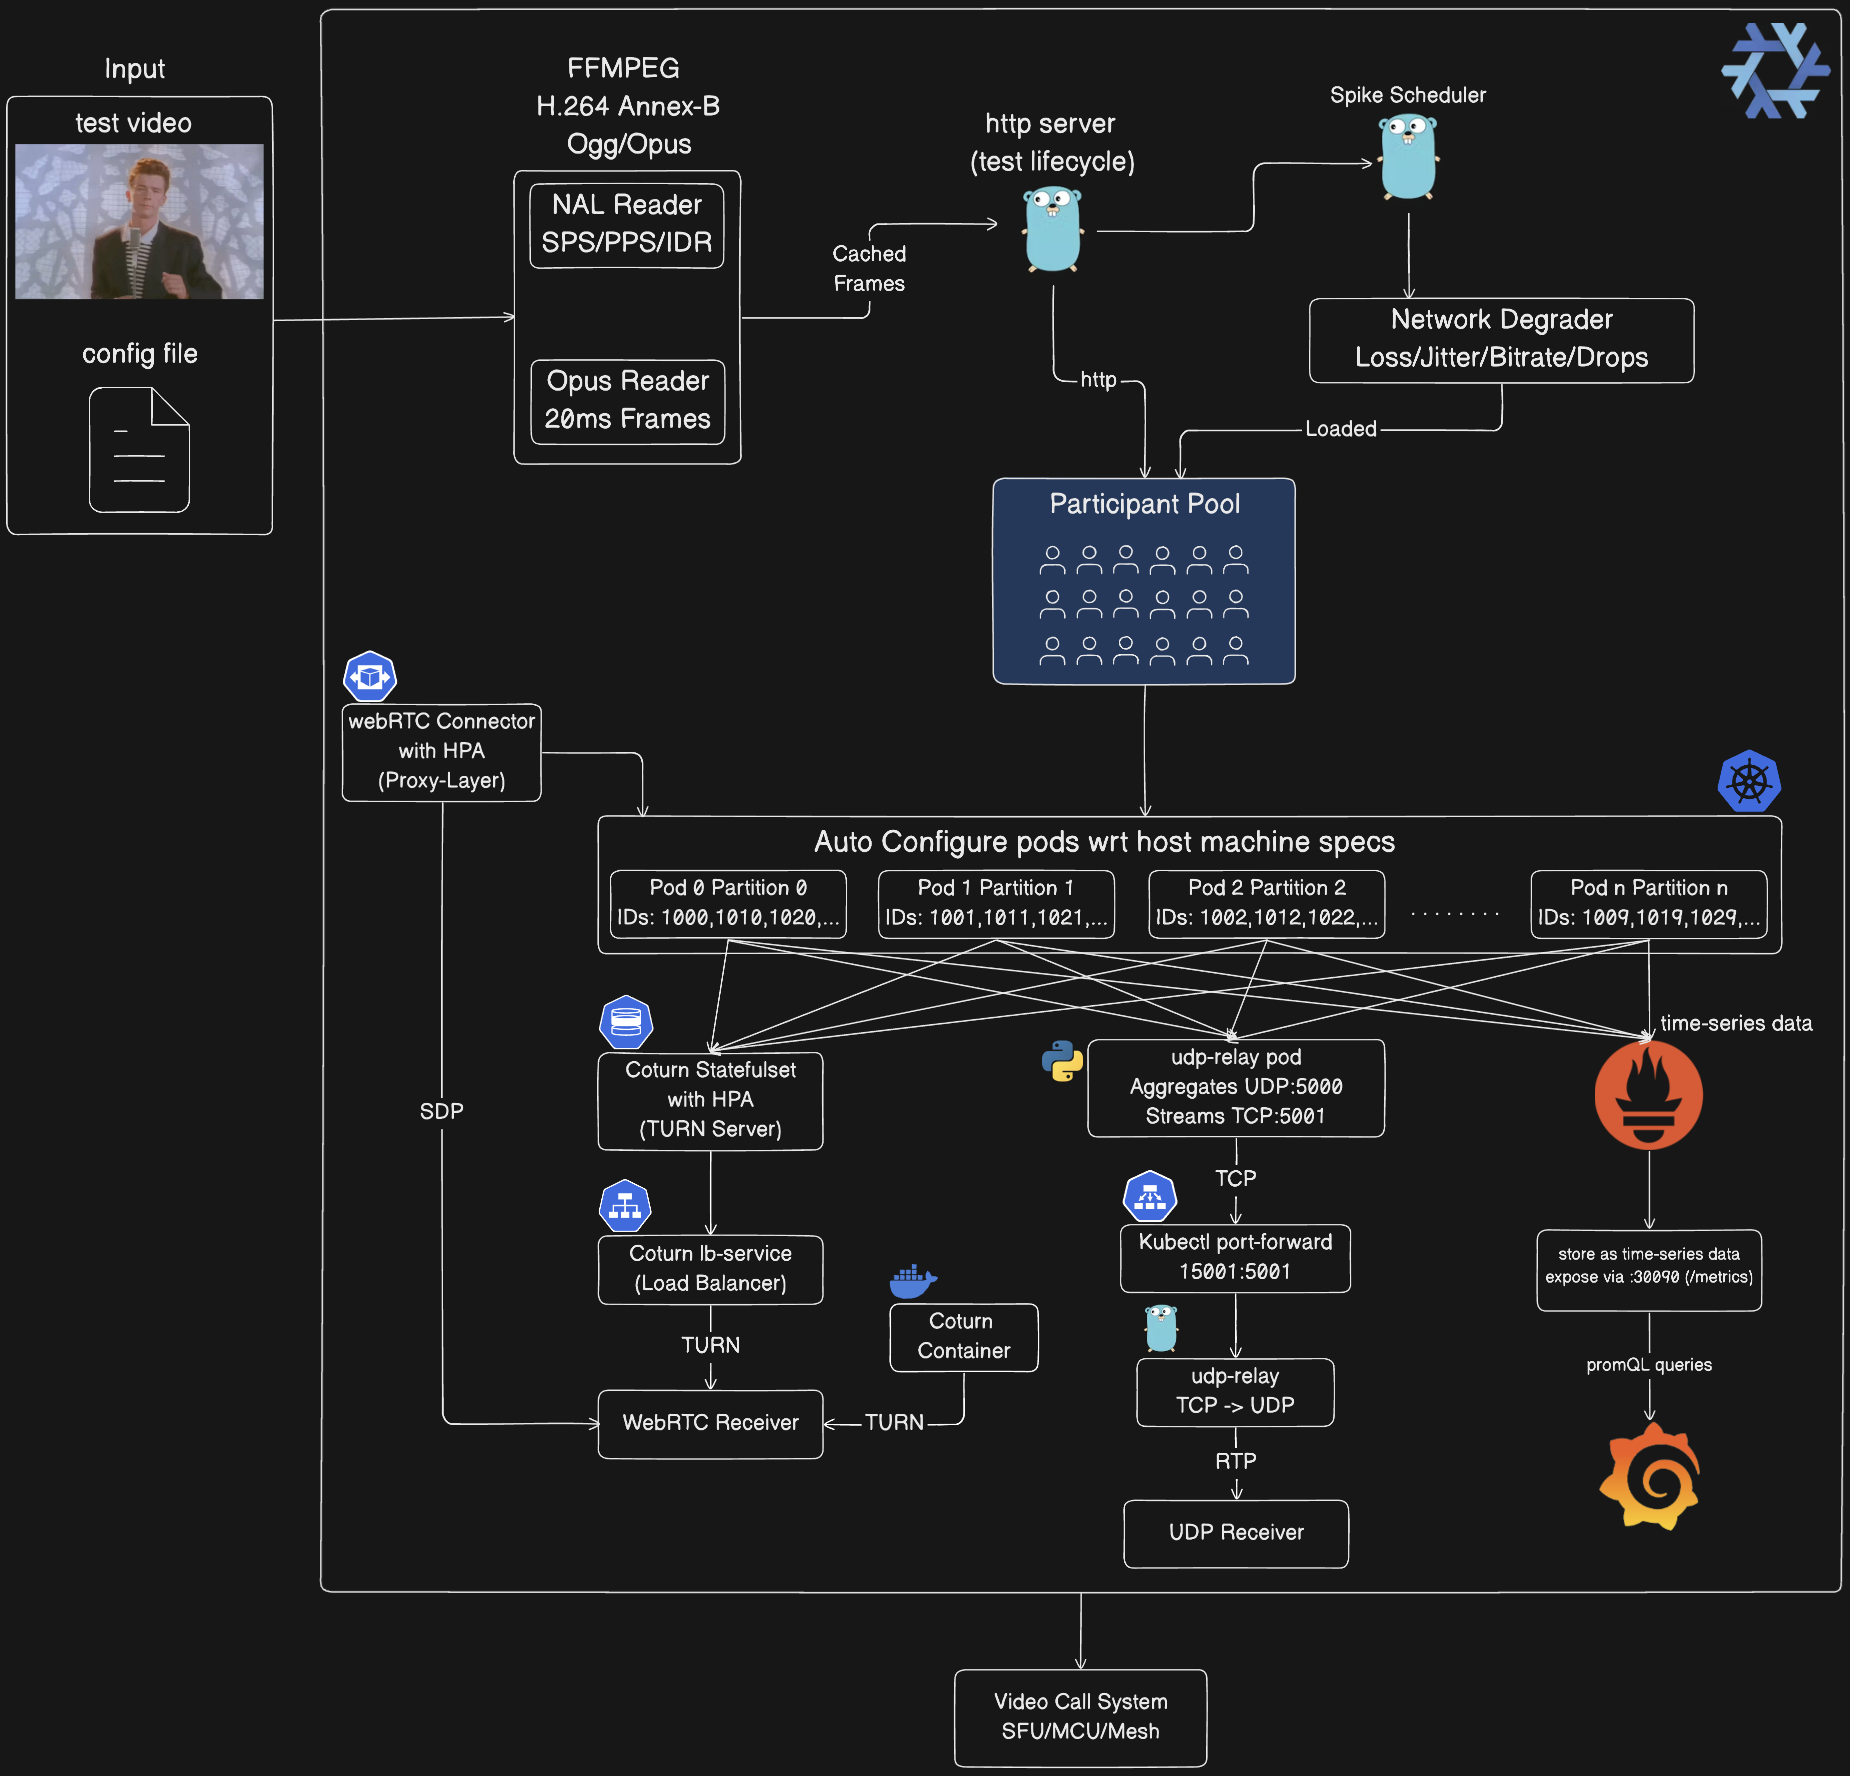
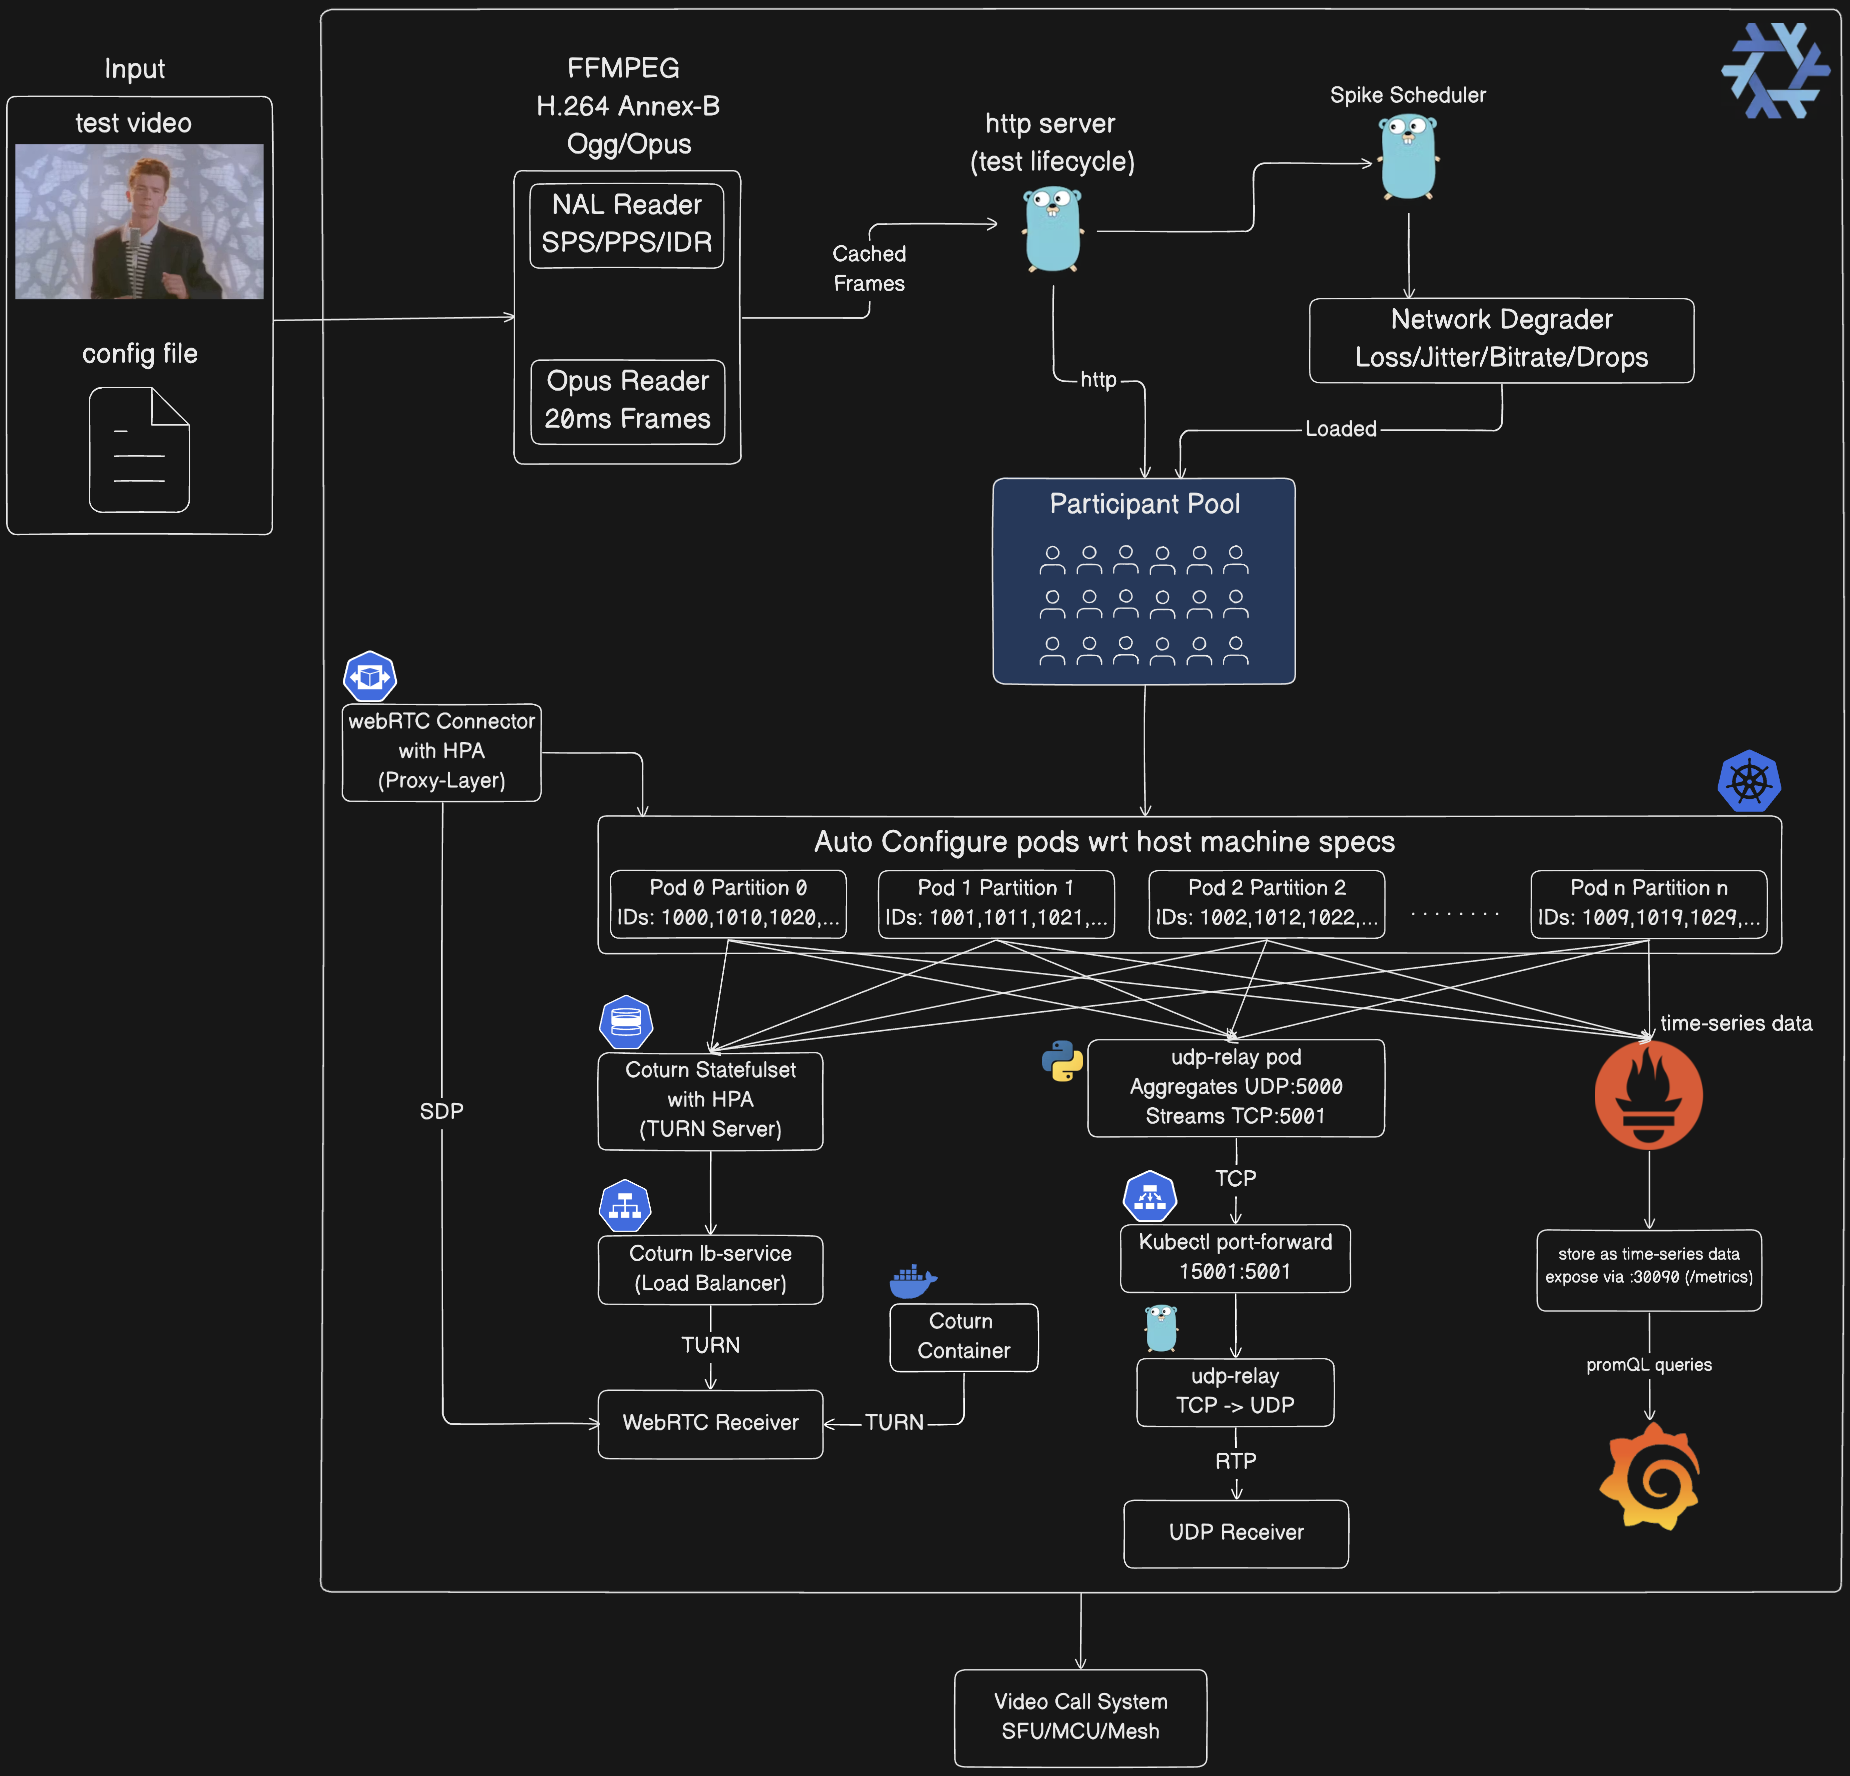
-
Medienverarbeitungspipeline:
- FFmpeg konvertiert eingehendes Video beim Start in H.264 Annex-B und Ogg/Opus
- NAL-Reader analysiert den H.264-Stream (SPS/PPS/IDR/Slices)
- Opus-Reader extrahiert 20ms-Audioframes aus dem Ogg-Container
- Frames werden im Cache gespeichert und von allen Teilnehmern gemeinsam genutzt (Zero-Copy)
- Reduziert CPU um ~90 % im Vergleich zur Kodierung pro Teilnehmer
-
Steuerungsebene:
- HTTP-Server (:8080) verwaltet den Testlebenszyklus über REST-API
- Spike-Scheduler verteilt Chaos-Ereignisse (gerade/zufällig/vorne/hinten/legacy)
- Network-Degrader wendet Chaos an: Paketverlust (1–25%), Jitter (10–50ms), Bitratenreduzierung (30–80%), Frame-Verluste (10–60%)
- Geladene Chaos-Konfiguration wird auf den Teilnehmerpool angewendet
-
Teilnehmerpool:
- Automatische Partitionierung über Pods mittels:
participant_id % total_partitions = partition_id
- Jeder Teilnehmer erzeugt RTP-Streams (PT=96 Video, PT=111 Audio)
- Teilnehmer-ID eingebettet in RTP-Erweiterungsheader (ID=1)
- Poolgröße: 1–100 (lokal), 100–500 (Docker), 500–1500 (Kubernetes)
-
Kubernetes-Autokonfiguration:
- Pods erkennen automatisch die Partitions-ID aus dem Pod-Namen:
orchestrator-3 → PARTITION_ID=3
- Port-Zuweisung:
base_port + (partition_id × 10000) + participant_index
- Beispiel: Partition 0 verwendet 5000–14999, Partition 1 verwendet 15000–24999
- StatefulSet mit 10 Replikaten, jedes handhabt ~150 Teilnehmer
- Ressourcen: 1–4 CPU, 2–4Gi Speicher pro Pod
- Automatische Konfiguration basierend auf den Spezifikationen des Host-Rechners
-
UDP-Relay-Kette (nur Kubernetes):
Orchestrator-Pods (10×) → UDP :5000 → udp-relay-Pod (Python)
→ Längenpräfix-TCP :5001 → kubectl port-forward 15001:5001
→ tools/udp-relay (Go) → UDP :5002 → Ihr Empfänger
- Warum: kubectl port-forward unterstützt nur TCP, nicht UDP
- Relay im Cluster: Python-Skript aggregiert UDP von allen Pods, streamt als TCP mit 2-Byte-Längenpräfix
- Lokales Relay: Go-Tool wandelt TCP-Stream zurück in UDP-Pakete
- Aggregiert 1500 Teilnehmer-Streams in eine einzige Verbindung
-
WebRTC-Infrastruktur:
- Coturn-StatefulSet: 3 anfängliche Replikate, HPA skaliert 1–10 basierend auf Last (~500 Teilnehmer/Replikat)
- coturn-lb-Service: Lastverteilung des TURN-Traffics auf Replikate
- webrtc-connector: Optionale Proxy-Schicht (Deployment + HPA 2–10 Replikate), behandelt SDP-Signalisierung
- Docker-Modus: Einzelner Coturn-Container für lokale Tests
- Ports: 3478 (TURN), 49152–65535 (Relay-Bereich)
- Anmeldedaten: webrtc/webrtc123
-
Client-Integration:
- UDP-Empfänger: Empfängt aggregierten RTP-Stream von allen Teilnehmern über die Relay-Kette
- WebRTC-Empfänger: Stellt 1:1-WebRTC-Verbindungen über SDP-Austausch über TURN-Server her
- Beide leiten an Ihr zu testendes Videokonferenzsystem weiter (SFU/MCU/Mesh)
-
Observability-Stack (optional):
- Prometheus: Sammelt alle 5s den
/metrics-Endpunkt von allen Orchestrator-Pods
- Grafana: Visualisiert Metriken über ein vorkonfiguriertes Dashboard (admin/admin)
- Verfügbare Metriken: Teilnehmeranzahl, gesendete Pakete, gesendete Bytes, aktive Spitzen, Paketverlust %, Jitter, MOS-Score
- Zugriff: Prometheus auf :30090, Grafana auf :30030 (NodePort)
- Orchestrator-Pods mit Anmerkungen für automatische Erkennung:
prometheus.io/scrape: "true"
Grundlegende Konzepte
Teilnehmersimulation
Jeder virtuelle Teilnehmer erzeugt echte Medienströme:
- Video: H.264-NAL-Einheiten aus tatsächlichen Videodateien, paketisiert gemäß RFC 6184
- Audio: Opus-Frames aus Ogg-Containern, paketisiert gemäß RFC 7587
- RTP: Standardkonforme Header mit Teilnehmer-ID-Erweiterungen
- Timing: Frame-genaues Timing (30fps Video, 20ms Audio-Pakete)
Chaos-Injektion
Fünf Spitzentypen simulieren reale Netzwerkbedingungen:
- Paketverlust: Verwirft RTP-Pakete auf Anwendungsebene (1–100%)
- Netzwerk-Jitter: Fügt Latenzvariation hinzu (Basis + Gauß-Jitter)
- Bitratenreduzierung: Drosselt die Videokodierung (30–80 % Reduzierung)
- Frame-Verlust: Überspringt Videoframes (10–60 % Verlustrate)
- Bandbreitenbegrenzung: Deckelt den Gesamtdurchsatz
Verteilungsstrategien
Spitzen werden über die Testdauer mit konfigurierbaren Strategien verteilt:
- Even: Gleichmäßige Abstände mit Jitter (vorhersagbare Last)
- Random: Unvorhersehbare Zeitpunkte (realistisches Chaos)
- Front-loaded: Dichte Spitzen zu Beginn (Wiederherstellungstests)
- Back-loaded: Grundlinie gefolgt von Chaos (Vergleichstests)
- Legacy: Ticker mit festem Intervall (Laufzeit-Injektion)
Partitionierung
Kubernetes-Bereitstellungen verwenden Teilnehmerpartitionierung für horizontale Skalierung:
- Jeder Pod behandelt
participant_id % total_partitions == partition_id
- Port-Zuweisung:
base_port + (partition_id * 10000) + participant_index
- Automatische Lastverteilung auf 1–10 Pods
- Skaliert auf 1500+ Teilnehmer (150 pro Pod)
Das System ausführen
1. Lokale Entwicklung (Natives Go)
Am besten geeignet für: Entwicklung, Debugging, Kleintests (1–100 Teilnehmer)
# Orchestrator starten
go run cmd/main.go

# In einem anderen Terminal: UDP-Empfänger starten
go run examples/go/udp_receiver.go 5002

# config/config.json bearbeiten und num_participants: 10 setzen
# Chaos-Test ausführen
go run tools/chaos-test/main.go -config config/config.json
Was passiert:
- Ein einzelner Orchestrator-Prozess auf
:8080
- Teilnehmer senden UDP an
127.0.0.1:5002
- Chaos-Spitzen werden über HTTP-API injiziert
- Echtzeit-Metriken werden alle 2s angezeigt
Konfiguration (config/config.json):
{
  "base_url": "http://localhost:8080",
  "media_path": "public/rick-roll.mp4",
  "num_participants": 10,
  "duration_seconds": 300,
  "spikes": {
    "count": 20,
    "interval_seconds": 5,
    "types": { "rtp_packet_loss": {...}, "network_jitter": {...} }
  },
  "spike_distribution": {
    "strategy": "random",
    "min_spacing_seconds": 5,
    "jitter_percent": 15
  }
}
2. Docker Compose (Containerisiert)
Am besten geeignet für: Isolierte Tests, CI/CD, mittlere Tests (100–500 Teilnehmer)
Voraussetzungen:
- Docker Desktop mit 8–16 GB Speicherzuweisung
docker-compose installiert
# Orchestrator-Container bauen und starten
./scripts/start_everything.sh build

# In einem anderen Terminal: UDP-Empfänger starten
go run examples/go/udp_receiver.go 5002

# config/config.json bearbeiten und num_participants: 100 setzen
# Chaos-Test ausführen (zielt auf Container)
go run tools/chaos-test/main.go -config config/config.json
Ressourcenlimits (docker-compose.yaml bearbeiten):
services:
  orchestrator:
    deploy:
      resources:
        limits:
          cpus: "14.0"
          memory: 6G  # Für mehr Teilnehmer erhöhen
Skalierungsleitfaden:
| Docker-Speicher | Max. Teilnehmer | CPU-Kerne |
|---|
| 8 GB | ~100 | 4 |
| 16 GB | ~250 | 8 |
| 24 GB | ~400 | 12 |
| 32 GB | ~500 | 14 |
3. Kubernetes mit Nix (Produktionsmaßstab)
Am besten geeignet für: Großtests (500–1500 Teilnehmer), horizontale Skalierung, Produktionsvalidierung
 mdsadiqmd/av-chaos-monkey

