Pyison
Pyison ist ein Tar-Pit für KI-Webcrawler
Einleitung
- Wie alle Webcrawler fordern KI-Bots Seiten von Webservern an und folgen dann den Links auf der Seite zu anderen Seiten. Dadurch können sie einen Index einer gesamten Website erstellen.
- Im Gegensatz zu anderen Webcrawlern stellen KI-Bots jedoch einige besondere Probleme dar
- Serveradministratoren können eine robots.txt-Datei konfigurieren, die Webcrawlern mitteilt, welche Seiten sie crawlen sollen und welche nicht.
- Es wurde festgestellt, dass einige KI-Crawler diese Datei ignorieren. Es gibt Datenschutz- und Urheberrechtsbedenken, wenn diese Bots die Daten einer Website zum Trainieren von LLMs verwenden dürfen, insbesondere wenn der Benutzer das Crawlen explizit abgelehnt hat.
- Einige Crawler ignorieren auch die Ratenbegrenzung. Wenn sie Seiten so schnell wie möglich anfordern, können sie eine erhebliche Last auf einem Webserver verursachen.
- Betreten Sie Pyison. Wie andere KI-Crawler-Tarpits (Nepenthes, Iocane) füttert Pyison Webcrawler mit einer endlosen Liste von Links zu anderen Seiten auf seiner Website. Dies fängt die Crawler auf einer einzigen Website ein, wo sie endlos in einem ständig wachsenden Meer von Links navigieren.
- Wenn KI-Crawler an einem Ort festgehalten werden, wird verhindert, dass sie andere Teile der Website indizieren, die der Besitzer möglicherweise nicht an LLMs verfüttern möchte.
- Gleichzeitig können diese Seiten jede Menge nutzlosen Text enthalten. Wenn LLMs diesen Text in ihre Modelle einbeziehen, können sie allmählich „vergiftet“ werden, da die zufällige Eingabe ihre Antworten weniger kohärent macht.
Motivation
- Nützliche Software zu erstellen, um dem Anstieg des LLM-Inhaltsdiebstahls entgegenzuwirken
- Lösen von Problemen in bestehenden KI-Tarpits:
- Generierung von Zufallstext ohne Verwendung einer Markov-Kette, von LLMs oder vorhandenen Textbeispielen
- Keine Unterscheidung von KI-Bots anhand des User-Agent-Headers, da sich Crawler oft als normale Benutzer tarnen
- Entwurf einer realistischen blogartigen Website, um die Erkennung zu verhindern
- Schaffung eines extrem anpassbaren Frameworks für weitere Konfiguration
- Bereitstellung einer Lösung, die sich einfach in eine bestehende Website integrieren lässt
- Unterstützt (aber erfordert nicht) Reverse Proxies/spezifische Webserver, bietet Unterpfad-Konfiguration mit einem Dokumentstammverzeichnis
- Betrieb mit geringem Platzbedarf statt eines gesamten CMS oder funktionsreichen Webservers
Technische Spezifikationen
- Dieses Projekt betreibt einen dynamischen Webserver unter Verwendung der HTTPServer-Bibliothek von Python
- Sätze werden aus einer 50/50-Mischung von zufälligen englischen Wörtern und „Stoppwörtern“ erzeugt
- Pyison verwendet einen globalen Salt sowie eine Seiten-URL, um seinen RNG zu seeden. Dadurch wird sichergestellt, dass, wenn Crawler jemals einen „Sicherheitscheck“ durchführen, indem sie eine Seite neu laden, diese dieselbe ist wie beim letzten Mal. Gleichzeitig sollten verschiedene Server unterschiedliche globale Seeds verwenden, damit nicht alle Websites, die Pyison verwenden, gleich aussehen.
- Es ist möglich, eine unbegrenzte Anzahl von Seiten zu generieren, da Pyison keine permanenten Dateien erstellt. Es ist ein dynamischer Webserver, der einfach HTML generiert und an den Client sendet.
- Die Verwendung von HTML-Inhalts-Tags, CSS-Formatierung und Bildern sollte die Website für einen Crawler etwas realistischer erscheinen lassen.
- Es ist möglich, die Ausgabe von Pyison zu konfigurieren, ohne das Programm neu zu schreiben, indem die Konfigurations-, statischen und Vorlagendateien geändert werden.
- Pyison antwortet auf fehlerhafte POST- und PUT-Anfragen mit einem 404, falls Crawler testen, ob diese HTTP-Verben konfiguriert sind.
Erste Schritte
-
Klonen Sie dieses Projekt in einen lokalen Ordner
-
Ändern Sie die Einstellungen in der Datei config/config.json
- Setzen Sie
random-seed auf eine zufällige Zahl!
- Setzen Sie die
port-Nummer für den Server
- Weitere Informationen finden Sie im Abschnitt Konfiguration
-
(Optional, aber empfohlen) Aktualisieren Sie die HTML-Vorlage, CSS, Bilder und robots.txt nach Ihren Wünschen
- Dieses Projekt ist effektiver, wenn Seiten unterschiedlich aussehen, was durch Variation der HTML- und CSS-Struktur erreicht werden kann. Ordnen Sie einige Dinge um und benennen Sie sie um, oder schreiben Sie sie vollständig neu.
-
(Optional) Bearbeiten Sie die robots.txt, wenn Sie ändern möchten, welche Bots betroffen sind
-
Richten Sie die Serverumgebung mit einer der unten stehenden Methoden ein
-
Stellen Sie den Server hinter einen Reverse Proxy
Lokale Ausführung
- Installieren Sie nltk
- Führen Sie Pyison aus
- Überprüfen Sie, ob es läuft
- Öffnen Sie
http://localhost:<Ihre Portnummer> in einem Browser
Docker
Mit docker compose
Mit docker run
docker run --tty --name pyison -p "127.0.0.1:80:80" --rm ghcr.io/jonaslong/pyison:main
- (Optional) Entfernen Sie das Flag
--rm, um den Container zu persistieren
Aus dem Quellcode bauen
- Klonen Sie das Repository lokal
docker build -t pyison:latest .- Führen Sie den Container aus mit
docker run --tty --name pyison -p "127.0.0.1:80:80" --rm pyison:latest
Reverse Proxy
Es wird dringend empfohlen, einen Reverse Proxy zu verwenden, um diesen Inhalt auszuliefern. Dies kann die Serverlast reduzieren, indem Seiten zwischengespeichert und Ratenbegrenzungen eingeführt werden, sowie den Inhalt über https ausliefern und vor einigen grundlegenden Webserver-Exploits schützen.
Überlegungen
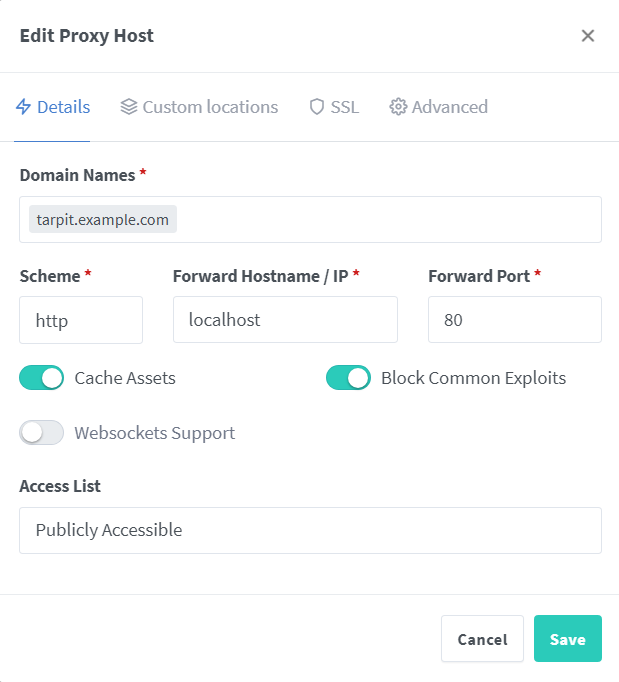
- Diese Beispiele verwenden Nginx Proxy Manager, aber jede Reverse-Proxy-Software sollte funktionieren
- Pyison unterstützt die strengsten SSL-Einstellungen von NPM
- NPM sollte den
User-Agent-HTTP-Header von NPM an den Pyison-Server ohne spezielle Konfiguration weiterleiten. Verwenden Sie proxy_pass_header User-Agent; falls nötig.
Unabhängige Subdomain-Konfiguration
 jonaslong/pyison