 hpthreatresearch/subcrawl
Modulares Framework zum Auffinden und Analysieren offener Verzeichnisse im Web. Durchsucht URLs, extrahiert Inhalte, wendet YARA/ClamAV-Scans an und gibt Ergebnisse an MISP, SQLite oder die Konsole für Threat Intelligence aus.

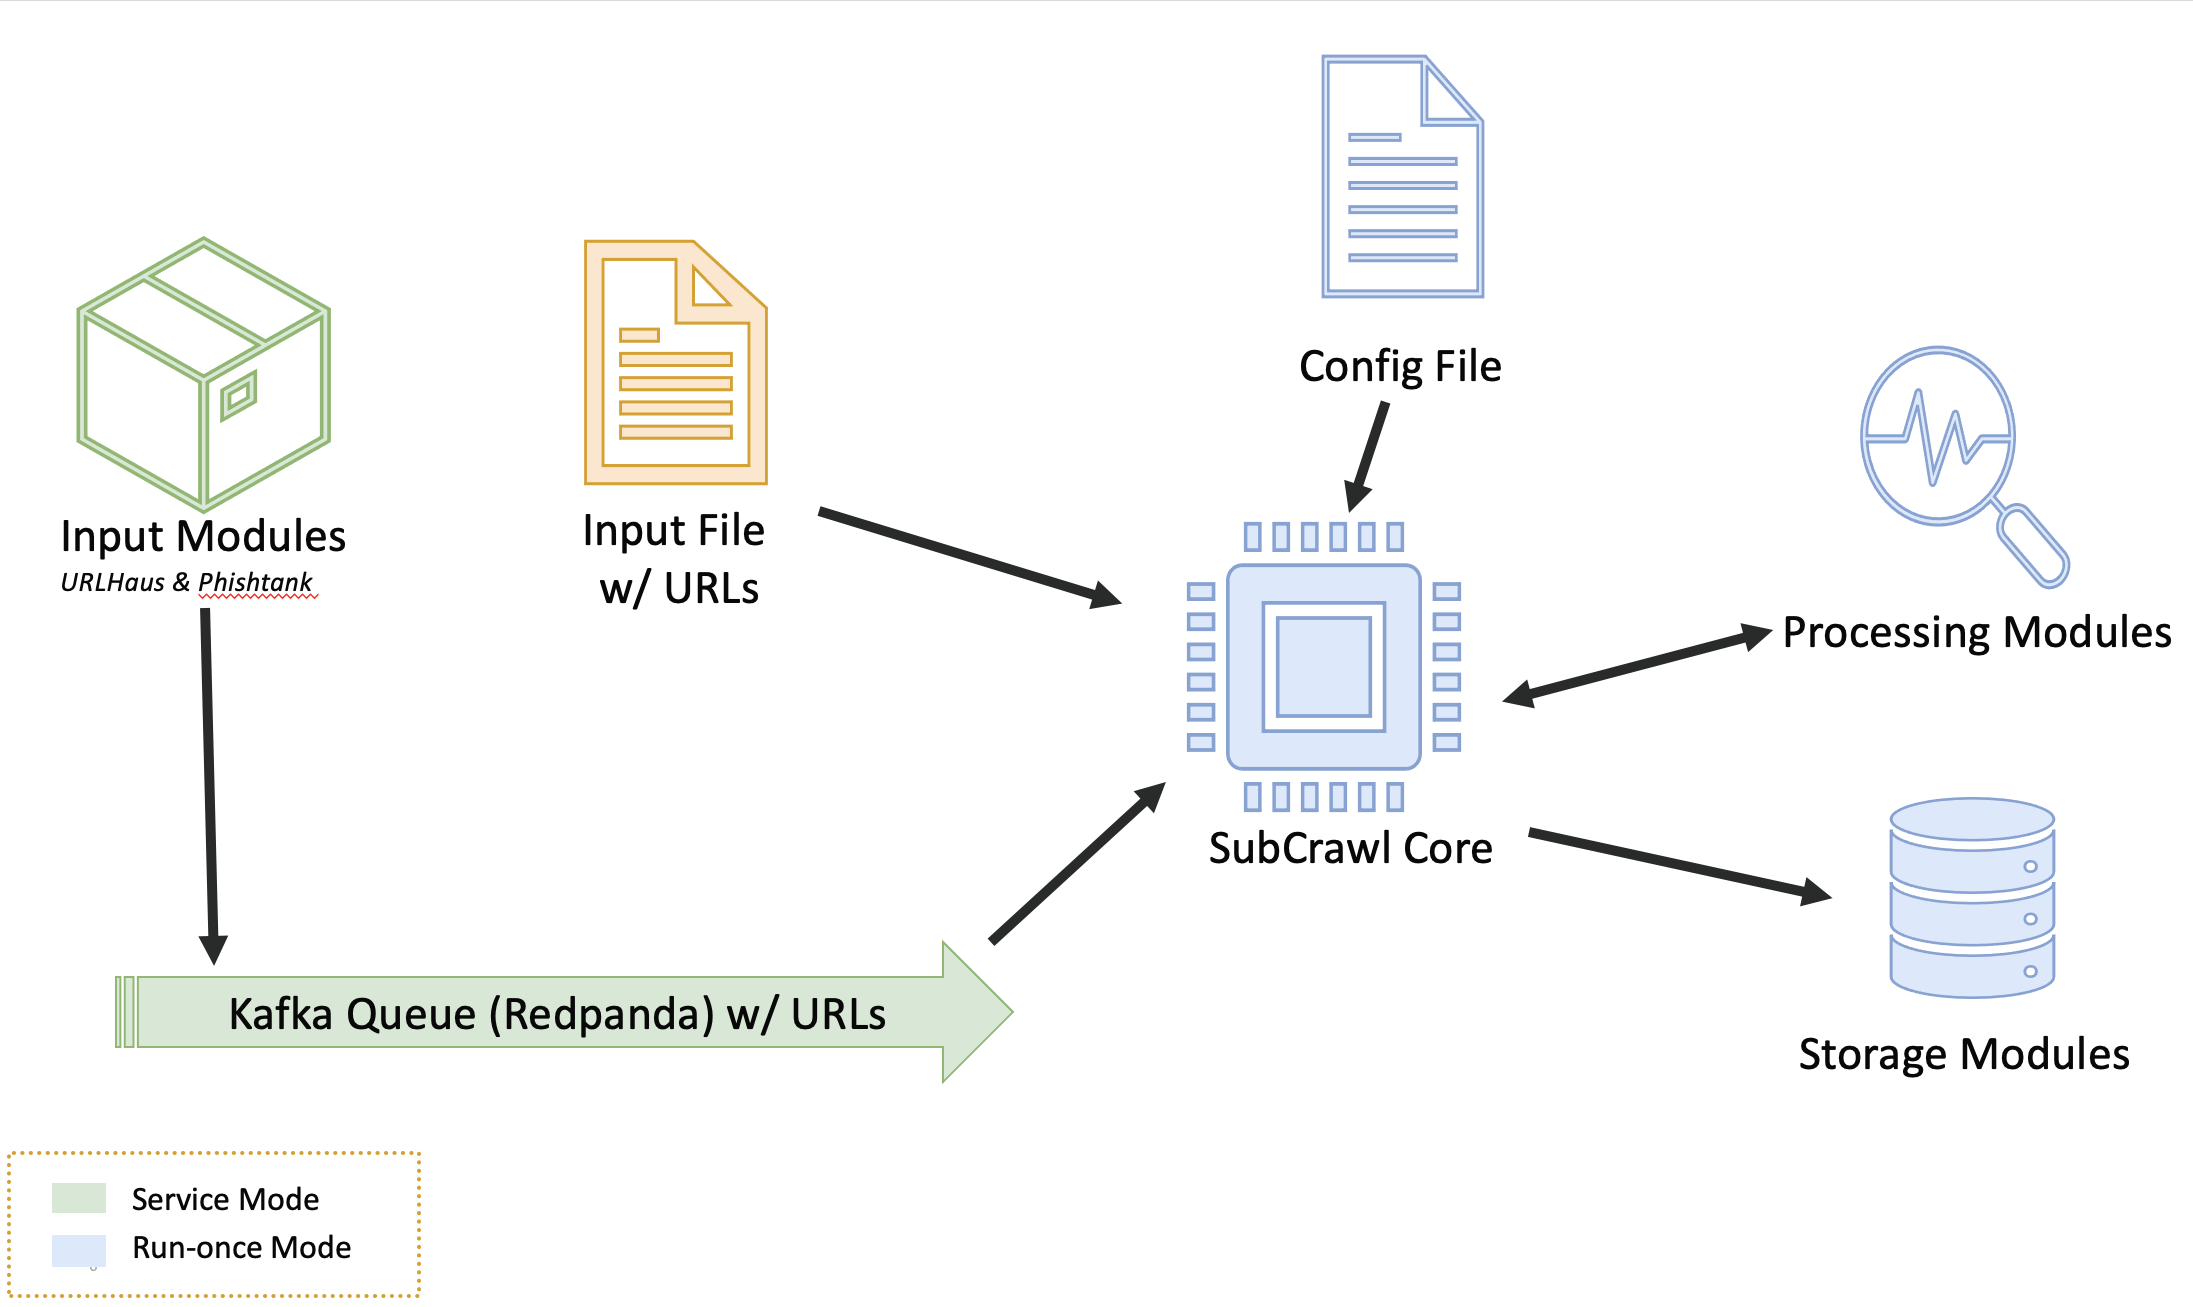
SubCrawl ist ein Framework, das von Patrick Schläpfer, Josh Stroschein und Alex Holland des Threat Research-Teams von HP Inc. entwickelt wurde. SubCrawl wurde entwickelt, um offene Verzeichnisse zu finden, zu scannen und zu analysieren. Das Framework ist modular aufgebaut und besteht aus vier Komponenten: Eingabemodule, Verarbeitungsmodule, Ausgabemodule und der zentralen Crawling-Engine. URLs sind die primären Eingabewerte, die das Framework analysiert und zu einem Warteschlangensystem hinzufügt, bevor es sie durchläuft. Das Parsen der URLs ist ein wichtiger erster Schritt, da es aus einer eingereichten URL zusätzliche URLs generiert, indem es nacheinander Unterverzeichnisse entfernt, bis keine mehr übrig sind. Dieser Prozess stellt einen vollständigeren Scanversuch eines Webservers sicher und kann zur Entdeckung zusätzlicher Inhalte führen. Insbesondere verwendet SubCrawl keine Brute-Force-Methode zur Erkennung von URLs. Der gesamte gescannte Inhalt stammt aus den Eingabe-URLs, dem Parsen der URL und der Erkennung während des Crawlings. Wenn ein offenes Verzeichnis entdeckt wird, extrahiert die Crawling-Engine Links aus dem Verzeichnis zur Auswertung. Die Crawling-Engine bestimmt, ob der Link ein weiteres Verzeichnis oder eine Datei ist. Verzeichnisse werden zur Crawling-Warteschlange hinzugefügt, während Dateien von den Verarbeitungsmodulen weiter analysiert werden. Für jede gescannte URL werden Ergebnisse generiert und gespeichert, wie z.B. die SHA256- und Fuzzy-Hashes des Inhalts, ob ein offenes Verzeichnis gefunden wurde oder Übereinstimmungen mit YARA-Regeln. Schließlich werden die Ergebnisdaten gemäß einem oder mehreren Ausgabemodulen verarbeitet, von denen es derzeit drei gibt. Das erste bietet eine Integration mit MISP, das zweite gibt die Daten einfach auf der Konsole aus, und das dritte speichert die Daten in einer SQLite-Datenbank. Da das Framework modular ist, ist es nicht nur einfach zu konfigurieren, welche Eingabe-, Verarbeitungs- und Ausgabemodule gewünscht werden, sondern auch unkompliziert, neue Module zu entwickeln.
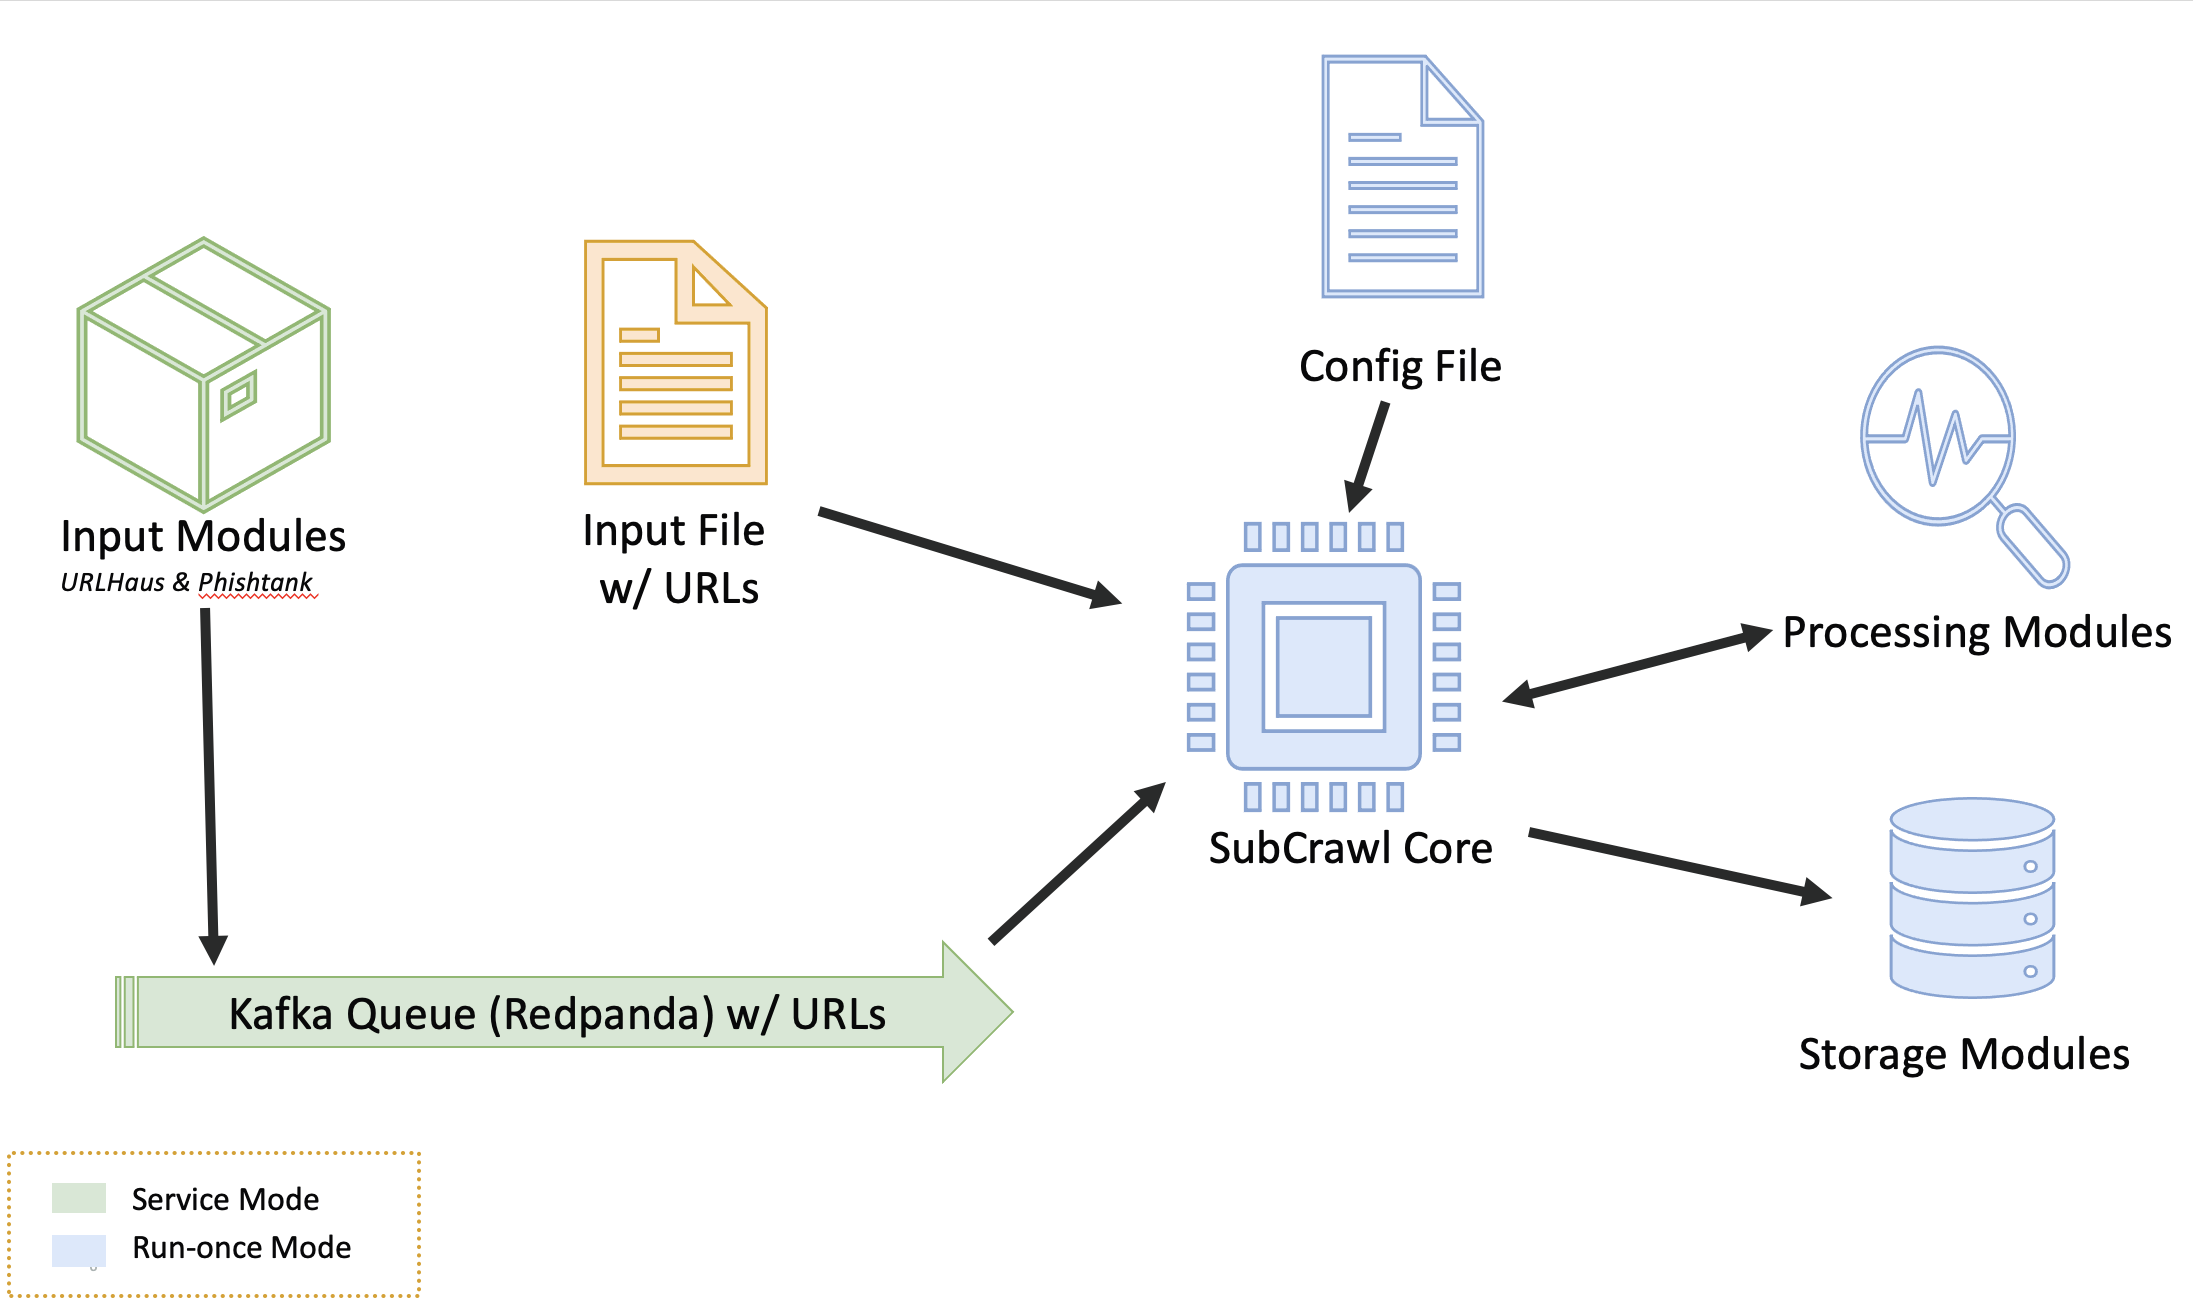 Abbildung 1 - SubCrawl-Architektur
SubCrawl unterstützt zwei verschiedene Betriebsmodi. Erstens kann SubCrawl im Run-Once-Modus gestartet werden. In diesem Modus gibt der Benutzer die zu scannenden URLs in einer Datei an, wobei jeder Eingabewert durch einen Zeilenumbruch getrennt ist. Der zweite Betriebsmodus ist der Dienstmodus. In diesem Modus läuft SubCrawl im Hintergrund und verlässt sich auf die Eingabemodule, um die zu scannenden URLs bereitzustellen. Abbildung 1 zeigt eine Übersicht über die Architektur von SubCrawl. Die Komponenten, die in beiden Betriebsmodi verwendet werden, sind blau, Run-Once-Modus-Komponenten sind gelb und Dienstmodus-Komponenten sind grün.
Basierend auf dem gewählten Ausführungsmodus müssen weitere Vorbedingungen erfüllt sein.
SubCrawl ist in Python3 geschrieben. Darüber hinaus sind mehrere Pakete erforderlich, bevor SubCrawl ausgeführt werden kann. Der folgende Befehl kann verwendet werden, um alle erforderlichen Pakete vor dem Ausführen von SubCrawl zu installieren. Führen Sie den folgenden Befehl aus dem Verzeichnis crawler aus:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
Wenn SubCrawl im Dienstmodus gestartet wird, kann dies mit Docker erfolgen. Aus diesem Grund ist die Installation von Docker und Docker Compose erforderlich. Gute Installationsanleitungen hierfür finden Sie direkt auf der Docker.com-Website.
SubCrawl verfügt über eine integrierte Hilfe über das Argument -h/--help oder durch einfaches Ausführen des Skripts ohne Argumente.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Harvesting the Open Web ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
Dieser Modus eignet sich, wenn Sie schnell eine überschaubare Anzahl von Domains scannen möchten. Dazu müssen die zu scannenden URLs in einer Datei gespeichert werden, die dann als Eingabe für den Crawler dient. Das Folgende ist ein Beispiel für die Ausführung im Run-Once-Modus. Beachten Sie, dass das Argument -f mit einem Pfad zu einer Datei verwendet wird.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
Mit dem Dienstmodus kann eine größere Anzahl von Domains gescannt und die Ergebnisse gespeichert werden. Basierend auf dem ausgewählten Speichermodul können die Daten dann detaillierter analysiert und ausgewertet werden. Um die Ausführung des Dienstmodus für den Benutzer so einfach wie möglich zu gestalten, haben wir alle Funktionen in ein Docker-Image integriert. Im Dienstmodus werden die zu scannenden Domains über Eingabemodule bezogen. Standardmäßig werden neue Malware- und Phishing-URLs von URLhaus und PhishTank heruntergeladen und zur Überprüfung in die Warteschlange gestellt. Die gewünschten Verarbeitungs- und Speichermodule können direkt in der config.yml eingetragen werden. Standardmäßig sind die folgenden Verarbeitungsmodule unter Verwendung des SQLite-Speichers aktiviert:
Zusätzlich zum SQLite-Speichermodul wurde eine einfache Weboberfläche entwickelt, die das Anzeigen und Verwalten der gescannten Domains und URLs ermöglicht.
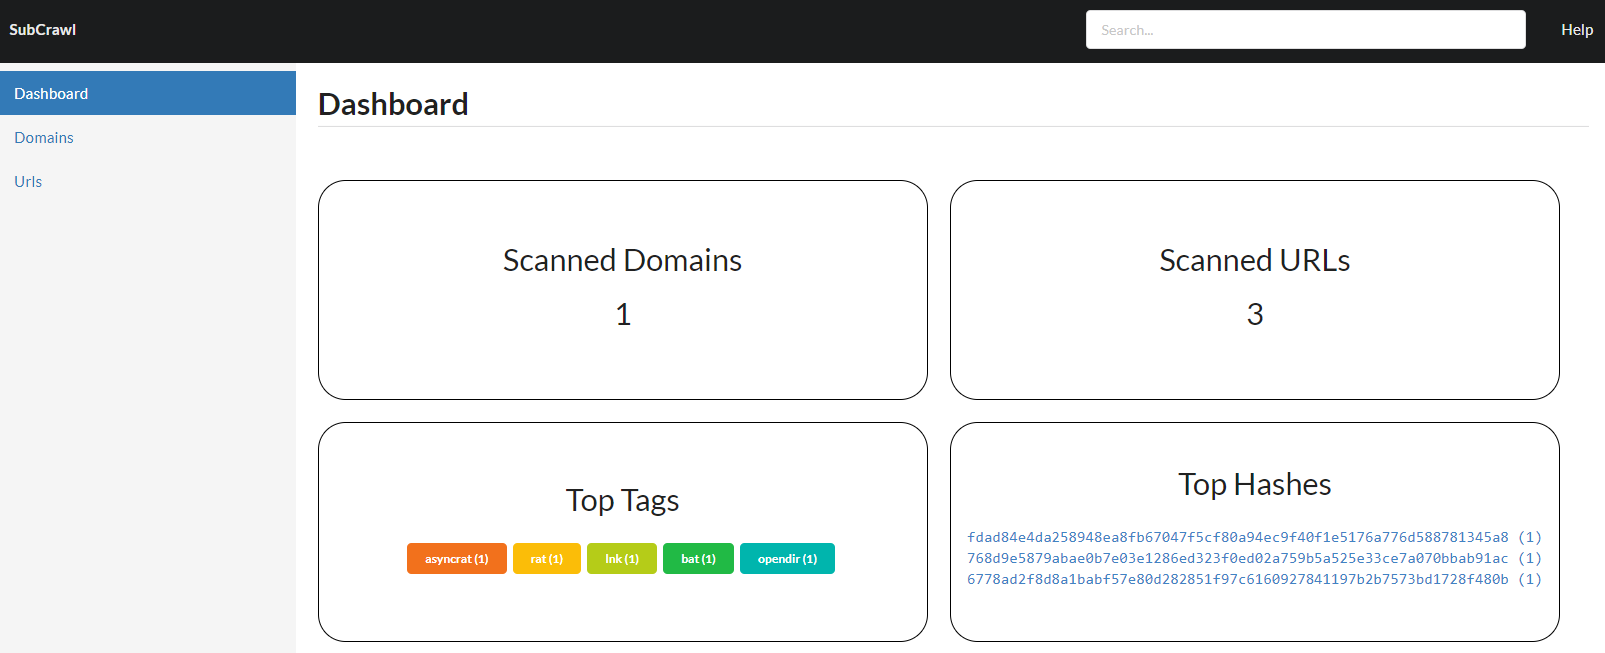
Falls diese Benutzeroberfläche für die spätere Auswertung der Daten nicht ausreicht, kann alternativ oder zusätzlich das MISP-Speichermodul aktiviert werden. Die entsprechenden Einstellungen müssen in der config.yml im Abschnitt MISP vorgenommen werden.
Die folgenden zwei Befehle reichen aus, um das GIT-Repository zu klonen, den Docker-Container zu erstellen und direkt zu starten. Anschließend ist die Weboberfläche unter der Adresse https://localhost:8000/ erreichbar. Bitte beachten Sie, dass die Eingabemodule nach dem Start der Container beginnen, URLs zur Verarbeitungswarteschlange hinzuzufügen, und die Engine beginnt, Hosts zu durchsuchen.
