 germondai/trawl
Selbstgehostete Scraping-Engine — umgeht jede JS-Challenge & jedes Captcha: Cloudflare, Turnstile, reCAPTCHA, hCaptcha, GeeTest. FlareSolverr- & Byparr-Alternative und Drop-in-Ersatz für deinen *arr-Stack.


Selbstgehostetes Web Scraping für Anwendungen und KI-Agenten. Rufe Seiten über die native API ab oder verbinde einen MCP-Client, um sauberes Markdown zu lesen, strukturierte Daten zu extrahieren, Screenshots aufzunehmen und Browseraktivitäten zu inspizieren.
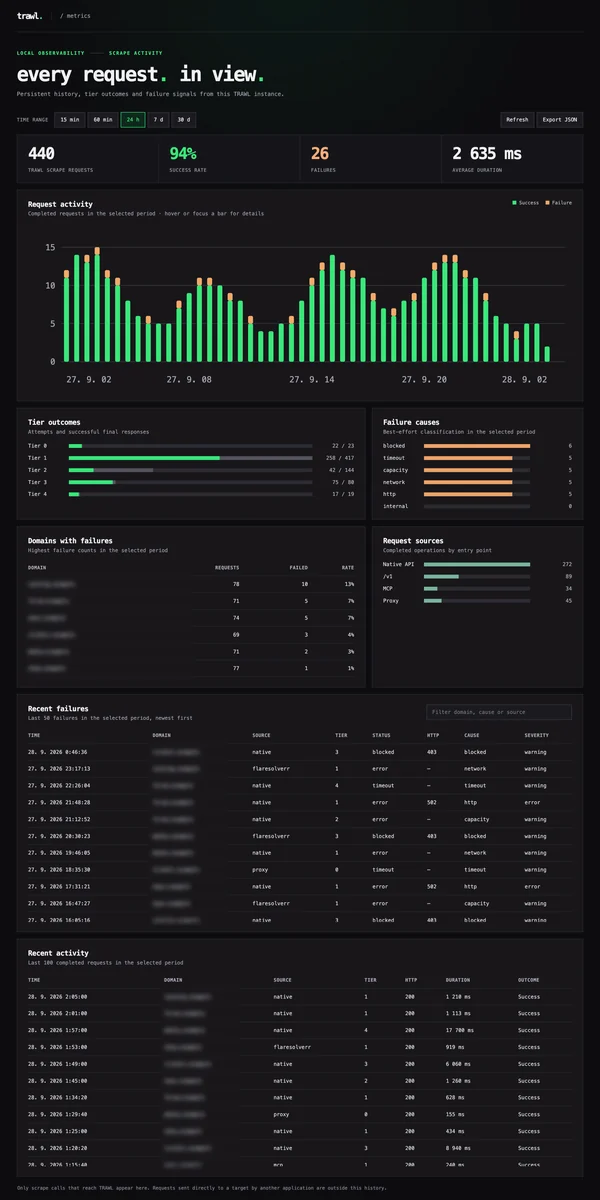
TRAWL beginnt mit einer schnellen HTTP-Anfrage, verwendet gelöste Browser-Sitzungen wieder und eskaliert zu Camoufox und einem optionalen Residential-Proxy, wenn eine Website mehr Aufwand erfordert. Es bewältigt unterstützte JavaScript-Herausforderungen und CAPTCHAs und bietet dir ein lokales Dashboard, um zu sehen, was erfolgreich war, fehlgeschlagen ist und wie lange gedauert hat.
Für bestehende FlareSolverr-Nutzer funktioniert der kompatible /v1-Endpunkt mit Prowlarr und anderen *arr-Tools. Das adaptive Routing und die Sitzungswiederverwendung von TRAWL sind auf schnellere, zuverlässigere Anfragen ausgelegt; ausgewählte Benchmarks auf derselben Maschine zeigen schnellere Antworten als FlareSolverr und Byparr, wobei die Ergebnisse je nach Website und Sitzungszustand variieren.
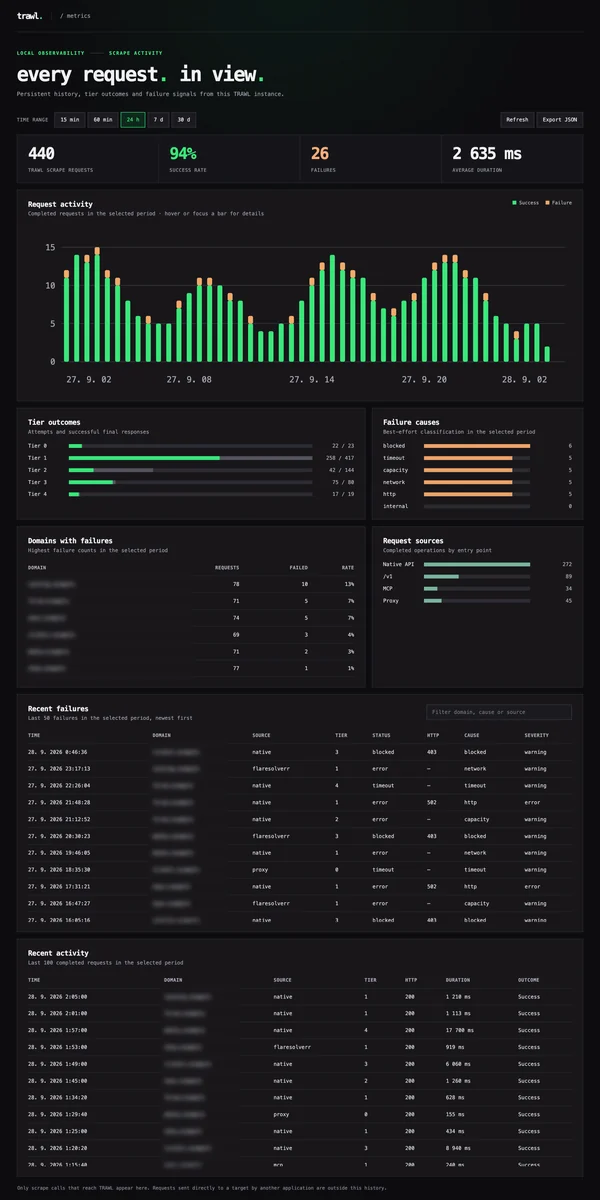
Der Screenshot verwendet beispielhaften Datenverkehr. Dein Dashboard unter http://localhost:8191/dashboard zeigt nur Anfragen an, die von deiner TRAWL-Instanz verarbeitet wurden. Siehe den Metrik-Leitfaden für die Einrichtung.
git clone https://github.com/germondai/trawl cd trawl cp .env.example .env
docker compose up -d
curl http://localhost:8191/health
Der erste Start dauert 15–30 s, während der Browser-Pool aufwärmt. Nachfolgende Starts sind schnell.

### NAS-App-Kataloge

Bevorzugen Sie eine Installation mit einem Klick? TRAWL ist in den Community-App-Katalogen sowohl für TrueNAS als auch für Unraid verfügbar:

- [TrueNAS Community Apps](https://apps.truenas.com/catalog/trawl_community/) —
  öffnen Sie **Apps → Discover Apps** und suchen Sie nach **TRAWL**.
- [Unraid Community Apps](https://ca.unraid.net/apps/trawl-1o4q23p06utr4h) —
  öffnen Sie den Tab **Apps** und suchen Sie nach **Trawl**.

Dank an die Mitwirkenden der TrueNAS- und Unraid-Community, die diese Integrationen gepackt und veröffentlicht haben.

## API

### FlareSolverr-kompatibel (`/v1`)```bash
curl -X POST http://localhost:8191/v1 \
  -H 'Content-Type: application/json' \
  -d '{"cmd":"request.get","url":"https://nowsecure.nl","maxTimeout":60000}'
/scrape)Liefert umfangreichere Metadaten: tier, timings, sessionCached, vollständige Cookie-Liste.```bash
curl -X POST http://localhost:8191/scrape
-H 'Content-Type: application/json'
-d '{"url":"https://nowsecure.nl","maxTimeout":60000}'
### MCP-Tools (`/mcp`)

Setze `MCP_ENABLED=true`, um TRAWLs client-unabhängige Streamable-HTTP-Tools
für lesbare Inhalte, HTML, strukturierte Extraktion, Screenshots und Browser-Diagnosen für jede
MCP-kompatible KI-Anwendung oder jeden Agenten bereitzustellen. Sie laden bekannte öffentliche URLs; TRAWL bietet
keine Websuche oder Ranking. Siehe die
[MCP-Integrationsanleitung](https://github.com/germondai/trawl/blob/dev/apps/docs/integrations/mcp.md).

### Prowlarr / Jackett verbinden

Setze die FlareSolverr-URL auf:```
http://localhost:8191        # running on the same host
http://trawl:8191            # running via Docker Compose on the same network
Einige Seiten binden ihre Cloudflare-Freigabe an den vollständigen Verbindungs-Fingerprint des lösenden Browsers. Der /v1-Flow kann dort nicht helfen: Prowlarr behält nur das Cookie + den User-Agent und ruft die Seite mit seinem eigenen HTTP-Client erneut ab, woraufhin Cloudflare erneut eine Challenge stellt — das Cookie ist nicht portabel. Für diese Indexer aktiviere TRAWLs Forward-Proxy und füge ihn in Prowlarr als HTTP-Proxy hinzu:```env
MITM_ENABLED=true
MITM_PORT=8192
MITM_CA_DIR=/data/proxy-ca # persist the CA (mount a volume)
MITM_MAX_TIER=4 # cap escalation (e.g. 3 to stay off residential)
MITM_ALWAYS_SCRAPE=false # opt in to bypass the proxy's direct Tier 0 probe
Standardmäßig bindet der Listener `0.0.0.0`, damit Clients in einem Docker-Bridge-Netzwerk ihn erreichen können; setze `MITM_HOST=127.0.0.1`, um ihn auf einem Bare-Metal-Host auf Loopback zu beschränken.

1. Installiere die CA des Proxys in den Trust Store des Clients, damit er die Pro-Host-Zertifikate akzeptiert:
   `curl http://<trawl-host>:8191/proxy-ca.crt` → zum CA Store des Prowlarr-Containers hinzufügen
   (z. B. ein linuxserver `/custom-cont-init.d`-Skript, das sie nach
   `/usr/local/share/ca-certificates/` kopiert und `update-ca-certificates` ausführt).
2. Prowlarr → Settings → Indexer Proxies → **HTTP**, Host `<trawl-host>`, Port `8192`.
   Gib ihm ein Tag, wenn nur ausgewählte Indexer ihn verwenden sollen.

Normale Anfragen verwenden einen direkten HTTP/TLS-Pfad. Kleine HTML-, JSON- und Textantworten werden
für die Challenge-Erkennung gepuffert; erkannte Challenges eskalieren durch dieselbe Tier-Pipeline wie
`POST /scrape`. Videos und große binäre Antworten werden direkt gestreamt. Range-Anfragen werden
Ende-zu-Ende weitergeleitet und können eskalieren, wenn ihre Antwort eine erkannte Challenge ist; WebSocket-Upgrades verwenden einen
direkten Relay ohne Browser-Eskalation.

Siehe die vollständige [Proxy-Dokumentation](https://github.com/germondai/trawl/blob/dev/apps/docs/proxy/overview.md) für Routing-Details,
unterstützten Datenverkehr, Einschränkungen, CA-Installation und Client-Beispiele.

> ⚠️ Ein MITM-Proxy kann gegenüber einem Client, der seiner CA vertraut, jeden Host imitieren. Stelle ihn nur auf einem
> privaten Interface (localhost / ein privates Docker-Netzwerk) bereit, niemals öffentlich.

### Installieren des Proxy-CA-Zertifikats

Der Proxy generiert beim ersten Start selbst eine Root-CA. Sein Zertifikat und sein privater Schlüssel werden
unter `MITM_CA_DIR` (Standard `/data/proxy-ca`) persistiert. Pro-Host-Zertifikate werden ausgestellt und
im Speicher zwischengespeichert, während TRAWL läuft; sie müssen nicht separat installiert werden, da sie von der
persistenten Root signiert werden. Jeder Client, der den Proxy verwendet, muss dieser Root vertrauen. Ohne sie schlägt HTTPS mit
`ERR_CERT_AUTHORITY_INVALID` (Browser) oder `PKIX path building failed` (Java) fehl.

Lade die CA einmal pro Client herunter:```bash
curl http://<trawl-host>:8191/proxy-ca.crt -o trawl-ca.crt
# or in a Docker setup where the API isn't reachable from outside:
docker cp trawl:/data/proxy-ca/ca.crt ./trawl-ca.crt
sudo security add-trusted-cert -d -r trustRoot
-k /Library/Keychains/System.keychain ./trawl-ca.crt
security find-certificate -c "TRAWL MITM Proxy CA"
sudo security delete-certificate -c "TRAWL MITM Proxy CA"
/Library/Keychains/System.keychain
#### Linux (Debian/Ubuntu — systemweit für curl, wget, apt usw.)```bash
sudo cp trawl-ca.crt /usr/local/share/ca-certificates/trawl-ca.crt
sudo update-ca-certificates
# Verify
awk '/BEGIN/{c++} c==2' /etc/ssl/certs/ca-certificates.crt | grep -c "TRAWL MITM"
sudo cp trawl-ca.crt /etc/pki/ca-trust/source/anchors/trawl-ca.crt sudo update-ca-trust
#### Firefox- und NSS-Vertrauensspeicher

Firefox-Installationen, die keine Betriebssystem-Stammzertifikate verwenden, benötigen einen NSS-Import pro Profil:```bash
# Firefox 115+ uses a file-backed NSS DB; older versions use the legacy libnssdb format.
# The certutil command is the same either way.
certutil -A -n "TRAWL MITM" -t "CT,C,C" -i trawl-ca.crt \
  -d sql:$HOME/.mozilla/firefox/<profile-dir>
# Or via Firefox UI: Settings → Privacy & Security → Certificates → View Certificates →
# Authorities → Import… → check "Trust this CA to identify websites".
# Profile dir location: about:profiles in Firefox.
Chrome verwendet den System-Truststore unter macOS und Windows, hat jedoch unter Linux einen eigenen:```bash
#### Java (einschließlich JDownloader)```bash
# Find the JRE cacerts file for your client.
#   JDownloader:    <install>/jre/lib/security/cacerts
keytool -importcert -alias trawl -file trawl-ca.crt \
  -keystore "<path-to-cacerts>" -storepass changeit
# If `keytool` reports "Certificate already exists in keystore", use -delete first:
#   keytool -delete -alias trawl -keystore "<path-to-cacerts>" -storepass changeit
Prowlarr, Sonarr und Radarr sind .NET-Anwendungen, keine Java-Anwendungen. Für ihre
Docker-basierten Installationen fügen Sie die CA zum Linux-System-Truststore des Containers hinzu. Ein gängiges
LinuxServer-Muster ist ein /custom-cont-init.d-Skript:```yaml
volumes:
Ihre Anfrage ist leer. Bitte senden Sie den zu übersetzenden Markdown-Inhalt (Chunk 27 von 41), und ich werde ihn wie spezifiziert ins Deutsche übersetzen.```bash
#!/usr/bin/with-contenv bash
cp /config/trawl-ca.crt /usr/local/share/ca-certificates/trawl-ca.crt
update-ca-certificates
LinuxServer führt Skripte in /custom-cont-init.d/ aus, wenn der Container startet. Java-Clients wie
JDownloader erfordern den separaten keytool-Import, der oben beschrieben ist.
JDownloader bringt eine eigene JRE mit; das CA muss in diese importiert werden.
Settings → Advanced → Java Path (in JDownloader) oder schaue im Installationsverzeichnis:
C:\Program Files\JDownloader 2\jre\lib\security\cacerts/Applications/JDownloader 2.app/Contents/app/jre/lib/security/cacerts<install>/jre/lib/security/cacertskeytool -importcert-Befehl von oben gegen diese Datei aus.Import-Certificate -FilePath .\trawl-ca.crt ` -CertStoreLocation Cert:\LocalMachine\Root
Get-ChildItem Cert:\LocalMachine\Root | Where-Object { $_.Subject -like "TRAWL MITM" } | Remove-Item
#### Entfernen der CA (Bereinigung)

Jede Installationsmethode hat einen symmetrischen Entfernungspfad. Durchsuchen Sie Ihren Trust Store nach
`TRAWL MITM Proxy CA` (dem CN der CA) und löschen Sie diesen Eintrag. Das CA-Zertifikat und der Schlüssel befinden sich außerdem unter
`<MITM_CA_DIR>/ca.crt` und `ca.key` auf dem TRAWL-Host. Das Löschen eines der beiden veranlasst TRAWL dazu,
bei seinem nächsten Start eine neue Root zu generieren, sodass bestehende Clients das neue Zertifikat installieren müssen.

## Stufen```
Request
  │
  ▼
Tier 1: Plain HTTP fetch ────── success ──→ return (< 100ms)
  │ blocked
  ▼
Tier 2: Cached session ─────── success ──→ return (~500ms)
  │ cache miss / expired
  ▼
Tier 3: Fresh challenge solve ─ success ──→ cache + return
  │ IP flagged
  ▼
Tier 4: Residential proxy ──── success ──→ cache + return (15–45s)
  │ failed
  ▼
  error
| Datei | Beschreibung |
|---|---|
docker-compose.yml | Scraper + Redis (Standard) |
docker-compose.minimal.yml | Nur Scraper, kein Redis |
docker-compose.prod.yml | Produktion: restart: always, Speicherlimit, Healthcheck |
| Image-Tag | Erstellt aus | Laufzeit | Anwendungsfall |
|---|
Alle Tags liegen im selben ghcr.io/germondai/trawl-Paket — sie teilen sich die Registry, unterscheiden sich jedoch in der Dockerfile-Quelle oder den Build-Argumenten. Wählen Sie das Tag, das zu Ihrer Hardware und Ausgabe passt:```yaml
image: ghcr.io/germondai/trawl:latest
image: ghcr.io/germondai/trawl:baseline
Synology-Hinweis: Viele Synology-NAS-Geräte (DSM 7.x auf J4125 / älterer Hardware) werden mit Kernel 4.4.x ausgeliefert, den Buns moderne Laufzeit nicht vollständig verarbeiten kann. Standard-Bun erfordert Kernel 5.1+ (5.6+ empfohlen); der Baseline-Build degradiert graceful bis hinunter zu Kernel 3.10. Das `:baseline`-Tag wird für diesen Fall veröffentlicht — **bestätigt funktionierend** auf einem Synology DS920+ (Celeron J4125, DSM 7.3.2, Kernel 4.4.302): Der Container startet sauber, `/health` meldet healthy, und er löst Live-Cloudflare-Challenges über `/v1` (siehe [#1](https://github.com/germondai/trawl/issues/1)). Veröffentlicht durch unabhängige GitHub-Actions-Workflows: Das Pushen eines Release-Tags wie `v1.7.0` erzeugt `:1.7.0`, `:latest`, `:1.7.0-baseline` und `:baseline`; der tägliche Nightly-Build um 02:00 UTC erzeugt `:nightly` und `:nightly-<dev-sha>` aus dem neuesten `dev`-Commit.

## Releases & Versionierung

TRAWL folgt [Semantic Versioning](https://semver.org/). Das Pushen eines mit `v` präfixierten Git-Tags (z. B.
`v1.0.0`) löst `publish.yml` aus, das den passenden unpräfixierten Docker-Tag
(`ghcr.io/germondai/trawl:1.0.0`) zusammen mit `:latest` baut und pusht. Der bewegliche `:nightly`-Tag und die unveränderlichen
`:nightly-<shortsha>`-Tags werden täglich um 02:00 UTC aus der neuesten verifizierten `dev`-Revision gebaut
oder bei manueller Auslösung; Branch-Pushes veröffentlichen keine Images.
Siehe die [Releases-Seite](https://github.com/germondai/trawl/releases) für die vollständige Versionshistorie
und [CHANGELOG.md](https://github.com/germondai/trawl/blob/dev/CHANGELOG.md) für die Änderungen in jeder einzelnen.

Um einen bestimmten vergangenen Commit zu veröffentlichen, der einen wichtigen Fix enthielt, ohne auf das nächste Tip-of-`main`-Release
zu warten, taggen Sie genau diesen SHA und pushen Sie ihn — `publish.yml` baut auf dem Tag-Ref, nicht auf dem
aktuellen Tip von `main`:```bash
git tag -a v1.0.1 <sha> -m "..."
git push origin v1.0.1
TRAWL unterstützt HTTP-Proxys, authentifizierte HTTP-Proxys und SOCKS5-Proxys. Die Standard-Compose-Dateien lesen die Proxy-Einstellungen aus der lokalen .env-Datei:```ini
PROXY_URL=http://user:[email protected]:8080
RESIDENTIAL_PROXY_URL=socks5://user:[email protected]:1080
| `-s` | `--server` | `SERVER` | `http://localhost:8080` | Server URL |
| `-t` | `--token` | `TOKEN` | – | API token |
| `-o` | `--output` | `FILE` | `stdout` | Output file |
| `-f` | `--format` | `FORMAT` | `json` | Output format |
| `-v` | `--verbose` | – | `false` | Enable verbose output |
| `-q` | `--quiet` | – | `false` | Suppress non-error output |
| `-h` | `--help` | – | – | Show help message |

### Examples

```bash
# Basic usage
tool --server http://localhost:8080 --token abc123

# With output file
tool -s http://localhost:8080 -t abc123 -o results.json

# Verbose mode
tool -s http://localhost:8080 -t abc123 -v
The tool supports a configuration file located at ~/.config/tool/config.yaml:
server: http://localhost:8080
token: your-api-token
output: results.json
format: json
verbose: false
| Code | Description |
|---|---|
| 0 | Success |
| 1 | General error |
| 2 | Invalid arguments |
| 3 | Connection error |
| 4 |
If you see a connection refused error, ensure the server is running:
curl http://localhost:8080/health
Verify your API token is correct and has not expired.
Ensure you have the necessary permissions to write to the output file.
We welcome contributions! Please follow these steps:
git checkout -b feature/amazing-feature)git commit -m 'Add amazing feature')git push origin feature/amazing-feature)This project is licensed under the MIT License - see the LICENSE file for details.
Lassen Sie entweder den einen oder den anderen Wert leer, um diese Proxy-Stufe zu deaktivieren. Mehrere Endpunkte können durch
Kommas getrennt werden; größere Pools können die entsprechende `*_LIST_FILE`-Variable verwenden. Siehe
[Konfiguration → Proxies](https://github.com/germondai/trawl/blob/dev/apps/docs/getting-started/configuration.md#proxies)
für Pool- und gemountete Dateibeispiele.

| Variable                         | Standard                 | Beschreibung                                                                        |
| -------------------------------- | ------------------------ | ----------------------------------------------------------------------------------- |
| `BROWSER_POOL_SIZE`              | `1`                      | Warme Camoufox-Firefox-Instanzen; erhöhen für gleichzeitige Browser-Lösungen         |
| `LOG_LEVEL`                      | `info`                   | Betriebsprotokolle: `error`, `warn`, `info`, `debug` oder `silent`                  |
| `METRICS_DASHBOARD_ENABLED`      | `false`                  | Dashboard explizit ohne Token aktivieren; Port an `127.0.0.1` binden                |
| `METRICS_DASHBOARD_TOKEN`        | —                        | Dashboard, JSON-Endpunkt und Live-Stream mit einem Token mit 32+ Zeichen schützen   |
| `METRICS_DB_PATH`                | `/data/metrics/trawl.sqlite` | SQLite-Pfad für lokale Metrik-Historie (`/data/metrics` dauerhaft mounten)      |
| `BROWSER_ACQUIRE_TIMEOUT_MS`     | `15000`                  | Wie lange `acquire()` auf einen freien Browser wartet, bevor HTTP 429 zurückgegeben wird |
| `BROWSER_RECYCLE_AFTER_CONTEXTS` | `8`                      | Rolling-Replace nach so vielen Tier-3/4-Kontexten; `0` zum Deaktivieren             |
| `BROWSER_MAX_CONTENT_PROCESSES`  | `2`                      | Firefox-Content-Prozesse pro Browser begrenzen (`dom.ipc.processCount`); senkt RAM/CPU |
| `SCRAPE_MIN_TIER`                | `1`                      | Niedrigste global erlaubte Stufe (`1` HTTP, `2` gecachter Browser, `3` frisch, `4` residential) |
| `SESSION_CACHE_DRIVER`           | `redis`                  | Session-Cache-Backend: `redis` oder Single-Process-`memory`                         |
| `REDIS_SESSION_TTL_SECONDS`      | `3600`                   | Redis- oder In-Memory-Session-TTL (Sekunden)                                        |
| `MEMORY_SESSION_CACHE_MAX_ENTRIES` | `1000`                 | Maximale LRU-begrenzte Einträge für den Memory-Treiber                              |
| `REDIS_URL`                      | —                        | Redis-Verbindungszeichenfolge; leer oder nicht gesetzt deaktiviert den Redis-Cache  |
| `REDIS_CONNECT_TIMEOUT_MS`       | `5000`                   | Maximale Zeit für jeden Redis-Verbindungsversuch                                    |
| `REDIS_RETRY_DELAY_MS`           | `5000`                   | Verzögerung vor erneutem Verbindungsversuch nach Startfehler; `0` deaktiviert Retry |
| `SCRAPE_PROXY_SELECTION`         | `failover`               | Pool-Richtlinie: sticky `failover`, pro Anfrage `roundrobin` oder `random`          |
| `PROXY_URL`                      | —                        | Optionaler Tier-3-HTTP- oder SOCKS5-Proxy oder kommagetrennter Pool                 |
| `PROXY_LIST_FILE`                | —                        | Datei mit einer Tier-3-Proxy-URL pro Zeile                                          |
| `RESIDENTIAL_PROXY_URL`          | —                        | Aktiviert Tier-4-Proxy-Eskalation                                                   |
| `RESIDENTIAL_PROXY_LIST_FILE`    | —                        | Datei mit einer Tier-4-Proxy-URL pro Zeile                                          |
| `STT_URL`                        | —                        | Lokaler Whisper-Endpunkt für reCAPTCHA (optional)                                   |
| `PORT`                           | `8191`                   | API-Listen-Port                                                                     |
| `MITM_ENABLED`                   | `false`                  | Challenge-umgehenden HTTP/HTTPS-Proxy aktivieren                                    |
| `MITM_PORT`                      | `8192`                   | Forward-Proxy-Listen-Port                                                           |
| `MITM_HOST`                      | `0.0.0.0`                | Bind-Adresse; `127.0.0.1` für Loopback-only                                         |
| `MITM_CA_DIR`                    | `/data/proxy-ca`         | Persistentes Root-CA-Zertifikat- und Private-Key-Verzeichnis                        |
| `MITM_MAX_TIER`                  | `4`                      | Eskalationsobergrenze des Proxys (z. B. `3`, um residential zu vermeiden)           |
| `MITM_ALWAYS_SCRAPE`             | `false`                  | Proxy-Tier 0 überspringen; deaktiviert den direkten Medien-/Großdatei-Streaming-Pfad |
| `MITM_DEBUG`                     | `false`                  | Eine Zeile pro proxied Request protokollieren (Fehler werden immer protokolliert)   |

Ein Upgrade von einer früheren Version erfordert das Umbenennen mehrerer Umgebungsvariablen. Siehe den
[Konfigurationsmigrationsleitfaden](https://github.com/germondai/trawl/blob/dev/apps/docs/deployment/configuration-migration.md) für die vollständige
Alt-zu-Neu-Zuordnung und das Redis-Opt-in-Verhalten.

## Stack

Auf einem modernen, standardmäßig schnellen Stack aufgebaut: Bun + Elysia für die API, Redis für Caching,
Camoufox (gehärteter Firefox) für Browser-Automatisierung und Nuxt für die Web-UI — kein Legacy-
Node/Express-Ballast.

| Ebene         | Technologie                        |
| ------------- | ---------------------------------- |
| Runtime       | Bun                                |
| API           | Elysia                             |
| Browser       | Camoufox Firefox (via camoufox-js) |
| Session-Cache | Redis 8.8                          |
| Landing Page  | Nuxt 4                             |
| Dokumentation | VitePress                          |

## Lizenz

[AGPL-3.0](https://github.com/germondai/trawl/blob/dev/LICENSE)

---

<p align="center">
    <span>Made with ❤️ by</span>
    <a href="https://github.com/germondai" target="_blank">@germondai</a>
</p>
|
Bright Data – Die leistungsstärkste Plattform für Web Unlocker, SERP API und Web-Scraping-Tools. Warum Bright Data? • Web Unlocker – umgeht jeden Anti-Bot-Schutz • SERP API – Echtzeit-Ergebnisse von Google, Bing und mehr • Scraping Browser & dedizierte Scraper • Massives Residential-Proxy-Netzwerk • Für Skalierung und Zuverlässigkeit gebaut Starte kostenlos mit Bright Data! |
|
NodeMaven – Der effizienteste Proxy-Anbieter für Web Scraping und Automatisierung mit der hochwertigsten IP auf dem Markt. Warum NodeMaven? • ZIP-Targeting • 99,9 % Uptime • IP-Filterung: alle Proxies haben einen Fraud Score <97 % • Kein KYC erforderlich • Einzigartige kostenlose Tools: Proxy Bandwidth Checker, Meta Tag Checker, IP Lookup und andere! Spezielle Codes für TRAWL-Nutzer: • TRAWL35 – 35 % Rabatt auf Mobile- und Residential-Proxies• TRAWL40 – 40 % Rabatt auf ISP-(Static-)Proxies
|
|
Thordata – Premium-Residential-Proxies für die Datenerfassung. Thordata hilft Entwicklern, zuverlässige Scraping-, Automatisierungs- und KI-Daten-Workflows mit hochwertigen Residential-IPs aufzubauen. 🌍 100 Mio.+ echte IPs | 195+ Länder 🔄 Rotierende & sticky Sitzungen | Präzises Geo-Targeting ⚡ Hohe Parallelität | Stabile Verbindungen Reduziere Sperren und sammle Daten in großem Umfang mit Zuversicht. 🎁 TRAWL-Nutzer: • 3-tägige kostenlose Testversion + 10 % Rabatt Code: TRAWL10
|
ghcr.io/germondai/trawl:latest | apps/api/Dockerfile | Bun 1.4.2 (modern, AVX2) | Kompakter Standard — Linux-Fingerprints |
ghcr.io/germondai/trawl:baseline | apps/api/Dockerfile.baseline | Bun 1.4.2 Baseline (kein AVX2) | Ältere CPUs / ältere Kernel (Synology NAS, J4125, Atom-Ära) |
| Authentication error |
