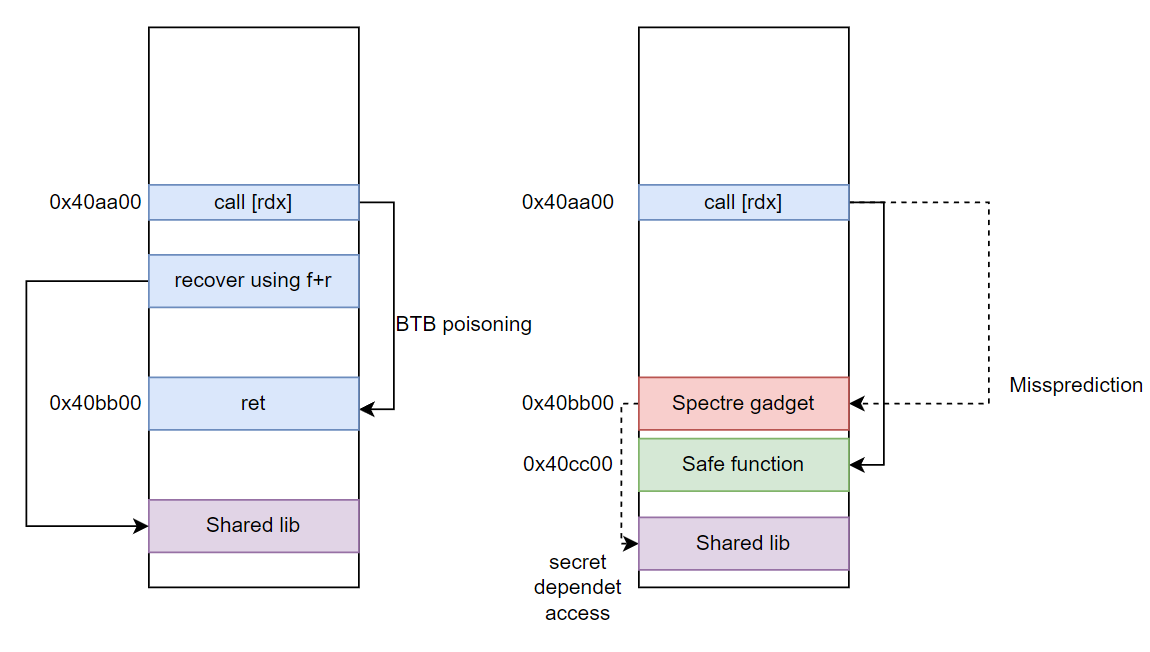
 es0j/execaslr-ekoparty
Proof-of-Concept-Exploit, der ASLR auf Intel-CPUs umgeht, indem er den Branch Target Buffer und spekulative Ausführung missbraucht, um randomisierte Adressen über einen Seitenkanal zu leaken.

Address Space Layout Randomization ist eine Schutzmaßnahme, die es schwerer machen soll, Speicherkorruptionsangriffe auszunutzen. In einem Szenario einer Pufferüberlauf-Schwachstelle muss ein Angreifer, der beispielsweise einen Return-Oriented-Programming-Exploit bauen möchte, die Adressen der Gadgets in der Kette kennen. Wenn das Codesegment der ausgenutzten Binärdatei randomisiert ist, ist es für einen Angreifer viel schwerer, die richtige Adresse für den Exploit zu wählen, was die Ausnutzung unpraktikabel macht.
Das folgende Beispiel zeigt, wie eine Adresse randomisiert wird:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
Bei jeder Ausführung wird der Wert randomisiert:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
Die letzten 12 Bits 149 sind immer gleich, aber die Position der Funktion kann ungefähr überall zwischen 0x550000000000 und 0x570000000000 liegen, was bedeutet, dass 29 Bits randomisiert sind, was einen möglichen Adressraum von 0x200 0000 0000 oder 2,2 TB Größe ergibt.
Die Verarbeitung jeder Instruktion ist eine anspruchsvolle Aufgabe. Einige Stufen der Verarbeitung einer einzelnen Instruktion sind:
Um den Durchsatz von Instruktionen in der CPU zu erhöhen, wird jede Aufgabe der Instruktion von einer bestimmten Einheit des Prozessors ausgeführt. Wenn alle Einheiten parallel arbeiten, kann die CPU mit viel höheren Taktraten arbeiten – das ist die Idee einer Pipeline.
| Operation \ Taktyklus | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Abruf | A | B | C | ||
| Dekodierung | A | B | C | ||
| Ausführung | A | B | C |
Ausführung der Instruktionen A, B und C über die Takte 1–5. In Takt 3 zum Beispiel sind die Abruf-, Dekodier- und Ausführungseinheiten gleichzeitig aktiv
Allerdings sind Instruktionen nicht völlig unabhängig voneinander. Zum Beispiel die folgende Sequenz:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
In diesem Fall wird die Instruktion A im besten Fall erst in Takt 3 in der Ausführungsphase abgeschlossen. Allerdings muss die Abrufeinheit entscheiden, welche Instruktion als Nächstes aus dem Speicher geholt werden soll, nämlich ob Instruktion C (mov dl,[rsi]) übersprungen werden soll.
In diesem Szenario hat die CPU die Möglichkeit, auf das Ende der Instruktion A zu warten, das erst im dritten Taktyklus eintritt, um dann die richtige Instruktion aus dem Speicher zu holen, wenn die Add-Operation zum Beispiel 0 zurückgibt:
| Operation \ Taktyklus | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Abruf | A | B | D | |||
| Dekodierung | A | B | D | |||
| Ausführung | A | B | D |
Das bedeutet eine Verzögerung in der Pipeline, weil die CPU auf die Ausführung der Instruktion warten muss. In diesem Beispiel beträgt die Verzögerung einen einzigen Taktyklus, aber die Instruktion add ax,[bx] erfordert eine Speicheroperation, die, wie zuvor gesehen, bis zu Hunderte von Takten dauern kann, was erhebliche Leistungskosten für den Prozessor mit sich bringt.
Eine schnellere Option wäre, den korrekten Ausführungspfad zu „erraten“. Die CPU kann spekulieren, ob der Sprung ausgeführt wird oder nicht. Danach wird die Ausführung auf dem spekulierten Pfad fortgesetzt, und die Werte werden nur übernommen, wenn der Pfad nach dem Ende der Instruktion A als korrekt bestätigt wird. Wenn der Pfad als falsch bestätigt wird, werden die Ergebnisse verworfen und der Zustand auf den Punkt vor der Spekulation zurückgesetzt.
| Operation \ Taktyklus | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Abruf | A | B | (S) C | |||
| Dekodierung | A | B | (S) C | |||
| Ausführung | A | B | (S) C |
Das einzige Problem beim Rückgängigmachen des eingeschlagenen Pfads ist, dass der mikroarchitektonische Zustand der CPU nicht zurückgesetzt werden kann. Wenn die CPU also spekuliert, die Instruktion C (mov dl,[rsi]) auszuführen, werden die von rsi referenzierten Daten in den Cache verschoben. Dieser Effekt kann später mit einem Seitenkanalangriff gemessen werden.
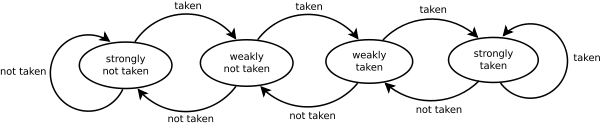
2-Bit-Bedingungsprädiktor. https://en.wikipedia.org/wiki/Branch_predictor
Nicht nur bedingte Instruktionen müssen vorhergesagt werden, sondern auch indirekte Sprünge. Die CPU muss einen Mechanismus haben, um die Ziele einer Instruktion wie call [rdi] zu erraten.
Die Spectre-v2-Schwachstelle zeigt, dass es möglich ist, den indirekten Prädiktor auszunutzen, um transiente Ausführung in anderen Prozessen zu erreichen:
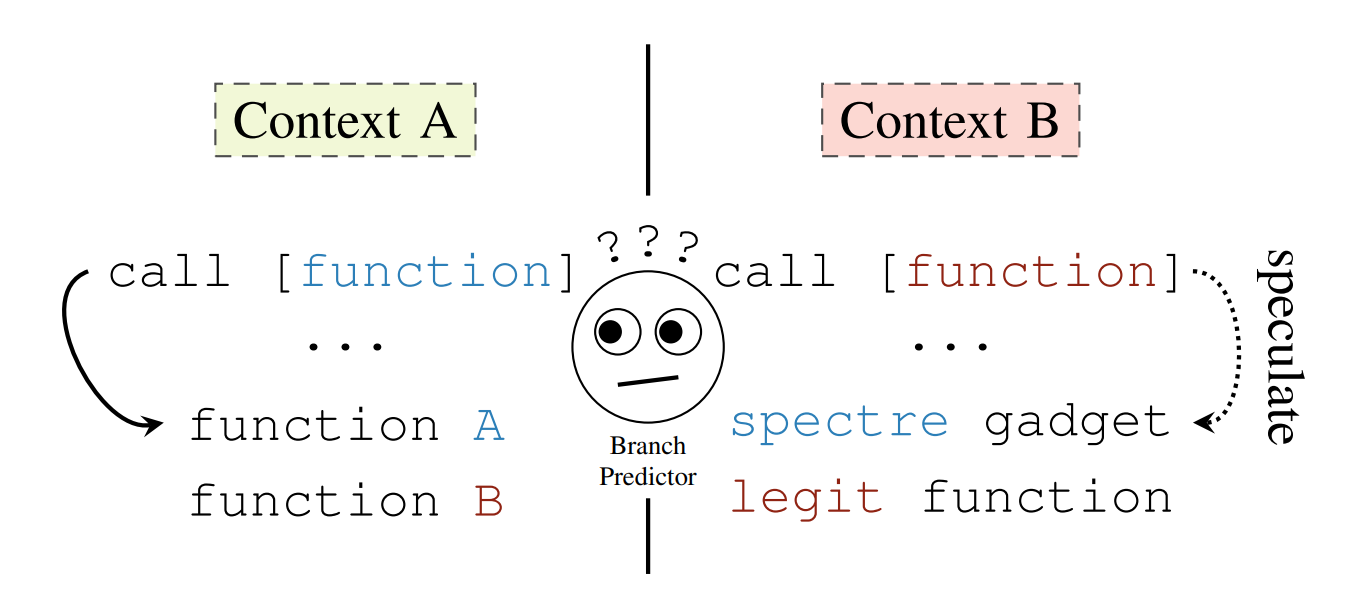 Entnommen aus https://spectreattack.com/spectre.pdf
Wenn eine Call-Instruktion im Kontext A auf derselben virtuellen Adresse wie ein anderer Call im Kontext B platziert wird, kann der Angreifer die CPU trainieren, Code an einer vom Angreifer gewählten Position im Kontext B auszuführen – eine Code-Reuse-Attacke, ähnlich wie Return-Oriented Programming (ROP).
Das anvisierte Opfer muss über ein Stück Code verfügen, das als „Spectre-Gadget“ bekannt ist und in der Lage ist, ein Geheimnis über einen Seitenkanalangriff zu leaken. Für einen erfolgreichen Spectre-Angriff muss der Angreifer auch die Position des Spectre-Gadgets kennen. Daher war der Schutz des Opfers mit ASLR bei Benutzer-zu-Benutzer-Angriffen früher eine Abschwächung für diese Art von Angriff. Es gibt jedoch auch Techniken zur Extraktion von ASLR mittels mikroarchitektonischer Angriffe wie Jump Over ASLR. Diese Technik hat jedoch einige Einschränkungen hinsichtlich der Menge der geleakten Bits, da sie zur Umgehung von ASLR auf Kollisionen im direkten Prädiktor angewiesen ist.
Die internen Mechanismen dieses Prädiktors sind unten dargestellt:
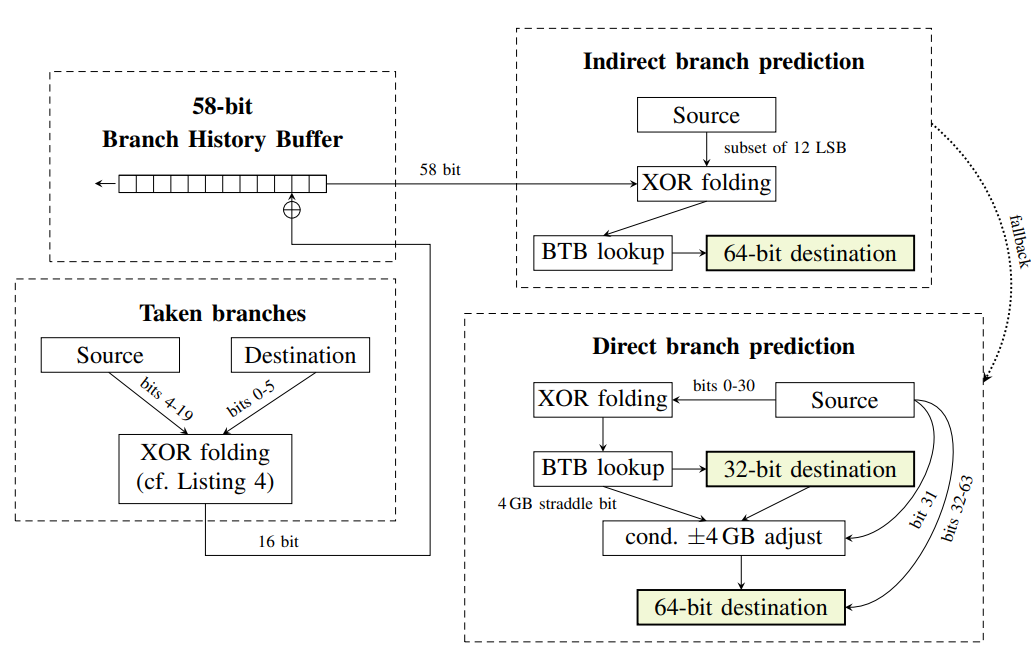
Entnommen aus https://spectreattack.com/spectre.pdf
Einige dieser Komponenten sind:
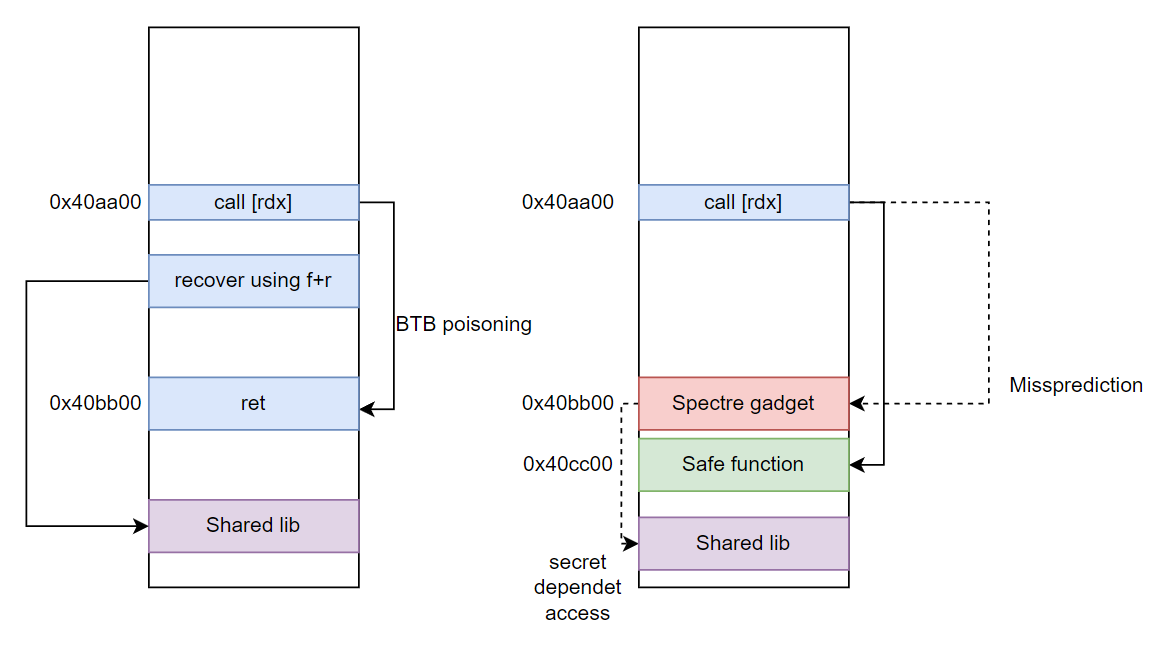
Das klassische Spectre-v2-Angriffslayout sieht folgendermaßen aus: