 edoardottt/cariddi
Nimm eine Liste von Domains, crawle URLs und scanne nach Endpunkten, Geheimnissen, API-Schlüsseln, Dateierweiterungen, Tokens und mehr

Nimm eine Liste von Domains, crawle URLs und scanne nach Endpunkten, Secrets, API-Keys, Dateiendungen, Tokens und mehr

Mit 💙 programmiert von edoardottt
Auf Twitter teilen!
Installation • Verwendung • Erste Schritte • Changelog • Mitwirken • Lizenz
brew install cariddi
sudo snap install cariddi
go install -v github.com/edoardottt/cariddi/cmd/cariddi@latest
pacman -Syu cariddi
nix-shell -p cariddi
Du benötigst Go (>=1.24.0)
git clone https://github.com/edoardottt/cariddi.git
cd cariddi
go get ./...
make linux # (to install)
make unlinux # (to uninstall)
Einzeiler: git clone https://github.com/edoardottt/cariddi.git && cd cariddi && go get ./... && make linux
Beachte, dass die ausführbare Datei nur im cariddi-Ordner funktioniert.
git clone https://github.com/edoardottt/cariddi.git
cd cariddi
go get ./...
.\make.bat windows # (to install)
.\make.bat unwindows # (to uninstall)
Wenn du nur ein einzelnes Ziel scannen möchtest, kannst du Folgendes verwenden
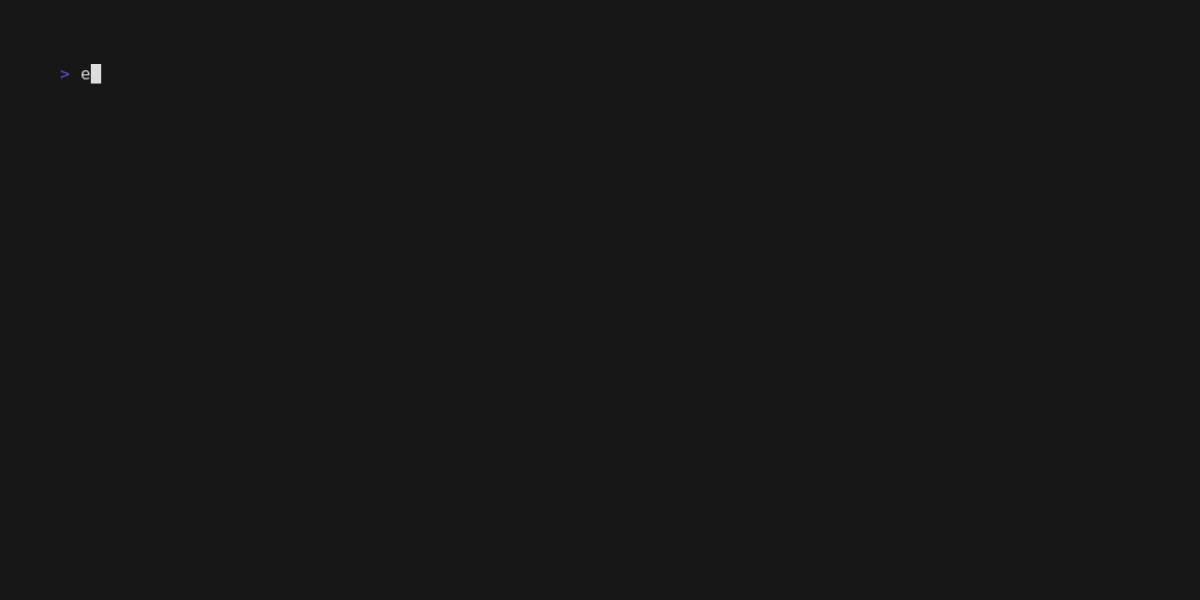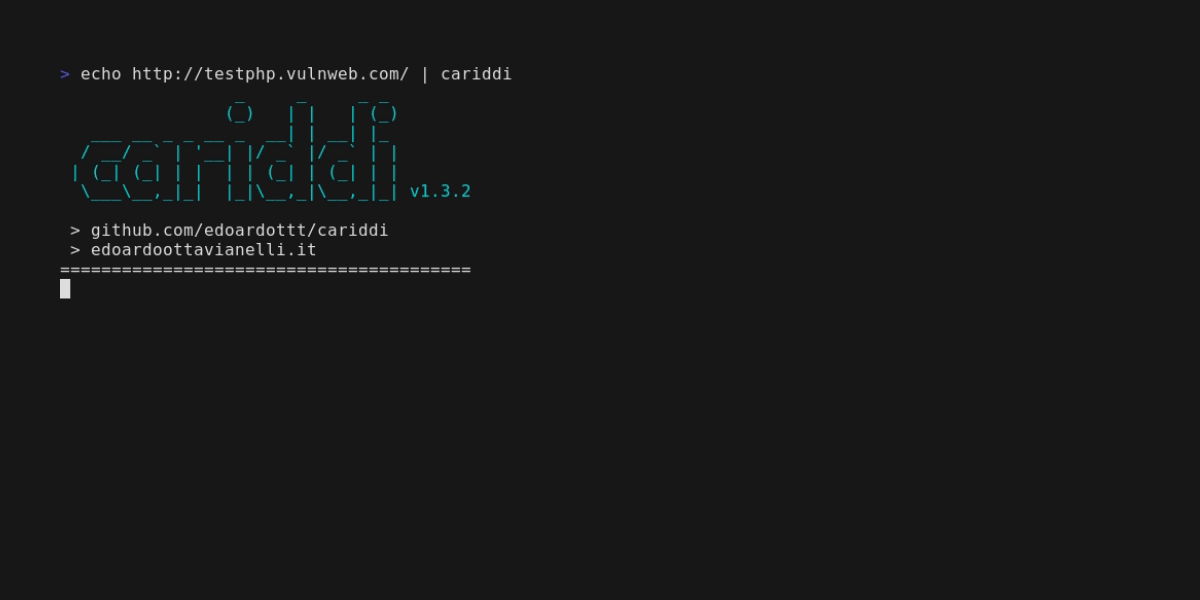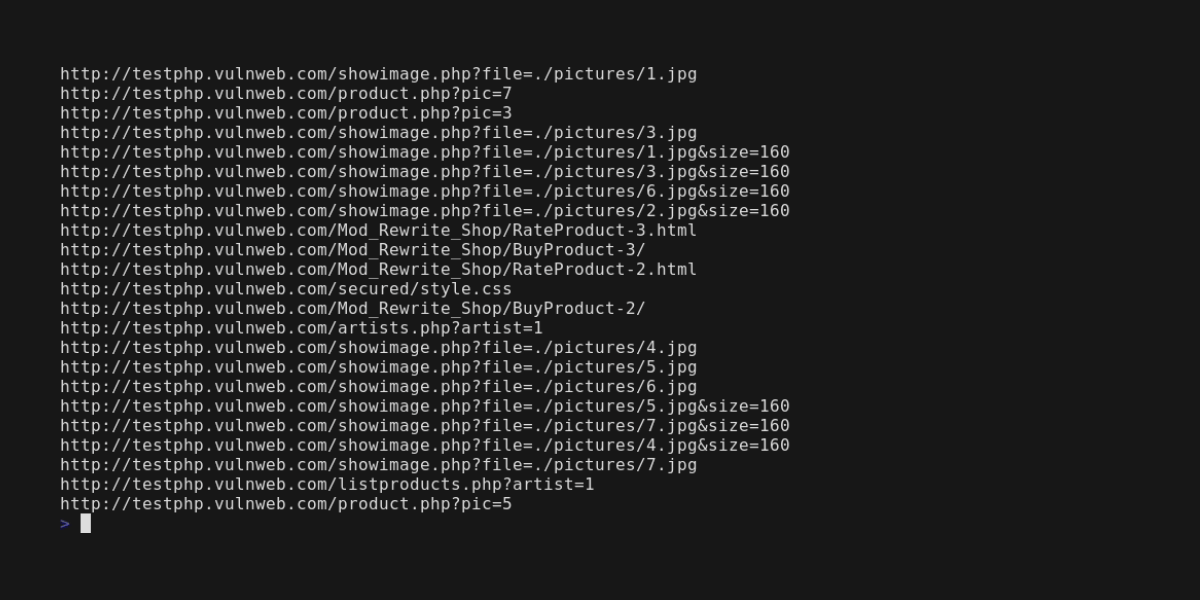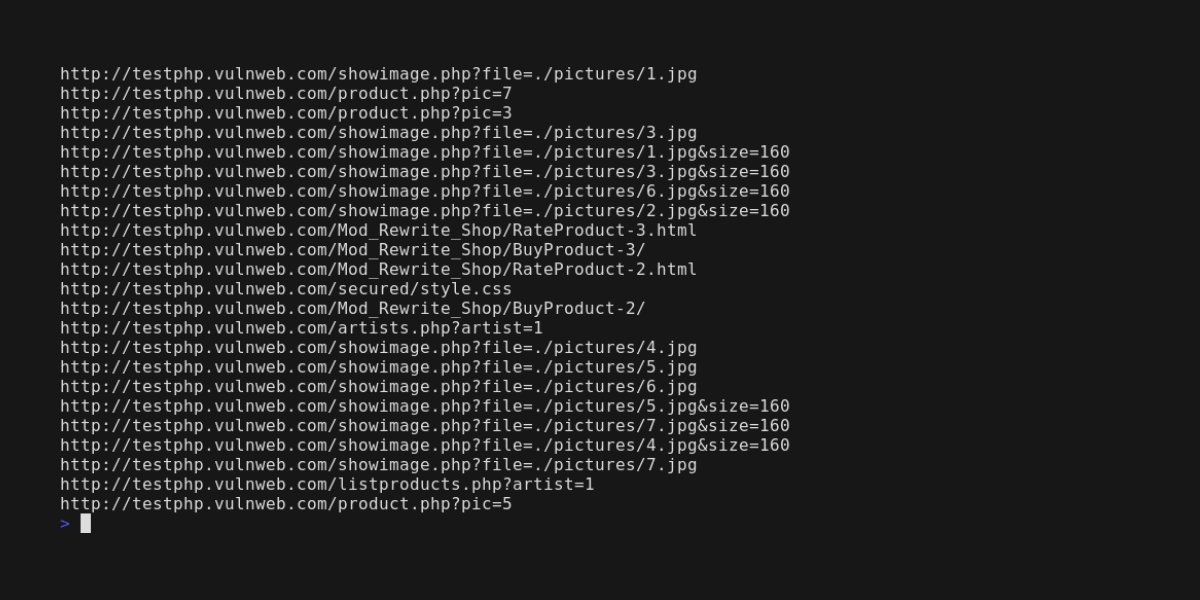
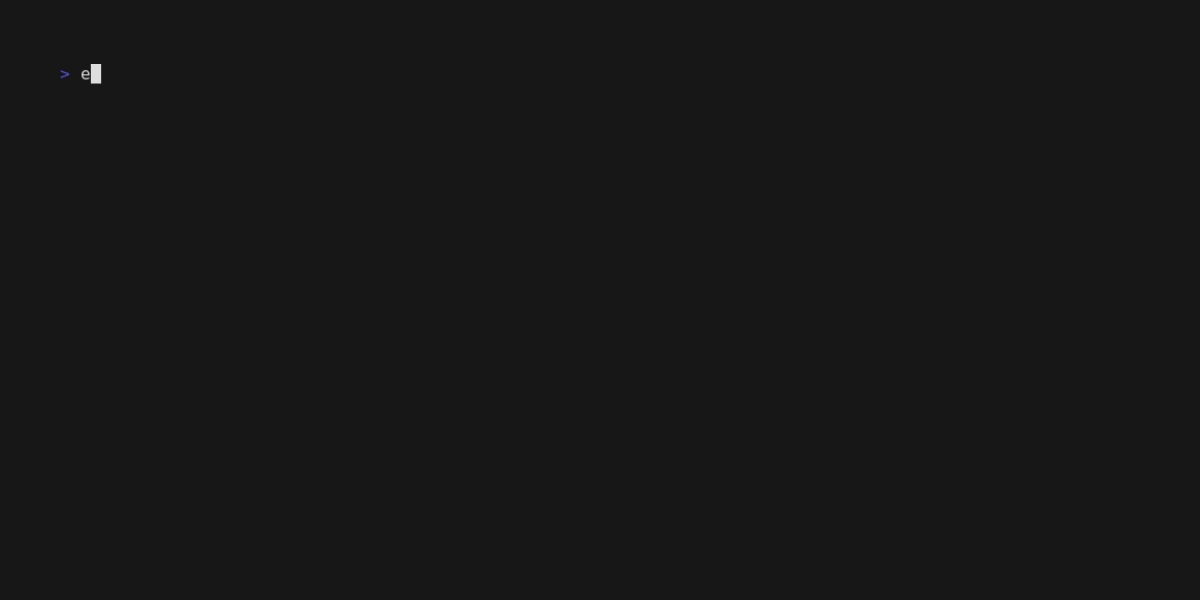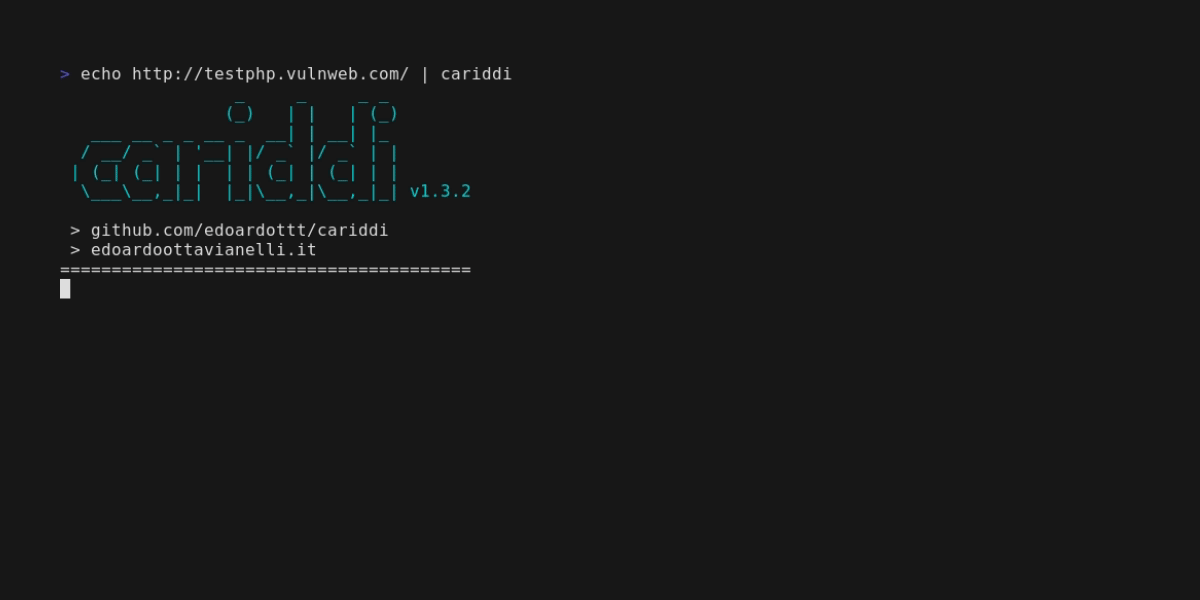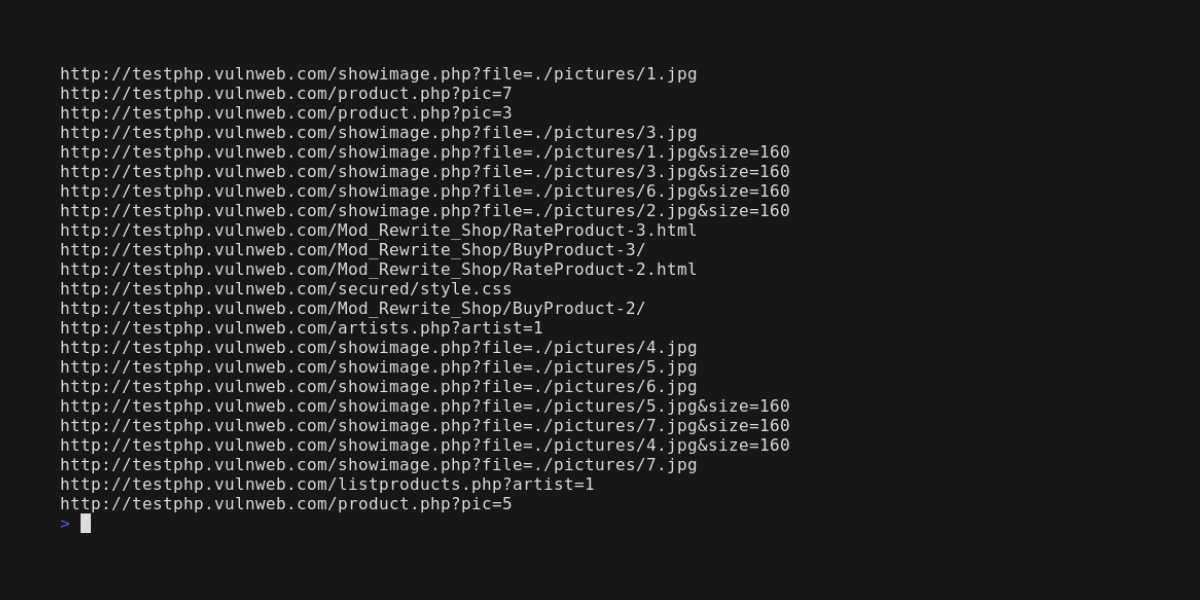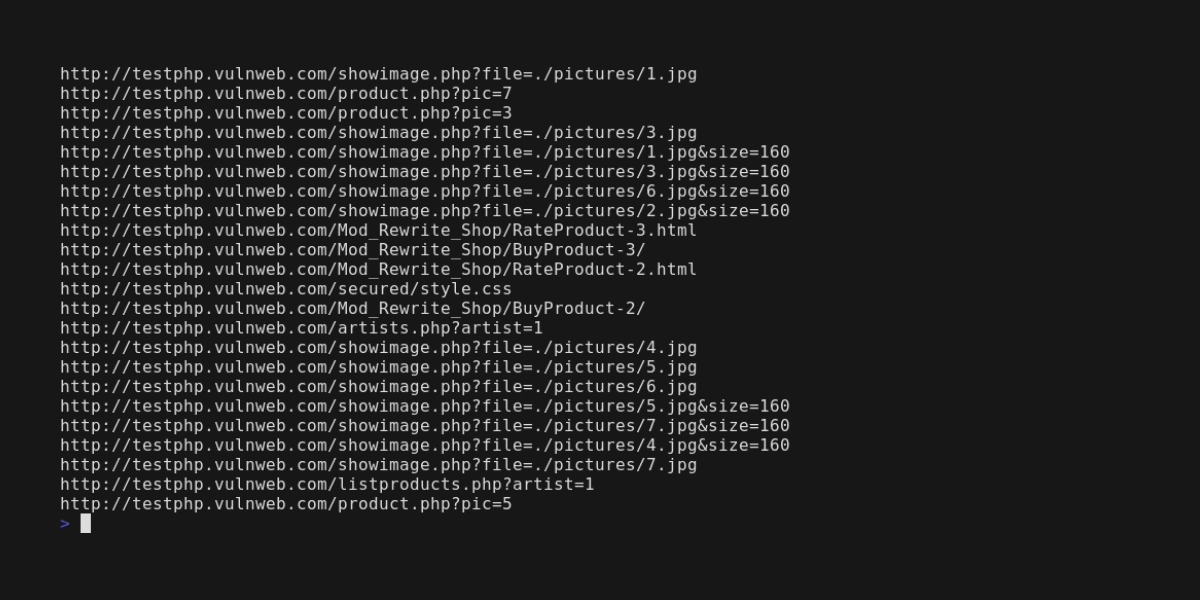
echo https://edoardottt.com/ | cariddi
Bei mehreren Zielen kannst du stattdessen eine Datei verwenden, z. B. urls.txt mit:
https://edoardottt.com/
http://testphp.vulnweb.com/
Für Windows:
powershell.exe -Command "cat urls.txt | .\cariddi.exe" in der Eingabeaufforderungcat urls.txt | cariddi.exe mit PowerShellcariddi -version (Gibt die Version aus)cariddi -h (Gibt die Hilfe aus)cariddi -examples (Gibt die Beispiele aus)cat urls.txt | cariddi -intensive (Crawlt und sucht auch nach Subdomains, wie *.target.com)cat urls.txt | cariddi -s (Sucht nach Secrets)cat urls.txt | cariddi -err (Sucht nach Fehlern in Websites)cat urls.txt | cariddi -e (Sucht nach interessanten Endpunkten)cat urls.txt | cariddi -info (Sucht nach nützlichen Informationen in Websites)cat urls.txt | cariddi -ext 2 (Sucht nach interessanten Dateien (Stufe 2 von 7))cat urls.txt | cariddi -e -ef endpoints_file (Sucht nach benutzerdefinierten Endpunkten)cat urls.txt | cariddi -s -sf secrets_file (Sucht nach benutzerdefinierten Secrets)cat urls.txt | cariddi -ie pdf,png,jpg (Ignoriert diese Endungen beim Scannen)Standardmäßig werden png, svg, jpg, jpeg, bmp, jfif, gif, webp, woff, woff2, ttf, tiff, tif, mp4, webm, mkv, avi, mov, flv, wmv, mp3, wav, flac, ogg, m4a, aac, ico, cur, eot, otf beim Scannen nach Secrets, Informationen und Fehlern ignoriert.
cat urls.txt | cariddi -proxy http://127.0.0.1:8080 (Setzt einen Proxy, http und socks5 werden unterstützt)cat urls.txt | cariddi -d 2 (2 Sekunden zwischen einer gecrawlten Seite und der nächsten)cat urls.txt | cariddi -c 200 (Setzt die Parallelitätsstufe auf 200)cat urls.txt | cariddi -i forum,blog,community,open (Ignoriert URLs, die diese Wörter enthalten)cat urls.txt | cariddi -it ignore_file (Ignoriert URLs, die mindestens eine Zeile aus der Eingabedatei enthalten)cat urls.txt | cariddi -cache (Verwendet den Ordner .cariddi_cache als Cache)cat urls.txt | cariddi -t 5 (Setzt das Timeout für die Anfragen)cat urls.txt | cariddi -headers "Cookie: auth=admin;type=2;; X-Custom: customHeader"cat urls.txt | cariddi -headersfile headers.txt (Liest benutzerdefinierte Header aus einer externen Datei)cat urls.txt | cariddi -ua "Custom User Agent" (Verwendet einen benutzerdefinierten User Agent)cat urls.txt | cariddi -rua (Verwendet bei jeder Anfrage einen zufälligen Browser-User-Agent)cat urls.txt | cariddi -plain (Gibt nur Ergebnisse aus)cat urls.txt | cariddi -ot target_name (Ergebnisse in TXT-Datei)cat urls.txt | cariddi -oh target_name (Ergebnisse in HTML-Datei)cat urls.txt | cariddi -json (Gibt die Ausgabe als JSON in stdout aus)cat urls.txt | cariddi -sr (Speichert HTTP-Antworten)cat urls.txt | cariddi -debug (Gibt Debug-Informationen während des Crawlens aus)cat urls.txt | cariddi -md 3 (Maximal 3 Tiefenebenen)cariddi -h gibt die Hilfe aus.
Usage of cariddi:
  -c int
     Concurrency level. (default 20)
  -cache
     Use the .cariddi_cache folder as cache.
  -d int
     Delay between a page crawled and another.
  -debug
     Print debug information while crawling.
  -e Hunt for juicy endpoints.
  -ef string
     Use an external file (txt, one per line) to use custom parameters for endpoints hunting.
  -err
     Hunt for errors in websites.
  -examples
     Print the examples.
  -ext int
     Hunt for juicy file extensions. Integer from 1(juicy) to 7(not juicy).
  -h Print the help.
  -headers string
     Use custom headers for each request E.g. -headers "Cookie: auth=yes;;Client: type=2".
  -headersfile string
     Read from an external file custom headers (same format of headers flag).
  -json
     Print the output as JSON in stdout.
  -md
     Maximum depth level the crawler will follow from the initial target URL.
  -i string
     Ignore the URL containing at least one of the elements of this array.
  -ie value
     Comma-separated list of extensions to ignore while scanning.
  -info
     Hunt for useful informations in websites.
  -intensive
     Crawl searching for resources matching 2nd level domain.
  -it string
     Ignore the URL containing at least one of the lines of this file.
  -oh string
     Write the output into an HTML file.
  -ot string
     Write the output into a TXT file.
  -plain
     Print only the results.
  -proxy string
     Set a Proxy to be used (http and socks5 supported).
  -rua
     Use a random browser user agent on every request.
  -s Hunt for secrets.
  -sf string
     Use an external file (txt, one per line) to use custom regexes for secrets hunting.
  -sr
     Store HTTP responses.
  -t int
     Set timeout for the requests. (default 10)
  -ua string
     Use a custom User Agent.
  -version
     Print the version.
Normalerweise verwendest du Burpsuite in deinem Browser, also musst du nur das Zertifikat von Burpsuite im Browser als vertrauenswürdig einstufen und fertig.
Um cariddi mit dem BurpSuite-Proxy zu verwenden, musst du einige weitere Schritte durchführen.
