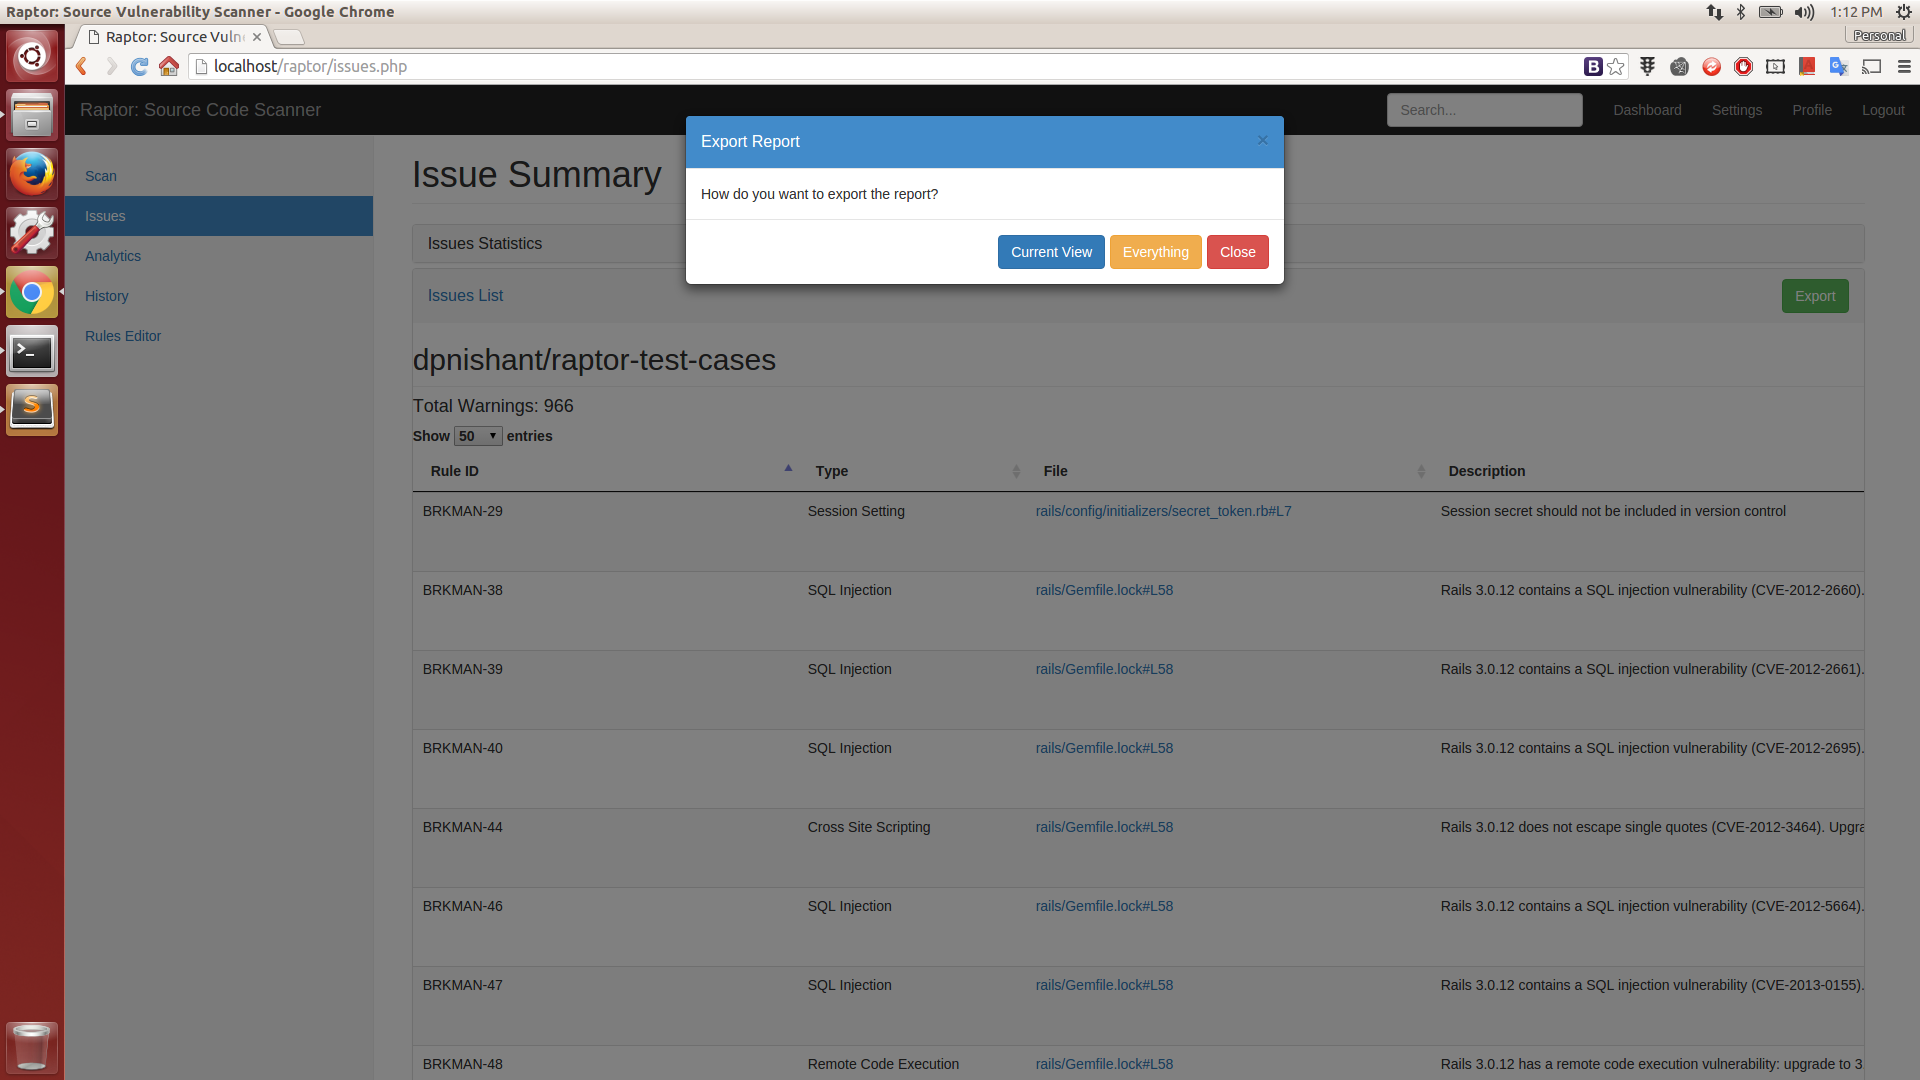

Webbasierter Quellcode-Schwachstellenscanner
Raptor ist ein webbasierter (Webdienst + UI) GitHub-zentrierter Quellcode-Schwachstellenscanner, d.h. er scannt ein Repository nur mit der GitHub-Repo-URL. Sie können Webhooks einrichten, um automatische Scans jedes Mal sicherzustellen, wenn Sie einen Commit oder einen Pull-Request mergen. Der Scan erfolgt asynchron und die Ergebnisse sind nur für den Benutzer verfügbar, der den Scan gestartet hat.
Einige der Funktionen von Raptor:
Dieses Tool ist ein Versuch, der Gemeinschaft und Start-up-Unternehmen zu helfen, den Fokus auf sichere Programmierung zu legen. Dieses Tool entspricht möglicherweise nicht den Funktionen/der Qualität kommerzieller Alternativen, es wird nichts garantiert und Sie wurden gewarnt. Dieses Tool ist für die Verwendung durch Sicherheits-Code-Reviewer und/oder Entwickler mit Erfahrung in sicherer Programmierung gedacht, um Schwachstellen-Einstiegspunkte während Code-Audits oder Peer-Reviews zu finden. Bitte vertrauen Sie der Ausgabe des Tools nicht blind. Es wird am besten genutzt, wenn Sie Raptor in Ihre CI/CD-Pipeline integrieren.
0.1 beta
Integrierte Plugins:
Hinweis: Die meisten der folgenden Tools/Module/Bibliotheken wurden stark modifiziert, um eine gute Integration in das Framework zu ermöglichen.
Verfügbare Regelpakete:
Installationsvideo: YouTube Installation
$ wget https://github.com/dpnishant/raptor/archive/master.zip -O raptor.zip
$ unzip raptor.zip
$ cd raptor-master
$ sudo sh install.sh
Installationsvideo: YouTube Verwendung
cd raptor-master
sudo sh start.sh #startet den Backend-Webdienst
Richten Sie nun Ihren Browser auf Raptor Home (http://localhost/raptor/)
Melden Sie sich mit dem Benutzernamen an, der auf dem entsprechenden GitHub-Server registriert ist, mit dem Sie verbunden sind, und einem beliebigen Passwort (merken Sie sich jedoch den Benutzernamen, um den Scan-Verlauf anzuzeigen).
Zum Beispiel:
Wenn Sie auf https://github.com als foobar registriert sind, verwenden Sie denselben Benutzernamen beim Scannen von Repos auf https://github.com. Wenn Sie jedoch auf Ihrem persönlichen/unternehmenseigenen GitHub (z.B. https://github.corp.company.com) als foobar_corp registriert sind, verwenden Sie denselben Benutzernamen, wenn Sie Repos auf https://github.corp.company.com scannen möchten.
Derzeit kann das Passwort jedoch beliebig sein, da wir keine Datenbank in der Entwicklungsversion implementiert haben.
Sie können den mitgelieferten leichten, GUI-basierten clientseitigen Regeleditor verwenden, um neue/benutzerdefinierte Regeln für Ihre spezifischen Anforderungen hinzuzufügen, oder einen anderen Texteditor, da die Regelpaketdateien einfache JSON-Strukturen sind. Öffnen Sie die Regeln in 'backend/rules' mit Ihrem Browser. Wenn Sie fertig sind, speichern Sie Ihre neue/modifizierte Regelsdatei im selben Verzeichnis, d.h. 'backend/rules'. Alles, was Sie jetzt tun müssen, ist eine kleine Bearbeitung, hier: Init Script. Hängen Sie den Namen Ihres neuen Regelpakets an dieses Array an, ohne die Erweiterung '.rulepack', und starten Sie den Backend-Server neu. Sie sind fertig! 👍
Sie können es hier aufrufen: Regeleditor (http://localhost/raptor/editrules.php)
Fügen Sie ein Dateinamen- oder Verzeichnisnamenmuster hinzu, das vom Scannen ausgeschlossen werden soll. Dies ist nützlich, um bekannte Dateien wie jquery.min.js usw. oder das gesamte /test/-Verzeichnis zu ignorieren. Im folgenden Beispiel bedeutet 'jquery' jquery und ist groß-/kleinschreibungssensitiv, seien Sie also vorsichtig. Im Abschnitt plugins ist der name des Plugins der Name der Regelpaketdatei ohne die Erweiterung ".rulepack", wie sie im Verzeichnis rules/ verfügbar ist. Das Feld issue ist die ID des Issues, das in jeder Regel der Regelpaketdateien erwähnt wird: Beispiel #1, Beispiel #2. Der Wert des Feldes match_type kann entweder regex oder start oder end sein. Das Feld value ist die exakte Zeichenfolge, die abgeglichen werden soll, wenn match_type start oder end ist. Falls das Feld match_type regex ist, sollte der value das rohe RegEx-Muster enthalten, das Base64-kodiert werden muss, um Probleme mit der JSON-Syntax-Escaping zu vermeiden. regex ist ein regulärer Ausdruck basierter Abgleich, start vergleicht den Anfang des Ausschnitts und end vergleicht das Ende des Ausschnitts.
Die Funktionsweise ist, dass der Scanner nach dem Scannen nach Issues alle gefundenen Issues durchläuft und diejenigen entfernt, die den Mustern (basierend auf der Art des Abgleichs) jedes im ignore_list.rulepack genannten Plugins entsprechen.

